



学习记录总结专栏:机器学习:PyTorch框架-个人学习总结(专栏) https://blog.csdn.net/spiderb/category_12838886.html
1 前言
从本质上来来说,深度学习模型的训练过程就是不断更新权重值,而权重值的更新需要求解梯度。因此,梯度在模型训练过程中至关重要。同时,求解梯度是相对复杂的。在实际训练过程中,pytorch框架就提供了自动求导(微分)系统。从而不需要手动计算梯度,只需要搭建好向前传播的计算图,然后根据pytorch中的autograd中相应的方法就可以得到所有张量的梯度。
2 autograd中的具体方法
2.1 torch.autograd.backward()
# 自动求取计算图中各个结点的梯度
torch.autograd.backward(
    tensors, # 用于求导的张量,如:loss
    grad_tensors=None, # 多梯度权重(如果有多个loss需要进行计算时,需要设置每一个loss的权重)
    retain_graph=None, # 保存计算图(动态图机制--每一次反向传播后,动态图会被释放掉,如果想要继续使用,需要设置为True)
    create_graph=False # 创建导数计算图,用于高阶求导(二阶导数,三阶导数等)
)

# 在这里,还是使用【机器学习:pytorch框架(5)--计算图的理解与代码实操】中的计算图研究示例来进行说明
# 示例(1)
import torch

w = torch.tensor([1.], requires_grad=True)
x = torch.tensor([2.], requires_grad=True)

a = torch.add(w,x)
b = torch.add(w,1)
y = torch.mul(a,b)

y.backward() # 梯度反向传播,这里张量类中是调用了torch.autograd.backward()的封装,本质是一样的
print('求导结果:',w.grad)
# 输出结果及说明
求导结果: tensor([5.])  # 这与手动计算的结果是一致的

# 示例(2)多个loss需要计算
w = torch.tensor([1.], requires_grad=True)
x = torch.tensor([2.], requires_grad=True)

a = torch.add(w,x)
b = torch.add(w,1)

y1 = torch.mul(a,b) # y1 = (x+w)×(w+1)
y2 = torch.add(a,b) # y2 = (x+w)+(w+1)  dy/dw=2

loss = torch.cat([y1,y2],dim=0) # [y1,y2]
grad_tensors = torch.tensor([1,2])

loss.backward(gradient = grad_tensors) # 封装是形参gradient传入torchgrad.backward()中grad_tensors
print(w.grad)

# 输出结果及说明
tensor([9.])
# 梯度值9是:根据y1求导结果×权重1+y2求导结果×权重2 = 5×1+2×2 = 9
2.2 torch.autograd.grad()
# 求取计算图中某一个张量的梯度
torch.autograd.grad(
    outputs, # 用于求导的张量,如loss (谁需要求导)
    inputs, # 需要梯度的张量,如:w,x(对谁求导)
    create_graph=False, # 创建导数计算图,用于高阶求导,只有创建了导数的计算图,才能对导数的导数再进行求导
    retain_graph=None, # 保存计算图
    grad_outputs=None # 多梯度权重
)

# 示例:二阶导数求导
x = torch.tensor([3.],requires_grad = True)
y = torch.pow(x,2)  # y=x**2

grad_1 = torch.autograd.grad(y,x,create_graph = True) # grad_1 = dy/dx = 2x = 2*3 = 6
print(grad_1)

grad_2 = torch.autograd.grad(grad_1[0],x) # grad_2 = d(dy/dx)/dx = d(2x) = 2
print(grad_2)

# 输出结果
(tensor([6.], grad_fn=<MulBackward0>),)
(tensor([2.]),)
** 自动求导中需要注意以下细节:
1、梯度不会自动清零;每一次反向传播,都会累加;所以,需要调用:w.grad.zero_(),进行梯度清零;(其中,下划线表示原位(in-place)操作,变量原地址改变值)
2、依赖于叶子结点的结点,,requires_grad默认为True;
3、叶子结点不可执行in-place(反向传播之前,不能对叶子结点进行原位改变操作,因为反向传播过程中,梯度的计算是根据变量地址来获取变量值,若值改变了,那么计算时在原地址上,就找不到原数值了,梯度(求导)就会错误)。
3 逻辑回归
在前面的(1)至(5)和本节的学习当中,学习了数据的载体——张量;还学习了如何通过前向传播来搭建计算图;同时,通过计算图进行梯度的求解。有了数据前向传播和梯度,我们就可以开始正式训练机器学习模型。
3.1 逻辑回归简介
简单来说,逻辑回归是线性的二分类模型,模型的表达式为:
;
,f(x)称为sigmoid函数,也叫做Logistic函数
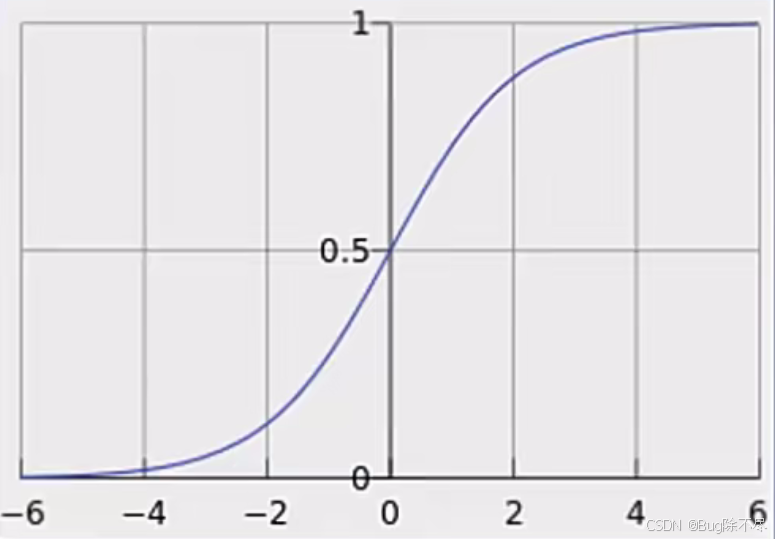
sigmoid函数,因变量是自变量的一个线性组合,映射到【0,1】之间
[0, 1]符合概率取值,经过sigmoid函数,输出y就可以实现二分类(选择一个阈值,如0.5/0);
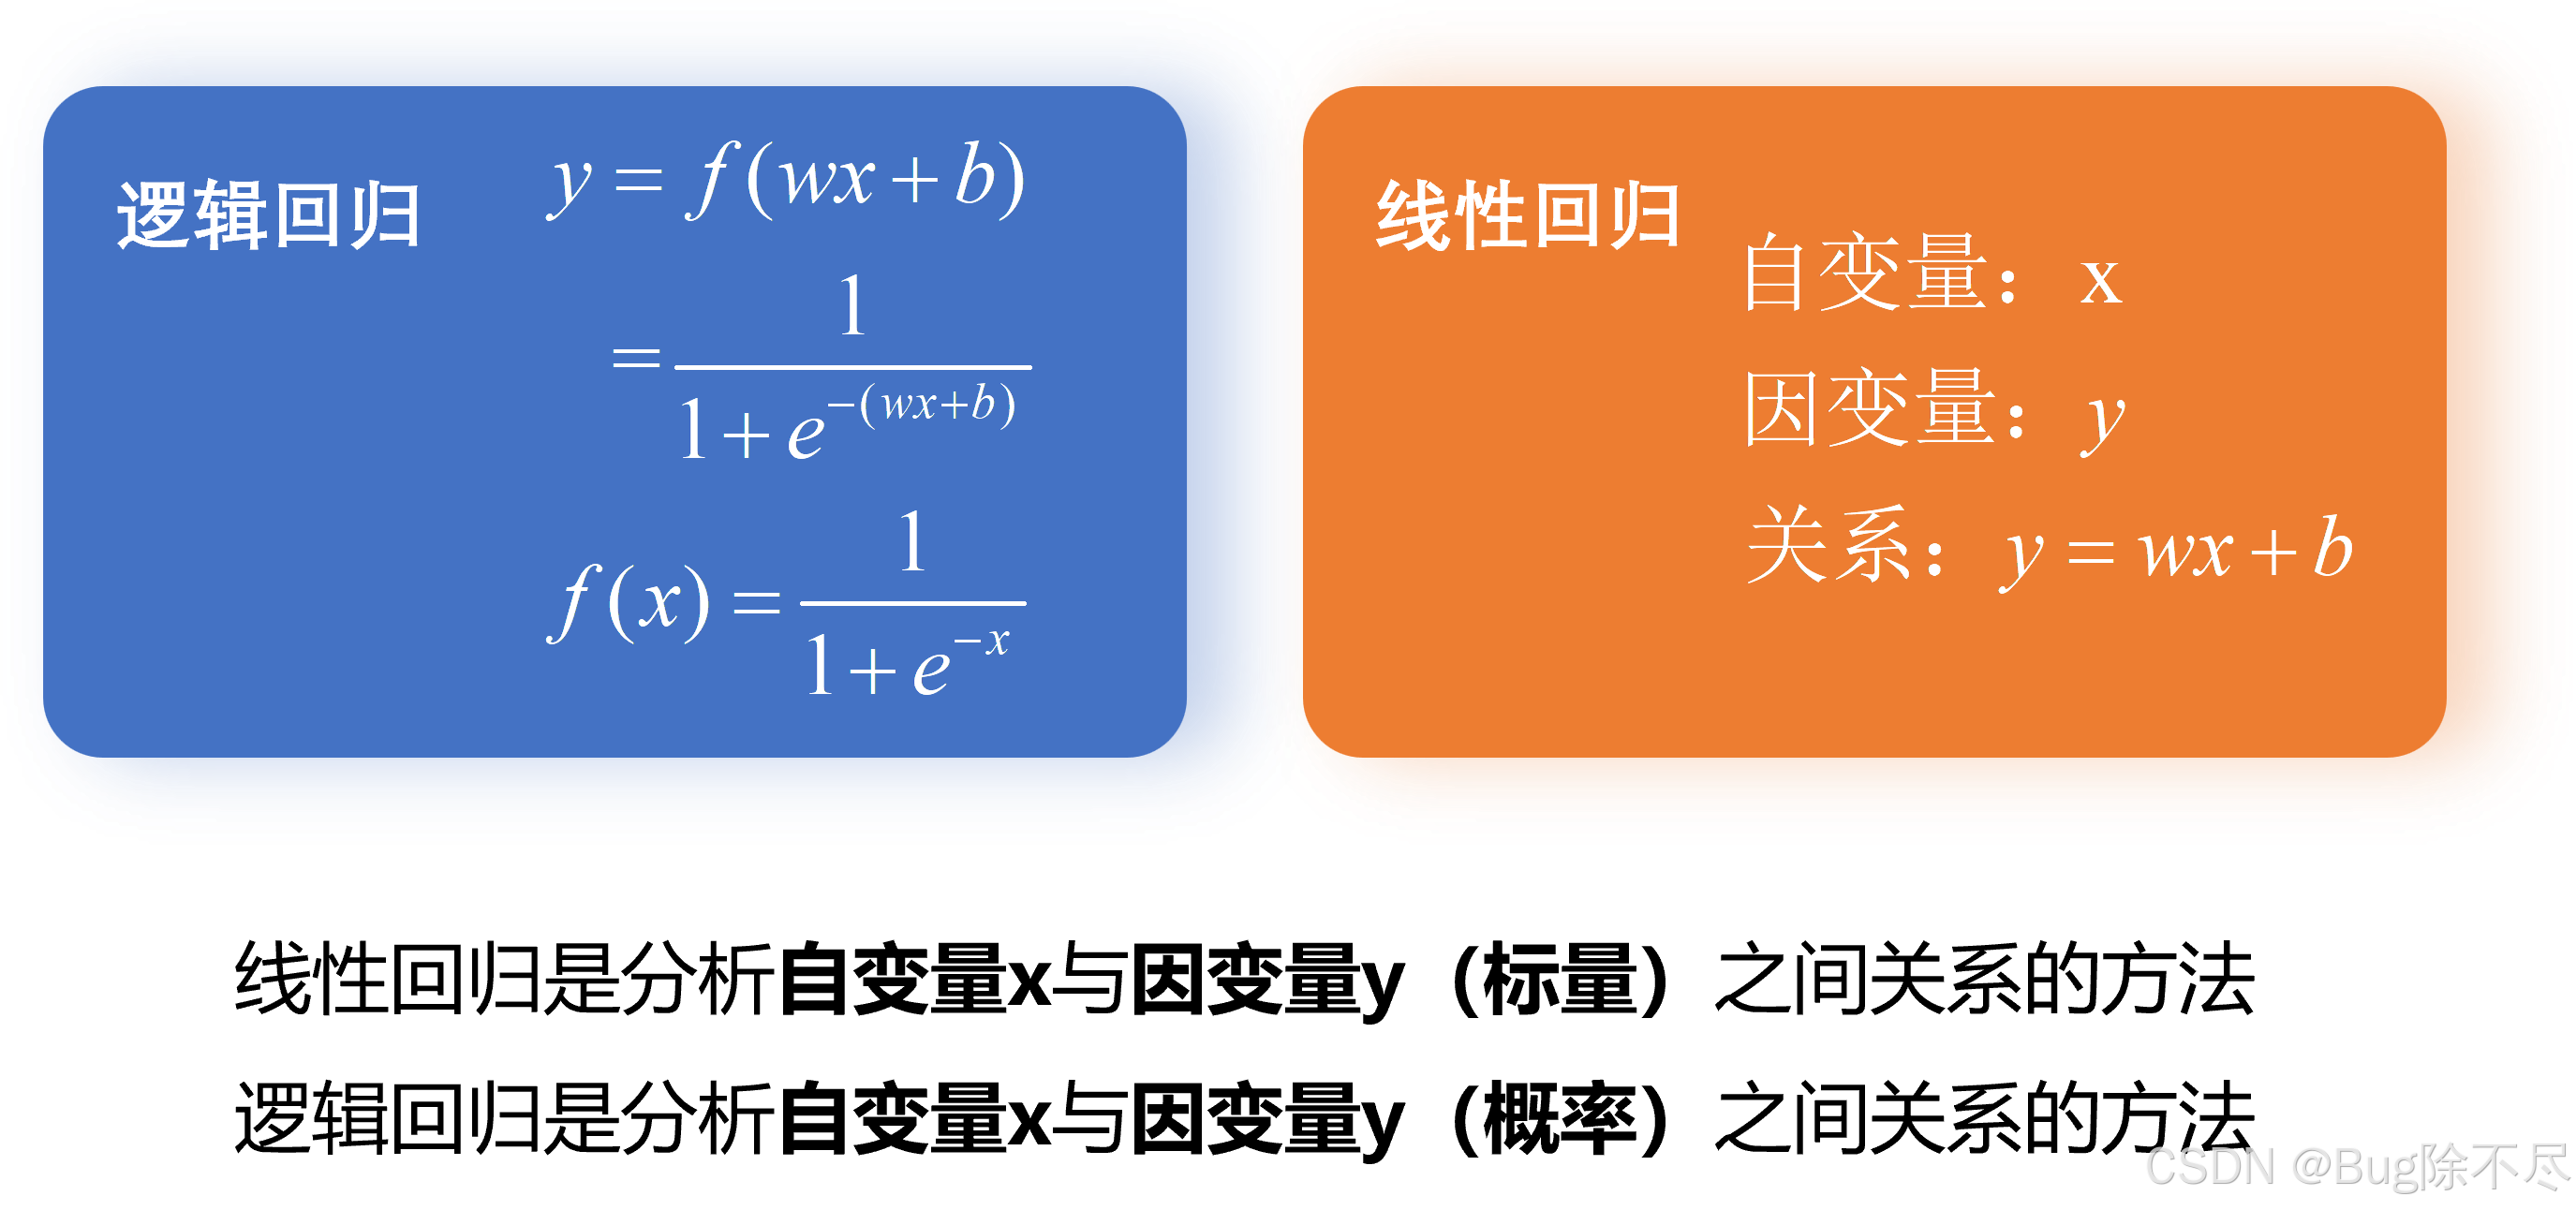
逻辑回归也叫对数几率回归:
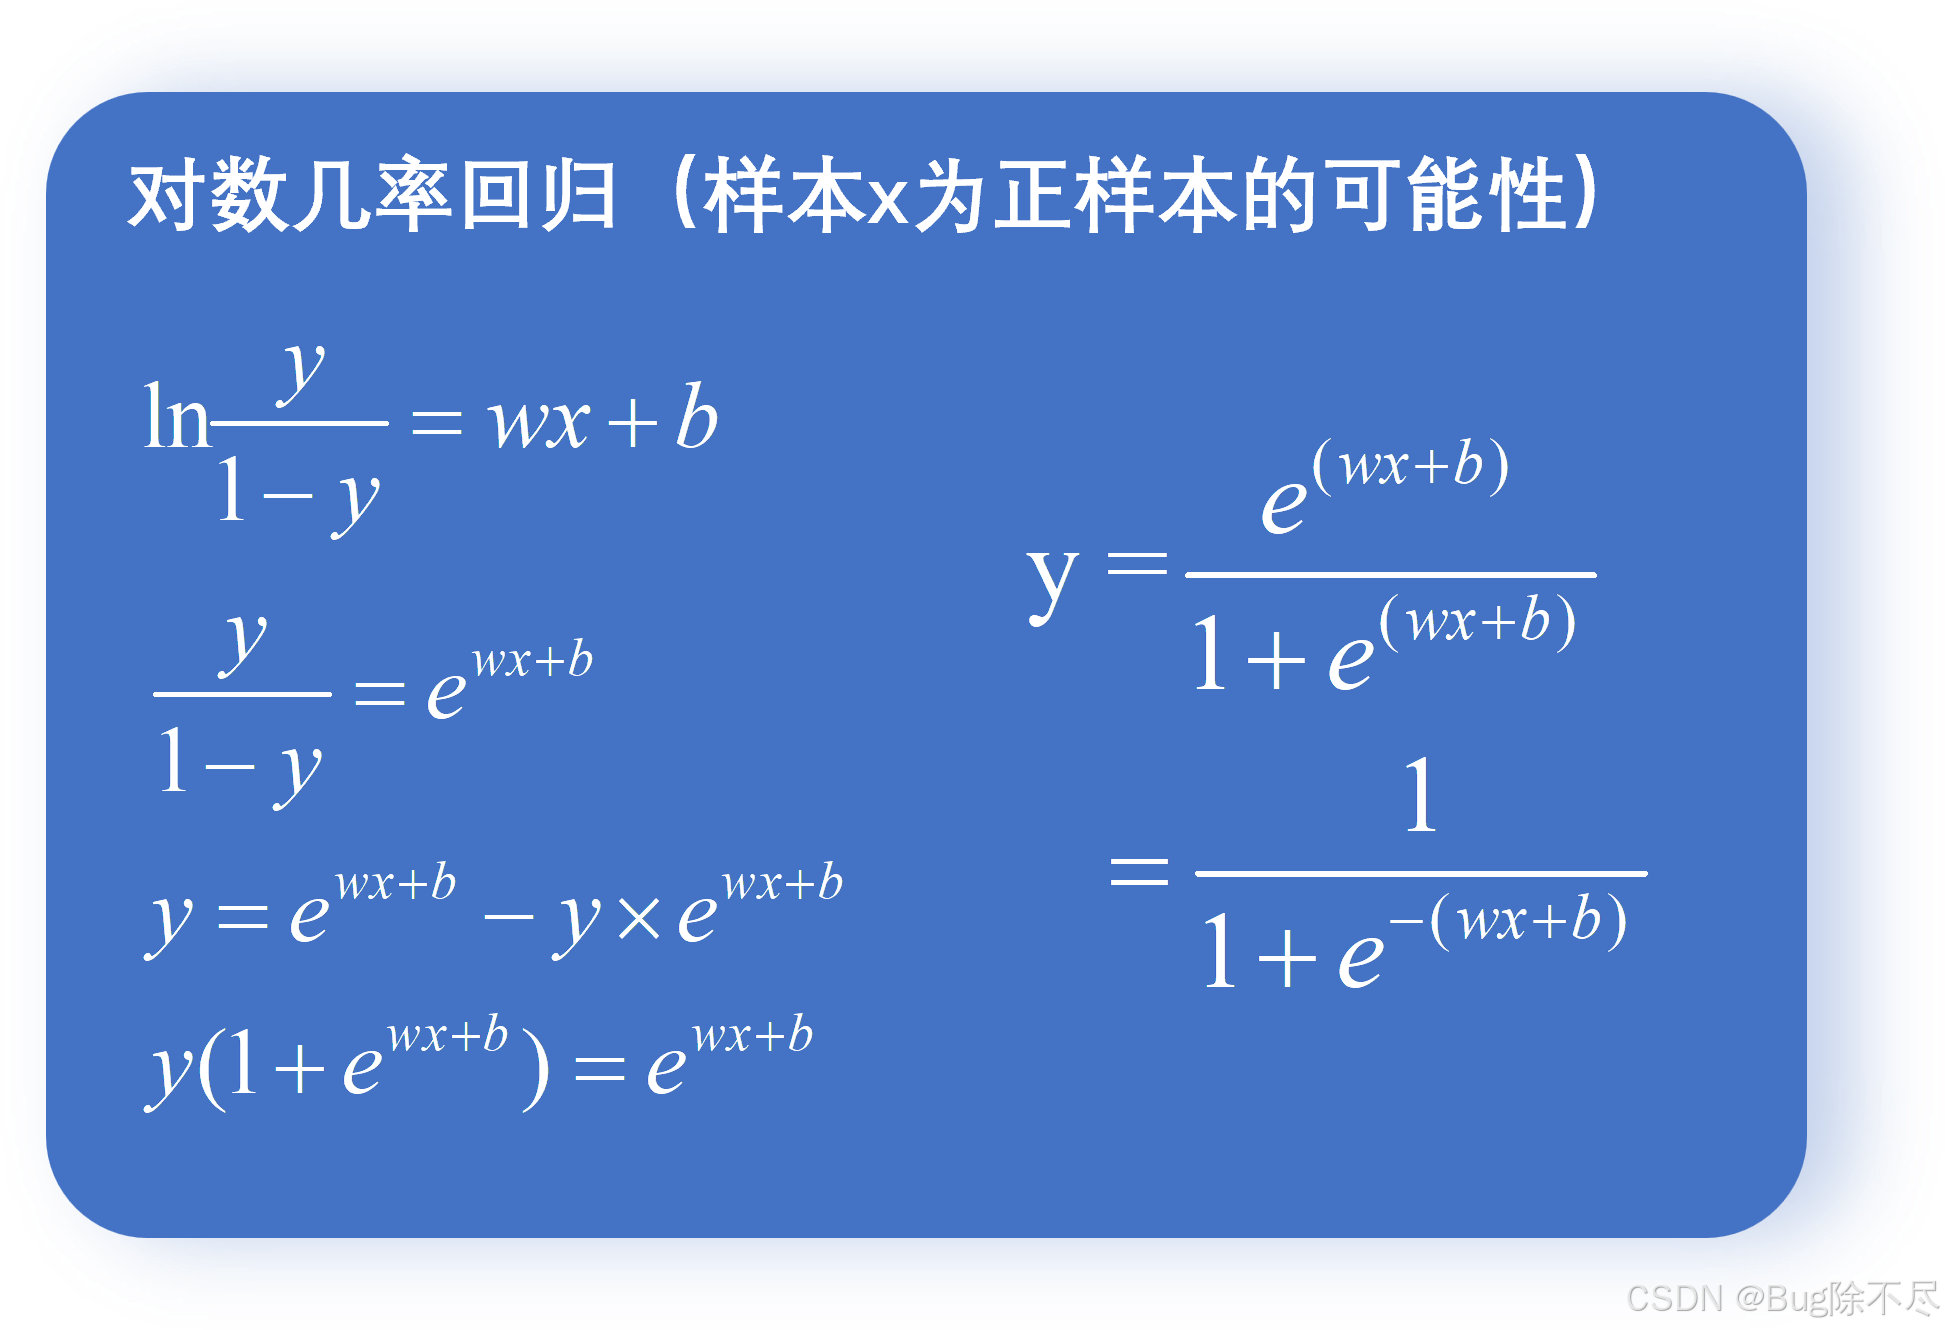
使用wx+b去拟合一个对数几率
3.2 二元逻辑回归模型(实现)
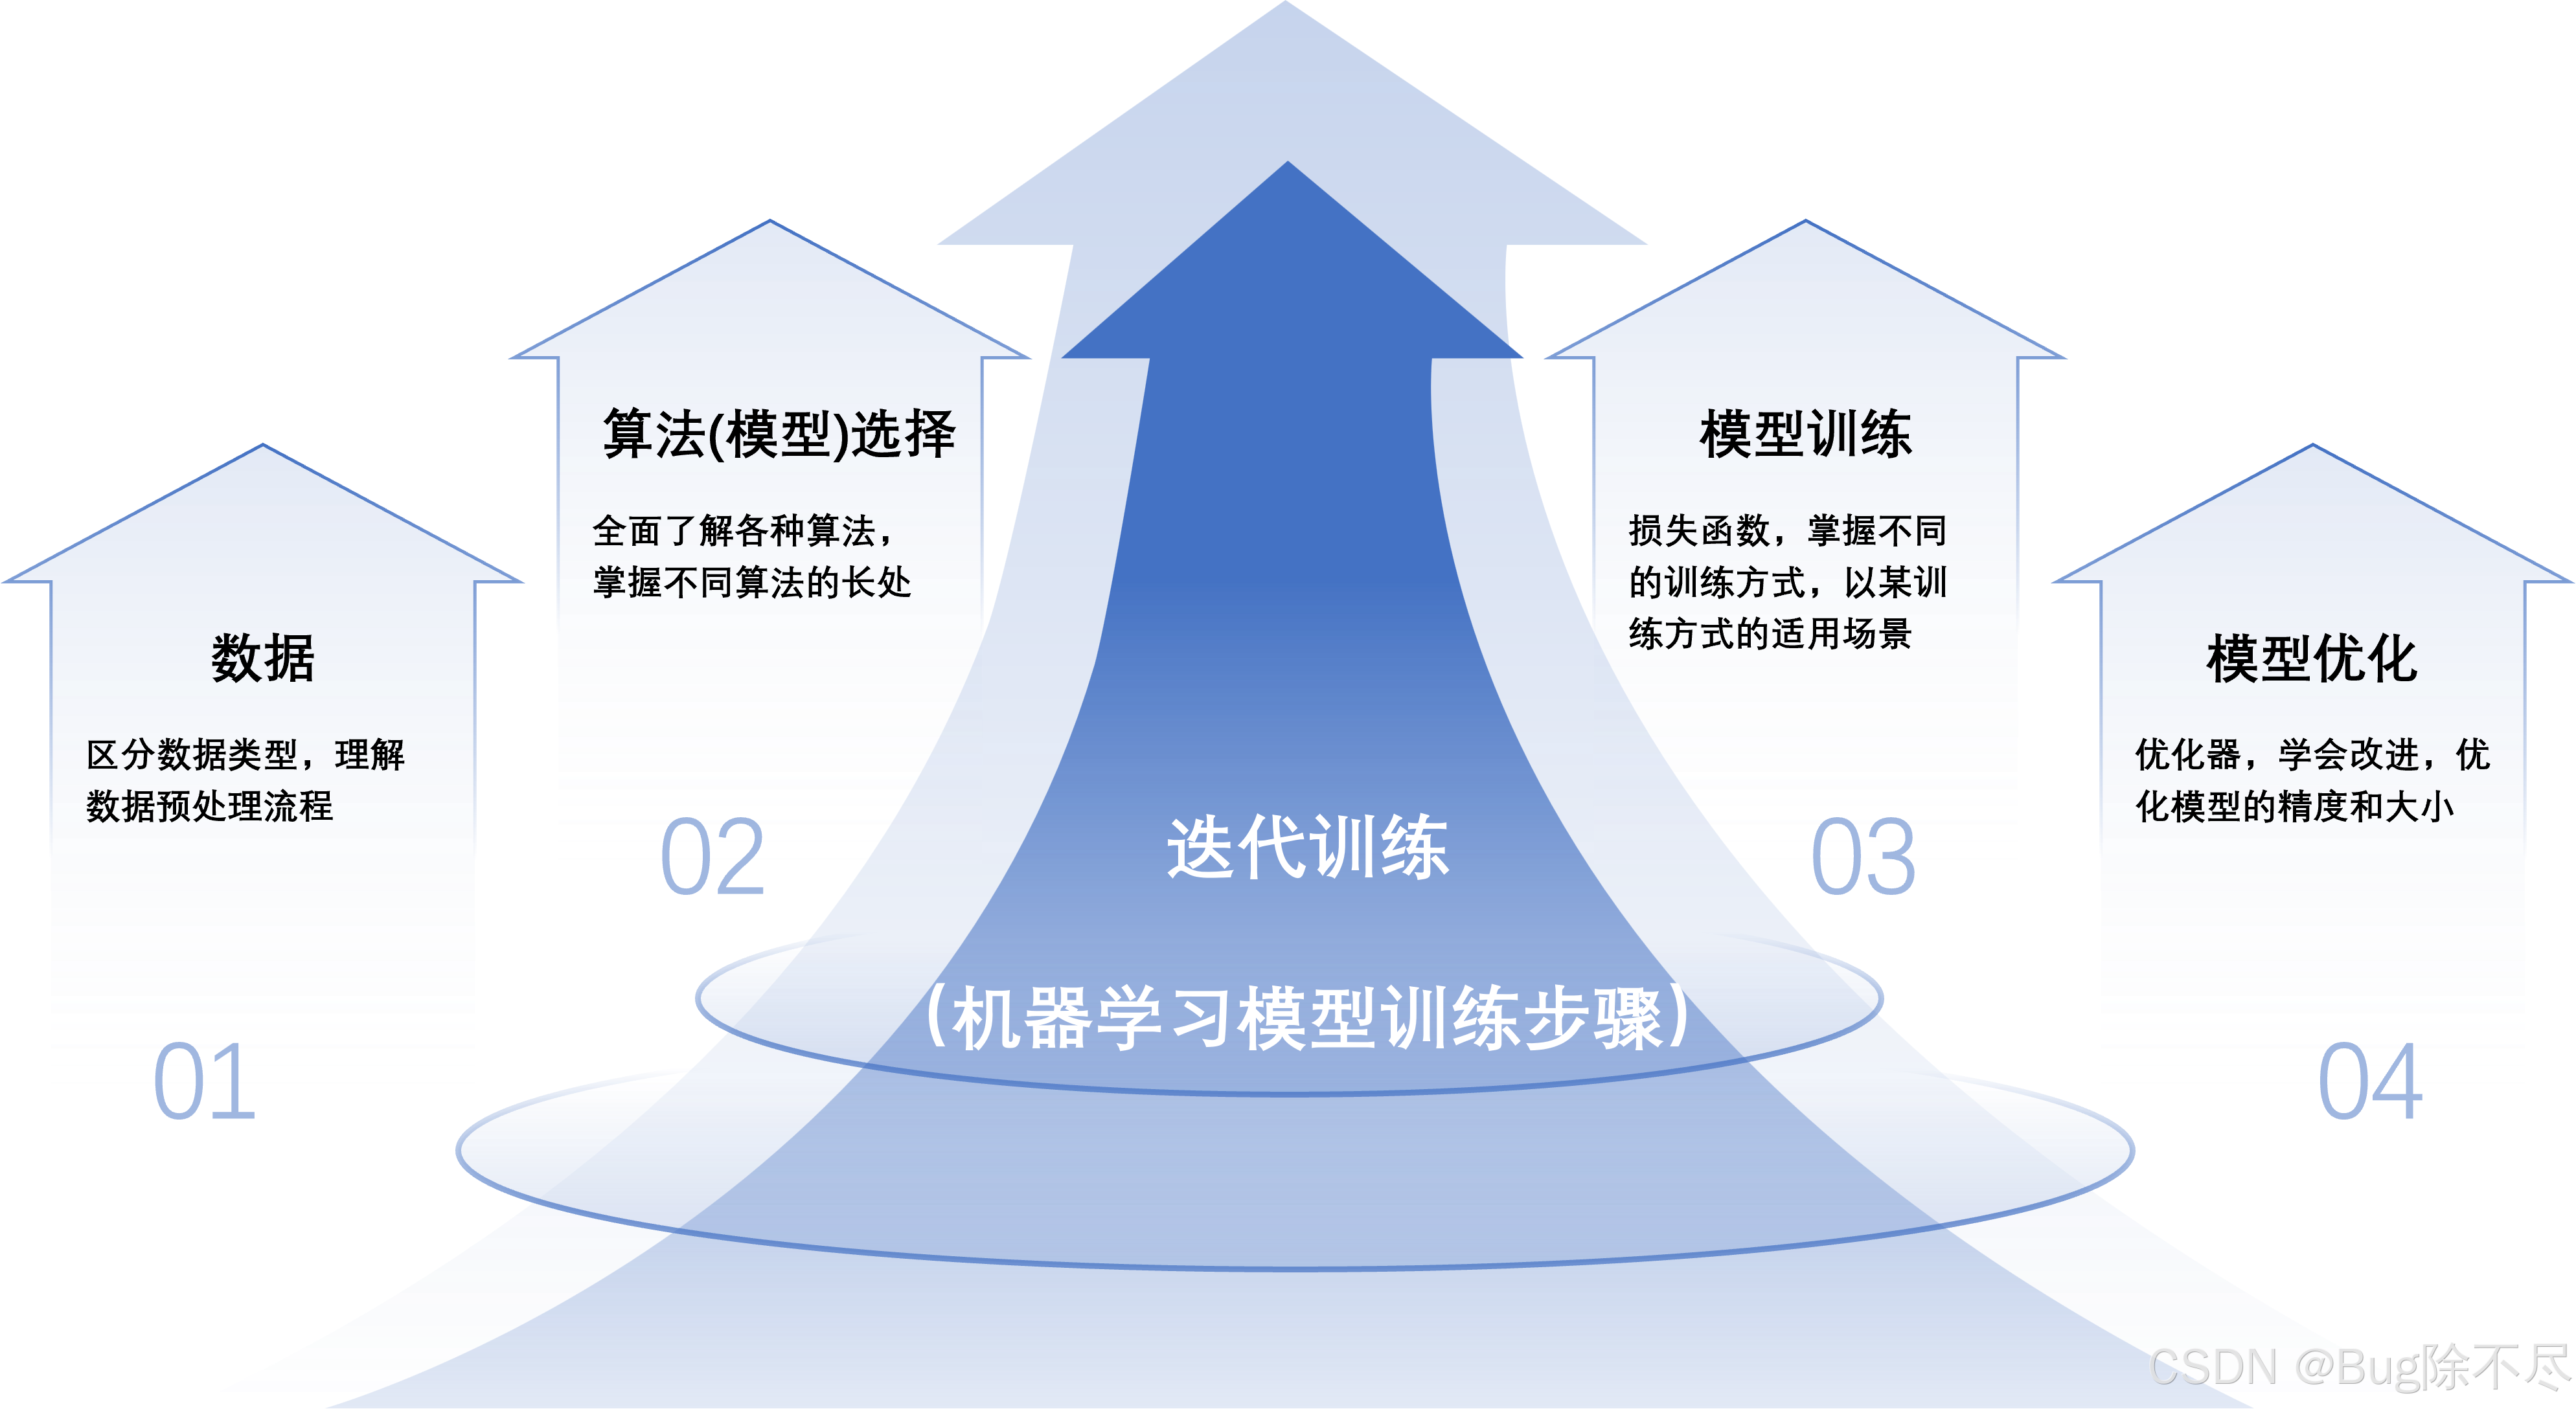
首先,我们需要了解基本的解决思路和步骤:
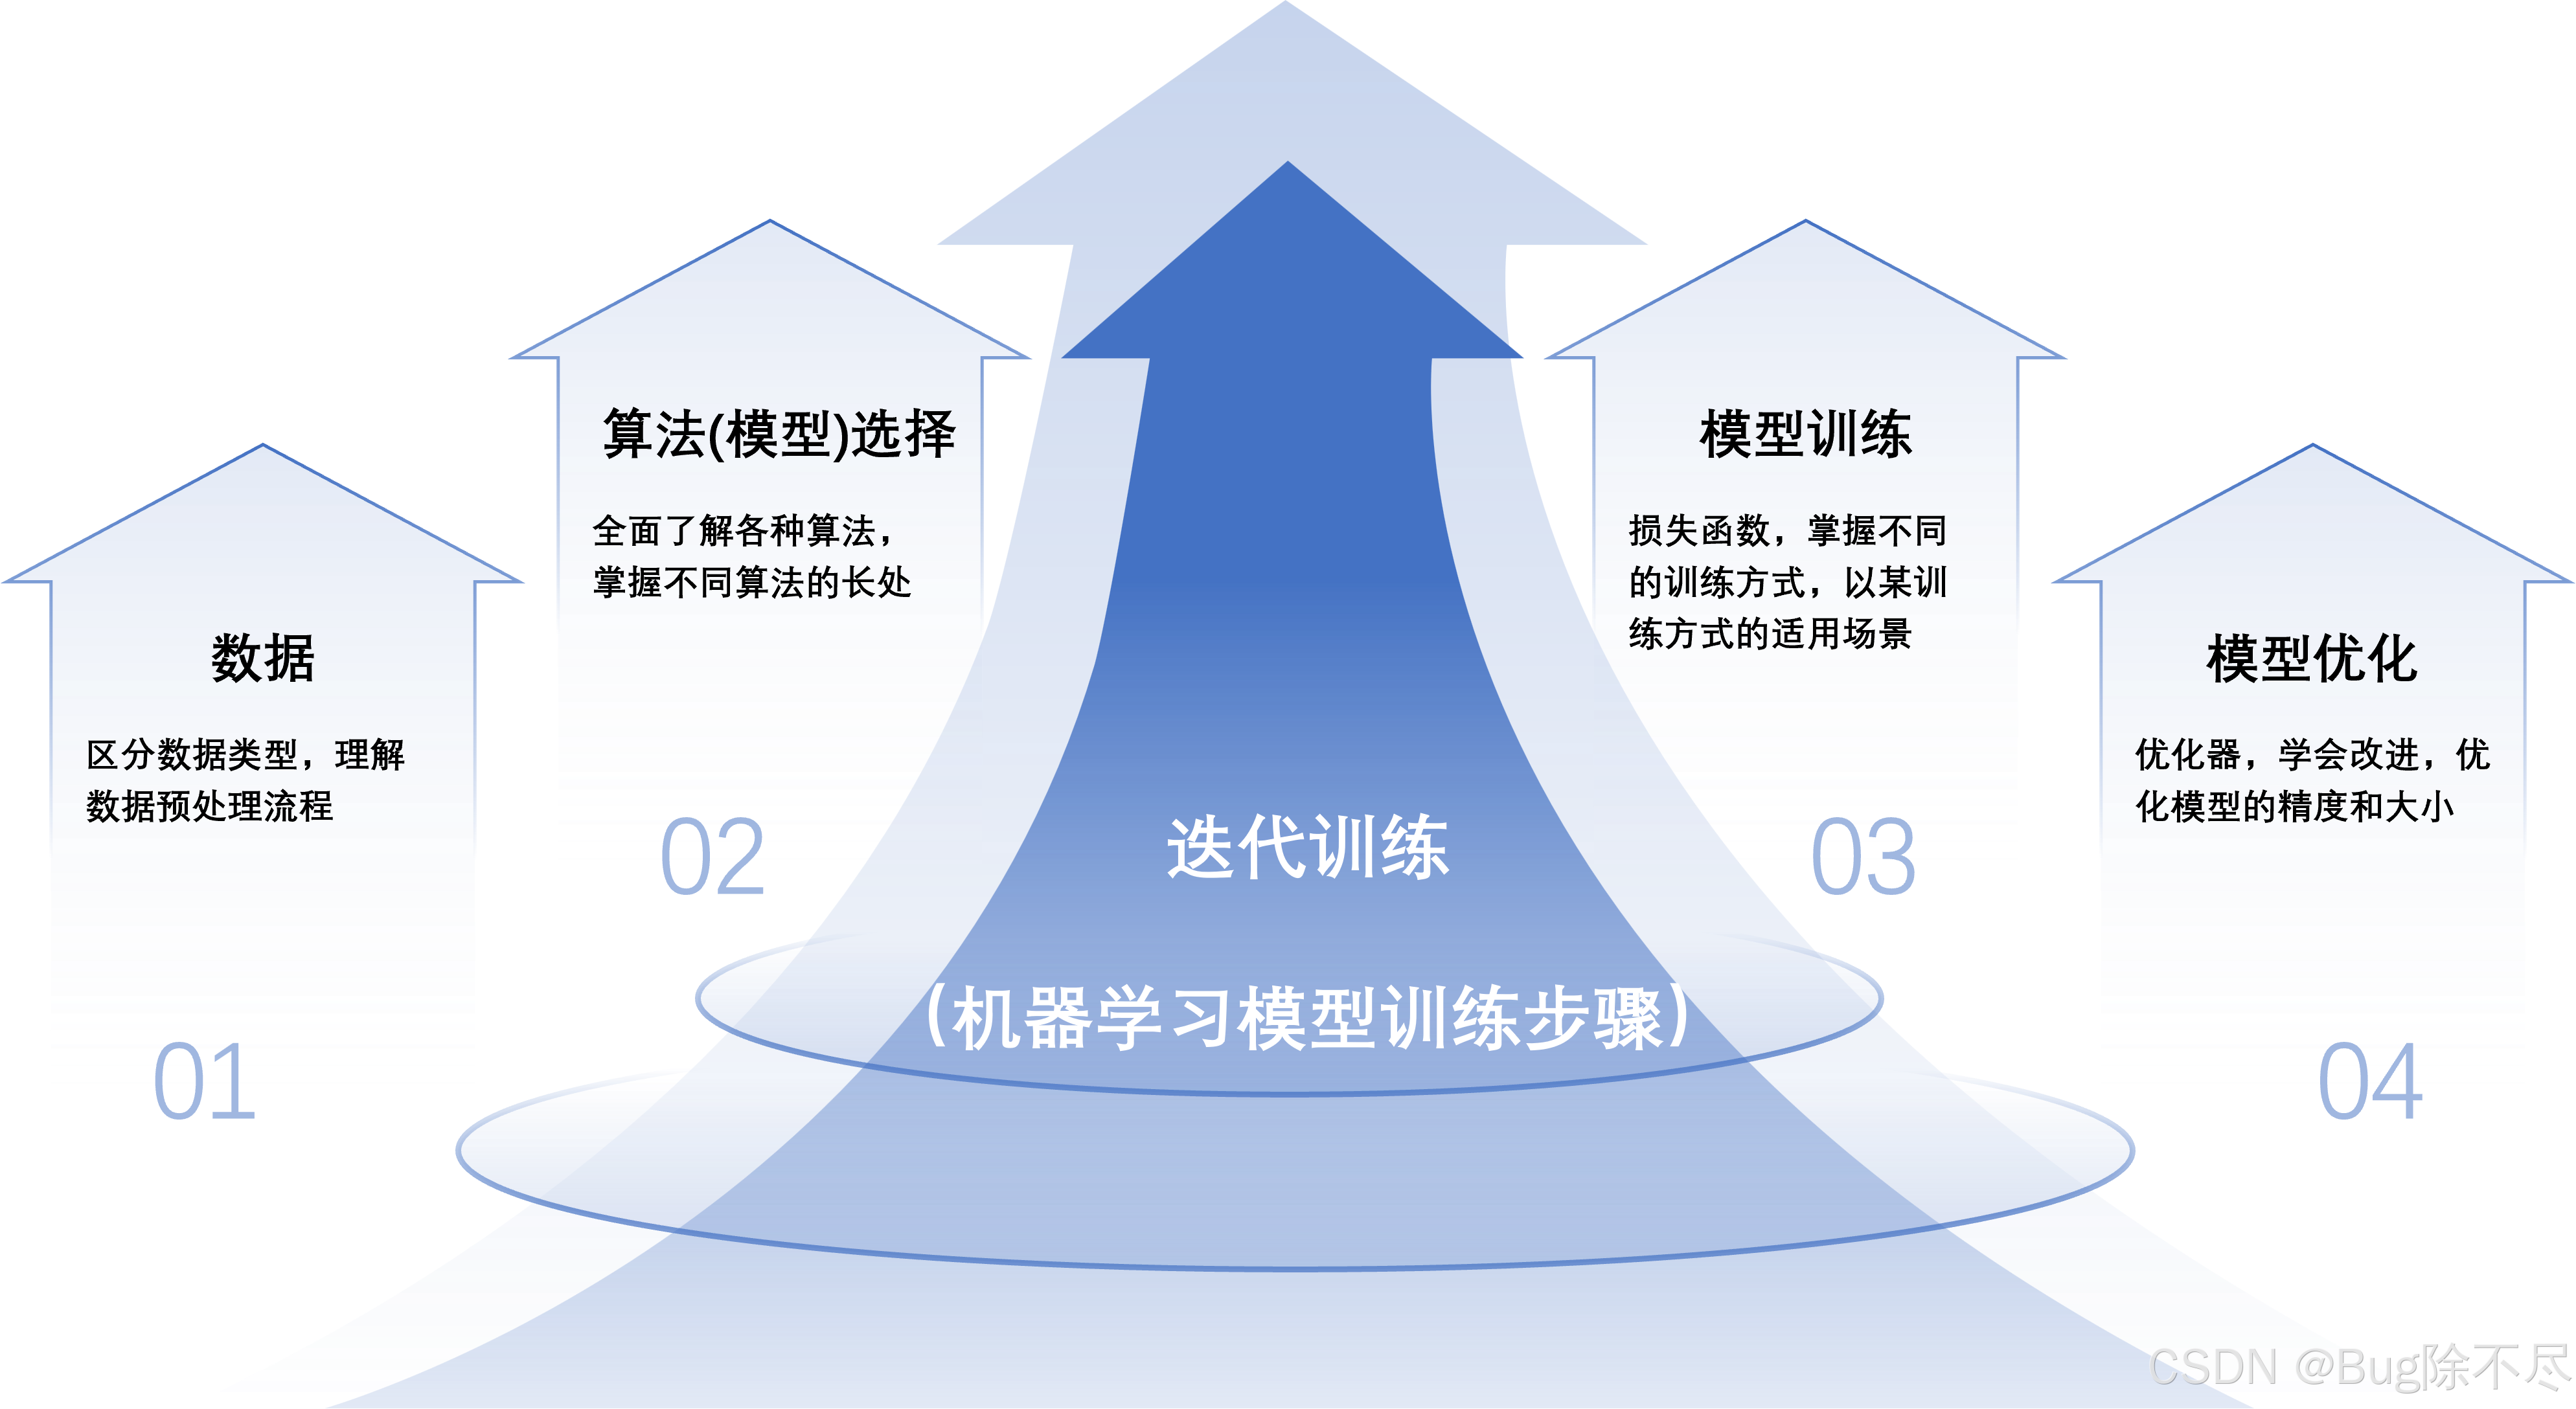
每一个机器学习的过程都会基本符合上述步骤流程
接下来,基于上述的解决思路和步骤,来实现一个逻辑回归模型:
import torch
import torch.nn as nn
import matplotlib.pyplot as plt
import numpy as np
torch.manual_seed(10)

# 01 数据--使用正态分布自定义相应的随机测试拟合数据
sample_nums = 100
mean_value = 1.7
bias = 1
n_data = torch.ones(sample_nums,2)
# 类别0 数据shape=(100,2) 标签shape=(100,1)
x0 = torch.normal(mean_value*n_data,1)+bias
y0 = torch.zeros(sample_nums)
# 类别1 数据shape=(100,2) 标签shape=(100,1)
x1 = torch.normal(-mean_value*n_data,1)+bias
y1 = torch.ones(sample_nums)
train_x = torch.cat((x0,x1),0)
train_y = torch.cat((y0,y1),0)

# 02 算法(模型)选择
class LR(nn.Module):
    def __init__(self):
        super(LR,self).__init__()
        self.features = nn.Linear(2,1)
        self.sigmoid = nn.Sigmoid()

    def forward(self, x):
        # 设定前向传播
        x = self.featues(x)
        x = self.sigmoid(x)
        return x

# 实例化逻辑回归模型
lr_net = LR()

# 03 模型训练;损失函数
loss_fn = nn.BCELoss()

# 04 模型优化;优化器
lr = 0.01
optimizer = torch.optim.SGD(lr_net.parameters(),lr=lr,momentum=0.9)

# 05 迭代训练更新
for iteration in range(1000):
    # 前向传播
    y_pred = lr_net(train_x)

    # 计算loss
    loss = loss_fn(y_pred.squeeze(),train_y)

    # 反向传播
    loss.backward()

    # 优化器更新参数
    optimizer.step()

    # 训练过程可视化--绘图
    if iteration % 20 ==0:
        mask = y_pred.ge(0.5).float().squeeze() #以0.5为阈值进行分类
        correct = (mask == train_y).sum() #计算正确预测的样本个数
        acc = correct.item()/train_y.size(0) #计算分类准确率
        plt.scatter(x0.data.numpy()[:,0], x0.data.numpy()[:,1],c='r', label='class 0')
        plt.scatter(x1.data.numpy()[:,0],x1.data.numpy()[:,1],c='b', label='class 1')

        w0,w1 = lr_net.features.weight[0]
        w0,w1 = float(w0.item()),float(w1.item())
        plot_b = float(lr_net.features.bias[0].item())
        plot_x = np.arange(-6,6,0.1)
        plot_y = (-w0*plot_x-plot_b)/ w1

        plt.xlim(-5,7)
        plt.ylim(-7,7)
        plt.plot(plot_x,plot_y)

        plt.text(-5,5,'Loss=%.4f' % loss.data.numpy(),fontdict={'size':20, 'color': 'red'})
        plt.title("Iteration: {}\n w0:{:.2f} w1:{:.2f} b: {:.2f} accuracy:{:.2%}".format(iteration, w0, w1, plot_b, acc))
        plt.legend()
        plt.show()
        plt.pause(0.5)
        if acc > 0.99:
            break
3.3 模型结果分析
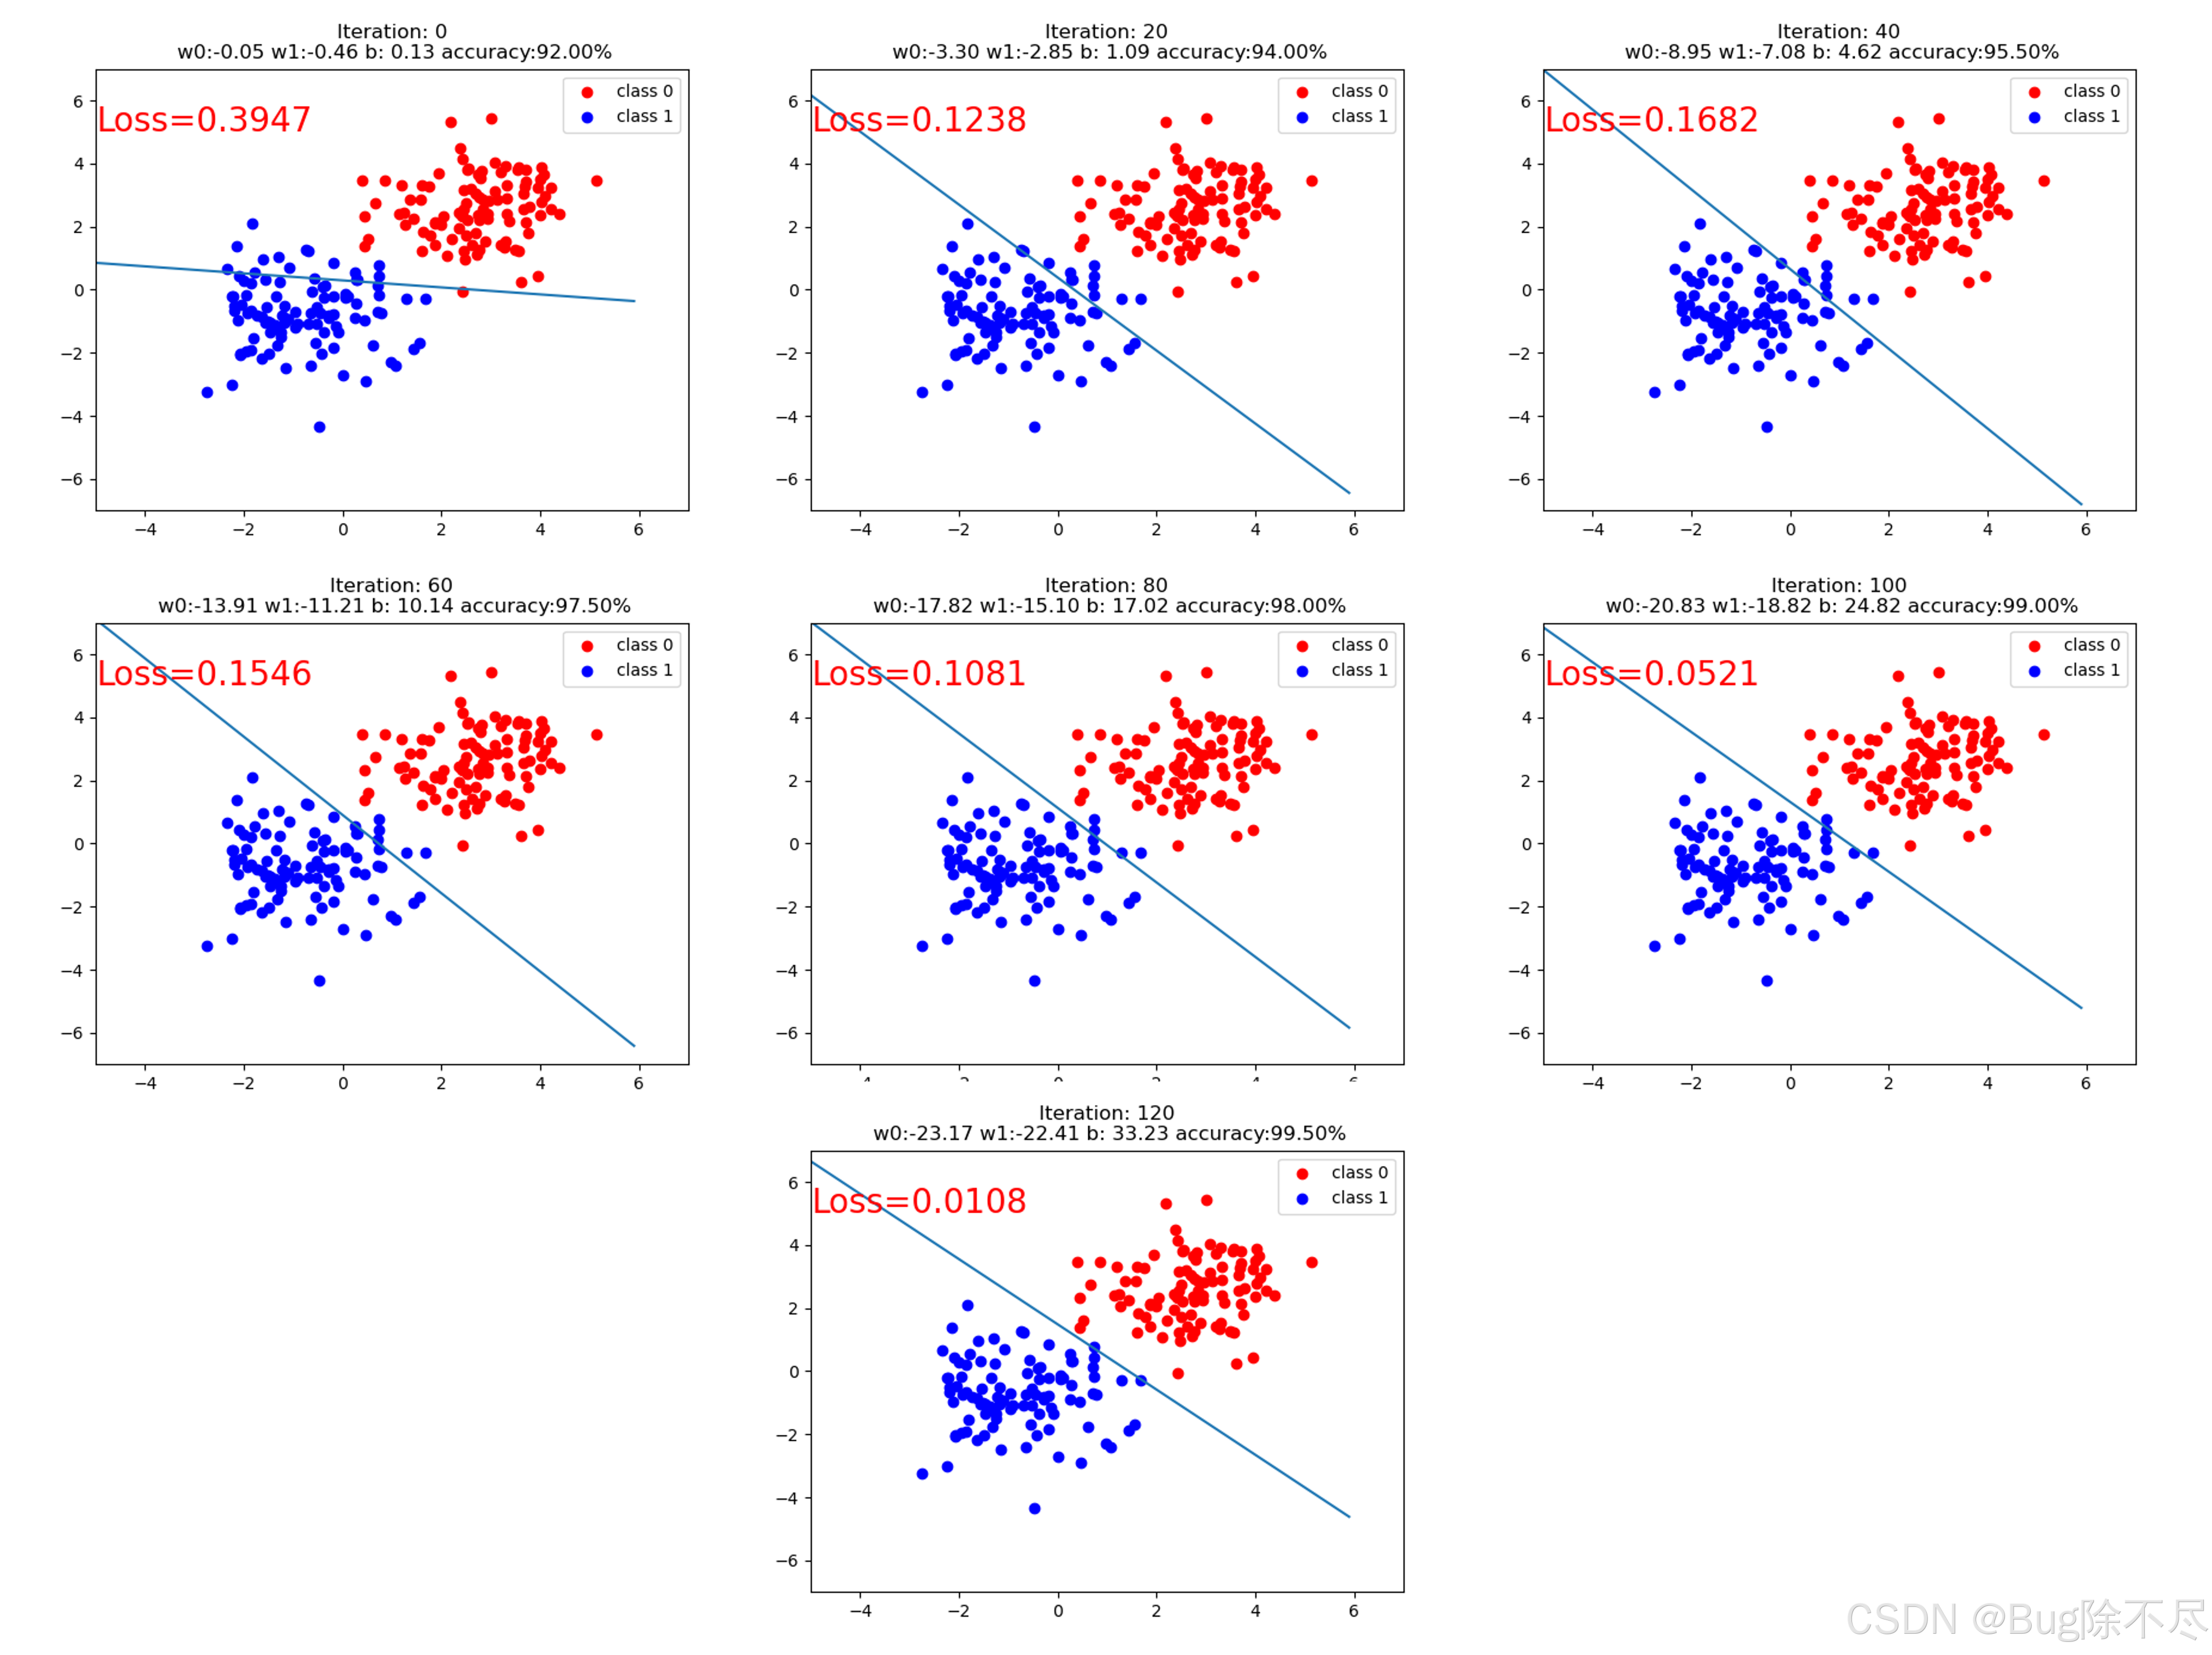
收敛时,分类准确率为99.5%
经过上述实现过程,需要牢记5个步骤,并之后学习中不断强化练习:
***个人学习过程总结,持续记录ing


 扫一扫


 3299

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


