



学习记录总结专栏:机器学习:PyTorch框架-个人学习总结(专栏) https://blog.csdn.net/spiderb/category_12838886.html
1 前言
经过前面的实例学习,其实我们可以发现:相较于传统的机器学习,神经网络的模型训练过程是一种端到端的过程,简化中间过程,核心是损失函数更新参数,这就把传统任务简化了。

人工智能、机器学习、神经网络、深度学习之间的关系
人工智能的研究大约是从 20 世纪 50 年代开始的,其发展史与计算机的发展史有所重合,可以划分为以下 3 次热潮:
- 20 世纪 50 ~ 60 年代,逻辑为主,智力游戏;
- 20 世纪 80 年代,知识为主,机器人、机器翻译;
- 2010 年至今,数据为主,模式识别、语音识别。
在人工智能领域,神经网络(Neural Network,NN)是近年来的热门话题。深度学习是人工智能领域一种具有代表性的实现方法。而深度学习是以神经网络为出发点的。曾经被媒体报道过的相关内容就有:
- 2012 年--在世界性的图像识别大赛ILSVRC中,使用深度学习技术的Supervision方法取得了完胜;
- 2012年--利用谷歌公司开发的深度学习技术,人工智能从 YouTube 的视频中识别出了猫;
- 2014年--苹果公司将Siri的语音识别系统变更为使用深度学习技术的系统;
- 2016年--利用谷歌公司开发的深度学习技术,AlphaGo 与世界顶级棋手对决,取得了胜利;
- 2016年--奥迪、宝马等公司将深度学习技术运用到汽车的自动驾驶中
- ………………
神经网络是以生物学研究中神经元抽象出来的数学模型为出发点的。相应的神经单元的数学模型可表示为(有/无输出信号):
即,有无信号输出是通过神经单元的阈值进行判定的。但是,推广到一般的情况下的话,神经单元的输出其实可以是任意数值。而在之前的第(6)章节的内容中,我们已经了解了sigmoid激活函数的作用——输出结果映射到一个概率空间。那么,这时我们公式可为:
其中a为激活函数(activation function);b为阈值(偏置-bias),其大小对神经单元的敏感/兴奋程度有影响。
*激活函数在数学上可以使用单调递增的可导函数来替代sigmoid激活函数,原理是一样的。(容易计算)
2 神经网络
就像人脑一样(一般来说,人脑神经元的数量大约在100亿到140亿个),将多个神经单元进行连接,形成网状,那么就是神经网络。实际上,这个网络的连接和叠加方式多种多样,最终就形成了不同的神经网络吗,例如:卷积神经网络、循环神经网络等。
在神经网络中,通常按照层(layer)划分神经元,也就是我们所熟知的:输入层、隐藏层和输出层。各层分别执行特定的信号处理操作。
- 输入层负责读取给予神经网络的信息。属于这个层的神经单元没有输入箭头,它们是简单的神经单元,只是将从数据得到的值原样输出;
- 隐藏层的神经单元将多个输入整理为对输入加权。在神经网络中,这是实际处理信息的部分;同时,隐藏层具有提取输入图像的特征的作用。
- 输出层与隐藏层一样执行信息处理操作,并显示神经网络计算出的结果,也就是整个神经网络的输出。
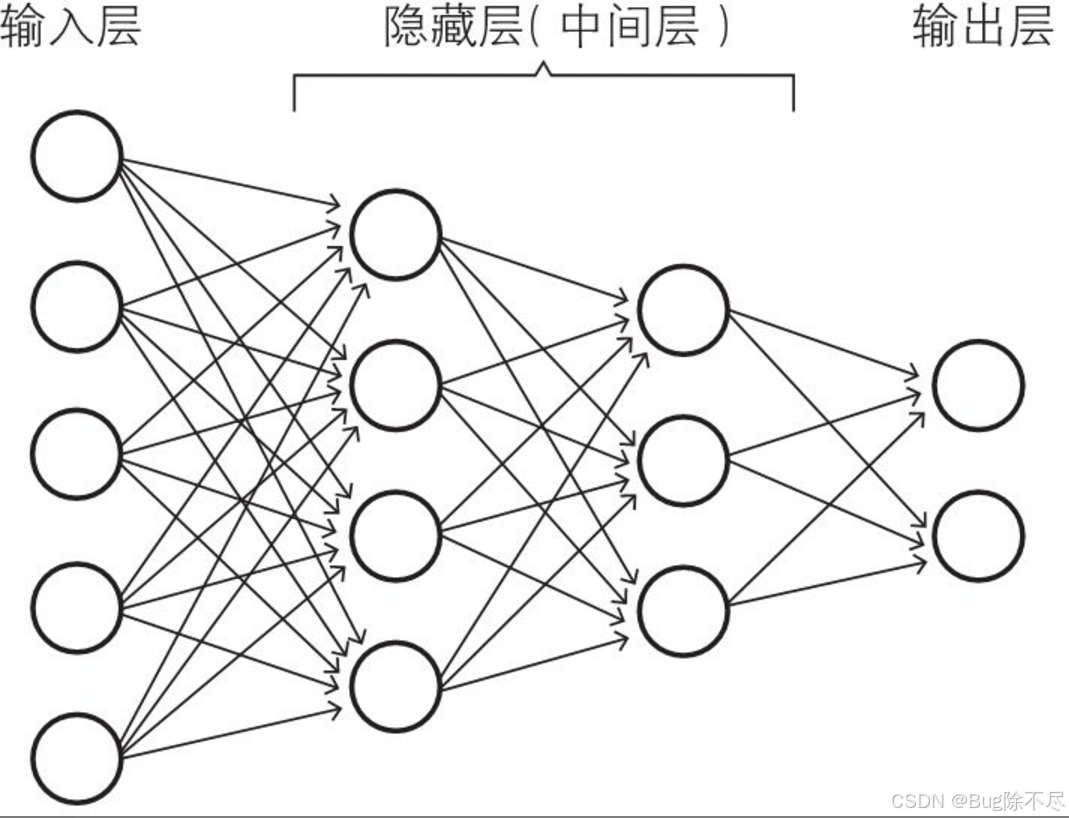
这个简单的神经网络的特征是,前一层的神经单元与下一层的所有神经单元都有箭头连接,这样的层构造称为全连接层(fully connected layer)。
其中,神经网络的参数确定方法分为有监督学习和无监督学习。为了确定神经网络的权重和偏置,事先给予数据,这些数据称为学习(训练)数据。根据给定的学习数据确定权重和偏置,称为学习(训练)过程。
在神经网络的世界中,所有神经单元的输入和输出在数学上都可以认为是用联立递推式联系起来的。
“tensor”来源于“tension”(物理学中的“张力”)。向固体施加张力时,会在固体的截面产生力的作用,这个力称为应力。这个力在不同的截面上大小和方向各不相同。当面的法向为x、y、z 轴时,作用在面上的力依次用向量表示,然后写成一个矩阵(matrix)的形式,这样的形式的量就称应力张量。因此,张量是应力张量在数学上的抽象。
而神经网络在学习训练过程中,会通过误差函数,梯度下降来自动对权重和偏置进行更更新(最优化--链式法则求导是一种方法:光滑的单变量函数 y=f(x) 在点 x 处取得最小值的必要条件是导函数在该点取值为 0)。
在用于求性能良好的神经网络的正则化技术中,经常会使用拉格朗日乘数法(在实际的最小值问题中,有时会对变量附加约束条件)
然而,在实际问题中,联立方程式组通常不容易求解,那么该如何解决呢?梯度下降法是一种具有代表性的替代方法。该方法不直接求解关系式方程,而是通过慢慢地移动图像上的点进行摸索,从而找出函数的最小值。在数值分析领域,梯度下降法也称为最速下降法。
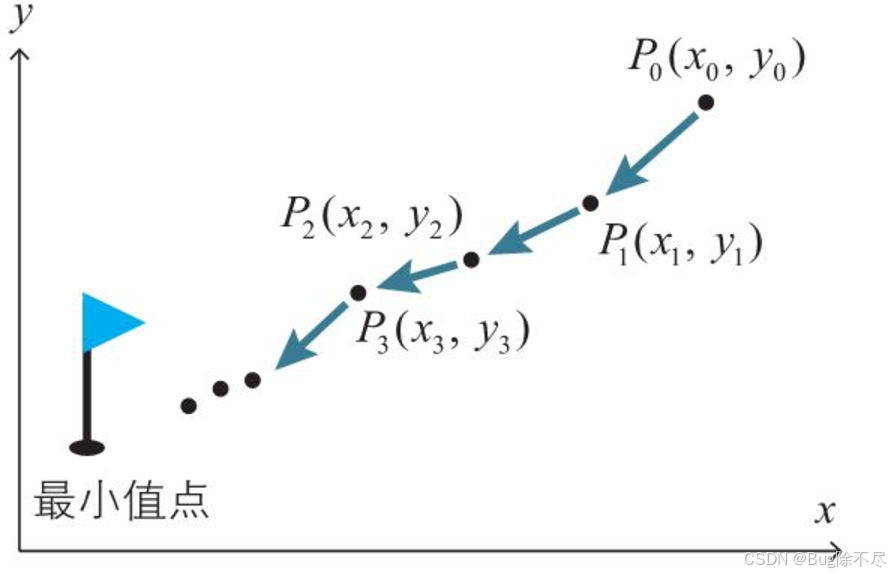
梯度下降:
为正的微小常数Δx=−η∇f(η 为正的微小常数)
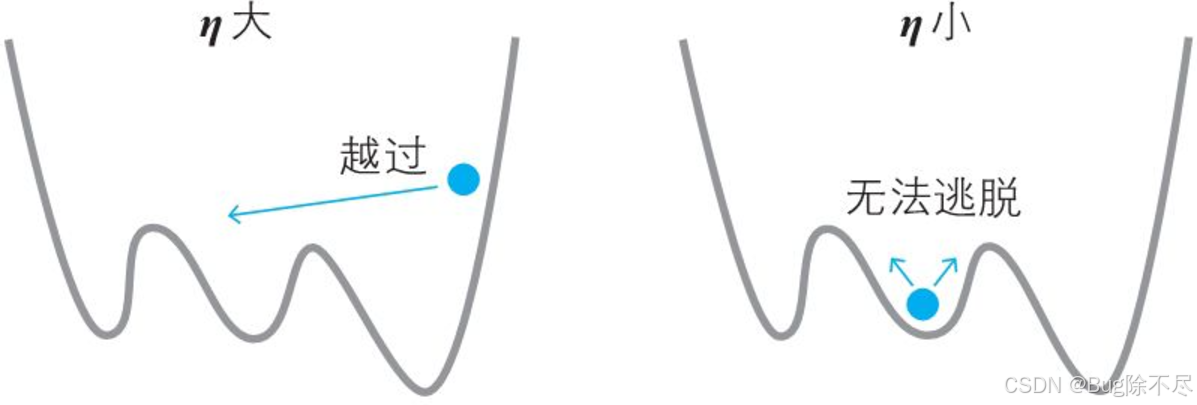
在实际使用计算机进行计算时,如何恰当地确定这个 η (学习率--移动步长)是一个大问题。根据 η 的值,可以确定下一步移动到哪个点。如果步长较大,那么可能会到达最小值点,也可能会直接跨过了最小值点(左图)。而如果步长较小,则可能会滞留在极小值点(右图)。
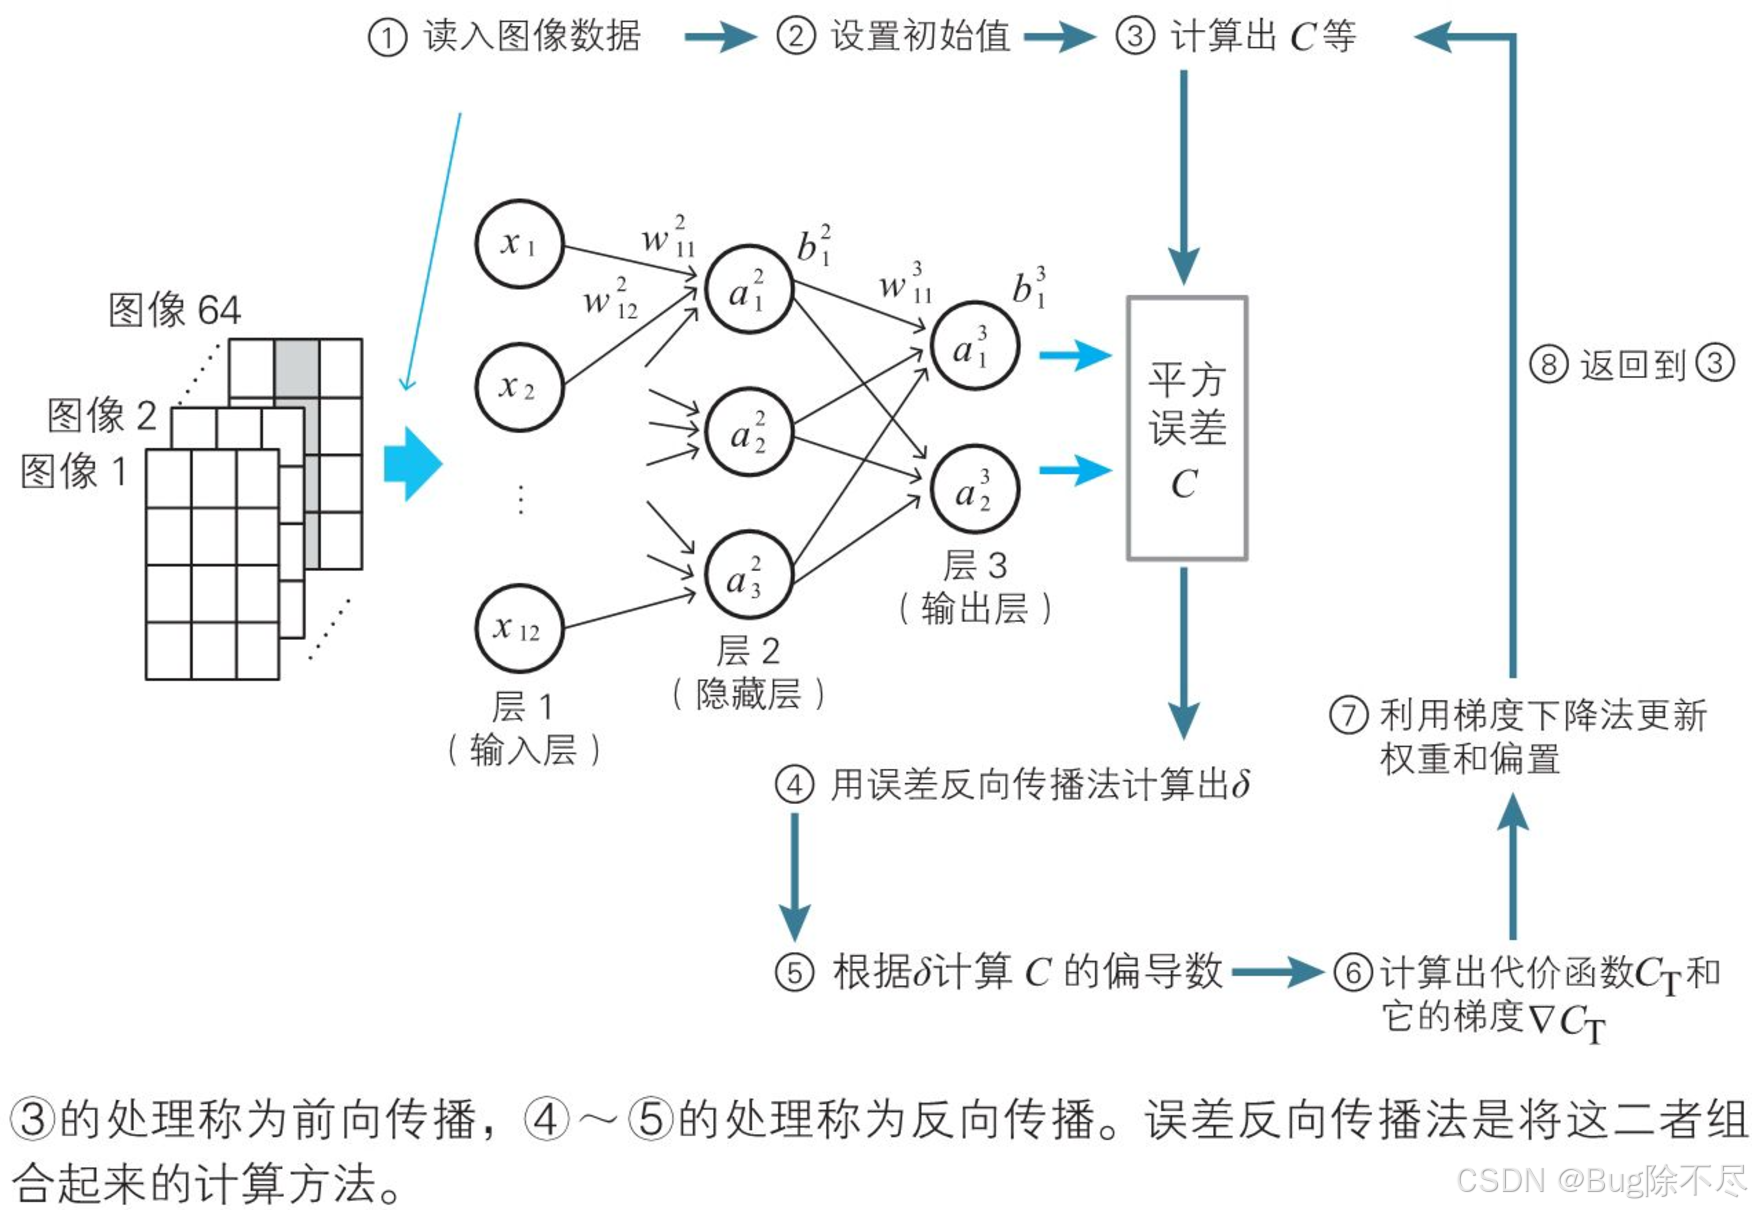
但是,由于神经网络中的变量、参数和函数错综复杂,无法直接使用梯度下降法,所以在误差反向传播中(BP神经网络),将繁杂的导数计算替换为数列的递推关系式。
3 卷积神经网络
深度学习是重叠了很多层的隐藏层(中间层,是多个由卷积层和池化层构成的层组成的)的神经网络。这样的神经网络使隐藏层具有一定的结构,从而更加有效地进行学习。
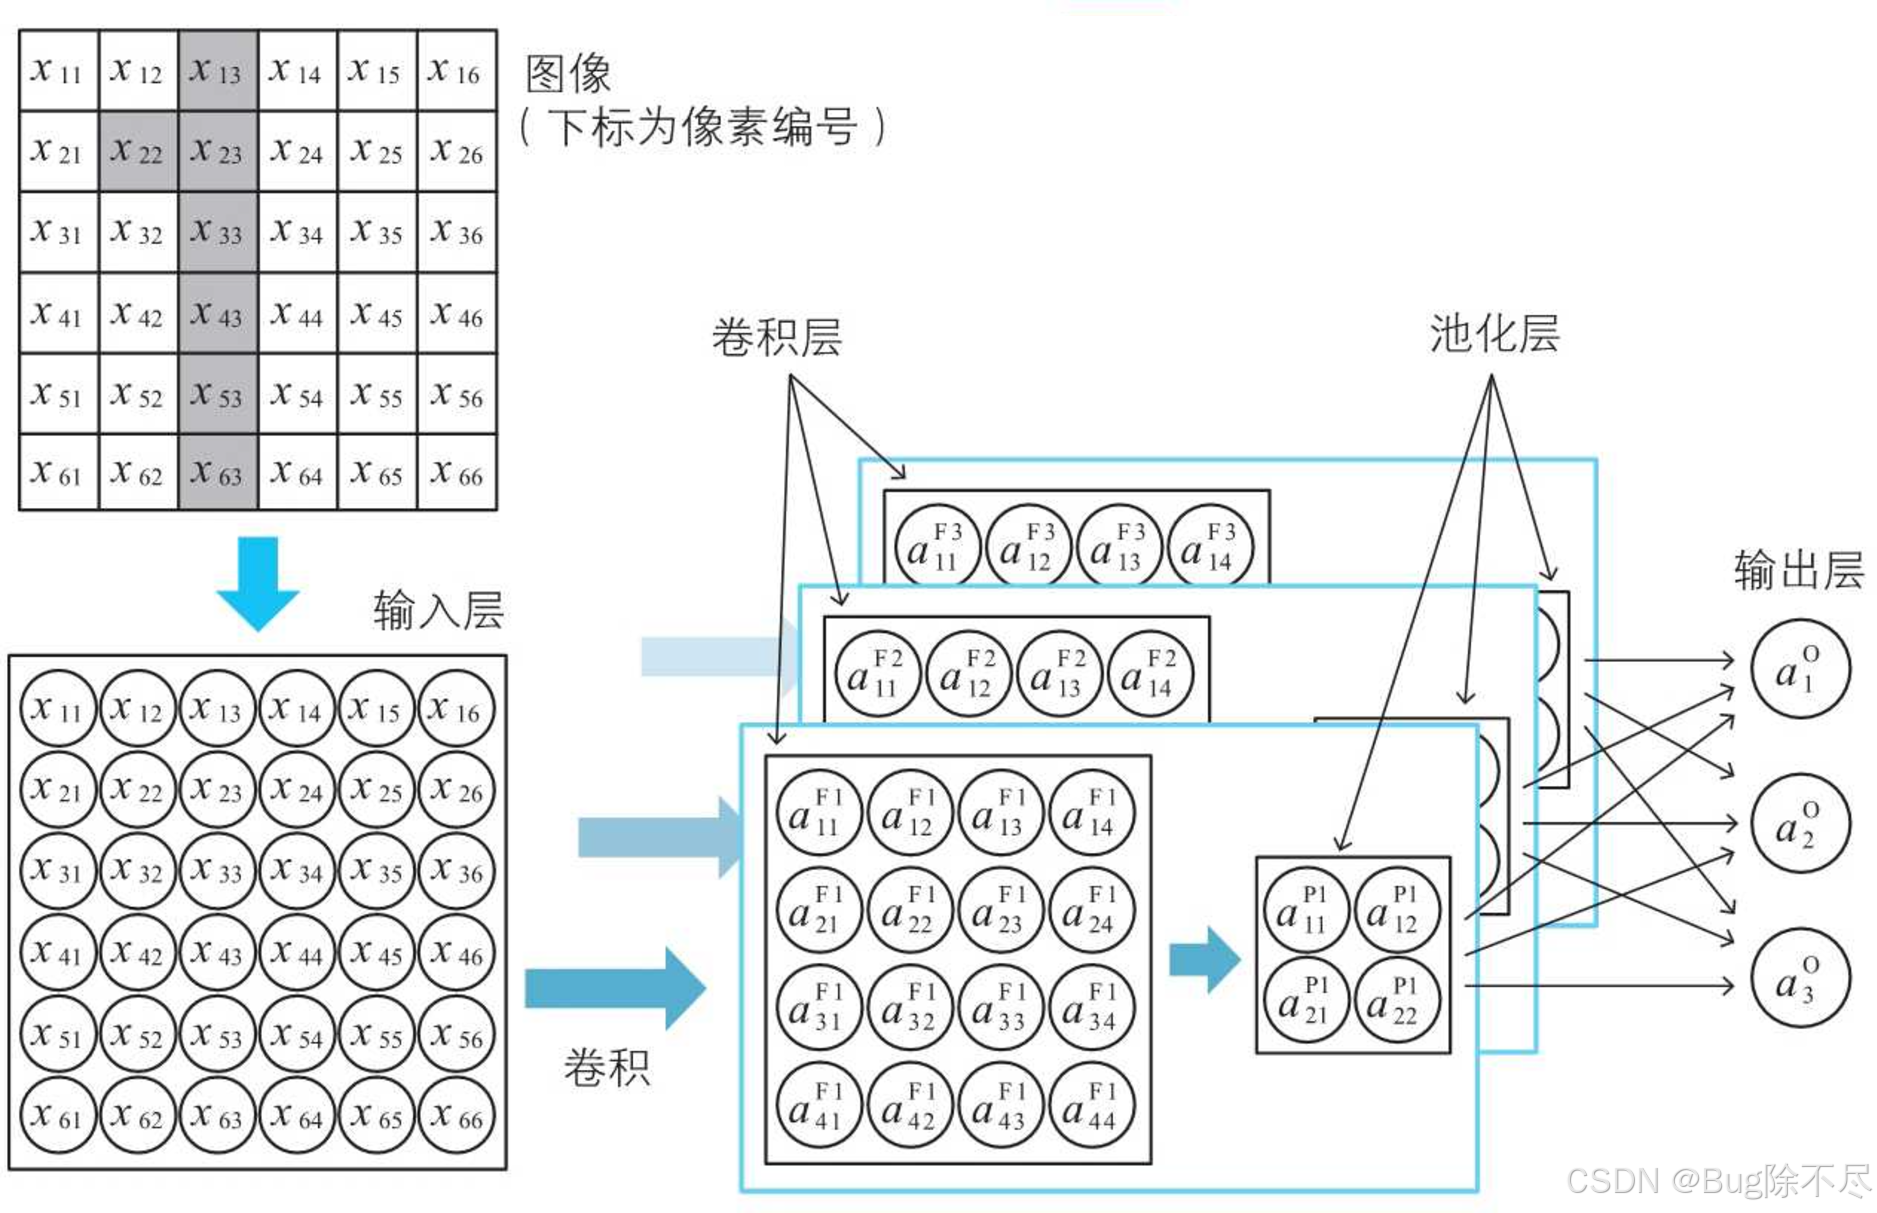
特征映射--最大池化(平均池化/L2池化)
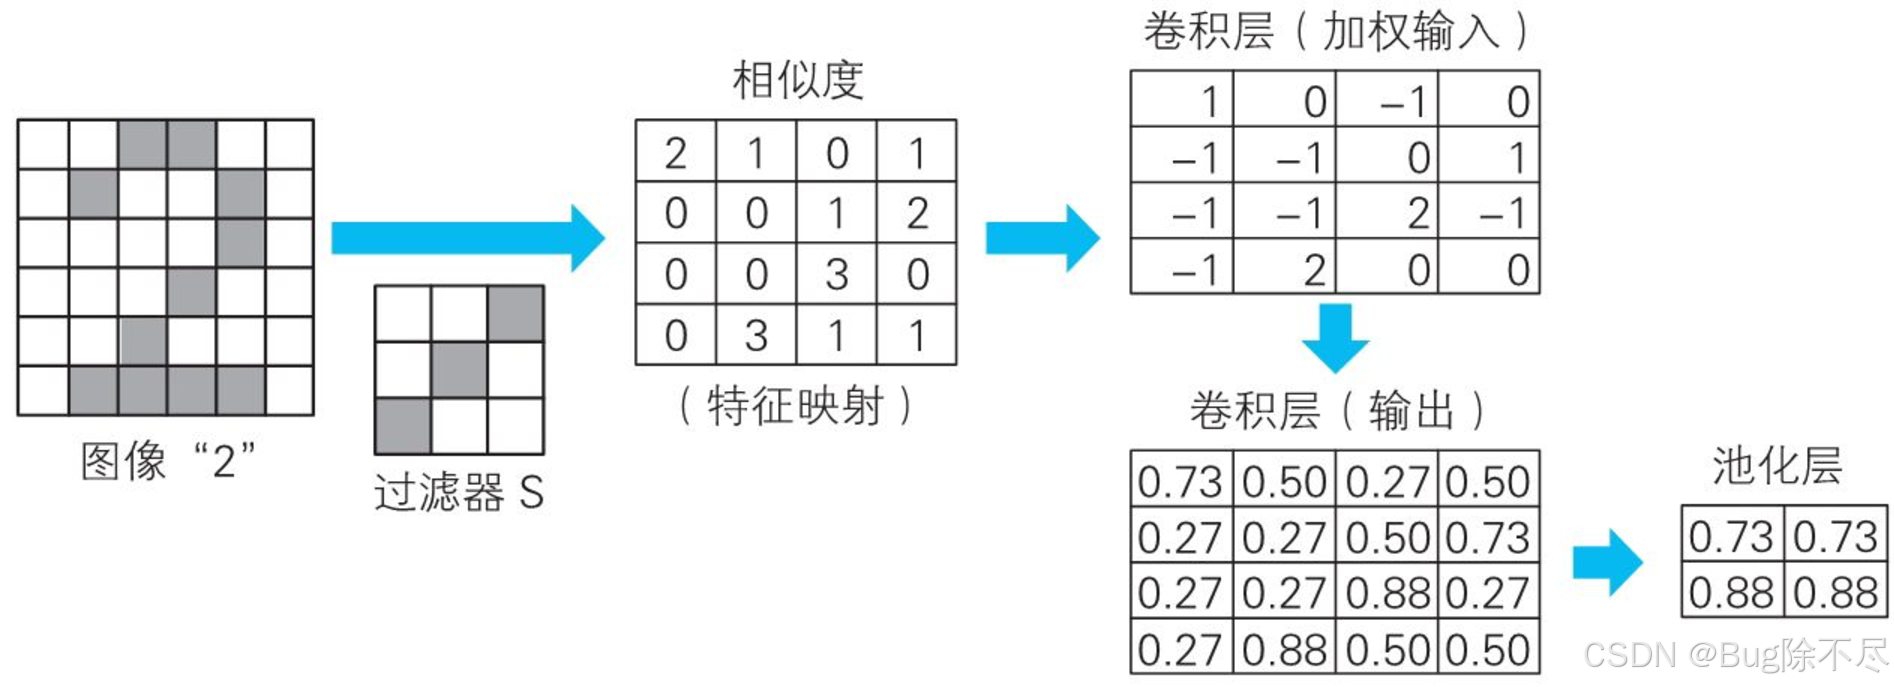
卷积神经网络的优势是:
- 对于复杂的模式识别问题,也可以用简洁的网络来处理;
- 整体而言,因为神经单元的数量少了,所以计算比较轻松。
** 卷积核(kernel)的个数需要根据应用场景进行确定,场景越复杂,卷积核的个数也会相应地增加。但对于需要多少个隐藏子层等问题,通常需要反复调试模型来确定。
4 References
| [1]王晓华著. 深度学习的数学原理与实现[M]. 北京:清华大学出版社, 2021.06. |
[2](日)涌井良幸,涌井贞美著. 深度学习的数学[M]. 北京:人民邮电出版社, 2019.05.
[3](美)伊莱·史蒂文斯(Eli Stevens),(意)卢卡·安蒂加(Luca Antiga),(德)托马斯·菲曼(Thomas Viehmann)著. PyTorch深度学习实战[M]. 北京:人民邮电出版社, 2022.02.
[4]大威作. 机器学习的数学原理和算法实践[M]. 北京:人民邮电出版社, 2021.06.
5 Author Information
基本的理论理解是编辑代码的基础,但是也不能只看理论,所以结合代码进行理解才是能够将理论结合实际的好办法。
***个人学习过程总结,持续记录ing


 扫一扫


 428

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


