Enterキーをやめて「クロ助」と呼んでみた ― 声で起動する相棒づくりで見えた、ウェイクワードの本当の壁

こんにちは!YaroTechです。継続投稿330日目、月曜日です。
先週は「X1(ThinkPad)の中だけで、クラウドに声を出さずに音声会話する」というのを5日かけて作っていました。喋り出しまで1.27秒(Day327)。速さはそれなりに出せたんです。
でも、ひとつだけ不自然なところが残っていました。会話を始めるたびに、毎回Enterキーを押して録音を起動していたんです。相棒と呼ぶには、ここがどうしても引っかかる。
そこで今日は、その入口を「呼びかけたら起きる」——いわゆるウェイクワード化に挑戦しました。「クロ助」と声をかけたら起動する、あれです。
結論から言うと、会話版そのものは動きました。でも、素朴なやり方で作ってみたら、「ウェイクワードって、思ってたより難しい」という壁にきれいにぶつかりました。今日はその実録です。
※見出し画像のプロンプトは一番下に「おまけ」で公開中!
🖥️ 今日の環境
先週作ったパイプライン(talk4.py)の続きです。
PC:ThinkPad X1 Carbon Gen13(Core Ultra 7 258V / Intel Arc 140V / NPU / 32GB / Windows 11)
音声認識(STT):OpenVINOのWhisper-base(NPUで実行)
頭脳(LLM):NexaCLIでローカルのQwen2.5-1.5B
音声合成(TTS):VOICEVOX(VOICEVOX:春日部つむぎ)
言語:Python 3.12
ぜんぶX1の中だけ。クラウドには一切出しません。この「talk4.py」の起動部分(Enter押下)を、声に置き換えるのが今日のテーマです。
🎯 この記事でわかること
物理キーに触らず「声で起動する」相棒の、いちばん素朴な作り方
既存のWhisperを"常時聞かせる"とどうなるか(=無音の幻聴問題)
なぜ「音量で検出するだけ」では、ウェイクワードとして成立しないのか
それでも「呼んで→会話して→ばいばいで戻る」会話版は作れる、という手応え
本物のウェイクワードに必要な"次の一手"(専用エンジン)
📊 結果サマリ(Before / After)
Before:会話のたびにEnterキーを押して6秒録音を起動
After:「クロ助」と呼びかけたら起動 →(会話)→「ばいばい」で待機に戻る
ただし、この「After」が静かな部屋でしか成立しない——というのが、今日いちばんの学びでした。順を追って書きます。
🚀 やってみた:素朴な方式から、3段階の壁
第1段:とにかく常時聞かせてみる → 無音で幻聴を連呼
最初のアイデアはシンプルです。2秒ずつ録音して、その都度Whisperで文字起こしし、「クロ助」が含まれていたら起動する。新しいライブラリは不要、今あるWhisperを使い回すだけ。
実測してわかったこと:
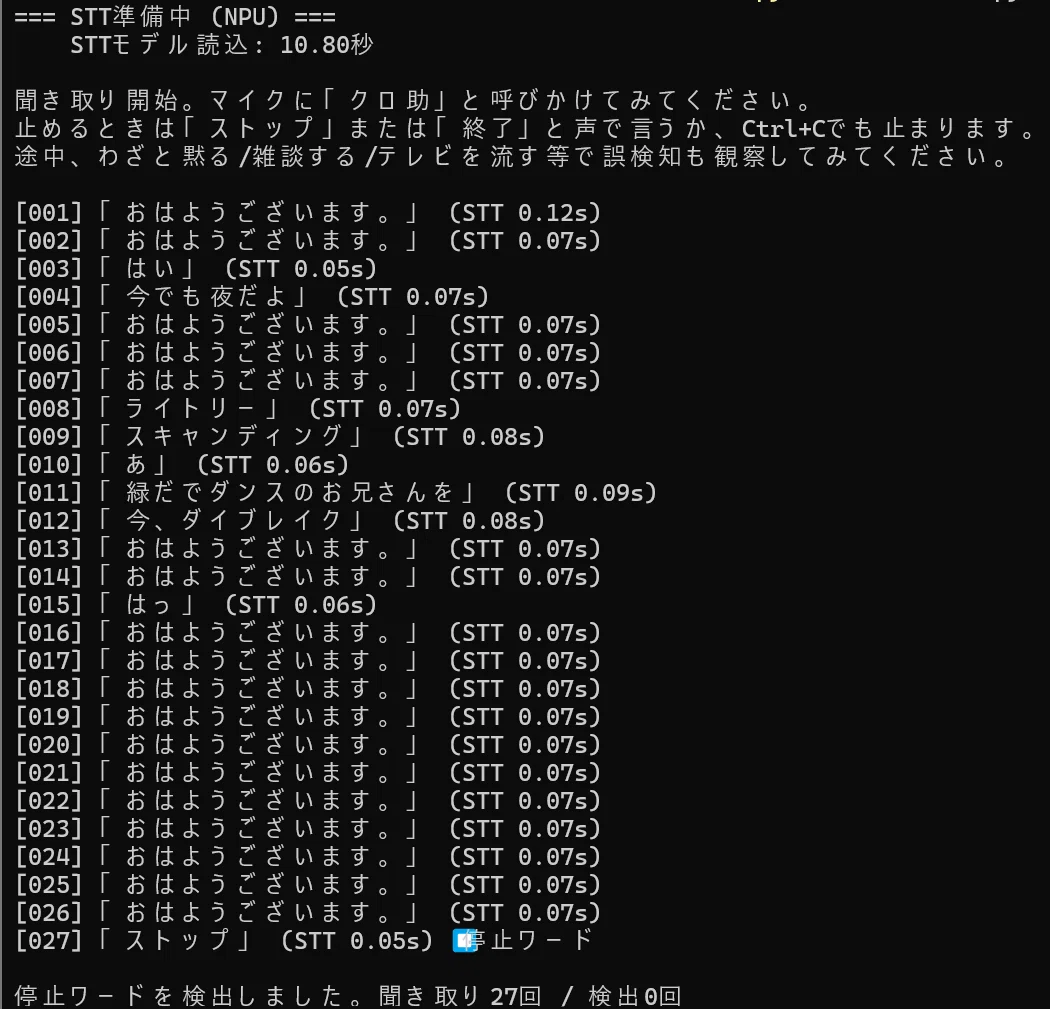
処理は軽い。文字起こし1回あたり0.05〜0.12秒、CPU使用率18%、NPUはほぼ0%。常時聞かせても余裕でした
でも、無音のときに「おはようございます。」を延々と連呼しはじめたんです
これはWhisper系でよく知られた"幻聴(ハルシネーション)"で、無音や雑音を渡されると「何か喋った」ことにしてしまう現象です。何も言っていないのに、画面に「おはようございます。」が並び続ける。ちょっと笑ってしまいました。
第2段:音量ゲートで「声があるときだけ聞く」→ 幻聴は消えた、でも言葉が割れる
原因は明確で、無音でも雑音でも、とにかく全部Whisperに渡していたこと。なので、Whisperに渡す前に音量(RMS)をチェックして、静かなチャンクはスキップするようにしました。
rms = float(np.sqrt(np.mean(audio ** 2)))
if rms < 0.010:           # 静かすぎる → Whisperに渡さない
continueこれだけで、無音の「おはようございます」連呼はピタッと止まりました。たった数行ですが効果は劇的です。
ところが次の壁が出ます。2秒で機械的に区切っているせいで、言葉が窓の境目でぶつ切りになるんです。
「クロ助」→「ロスケ」(頭が切れる)→ 次の窓でやっと全部入って起動
「こんばんは」→「コン」「公房間」「バウマ」…(バラバラ)
つまり、いつ喋るか分からないのに、こっちが勝手に2秒で区切るから不安定。3回言ってやっと1回通る、みたいな状態でした。
第3段:声の区切りで録る(簡易VAD)→ 一発で通った。でも――
そこで、固定2秒をやめて「声が出ている間だけ録音して、止まったら、その一区切りを丸ごと文字起こし」に作り替えました。音量で発話の始まり・終わりを判定する、簡易的なVAD(音声区間検出)です。
結果、「クロ助(クロスケ)」が一発で通るようになりました。言葉も途中で割れません。狙い通りです。
……なんですが、ここで本質的な壁にぶつかります。
TVをつけていたら、私が「クロ助」と言う前に、勝手に録音が始まってしまう。
考えてみれば当たり前で、この方式は「音が鳴ったか」しか見ていません。「クロ助という"特定の単語"か」は一切判定していないんです。だからTVでも雑談でも、音が出た瞬間に起動してしまう。これではウェイクワードの意味がありません。静かな部屋でしか使えない。
ここが今日いちばんの発見でした。音量ベースの検出は、ウェイクワードの代わりにはならない。
🗣️ それでも、会話版は動いた
壁は壁として、いったん「静かな環境」という前提で、会話までつないでみました。動きはこうです。
【待機中】「クロ助」と呼ぶ
🔔起動 → クロ助が「はい、聞いてるよ。どうしたの?」と返事
会話(履歴を覚えたまま、何往復でも)
「ばいばい」 → 「またね、ばいばい」と言って待機に戻る
もう一度「クロ助」で再開/完全停止は「ストップ」
実際のログがこちらです(聞き取り精度はさておき…)。
【待機中】「クロ助」と呼んでください。
  (聞こえた: 「クロスケ」)
🔔 起動! 会話モードに入ります。
[あなた] 私は健太です
[クロ助] こんにちは、健太さん。何かお手伝いできることはありますか? (応答 0.75s)
[あなた] 今は何時ですか?
[クロ助] すみません、私はリアルタイムの情報は持っていないんです。 (応答 0.60s)
[あなた] バイバイ
会話終了。待機に戻ります。応答は0.5〜0.7秒。待機→起動→会話→ばいばい→待機、という一連の流れがちゃんと回りました。「呼んだら返事して、用が済んだらまた待機に戻る」——アシスタントらしい形に、ようやくなってきました。
正直に書くと、聞き取り精度はまだ甘いです。「こんばんは」が「コンパンは」になったり、名前を取り違えたり。これはWhisper-base(小型モデル)の限界で、`whisper-small`や`medium`に上げれば改善します(その分わずかに遅くなる)。ここは次の調整ポイントです。
⚠️ つまずき&学び
今日踏んだものを正直に並べておきます。
無音の幻聴:Whisperに無音を渡すと「おはようございます」等を捏造する → 音量ゲートで「声があるときだけ渡す」と解決
言葉の切れ:固定窓で区切ると語頭・語尾が欠ける → **声の区切りで録る(簡易VAD)**で解消
"音なら何でも起動":音量検出は特定の単語を判定できない → これがウェイクワードにならない構造的な理由
認識精度:whisper-baseは短い語に弱い → モデルを大きくして対応(次回)
特に3つ目。今日のいちばんの収穫は、「ウェイクワードは"音の検出"ではなく"特定の単語の検出"だ」という、当たり前だけど身体でわかった一点です。
💡 では「本物のウェイクワード」はどう作るのか
答えは、「音が鳴ったか」ではなく「その単語が鳴ったか」だけを判定する専用エンジンを使うことです。これは文字起こしを一切せず、音声を常時スコアリングして「クロ助らしさ」が閾値を超えたときだけ起動します。TVも雑談も無視します。
現実的なルートは2つ。
openWakeWord:OSSで完全オフライン・無料。雑音を無視して特定ワードだけで起動できる本命。ただし学習済みワードは英語が中心で、日本語「クロ助」を使うには自前学習がひと手間
Porcupine(Picovoice):日本語のカスタムワードを数分で作れて速い。代わりに無料アカウント+アクセスキーが必要で、ライセンス・無料枠の制約あり
私の好みは「クラウドに出さない・OSS」なので、まずはopenWakeWordを試す予定です。これは次回(VADの本格化とセットで)やります。
そして、もし改良がうまくいったら——その成果と全コードは、別途あらためて有料記事にまとめるか、先日の有料記事(コード公開回)に追記する形で、ラボメンのみなさんに共有しますね!
🎨 おまけの宿題:クロ助の"声"も、もっと良くできそう
今日の検証中に見つけたのですが、Irodori-TTS v3という日本語特化の音声合成モデルが話題になっています。感情表現や"演技"までできて、しかもライセンスはMIT(商用利用OK)。今のVOICEVOXに加えて、クロ助の声を一段表情豊かにできそうです。
ただし実用的な速度にはNVIDIA GPUが推奨で、GPUなしのX1ではCPU実行になり重そう。我が家だとRTX搭載のメインPCで動かして、X1からLAN越しに呼ぶ……という宅内分担が現実解かもしれません。これも今後の宿題に。
🔗 関連記事
📝 まとめ
Enterキーをやめて「声で起動」する相棒に挑戦。会話版(待機→呼びかけ→会話→ばいばい→待機)は動いた
既存Whisperの常時聞き取りは軽い(CPU18%・1回0.1秒)が、無音で幻聴を起こす → 音量ゲートで解決
固定窓は言葉が割れる → 声の区切りで録る簡易VADで「クロ助」が一発検出
しかし音量検出は**「音なら何でも起動」**してしまい、TVで誤起動 → ウェイクワードの代わりにはならない
本物のウェイクワードには専用エンジン(openWakeWord / Porcupine)が必要。次回へ
「速さ」は作れた。次は「声をかけたら、ちゃんとその声にだけ起きてくれる」自然さ。相棒づくりは、もう一段だけ続きます。
それでは、また明日!
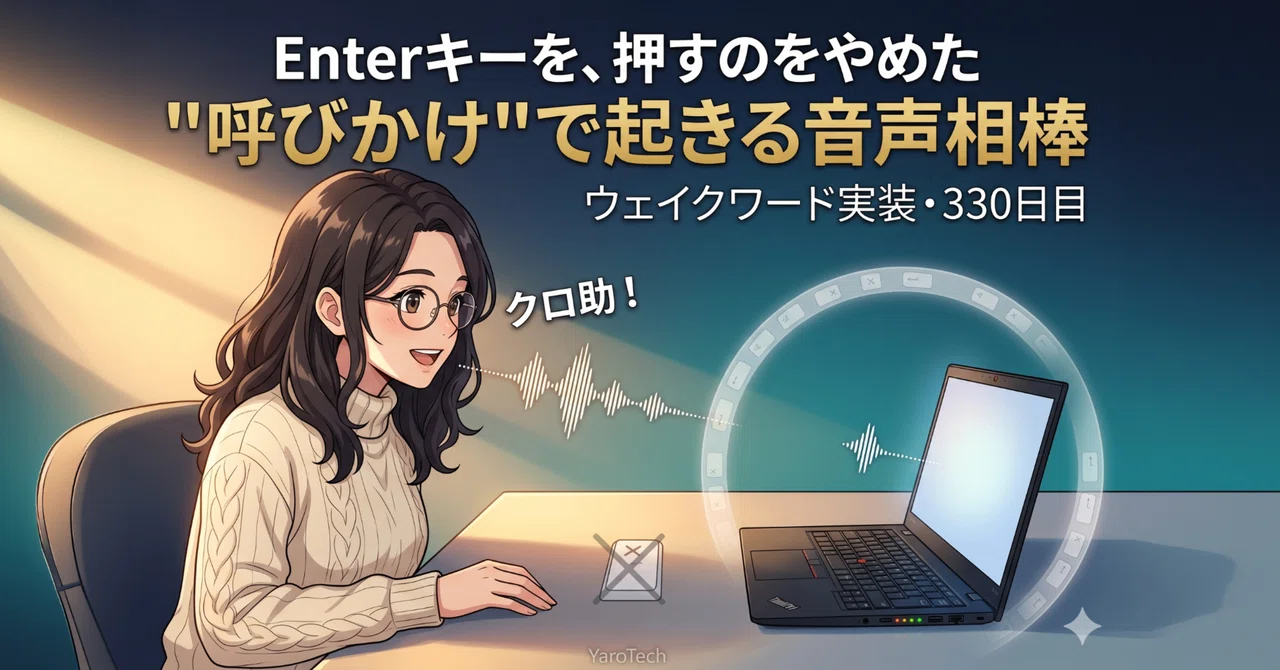
🎨 おまけ:見出し画像の作成プロンプト
今日の見出し画像は、ジミー(Gemini)に下記プロンプト+クロ助の参考画像1枚を添付して作成しました。
詳細なアニメの美意識の画像を作成してください。横長(1536×1024px)で作成してください。

【シーン】
朝の光が差し込む月曜の机。クロ助(ダークブラウンのウェーブヘア・丸眼鏡・
クリーム色のケーブルニットの女性)が、ThinkPad X1に向かって笑顔で「クロ助!」と
呼びかけている。口元から音声波形が出て、X1がスリープから半分目を覚ます演出。
手前には、もう押されないEnterキー(うっすら×印)。
PCの周りには「クラウドに出さない」象徴として淡い鍵マークの結界。

【配色・トーン】
ダークブルー〜ティールの背景に、左上から朝のゴールドの光。
クロ助→PCへの呼びかけ波形、PC→クロ助への応答波形を描く。

【テキスト】
上段(白・太字):「Enterキーを、押すのをやめた」
中段(特大ゴールド):「"呼びかけ"で起きる音声相棒」
下段(白・細字):「ウェイクワード実装・330日目」

【ロゴ】
下部中央寄りに「YaroTech」を控えめに配置(右下ではない)。いいなと思ったら応援しよう!
 記事がお役に立てたなら嬉しいです!
いただいたチップは、新しいMCPツールの検証や、より深い実践実験の資金として大切に使わせていただきます。
あなたの応援が次の「AI活用の感動」を生み出す原動力になります✨
一緒に羽ばたき続けましょう!
