クラウドに声を出さずに、X1の中だけでどこまで速い? ― ローカル音声認識が0.14秒で動いた話

こんにちは!YaroTechです。
去年の暮れ(Day262)、私はCocoroAIでローカルキャラと音声会話をさせて、感動したと同時に少しがっかりもしました。声で話しかけると、確かにキャラは返事をしてくれる。でも、返ってくるまで約2分かかったんです。裏で記憶処理がLLMを占有していたのが主因でしたが、「クラウドに出さず、手元のPCだけでAIと声で話す」という夢の、その重たさが体にこびりついていました。
あれから半年。手元のThinkPad X1 Carbonは、Intel Core Ultra(Lunar Lake)でNPUもArc GPUも積んでいます。ふと思ったんです。そもそも「声を文字にする」ところ(音声認識・STT)は、クラウドに一切出さずに、X1の中だけでどれくらい速く動くんだろう? と。
そこで今日は、音声会話パイプラインの第一段「STT(Speech to Text)」だけに絞って、X1の中で実機検証してみました。しかも、CPU・GPU・NPUの3つのデバイスで同じ音声を文字起こしして、どれが速いのかを測ってみたんです。結果は、私の予想を気持ちよく裏切るものでした。
相棒には、Windows・Intelまわりに強いコロ(Microsoft Copilot)に来てもらいました。X1はIntelマシンですからね。
※見出し画像のプロンプトは一番下におまけで公開中!
実行環境
PC: Lenovo ThinkPad X1 Carbon Gen13
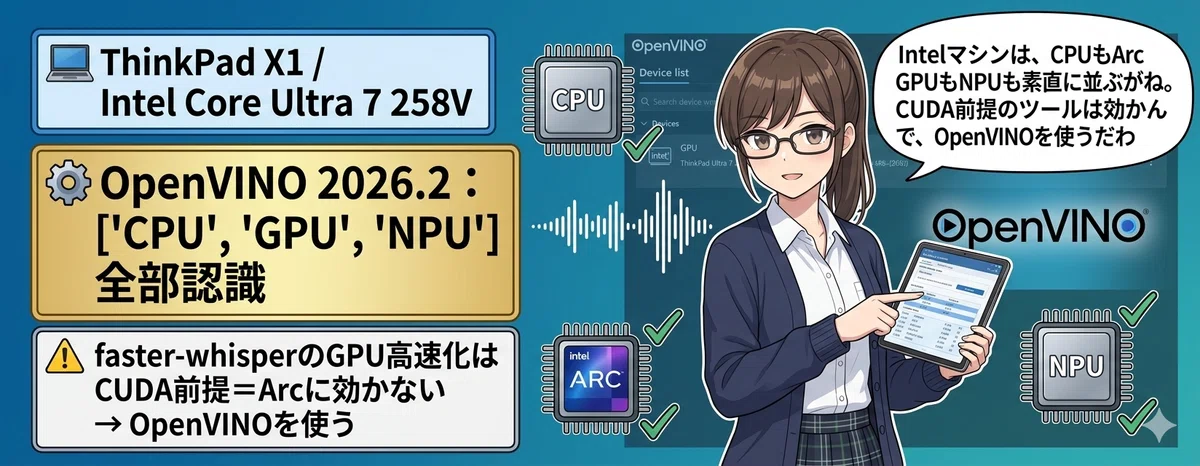
CPU: Intel Core Ultra 7 258V(Lunar Lake)
GPU: Intel Arc 140V(iGPU)
NPU: Intel AI Boost(48 TOPS)
メモリ: 32GB(LPDDR5X-8533・UMA)
OS: Windows 11 Home 25H2
推論ランタイム: OpenVINO 2026.2 / openvino-genai
検証モデル: whisper-base(OpenVINO・fp16-ov版)
NPUドライバ: 32.0.100.4512
⚠️ 本記事はThinkPad X1 Carbon(Intel・x64)での実機検証メモです。Snapdragon(ARM64)やNVIDIA GPU構成では挙動も最適なデバイスも変わります。
クロ助:「今日はね、欲ばらないのがコツなんだっちゃ。声の会話って『聞く(STT)→考える(LLM)→喋る(TTS)』の3段あるんだけど、今日は最初の"聞く"だけをX1の中でちゃんと測るべさ」
コロ:「ほうか、土台からだがね。Intelマシンだで、CPU・GPU・NPUの3つを全部使えるのがうちの強みだわ。どれが速いか、楽しみだがや」
この記事で得られること
クラウドに音声を一切出さず、X1の中だけで日本語の音声認識(STT)がどれくらい速く動くかの実機データ
同じ音声を CPU・GPU(Arc 140V)・NPU の3デバイスで文字起こしして比べた、推論時間と起動(読込)時間の生の数字
「推論が速いデバイス」と「起動が軽いデバイス」は別物、という用途設計の勘どころ
ローカルLLMで「GPUが最速」だったDay256と、今回のSTTで結論が変わった理由 ―「タスクで最適デバイスは変わる」
実際の成果
まず、今日いちばん伝えたい数字を先に置きます。
Before(Day262・CocoroAI): ローカルでキャラと声で会話したとき、返事まで約2分。裏で記憶処理がLLMを占有していて、体感はとにかく重かった。
After(今日・X1のローカルSTT): 6秒の音声を文字起こしするのに、いちばん速いNPUで0.14秒。クラウドに一切出さず、X1の中だけで、ほぼ待ち時間ゼロで声が文字になりました。
もちろんDay262の2分は「会話まるごと一往復」の時間で、今日の0.14秒は「聞く」の一段だけなので、単純比較ではありません。それでも、あれだけ重かったローカル音声処理の入り口が、こんなに軽く動くようになっていたことに、まず私自身が驚きました。土台は、もう十分に速い。
コロ:「2分が0.14秒って、桁が違うがね」
クロ助:「段が違うから直接は比べられないけどね。でも『入り口がこんなに軽いなら、会話まで届くかも』って思えたのが、今日の収穫だべさ」
実践内容
やったことは、拍子抜けするくらいシンプルです。プログラミングが分からなくても流れは追えるように書きます。
手順1:音声系専用のPython環境を作る
依存関係の衝突を避けるため、音声処理だけの新しい仮想環境(venv)を用意しました。日本語の文字化け(cp932エラー)を避けるため、`PYTHONUTF8=1` を設定しておくのがポイントです。
手順2:OpenVINOを入れて、デバイスを認識させる
IntelのAI推論ランタイム「OpenVINO」を導入します。これを入れると、X1の中のCPU・GPU・NPUを「推論に使えるデバイス」として一覧で認識してくれます。
利用可能なデバイス: ['CPU', 'GPU', 'NPU']この一行が出た時点で、もう半分勝ったようなものでした。Intelマシンは、特別なドライバ探しをしなくても3つの計算装置が素直に並びます。
手順3:whisper-baseモデルをダウンロード
音声認識の定番、OpenAIのWhisperを、OpenVINO向けに変換済みの「whisper-base(fp16-ov)」版で落としてきます。軽量なbaseサイズを選んだのは、まず「動く・速い」を確かめたかったからです。
手順4:内蔵マイクで録音して、文字起こし
X1の内蔵マイクで、テスト用に6秒の音声を録音しました。読み上げた文はこれです。
こんにちは、YaroTechです。今日もよろしくお願いします。これをwhisper-baseに渡すと、ちゃんと日本語のテキストが返ってきました。クラウドには一切送っていません。完全に、X1の中だけの処理です。
手順5:同じ音声を3デバイスで文字起こしして比較
ここからが本番です。まったく同じ6秒の音声(test1.wav)を、実行先だけ `CPU` → `GPU` → `NPU` と切り替えて、それぞれ「モデルの読込(コンパイル)にかかった時間」と「文字起こしにかかった時間」を測りました。
コロ:「同じ音声・同じモデルで、走らせる場所だけ変える。こういうのは条件をそろえるのが命だがね」
クロ助:「コロは几帳面だっちゃ。おかげできれいな比較になったべさ」
実測結果と考察
出てきた数字が、これです。
■ 文字起こし時間(6秒の音声・短いほど速い)
  NPU    0.14秒  ← 最速🏆
  GPU    0.35秒
  CPU    0.41秒

■ 読込(コンパイル)時間(モデル準備・短いほど軽い)
  CPU    0.43秒  ← 最軽🏆
  GPU    4.48秒
  NPU   10.35秒  ← 最重

■ 認識結果(3デバイスとも完全に同一)
  「こんにちは、やるてくです。今日もよろしくお願い致します。」
この表には、面白い"ねじれ"が2つ隠れています。
ひとつ目。推論(文字起こし)はNPUがダントツで速い。0.14秒は、GPUの0.35秒、CPUの0.41秒を引き離しています。NPUは「AI推論の専用回路」なので、いざ走り出せばいちばん速い ― これは期待どおりでした。
ふたつ目が本題です。読込(起動)はNPUがダントツで重い。NPUはモデルを使える形にコンパイルするのに10.35秒もかかりました。GPUの4.48秒、CPUのたった0.43秒と比べると、桁違いに腰が重い。つまりNPUは「準備に時間はかかるが、走り出せば最速」という性格なんです。
クロ助:「これね、ちょっと感動したっちゃ。NPUは準備に10秒かかるけど、走り出したら0.14秒。逆にCPUは0.4秒で準備できて、推論も0.4秒。性格が真逆なんだべさ」
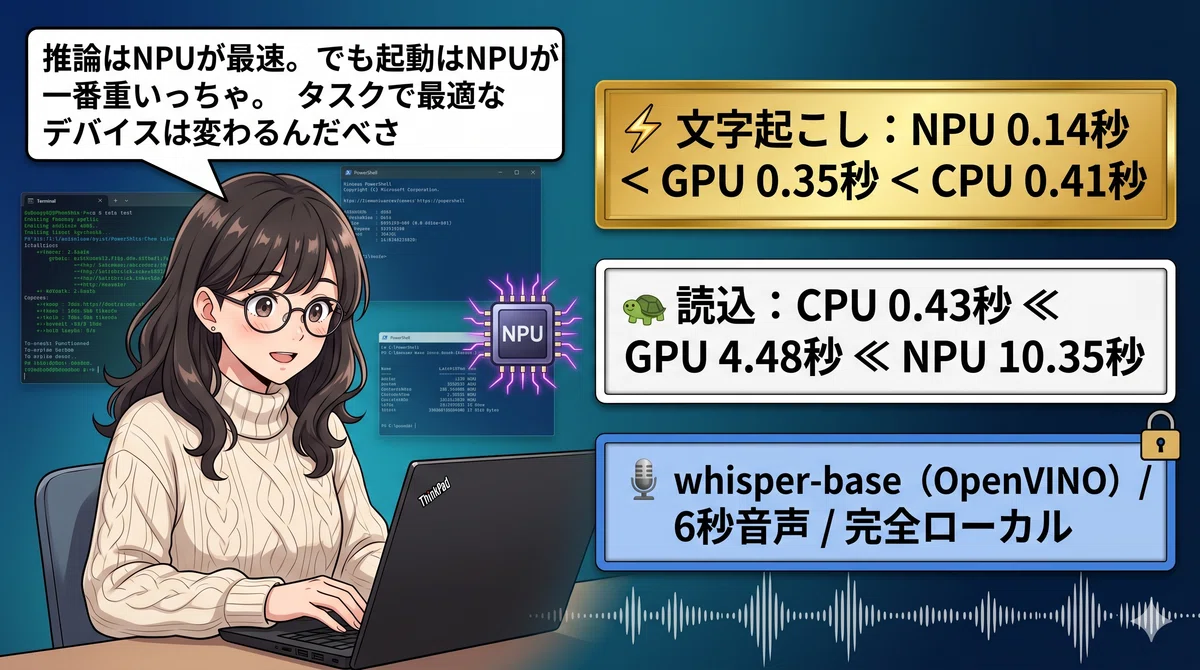
コロ:「用途で選ぶデバイスが変わる、ってことだがね。アプリを常駐させて何度も声をかけるなら、最初の10秒だけ我慢すれば、あとはNPUがずっと最速で応えてくれる。逆に、一回ポンと文字起こしするだけなら、身軽なCPUのほうが結局速いだわ」
そして、ここで過去の自分とつながります。Day256でX1のローカルLLMを検証したとき、私は「NPUをフル稼働させてもCPU+GPUのほうが速い」、つまりLLMではNPUが最速ではないという結論を書きました。ところが今回のSTT(Whisper)では、推論はNPUが最速だった。
同じX1でも、LLMとSTTで最速デバイスが入れ替わったんです。
これが今日いちばん大事な学びでした。「NPUは速い/遅い」と一括りにしてはいけない。タスク(仕事の種類)によって、最適なデバイスは変わる。さらに言えば、推論だけ見れば「NPU最速」でも、起動まで含めた総時間で見れば、単発ならCPUが勝つ場面もある。tok/sや推論時間という一点の数字ではなく、起動も含めた使い方全体で測らないと判断を誤る ― これはDay291で書いた「総応答時間で評価する」という話の、きれいな再確認になりました。
つまずきポイントと解決策
つまずき1:「YaroTech」が「やるてく」になった
3デバイスとも認識結果は同じで、文章自体は正確でした。ただ一か所、「YaroTech」が「やるてく」とひらがなで起こされていました。これは精度の問題というより、固有名詞をモデルが知らないために起きる典型的なミスです。
解決策はシンプルで、Whisperには `initial_prompt`(最初に文脈のヒントを渡す仕組み)があります。ここに「YaroTech」のような固有名詞や専門用語をあらかじめ書いておくと、その表記に寄せて起こしてくれます。議事録や自分のブランド名を扱うなら、まず仕込んでおきたい一手です。
つまずき2:large系モデルはNPUで止まる(既知の罠)
今回はbaseサイズで快適でしたが、より高精度な large-v3-turbo をNPUで動かそうとすると無限ループでハングする既知の不具合(OpenVINOのIssue #1965 )が報告されています。large系を使いたいときはNPUを避けて、Arc(GPU)かCPUに回すのが安全です。NPUはbase/small/medium級の軽量モデル向き、と割り切るのが実務的でした。
つまずき3:「GPUを使えば速い」はIntelでは素直に通らない
音声認識の高速化でよく名前が挙がる faster-whisper は、GPU高速化がCUDA(NVIDIA)前提です。X1のArcはIntel GPUなので、ここは効きません。Intelで「GPUでも動かしたい」なら、CUDAを前提にしたツールではなく、今回のようにOpenVINO(やONNX/DirectML)の経路を選ぶ必要があります。「ローカルAIの記事で見た高速化テクが、自分のマシンでは効かない」の多くは、この前提の違いが原因です。
応用例
STTがこれだけ軽く動くと分かると、会話の手前で使える場面が一気に広がります。
ひとつは、議事録やメモのその場文字起こし。クラウドに音声を出さないので、社外秘の打ち合わせでも安心して回せます。「クラウドに出さずに手元で完結させたい」というのは、まさにこの土台があってこそです。
もうひとつは、ハンズフリーのAIメモ。作業中に思いついたことを口に出すだけで、X1が文字にして溜めてくれる。NPUは常駐させて何度も使う用途と相性がいいので、こういう「ずっと耳を傾けている」使い方こそNPUの腰の重さが気にならず、推論の速さだけが効いてきます。
そして本命は、これが音声会話アシスタントの"口の前にある耳"になることです。STTが速ければ、あとは「考える(LLM)」と「喋る(TTS)」をつなぐだけ。土台が0.14秒で動いたいま、会話のテンポに届く完全ローカル音声対話が、急に現実味を帯びてきました。
関連記事
今回の内容に関連する過去記事もぜひご覧ください:
まとめ
クラウドに声を出さずに、X1の中だけでどこまで速いか。今日のSTT検証で分かったことを整理します。
完全ローカルの日本語STTは、X1のNPUで0.14秒(6秒音声)で動いた ― Day262で約2分かかった音声処理の入り口は、もう十分に軽い
推論はNPU最速(0.14s)、でも起動はNPU最重(10.35s) ― 走り出せば最速だが準備が重い、という性格。常駐用途ならNPU、単発ならCPUが身軽
同じX1でも、LLM(Day256はGPU優位)とSTT(今回はNPU優位)で最速デバイスが入れ替わった ―「NPUは速い/遅い」ではなく、タスクで最適デバイスは変わる
判断は一点の数字でなく総時間で ― 推論だけ見れば「NPU最速」でも、起動を含めると単発はCPU勝ち。Day291の「総応答時間で見る」の再確認
「ローカルは遅い」という思い込みも、「NPUがいちばん速いはず」という思い込みも、実際に自分の手で3デバイスを並べて測ってみると、両方ほどよく裏切られました。やっぱり、最後は手元で測るのがいちばん速い。
クロ助:「準備が重いNPUが、走り出すといちばん速い。人間にもいるべ、エンジンかかるの遅いけど乗ったら速い人」
コロ:「クロ助のことだがや?」
クロ助:「……今日はそういうことにしておくべさ」
次回予告
STTが動いたので、次はいよいよ**"声を返す"**ところに進みます。
「聞く(STT)」の土台ができたので、次回は「考える(LLM:NexaCLI / IPEX-LLM)」と「喋る(TTS:VOICEVOX / AivisSpeech)」を連結して、X1の中だけで声の会話が一往復成立するかを検証します。評価の主役は、tok/sのような一点の速さではなく、発話し終えてからAIが喋り出すまでの総ターン遅延。会話のテンポに届くかを、この一本の物差しで測ります。
そして、今日の出発点になったCocoroAIの"約2分"。あの重さを、速い構成に差し替えてどこまで縮められるか ― CocoroAIリベンジも狙っていきます。お楽しみに!
おまけ:見出し画像作成プロンプト
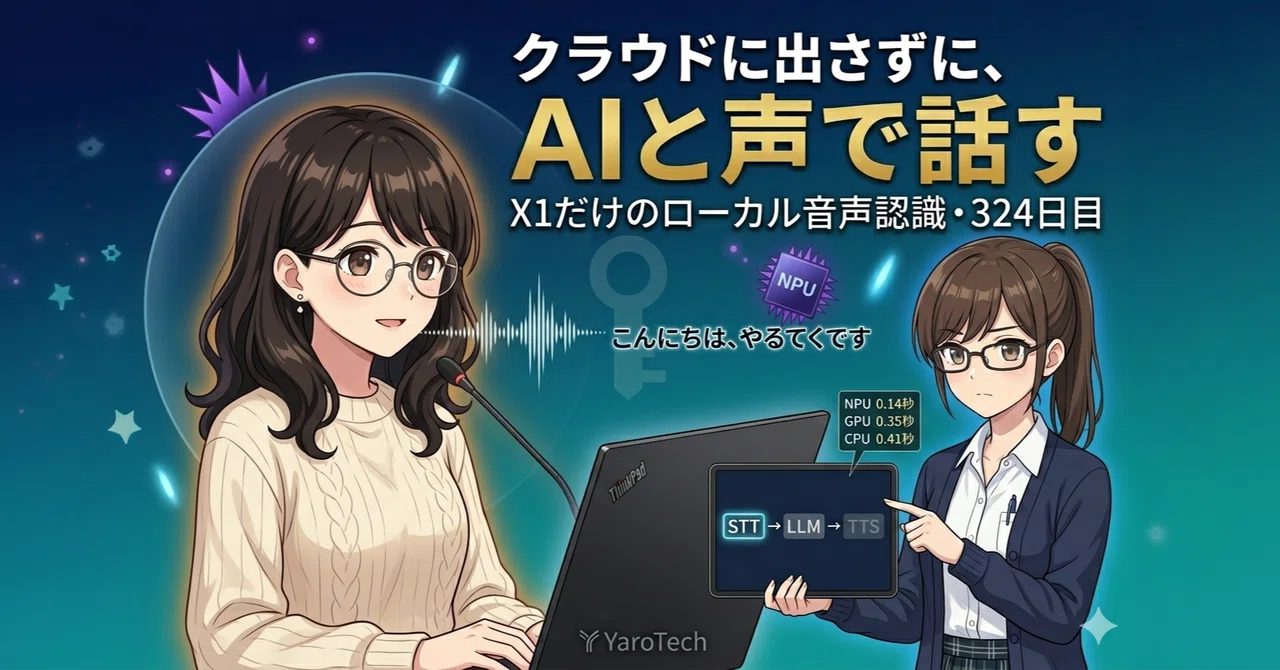
今日の見出し画像のベースはジミー(Gemini)に下記プロンプトで作成してもらいました!クロ助とコロの参考画像(`AI擬人化\Gemini_Generated_Image_クロ助(Claude Desktop).png` と `AI擬人化\Gemini_Generated_Image_コロ(Copilot).png`)を添付して、人物の一貫性を確保しています。
詳細なアニメの美意識の画像を作成してください。表情豊かな瞳、なめらかな網掛けセルの色使い、はっきりした線画を使用します。アニメのシーンに典型的な身ぶりと雰囲気で、心情と登場人物の存在を強調してください。

下記条件のnote見出し画像をサイズは横長で作成してください。サイズは必ず横長で作成してください。

【重要】添付画像とキャラクターの対応:
- 添付1「Gemini_Generated_Image_クロ助(Claude Desktop).png」→ クロ助(クリーム色ケーブルニット・丸眼鏡・ウェーブヘアの女性・中央左・やや大きめ)
- 添付2「Gemini_Generated_Image_コロ(Copilot).png」→ コロ(制服風のきちんとした服装・眼鏡の女性・中央右)
各キャラクターは必ず対応する添付画像の外見を忠実に再現してください。

## 見出し画像案

### デザインコンセプト
- 背景: 夜寄りのダークブルーからティールへのグラデーション(クラウドに出さない「ローカルの安心感」を表現)。PC全体を薄い鍵マークと結界のような円が囲み、外(クラウド)とつながっていないオフライン感を出す。NPUの紫スパイクとArcの水色を背景のアクセントに散らす
- メインビジュアル: クロ助&コロが ThinkPad X1 に向かって話しかけるシーン
  - 中央左(やや大きめ): クロ助(ダークブラウンのウェーブヘア、丸眼鏡、クリーム色ケーブルニット、女性)。X1のマイクに向かって「こんにちは、YaroTechです」と話しかけ、口元から右に向かって音声の波形(声の波)が流れている。穏やかで優しい表情
  - 中央右: コロ(制服風のきちんとした服装、眼鏡、几帳面な雰囲気の女性・Microsoft/Intel陣営)。タブレットを指さし、画面に「STT → LLM → TTS」の小さなパイプライン図と、今日光るのは先頭の「STT」だけ(あとの2つは半透明)を案内する表情
  - 二人の間〜PC画面に: 声の波形が文字「こんにちは、やるてくです」に変わる様子と、「NPU 0.14秒 / GPU 0.35秒 / CPU 0.41秒」の小さな数字パネル
- テキスト要素(3段):
  - 上段(白・太字・30pt): 「クラウドに出さずに、」
  - 中段(特大ゴールド・48pt): 「AIと声で話す」
  - 下段(白・細字・22pt): 「X1だけのローカル音声認識・324日目」
- 装飾: 声の波形、鍵マーク(オフライン)、「STT→LLM→TTS」の小パイプライン、NPUチップアイコン(紫スパイク)、Arcの水色グロー、クロ助周囲にあたたかいアンバー系の薄影・コロ周囲にブルー系の薄影

### 作成手順
1. 画像サイズ(1536×1024px)の横長フォーマット
2. 夜寄りのダークブルー → ティールのグラデーション背景を設定
3. クロ助(中央左・やや大きめ)、コロ(中央右)を配置
4. 添付した2キャラ(クロ助・コロ)の参考画像と外見を一致させる
5. クロ助の口元から流れる声の波形と、PC内に閉じた鍵・結界(オフライン感)を配置
6. 装飾要素:「STT→LLM→TTS」パイプライン(先頭STTのみ点灯)、NPU 0.14秒の数字パネル、NPUチップ・Arcグロー
7. テキストを3段構成で追加
8. 下部中央寄りに「YaroTech」のロゴを12ptで控えめに配置
9. 全体のバランスを確認して完成
#YaroTech #生成AI #AI活用 #ローカルLLM #音声認識 #Whisper #OpenVINO #IntelCoreUltra #NPU #ThinkPad #ローカルAI #継続は力なり
いいなと思ったら応援しよう!
 記事がお役に立てたなら嬉しいです!
いただいたチップは、新しいMCPツールの検証や、より深い実践実験の資金として大切に使わせていただきます。
あなたの応援が次の「AI活用の感動」を生み出す原動力になります✨
一緒に羽ばたき続けましょう!
