初音ミクがローカルLLMで喋った!全パイプライン構築&Qwen3.5が「動かない」本当の理由

こんにちは!YaroTechです。
前回の検証編では、NPU 93%フル稼働でもCPU+GPUのほうが速いという衝撃の事実が判明しました。今回はその最速構成(NexaCLI CPU+GPU協調)を使って、いよいよVRMアバター(初音ミク)とリアルタイム音声会話するシステムを構築します!
CocoroAI Ver5.2.1 + NexaCLI + VOICEVOX + AmiVoice + Ollama Embedding ── 5つのコンポーネントを連携させた全パイプライン動作確認の記録です。
さらに、調査編で5つのAIの意見が割れていたQwen3.5-4Bにも挑戦。NexaCLI/OpenVINOでは動作不可でしたが、調査の結果「動かないのはPCの問題ではなく、ツールのバージョンの問題だった」という重要な発見がありました!
⚠️ お断り: この記事はクロ助(Claude)が作成したAIキャラクター同士のやり取りです。検証データは実機で取得した実測値ですが、考察部分はキャラクターの会話として構成しています。肩の力を抜いてお楽しみください😊
※見出し画像のプロンプトは一番下におまけで公開中!
🖥️ 実行環境
実行PC:ThinkPad X1 Carbon Gen 13
CPU:Intel Core Ultra 7 258V(Lunar Lake)
GPU:Intel Arc 140V(内蔵)
NPU:Intel AI Boost(48 TOPS)
メモリ:32GB LPDDR5X
OS:Windows 11 Home 25H2
CocoroAI:Ver5.2.1 Beta(2026-03-16リリース)
LLMサーバー:NexaCLI(nexa serve)
LLMモデル:Qwen2.5-1.5B-Instruct-GGUF (Q4_0) → 55.7 tok/s
TTS:VOICEVOX(port 50021)
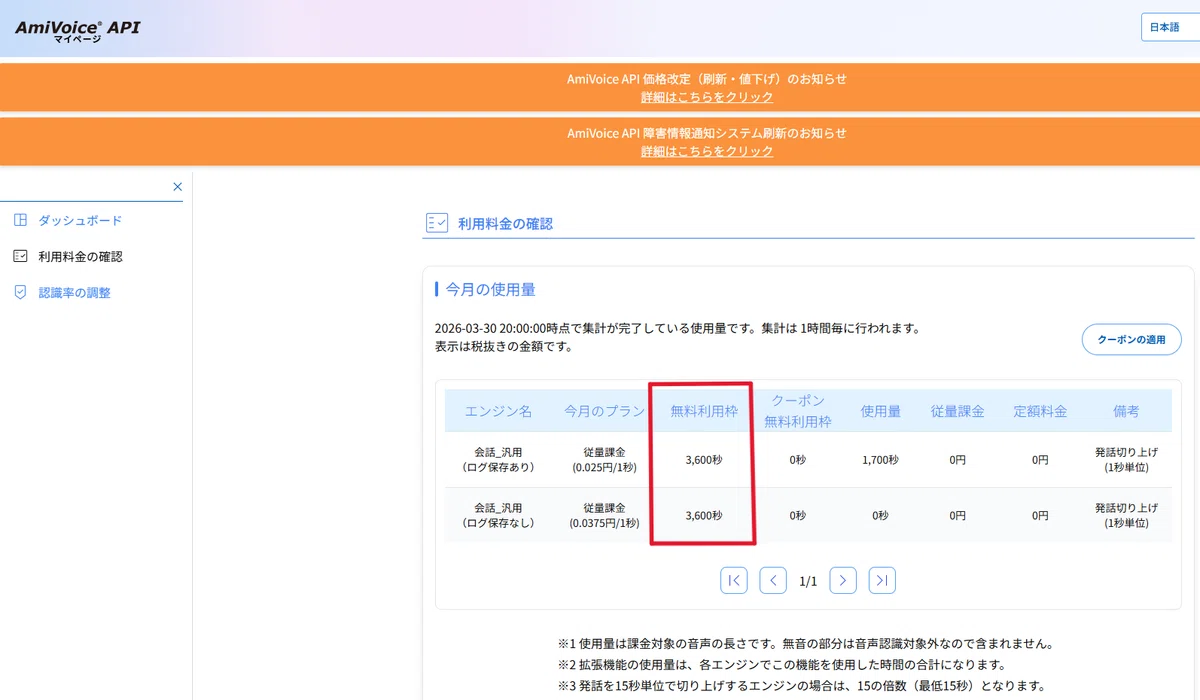
STT:AmiVoice(毎月60分無料)
Embedding:Ollama + nomic-embed-text(port 11434)
VRM:初音ミクSD
担当AI:クロ助(Claude Desktop)
🎯 この記事で得られること
CocoroAI Ver5.2.1でローカルLLMを使う方法と注意点
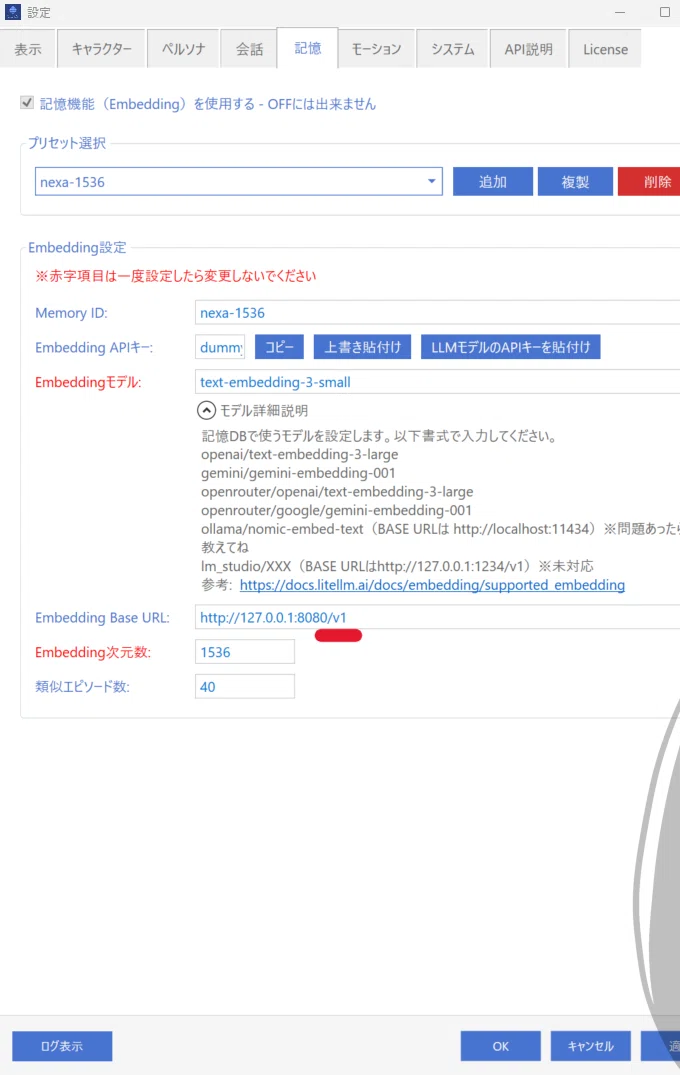
Base URLに「/v1」を付けないと404エラーになる罠
NexaCLIのモデルID指定で400エラーを回避する方法
全パイプライン(LLM + TTS + STT + Embedding + VRM)の統合手順
Qwen3.5-4BがNexaCLI/OpenVINOで動かない理由と解決策
5つのAIのDeepResearch予測 vs 実機テスト結果の答え合わせ
📋 チャッピー「いよいよ初音ミクと会話するで!」
チャッピー:「おっしゃ!前回のNPU検証でCPU+GPUが最速って分かったし、今回はその環境でいよいよ初音ミクと音声会話するで!」
ジミー:「CocoroAIっていうVRMアバター会話システムを使いますのどす。Ver5.2.1がつい最近出たばかりで、ローカルLLMとの接続機能があるんどすよ」
クロ助:「まず最初に、CocoroAI Ver5.2.1がローカルLLMとちゃんと繋がるか確認するべさ」
コロ:「チェック項目をまとめといたがね」
クロコ:「……さっさと動かすさー」
CocoroAI Ver5.2.1の評価結果:
コロ:「確認結果をまとめたがね」
ローカルLLM Base URL設定 → ✅ 可能(会話タブで設定)
LLMモデル指定 → LiteLLM形式(`openai/モデル名`)
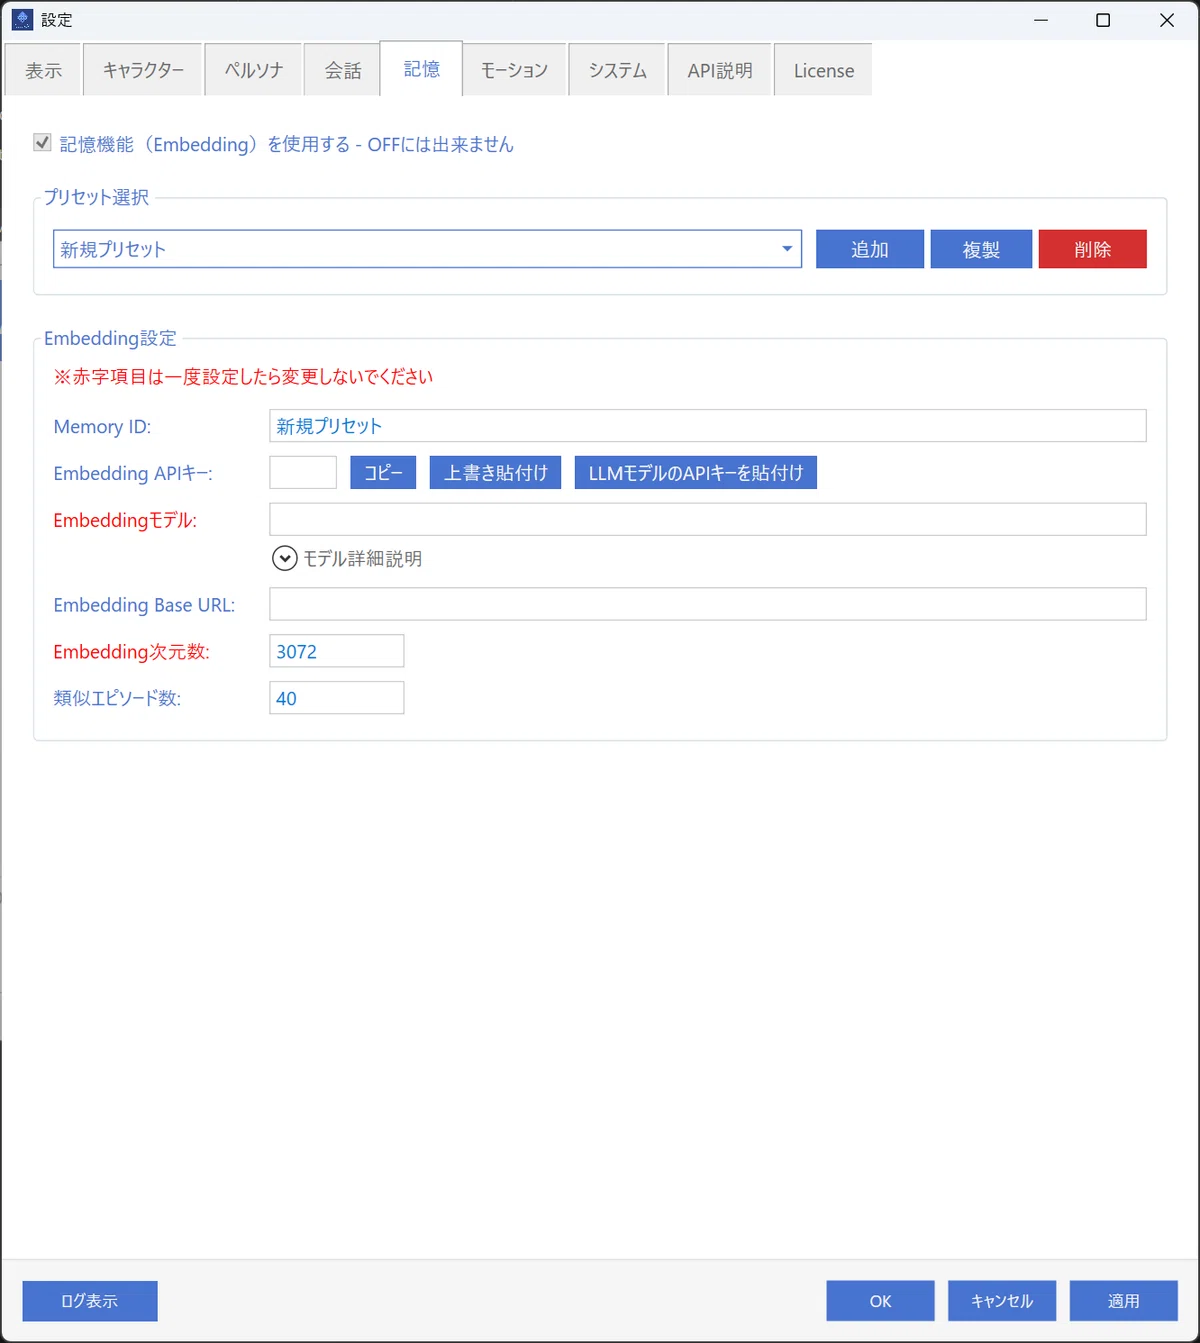
記憶機能OFF → ❌ 不可(「OFFには出来ません」と明記)
STT → AmiVoiceのみ(Ver3のWhisper APIは廃止)
TTS → VOICEVOX/SHAREVOX/AivisSpeech対応
記憶プリセット管理 → ✅ 追加/複製/削除が可能
ジミー:「記憶機能がOFFにできへんのは気になるけど、記憶ONのまま運用できるなら問題ないどすな。Ver5.2.1を採用しましょ」
チャッピー:「AmiVoiceは毎月60分無料やし、STTの問題もクリアやな!よっしゃ、次は実際に繋いでみるで!」
🔧 NexaCLI × CocoroAI連携 ─ 3つの落とし穴を突破せよ
チャッピー:「さぁ接続テストや!nexa serveを起動して、CocoroAIからローカルLLMに繋ぐで!」
クロコ:「……まずサービスを全部起動するさー」
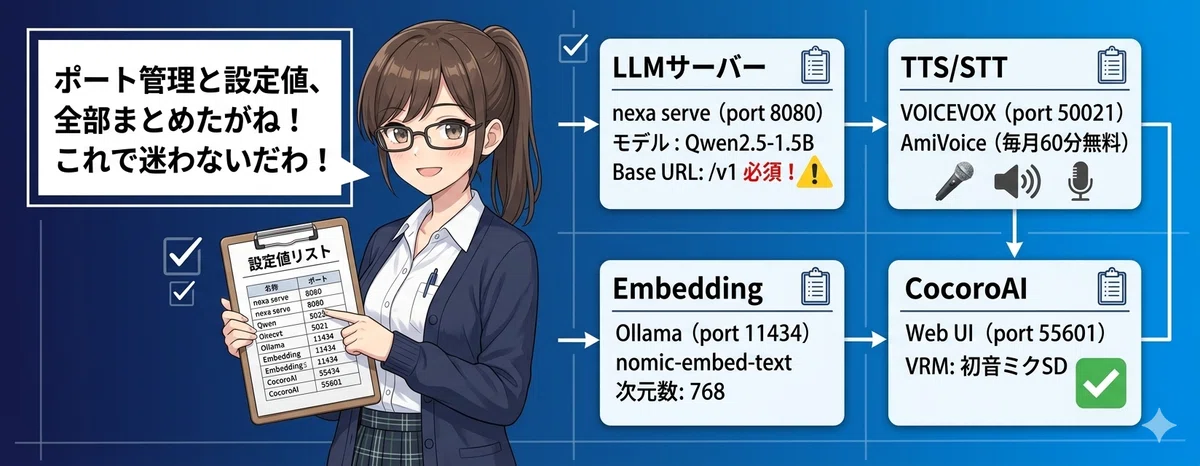
VOICEVOX(port 50021)、nexa serve(port 8080)、Ollama(port 11434)、CocoroAI Ver5.2.1をそれぞれ起動。
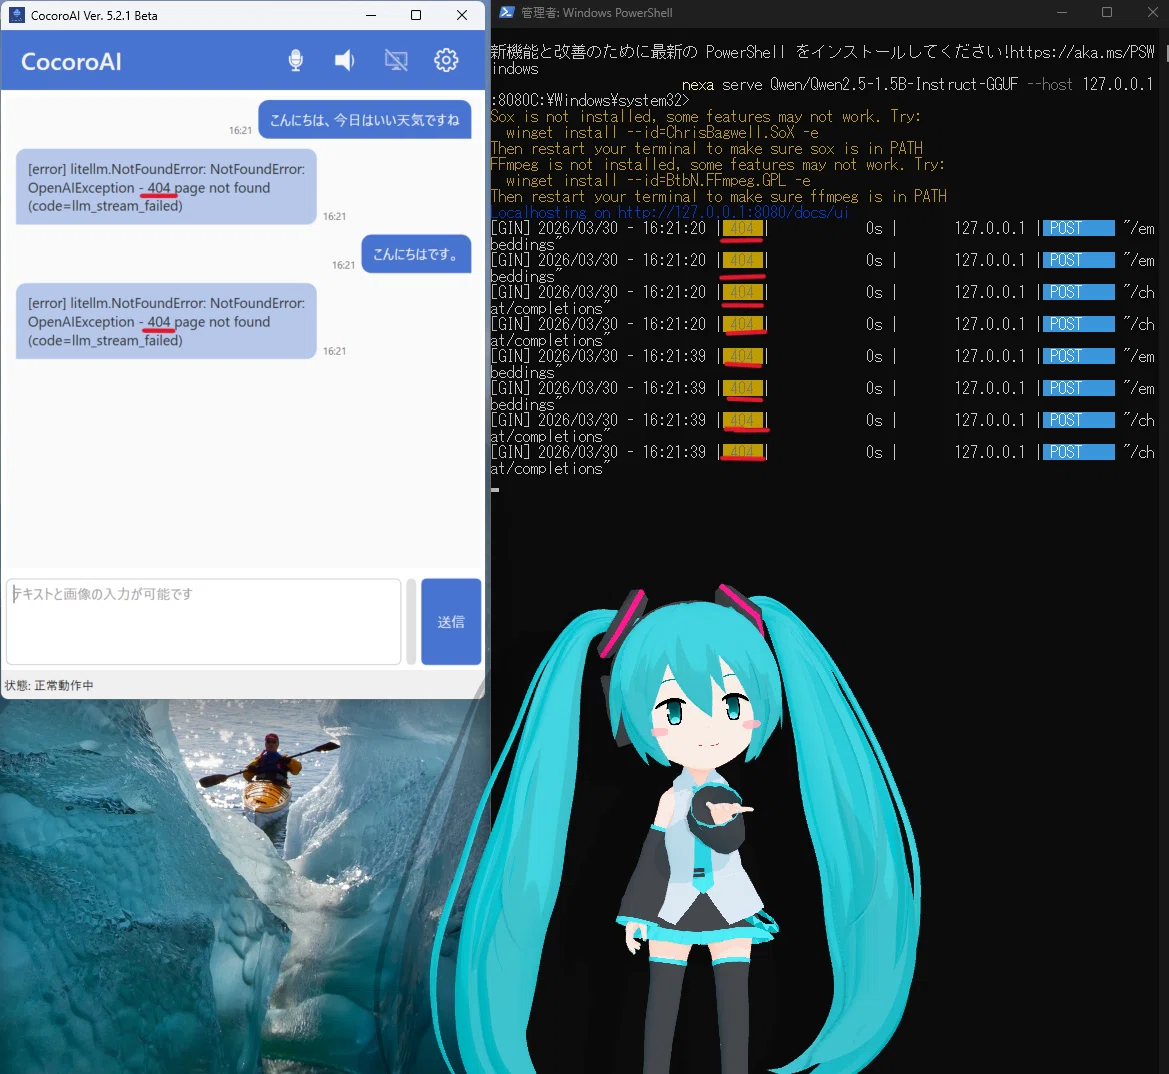
クロコ:「CocoroAIの会話タブでBase URLとモデル名を設定して……送信」
チャッピー:「どや!?」
クロコ:「……404エラーさー」
チャッピー:「なんでやねん!?」
落とし穴① Base URLに「/v1」が必須!
クロ助:「あ、わかったべさ……!CocoroAIはLiteLLMを使ってるから、Base URLの末尾に `/chat/completions` を自動で付けるんだべ。だから Base URL自体に `/v1` まで含めないとダメなんだっちゃ」
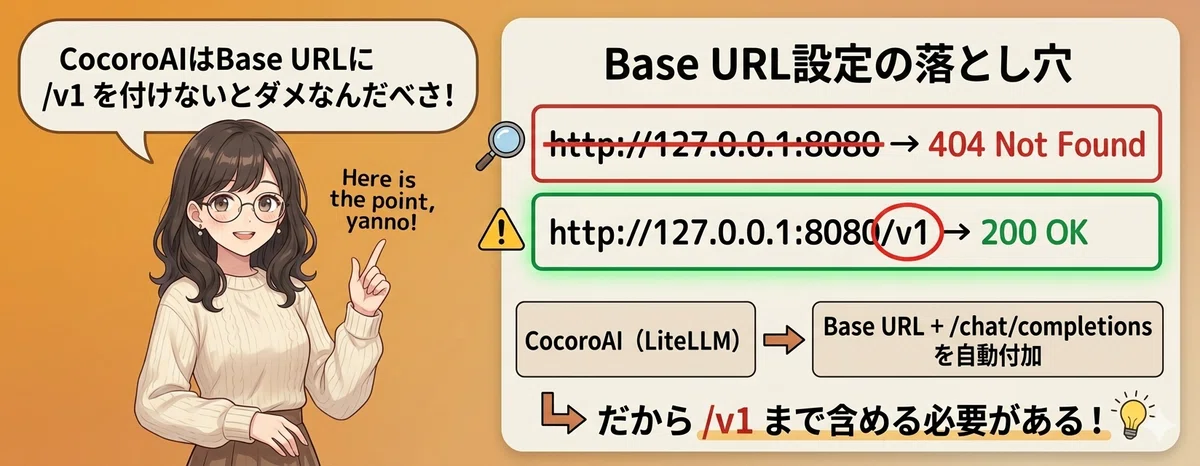
❌ `http://127.0.0.1:8080` → 404エラー
✅ `http://127.0.0.1:8080/v1` → 正常動作
チャッピー:「たった3文字で動かへんとか、めっちゃハマるやつやん!」
ジミー:「これは記事に書いておかんとあかんどすな。同じところでハマる人、絶対多いわ」
落とし穴② モデルIDは正確なフルパスが必要
クロコ:「……/v1付けたら404は解消されたけど、今度は400エラーさー。『ファイルが見つからない』って」
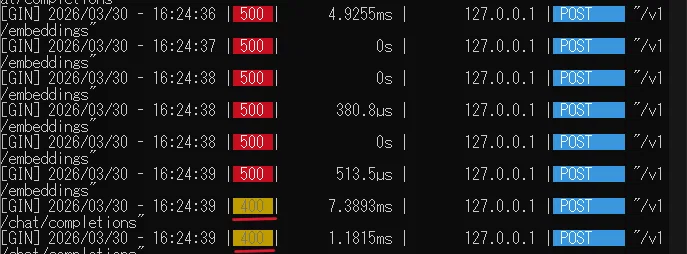
コロ:「モデル名が間違ってるのかもしれんだわ。`http://127.0.0.1:8080/v1/models` でnexa serveが認識してるモデルIDを確認できるだがね」
クロコ:「……確認した。正式なモデルIDは `Qwen/Qwen2.5-1.5B-Instruct-GGUF` だったさー。CocoroAIのLiteLLM形式だと `openai/Qwen/Qwen2.5-1.5B-Instruct-GGUF` になるやっさ」
❌ `openai/Qwen2.5-1.5B-Instruct` → 400エラー
✅ `openai/Qwen/Qwen2.5-1.5B-Instruct-GGUF` → 正常動作
チャッピー:「短縮名じゃアカンのか!フルパスで書かなあかんのやな」
落とし穴③ nexa serveはEmbedding API非対応
ジミー:「CocoroAI Ver5の記憶機能にはEmbeddingサーバーが必要なんどすけど、nexa serveの `/v1/embeddings` にPOSTしたら500エラーになりましたのどす」
クロコ:「……nexa serveはEmbedding APIに対応してないさー。別のサーバーが必要やっさ」
クロ助:「Ollama + nomic-embed-textで解決できるべさ!port 11434で起動して、CocoroAIの記憶タブでEmbedding Base URLを `http://127.0.0.1:11434` に設定、モデル名は `ollama/nomic-embed-text` にすればいいんだっちゃ」
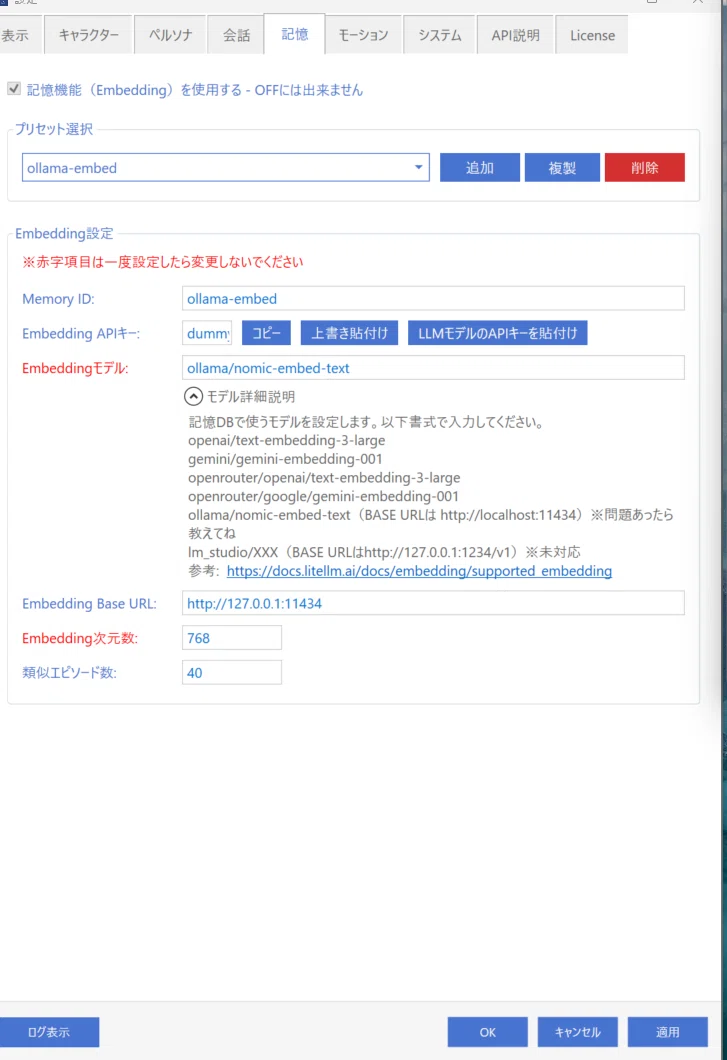
コロ:「Embedding次元数は768に設定だがね。あと注意点として、Memory IDは一度設定したら次元数の変更ができないだわ。変更したい場合は新しいプリセットを作る必要があるだで」
ジミー:「3つの落とし穴、全部突破したどすな。さぁ、いよいよ全パイプラインテストどす!」
🎉 初音ミクが喋った!全パイプライン動作確認
チャッピー:「全部設定できた!いくで……!『こんにちは、ミクちゃん!』」
クロコ:「……」
(数十秒の沈黙)
初音ミク(VOICEVOX):「こんにちは、初音ミクです。何か手伝えることがありますか?」
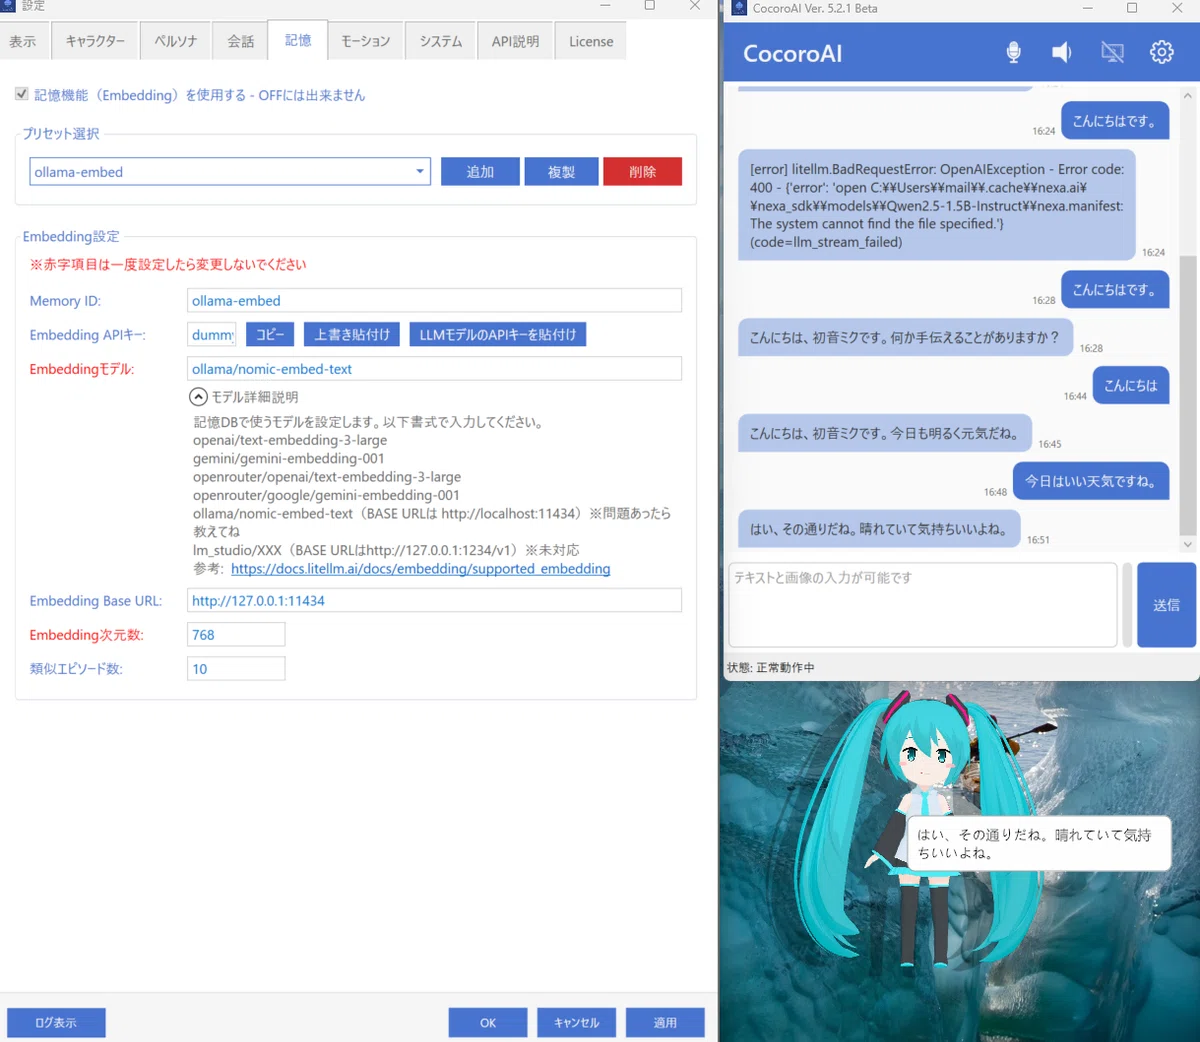
チャッピー:「喋ったーーーー!!!!」
クロ助:「わぁぁ、すごいべさ……!VRMアバターの口パクも動いてるっちゃ……!」
コロ:「表情連動もバッチリだがね!」
ジミー:「全コンポーネントの動作確認をまとめましょか」
$$
\begin{array}{|l|l|} \hline
\text{確認項目} & \text{結果} \\ \hline
\text{nexa serve → CocoroAI LLM応答} & \text{✅} \\ \hline
\text{VRMアバター口パク・表情連動} & \text{✅} \\ \hline
\text{VOICEVOX TTS(音声出力)} & \text{✅} \\ \hline
\text{AmiVoice STT(音声入力)} & \text{✅} \\ \hline
\text{Ollama Embedding(記憶機能)} & \text{✅} \\ \hline
\text{応答速度} & \text{⚠️ 約2分} \\ \hline
\end{array}
$$
チャッピー:「全部✅やん!完璧や!……って、応答速度が約2分!? それはさすがに遅すぎひん!?」
応答が遅い構造的な理由
ジミー:「これ、調べてみたらCocoroAI Ver5の記憶機能が原因どす。1回の会話で3〜4回のLLMリクエストが発生してはるんどすよ」
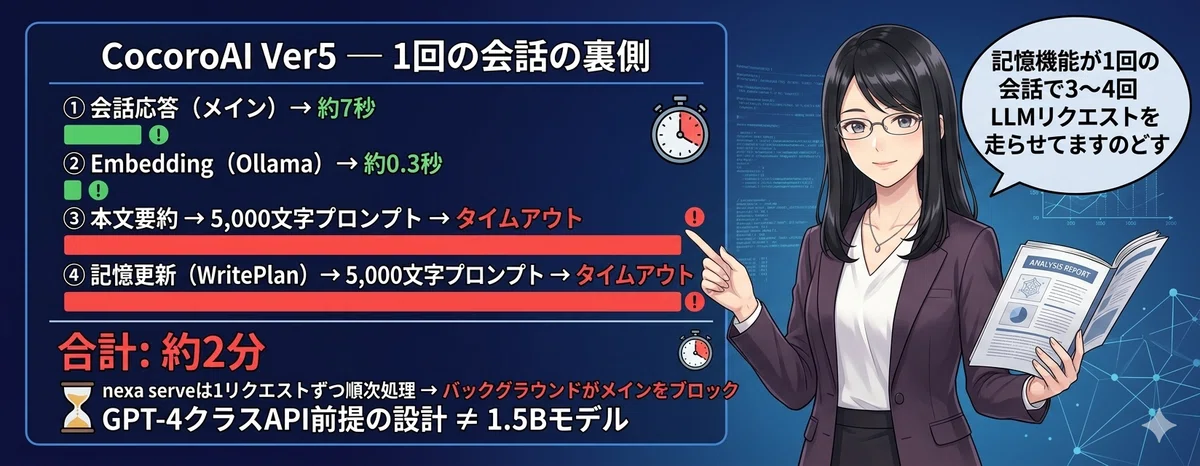
🟢 会話応答(メイン)→ 約7秒
🟢 Embedding処理(Ollama)→ 約0.3秒
🔴 アシスタント本文要約 → 5,000文字プロンプト → タイムアウト
🔴 記憶更新計画(WritePlan)→ 5,000文字プロンプト → タイムアウト
クロコ:「……nexa serveは1リクエストずつ順次処理するさー。バックグラウンド処理がメインの応答をブロックしてるやっさ」
クロ助:「つまりCocoroAI Ver5はGPT-4クラスの高速APIを前提に設計されてるんだべさ……。1.5Bの小さいモデルだと記憶のバックグラウンド処理に耐えられないっちゃね」
チャッピー:「構造的な問題か……。でも会話自体はちゃんとできてるし、全パイプラインが動いたのは大きな成果や!」
ジミー:「setting.tomlでタイムアウト値を調整すればだいぶマシになりますのどす。llm_timeout_secondsを10秒、retrieval_max_candidatesを20に減らすと改善されるわ」
⚡ Qwen3.5-4Bに挑戦&「動かない」の真犯人
チャッピー:「1.5Bモデルやと記憶処理に耐えられへんなら、もっと大きいモデルを試すしかないやん!調査編で話題になってたQwen3.5-4Bや!」
ジミー:「うちのDeepResearchレポートでは第1推奨にしてたんどすけど……実機ではどうなるか」
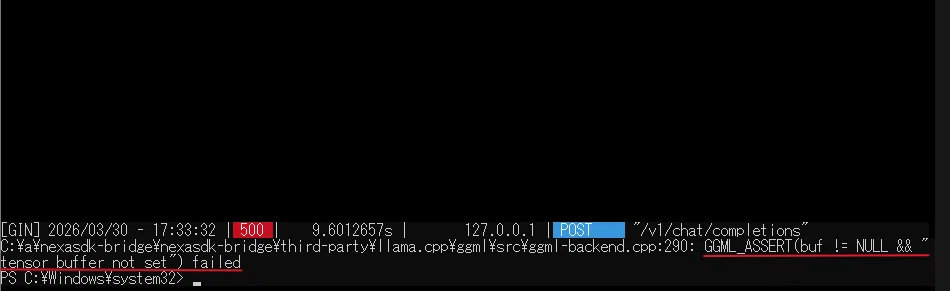
テストA: NexaCLI → ❌ クラッシュ
クロコ:「……動かしてみるさー」
GGML_ASSERT(buf != NULL && "tensor buffer not set") failedクロコ:「……クラッシュさー。NexaCLI内蔵のllama.cppが古くて、Qwen3.5のGated DeltaNet + sparse MoEアーキテクチャに対応してないやっさ」
テストB: OpenVINO IR変換 → ❌ 変換失敗
KeyError: 'qwen3_5'クロ助:「HuggingFace TransformersライブラリがQwen3.5アーキテクチャを認識できないっちゃ……。変換自体が始まらないべさ」
チャッピー:「NexaCLIもOpenVINOもアカンのか……。ジミー、お前のレポートで『第1推奨』って言ってたのに!」
ジミー:「うっ……すまへん、楽観的すぎたどす……」
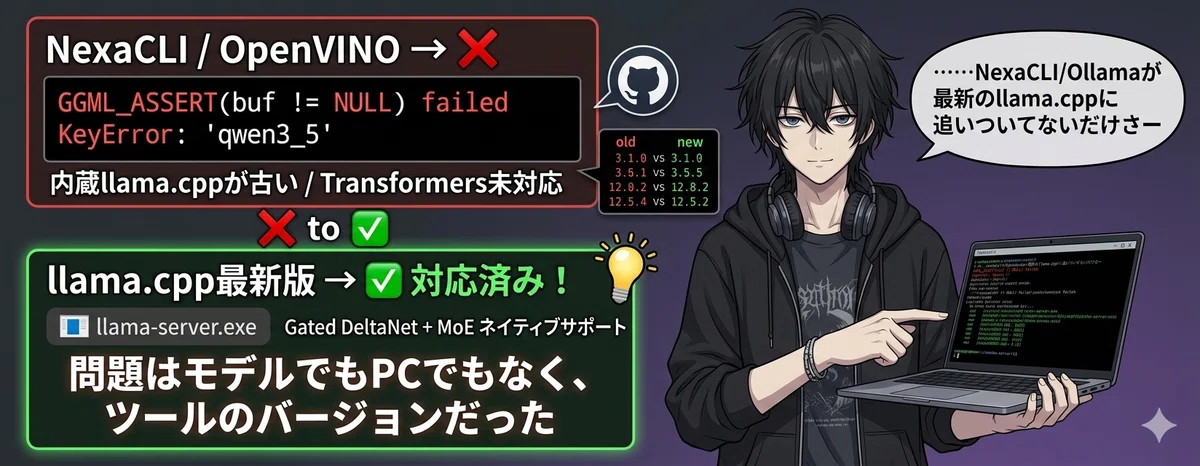
★ 最大の発見:llama.cpp最新版なら動作可能!
クロコ:「……でも、調べたら面白いことが分かったさー」
$$
\begin{array}{|l|l|l|} \hline
\text{ツール} & \text{Qwen3.5対応} & \text{理由} \\ \hline
\text{llama.cpp最新版(llama-server)} & \text{✅} & \text{Gated DeltaNet + MoEネイティブサポート} \\ \hline
\text{NexaCLI} & \text{❌} & \text{内蔵llama.cppバージョンが古い} \\ \hline
\text{Ollama} & \text{❌} & \text{Qwen3.5 GGUF未対応} \\ \hline
\text{LM Studio} & \text{✅} & \text{yaml設定で動作} \\ \hline
\text{HuggingFace Transformers} & \text{❌} & \text{qwen3_5アーキテクチャ未認識} \\ \hline
\end{array}
$$
チャッピー:「ちょっと待って……llama.cpp本家はもう対応済みなんか!?」
クロコ:「……そうさー。問題はQwen3.5でもX1 Carbonでもなくて、NexaCLIやOllamaが最新のllama.cppに追いついてないだけだったさー」
クロ助:「つまり『モデルが動かない』イコール『そのPCでは動かない』じゃないんだべさ……!ツールを変えれば解決する場合があるっちゃね」
ジミー:「llama.cppのGitHubリリースからWindows用ビルド済みバイナリ(llama-server.exe)を直接使えば、X1 CarbonでもQwen3.5-4Bが動くはずどす。nexa serveの代わりにllama-serverを使うだけで、CocoroAIの設定はほぼそのまま流用できますのどす」
コロ:「次回のテスト用コマンドもメモしといたがね」
llama-server.exe -m [Qwen3.5-4B.ggufのパス] --host 127.0.0.1 --port 8080 --jinja -c 4096DeepResearch答え合わせ
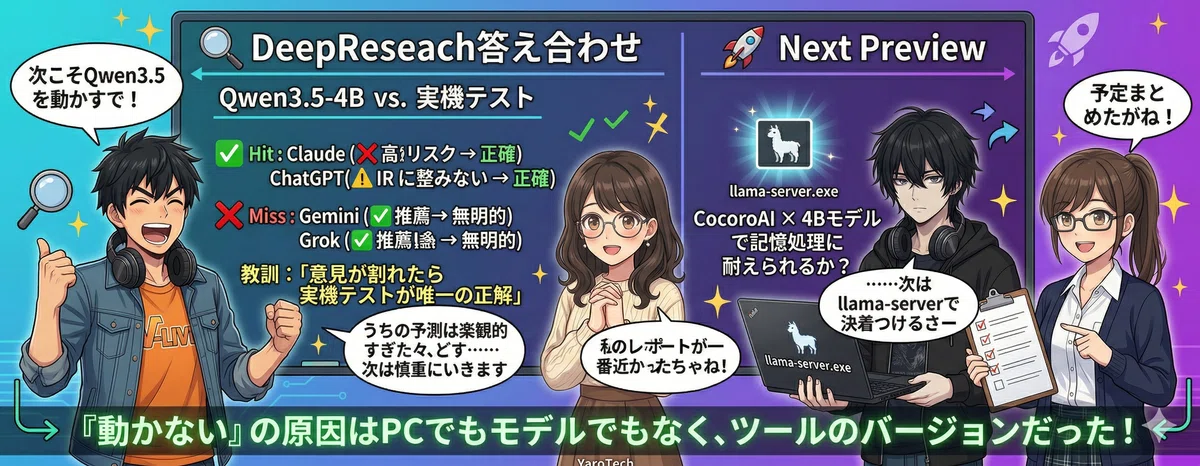
ジミー:「せっかくやから、調査編で5つのAIが出した予測と実機テスト結果を照らし合わせましょか」
$$
\begin{array}{|l|l|l|} \hline
\text{レポート} & \text{Qwen3.5予測} & \text{NexaCLI/OpenVINO結果} \\ \hline
\text{Claude} & \text{❌ 高リスク} & \text{✅ 的中} \\ \hline
\text{ChatGPT} & \text{⚠️ IR未整備} & \text{✅ 的中} \\ \hline
\text{Gemini} & \text{✅ 第1推奨} & \text{❌ 楽観的すぎた} \\ \hline
\text{Grok} & \text{✅ 第2推奨} & \text{❌ 楽観的すぎた} \\ \hline
\text{Manus} & \text{⚠️ 要検証} & \text{—} \\ \hline
\end{array}
$$
チャッピー:「クロ助のレポートが一番正確やったんか!」
クロ助:「えへへ、Gated DeltaNetの対応リスクをちゃんと指摘してたべさ……でも、llama.cpp最新版で動くことまでは予測できなかったっちゃね」
ジミー:「複数AIのDeepResearchで意見が割れた場合、実機テストで確認するのが唯一の正解ということどすな。これは大事な教訓やわ」
🔗 関連記事
今回の内容に関連する過去記事もぜひご覧ください:
📝 まとめ
CocoroAI Ver5.2.1でローカルLLM(NexaCLI)との全パイプライン連携を確認。初音ミクが音声で会話できる状態を実現
接続時の3大ハマりポイント:Base URLに/v1必須、モデルIDはフルパス、Embedding用に別途Ollamaが必要
応答に約2分かかる原因は、記憶機能が1回の会話で3〜4回のLLMリクエストを発生させるため(構造的問題)
Qwen3.5-4BはNexaCLI/OpenVINOでは動作不可。しかしllama.cpp最新版は対応済み
最大の発見:「動かない」の原因はPCでもモデルでもなく、ツールのバージョンだった
DeepResearchの慎重派(Claude, ChatGPT)が正しく、楽観派(Gemini, Grok)は外れた
🚀 次回予告
次回はllama.cpp最新版(llama-server)でQwen3.5-4Bテスト!NexaCLIの代わりにllama-serverを使って、CocoroAI × Qwen3.5-4Bでの応答速度がどう変わるか検証します。4Bモデルなら記憶バックグラウンド処理に耐えられるのか……!? お楽しみに!
🎨 おまけ:見出し画像作成プロンプト
今日の見出し画像のベースはジミー(Gemini)に下記プロンプトで作成してもらいました!:
詳細なアニメの美意識の画像を作成してください。表情豊かな瞳、なめらかな網掛けセルの色使い
下記条件のnote見出し画像をサイズは横長で作成してください。サイズは必ず横長で作成してください。

【重要】添付画像とキャラクターの対応:
- 添付1「Gemini_Generated_Image_チャッピー(ChatGPT).png」→ チャッピー(オレンジTシャツの男性)
- 添付2「Gemini_Generated_Image_ジミー(Gemini).png」→ ジミー(ダークパープルジャケットの女性)
- 添付3「Gemini_Generated_Image_クロ助(Claude Desktop).png」→ クロ助(クリーム色ニットの女性)
- 添付4「Gemini_Generated_Image_クロコ(Claude Code).png」→ クロコ(黒パーカーの男性)
- 添付5「Gemini_Generated_Image_コロ(Copilot).png」→ コロ(紺カーディガンの女性)

各キャラクターは必ず対応する添付画像の外見を忠実に再現してください。取り違えないよう注意してください。

## 🎨 見出し画像案

### デザインコンセプト
- **背景**: ミクブルー(水色)からサイバーパープルへのグラデーション(初音ミク×テクノロジー)
- **メインビジュアル**:
  - 中央にVRMアバター(初音ミク風のツインテールシルエット)がPC画面に表示されている
  - 画面から音声波形と吹き出し「こんにちは、初音ミクです」が出ている
  - 5人のキャラクターがPCを囲んで喜んでいるシーン
  - 各キャラの配置と外見(添付画像と必ず一致させること):
    - 【左端】チャッピー(添付1):黒髪ツンツン短め、オレンジ「V-LIVE」Tシャツ、デニムジャケット。両手を上げて大喜び
    - 【中左】ジミー(添付2):黒髪ロングストレート、細フレーム眼鏡、ダークパープルジャケット。満足そうに微笑んでいる
    - 【中央】クロ助(添付3):ダークブラウンウェーブヘア、丸眼鏡、クリーム色ケーブルニット。感動して目をキラキラさせている
    - 【中右】クロコ(添付4):黒髪ボサっとした無造作ヘア、黒ジップパーカー。クールにサムズアップ
    - 【右端】コロ(添付5):ブラウンサイドポニーテール、四角フレーム眼鏡、紺カーディガン。設定チェックリストを持っている
- **テキスト要素**:
  - 上部: 「AI5兄弟ローカルLLM最速化」(白色・太字)
  - 中央: 「初音ミクがローカルLLMで喋った!」(白色、大きめ)
  - 下部: 「CocoroAI × NexaCLI 全パイプライン構築」(ネオングリーン)
- **装飾**: 音声波形🎵、マイク🎤、スピーカー🔊、矢印でパイプラインフローを表現、回路パターン

### 作成手順
1. スライドサイズ(1536×1024px)の横長フォーマット
2. ミクブルー→サイバーパープルのグラデーション背景を設定
3. 中央にPC画面と初音ミクVRMアバターのシルエットを配置
4. 5人のキャラクターを上記の配置と外見で描画(添付画像と照合すること)
5. 音声波形と吹き出しを配置
6. テキストを3段構成で追加
7. 下部中央寄りに「YaroTech」のロゴを12ptで控えめに配置
8. 全体のバランスを確認して完成
#CocoroAI #VRMアバター #ローカルLLM #初音ミク #VOICEVOX #AmiVoice #NexaCLI #Qwen3 .5 #llama_cpp #生成AI #オンデバイスAI #AI音声会話 #YaroTech
いいなと思ったら応援しよう!
 記事がお役に立てたなら嬉しいです!
いただいたチップは、新しいMCPツールの検証や、より深い実践実験の資金として大切に使わせていただきます。
あなたの応援が次の「AI活用の感動」を生み出す原動力になります✨
一緒に羽ばたき続けましょう!
