GPT-Image-2最強プロンプト術

イテレーション生成時代の制作ワークフロー
いよいよリリースされた GPT-Image-2 、「実際にどう使えばいいの?」という実践編。
🚀 クイックリファレンス
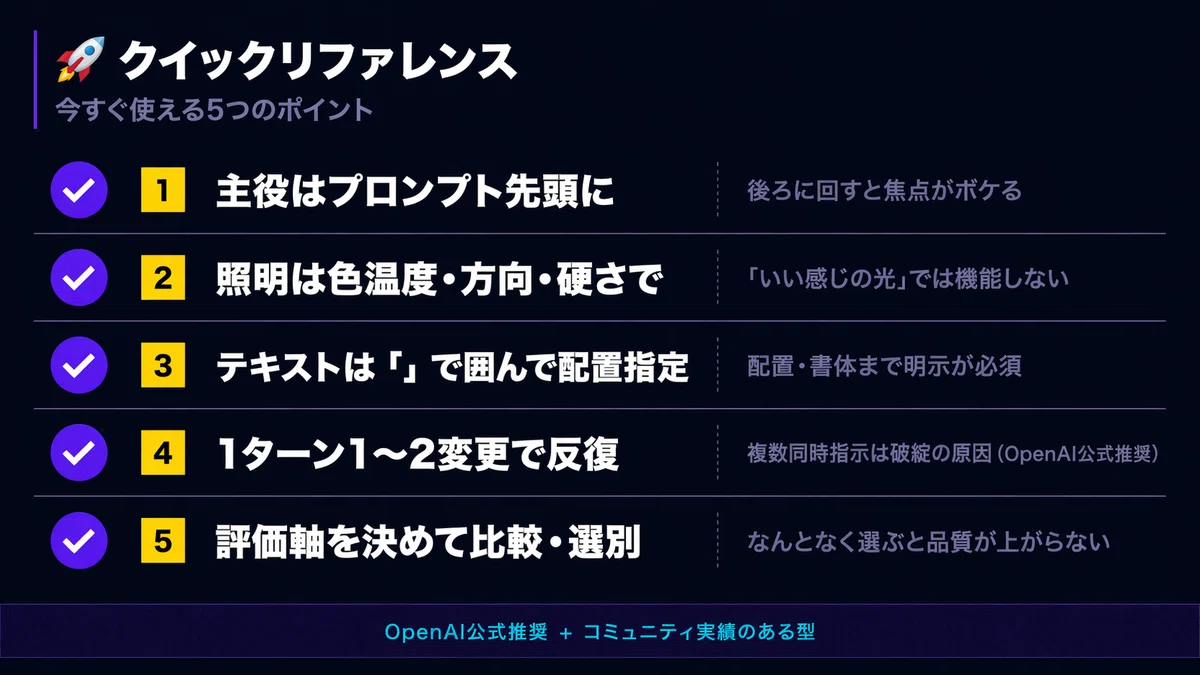
✅️ 被写体・主役(人物・物)
プロンプトの先頭に置く。後ろに回すと焦点がボケる
✅️ 照明
「良い光」ではなく「 左上から暖かいサイドライト、色温度3200K 」レベルで書く
✅️ テキスト
文言は 「」または "" で囲む。配置も「左上に白い太字ゴシックで」と明示する
✅️ イテレーションできる
一発で決めようとえずザックリ生成してから 1ターンに1〜2変更 でブラッシュアップする(後述)
💡 ここからは「なぜこれが効くのか」の解説です。
プロンプトの書き順、気にしてますか?
GPT-Image-2(というかGPT Imageシリーズ全体)の最重要原則として、コミュニティが繰り返し確認していること。
プロンプトは先に書いた要素ほど、構図の骨格に効く。
モデルはテキストを順番に処理するため、冒頭の単語が最大の視覚的重みを持ちます。
「photorealistic portrait of... a businessman」
と書くと「photorealistic」と「portrait」が最優先解釈され、ビジネスマン本人の具体性が薄まる。これが「なんとなく主役が弱い絵」になる原因の一つです。
コミュニティで広まっている7要素フレームワークがこれ。公式フレームではなくテスターたちの経験則ですが、実績のある型です。
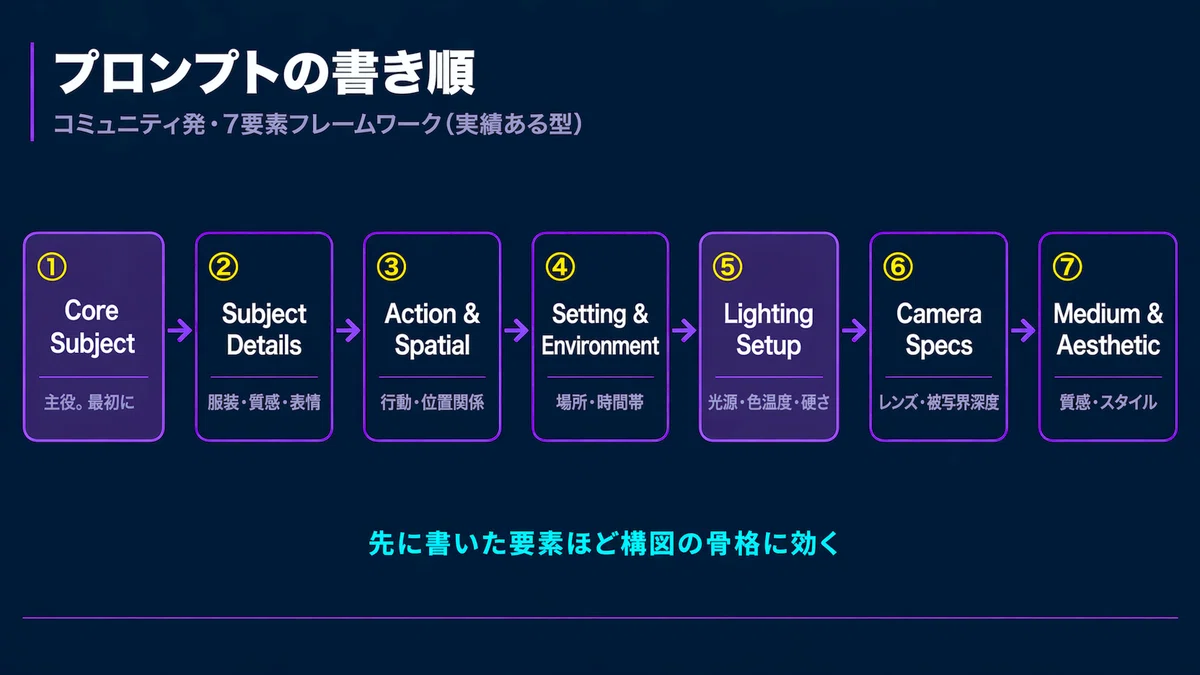
🔶 ① Core Subject(主役)
何が中心かを最初に。人物・動物・製品・何でも。後ろに回すのは厳禁。
🔶 ② Subject Details(主役の詳細)
服装・素材・質感・表情・年齢・髪型。主役の属性はここに集中。
🔶 ③ Action & Spatial Relationship(行動・配置)
何をしているか、画面内の位置(中央やや右寄り、カメラ正面など)。
🔶 ④ Setting & Environment(環境)
場所・時間帯・天候・背景の要素。
🔶 ⑤ Lighting Setup(照明)
光源の方向・色温度・硬さ。ここが曖昧だと質感が死ぬ重要項目。
🔶 ⑥ Camera Specifications(カメラ仕様)
レンズ焦点距離・被写界深度・アングル・ショットサイズ。
🔶 ⑦ Medium & Aesthetic(媒体・美学)
仕上がりの質感やジャンル。プロンプトの最後に置く。
実例
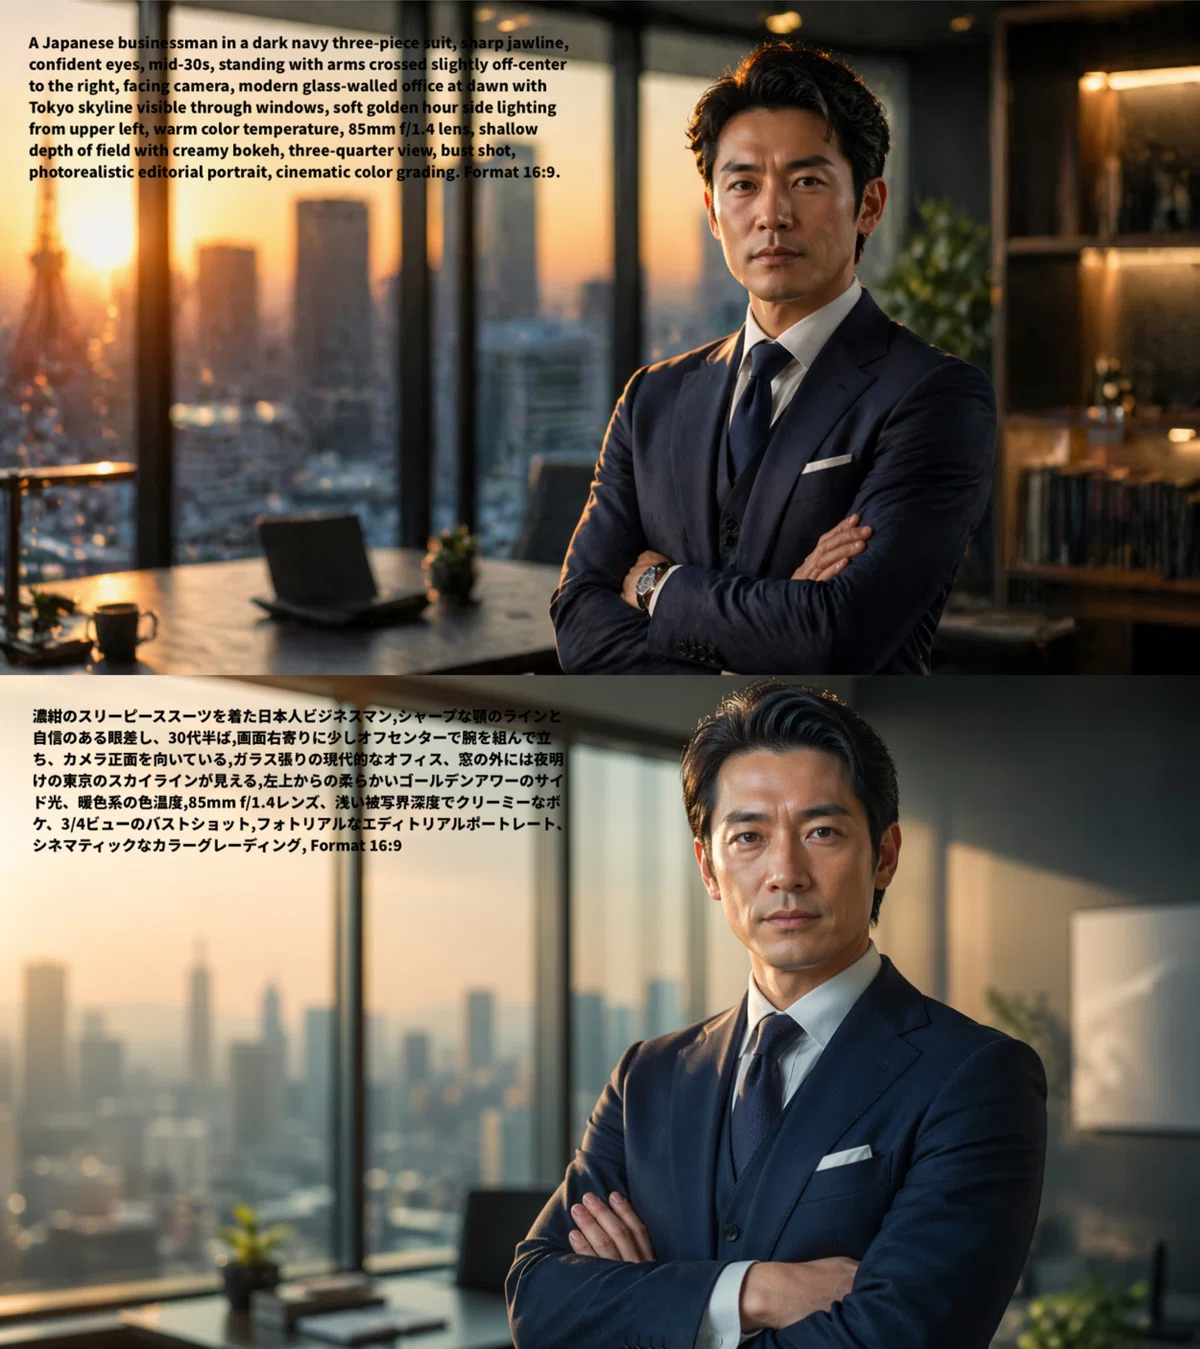
サンプルプロンプトがこれ。全部7要素の順番通りに並んでいます。
【英語版プロンプト】
A Japanese businessman (1) in a dark navy three-piece suit, sharp jawline, confident eyes, mid-30s (2), standing with arms crossed slightly off-center to the right, facing camera (3), modern glass-walled office at dawn with Tokyo skyline visible through windows (4), soft golden hour side lighting from upper left, warm color temperature (5), 85mm f/1.4 lens, shallow depth of field with creamy bokeh, three-quarter view, bust shot (6), photorealistic editorial portrait, cinematic color grading (7). Format 16:9.
【日本語版プロンプト】
濃紺のスリーピーススーツを着た日本人ビジネスマン(1)、シャープな顎のラインと自信のある眼差し、30代半ば(2)。画面右寄りに少しオフセンターで腕を組んで立ち、カメラ正面を向いている(3)。ガラス張りの現代的なオフィス、窓の外には夜明けの東京のスカイラインが見える(4)。左上からの柔らかいゴールデンアワーのサイド光、暖色系の色温度(5)。85mm f/1.4レンズ、浅い被写界深度でクリーミーなボケ、3/4ビューのバストショット(6)。フォトリアルなエディトリアルポートレート、シネマティックなカラーグレーディング(7)。アスペクト比16:9。
生成結果
プロンプトは英語でも日本語でも大差はありません。何度か生成して要件に合うもの・または気に入ったものを選びます。
「何が→どんな状態で→何をしている→どこで→どんな光で→どんなカメラで→何風に」
という流れになります。この構成だと生成モデルが迷いません。結果として破綻しない絵が出てくることになります。
テキスト・照明・カメラ、それぞれの書き方
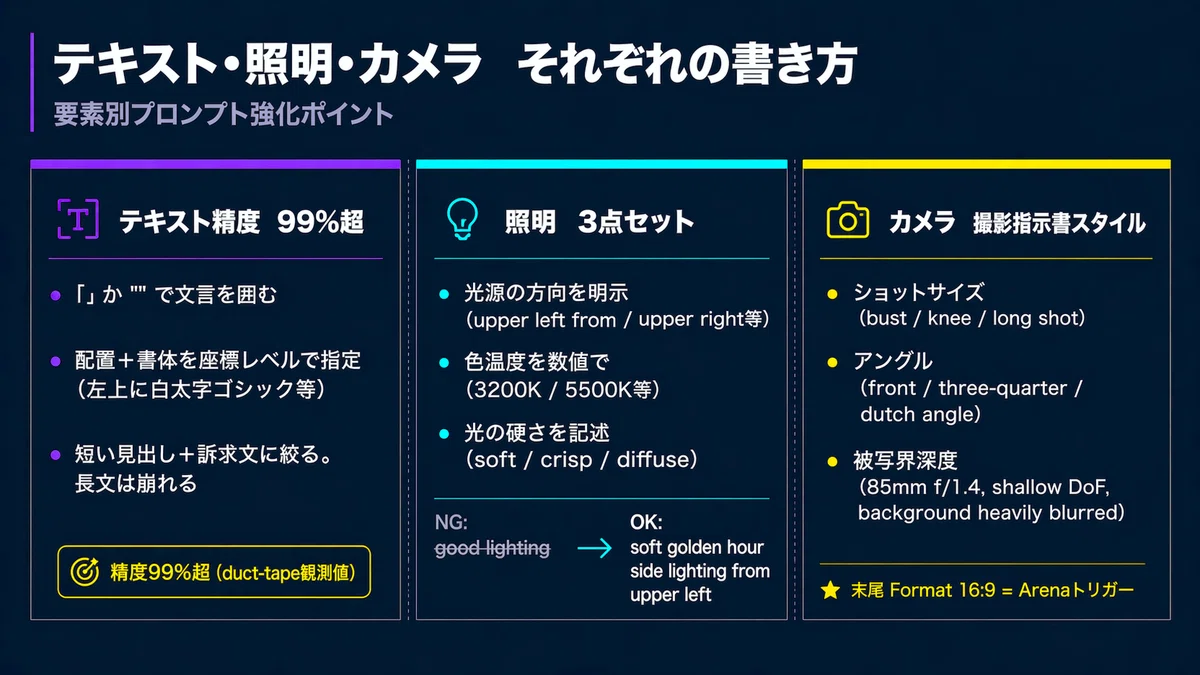
テキストを正確に入れる
duct-tapeという名称で登場したモデルのテキスト精度は99%超との報告が複数あります。
GPT-Image-1.5の90〜95%を大きく上回る水準です。この強みを引き出すには書き方にコツが要ります。
入れたい文言は必ず 「」 か "" で囲む
配置と書体を明示する。「左上に白い太字ゴシックで」「中央下に帯状に」のように座標+フォント属性で指定
見出し+短い訴求文に絞る。長文は崩れやすい
日本語テキストの再現精度が上がっているのは日本のクリエイターにとって特にメリットが大きいです。
GPT-Image-1系は漢字の崩れが課題でしたが、duct-tape系では「電車内広告レベルで漢字・レイアウトが正確に再現された」という𝕏の報告が複数出ています。SNS投稿やバナー系クリエイティブで使い勝手が一変する可能性があります。
ただし一点だけ注意。
画像内にテキストを作り込んだ場合、そのまま動画生成AIで動かすのは難しくなります。テキストが必要なら画像段階で完結させ、動画化する部分は別レイヤーで考えるのが現実的な運用です。
照明で質感を決める
照明指定は「いい感じの光」では機能しません。
🔶 NG例
good lighting
natural light
bright image
🔶 OK例
soft golden hour side lighting from upper left, warm tones
orange key light from left, blue fill from right
cold ambient moonlight, faint pink alpenglow rimming the horizon
色温度・光源の方向・光の硬さの3点セットで書くと、影のリアリティが別次元になります。ここがガバガバだと質感全体がぼやけるので、力を入れる価値がある箇所です。
カメラ仕様で「撮った感」を出す
写真家がアートディレクターに渡す撮影指示書のように書く、というイメージです。
ショットサイズ:bust shot / knee shot / long shot
アングル:front view / three-quarter view / high angle / dutch angle
被写体強調:85mm f/1.4, shallow depth of field, background heavily blurred
アスペクト比はプロンプト末尾に「Format 16:9」と書くのが最も確実とされています。
一発で決めようとしない
OpenAI公式のGPT-Image-1.5向けPrompting Guideには反復的アプローチが明示されています。
クリーンなベースプロンプトから始め、1ターンに1〜2変更ずつ重ねていく。
複数の変更を同時に指示すると要素が干渉して破綻しやすくなります。「照明を暖かく」「余分な木を消して」「ロゴを左上に移動」は、それぞれ別ターンで出すほうが安定します。
実務でのフローはこんな感じ。
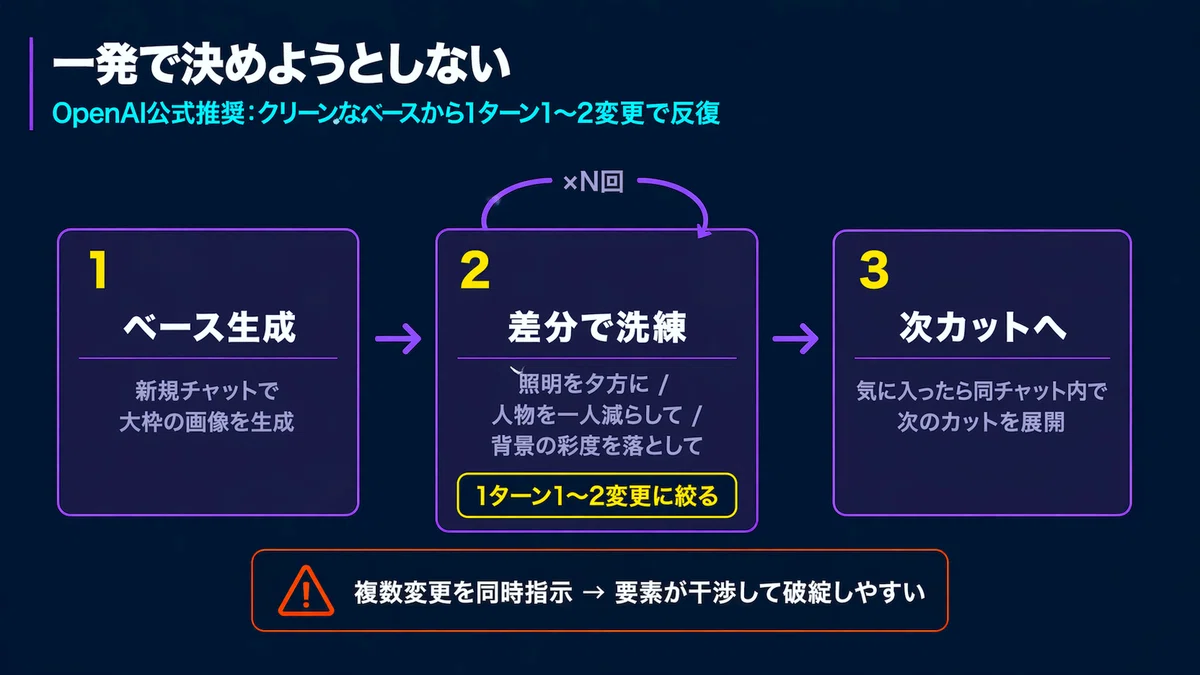
1️⃣ 新規チャットで大枠のベース画像を生成
2️⃣ 同チャット内でフォローアップ指示を重ねる(「照明を夕方に」「人物を一人減らして」「背景の彩度を落として」等)
3️⃣ 気に入ったら次のカットへ
「フルプロンプトを毎回書き直す」は最もつらいループです。ベースが決まったら差分だけ指示する、というリズムを身につけると制作速度が体感で変わります。GPT-Image-2ならこれが可能です。
GPT-Image-2の本領はイテレーション式の「対話型制作」にある
単発プロンプトで1枚を完成させるのはこのモデルの性能を半分も使えていません。
ChatGPTの会話文脈そのものが制作タイムラインになる。
同一チャット内で生成した画像は次のターンから「前の画像」として参照可能な状態で保持され続けます。
キャラや世界設定に「main character sheet」のような名前を与えておくと、以降は
「same character, but mid-combat」
「same deck, cream color version」
のような短い差分指示だけで通じます。これが使えると制作速度が桁違いに変わります。
活用用途を三つ挙げます。
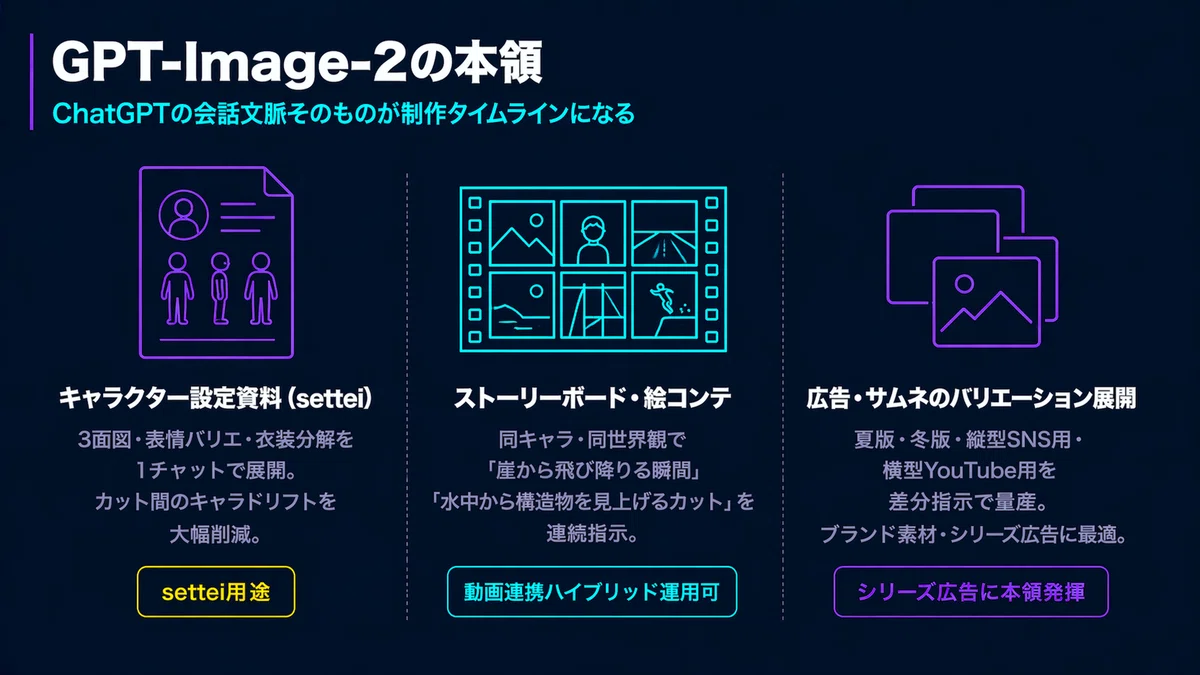
キャラクター設定資料(settei)
正面/側面/背面の3面図+表情バリエ+衣装分解+カラーパレットを1枚のシートに。同一チャット内でキャラ情報を保持させながら展開するので、カット間のキャラドリフト(衣装や顔つきが微妙にズレていく現象)が大幅に減ります。
GPT-Image-2が「キャラシ」で特に話題になっているのはこれが理由です。従来のモデルでは外部ツールでリファレンス画像を管理し毎回アップロードしていた作業が、会話の流れだけで成立するようになります。
ストーリーボード・絵コンテ
ベースシーンを確立したあと「同じキャラ・同じ世界観で、崖から飛び降りる瞬間に」「水中から構造物を見上げるカットに」と連続して指示できます。世界観を保ったまま複数カットが揃う感覚は、従来の画像生成AIとは別物です。
ここに動画連携を組み合わせる方法も面白くて。GPT-Image-2でテキスト・固定要素・キャラクターを確定させておき、動く部分だけSeedanceやKlingに任せるハイブリッド運用です。現状の動画生成AIは画像内テキストの扱いが苦手なので、テキスト込みのビジュアルは画像で完成させてしまうほうが合理的です。
広告・サムネのバリエーション展開
同じ商品やキャラを「夏版」「冬版」「縦型SNS用」「横型YouTube用」と短い差分指示で量産できます。ブランド素材やシリーズ広告のバリエーション制作はまさにここが本領です。
実践例
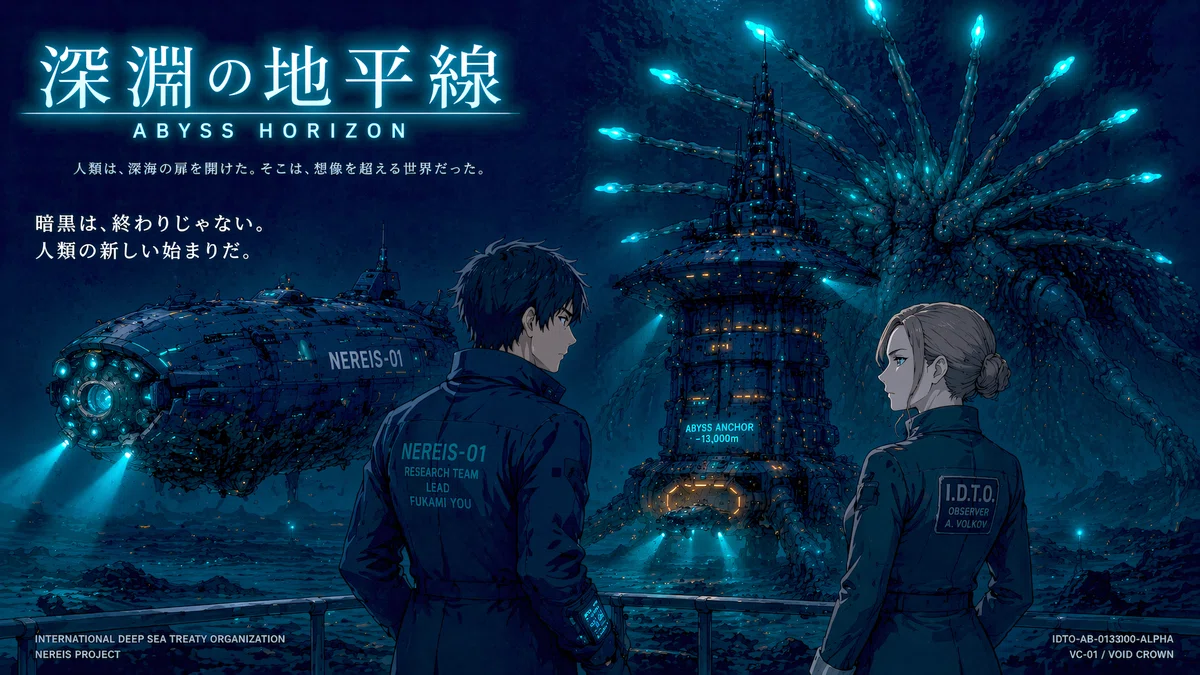
この画像がまさにイテレーションで生成したものです。チャット・セッション内の画像を参照させて、ストーリー展開させる指示を出して生成したもの。
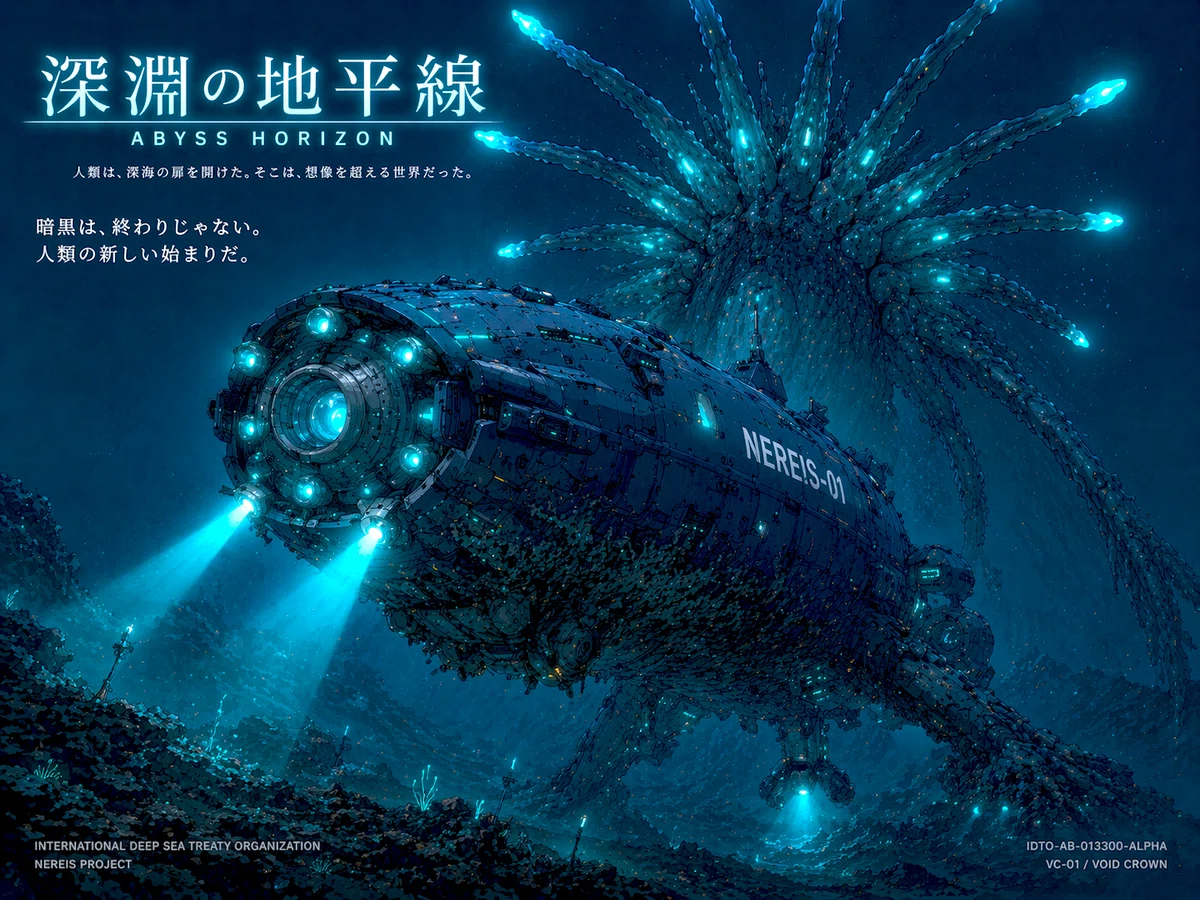
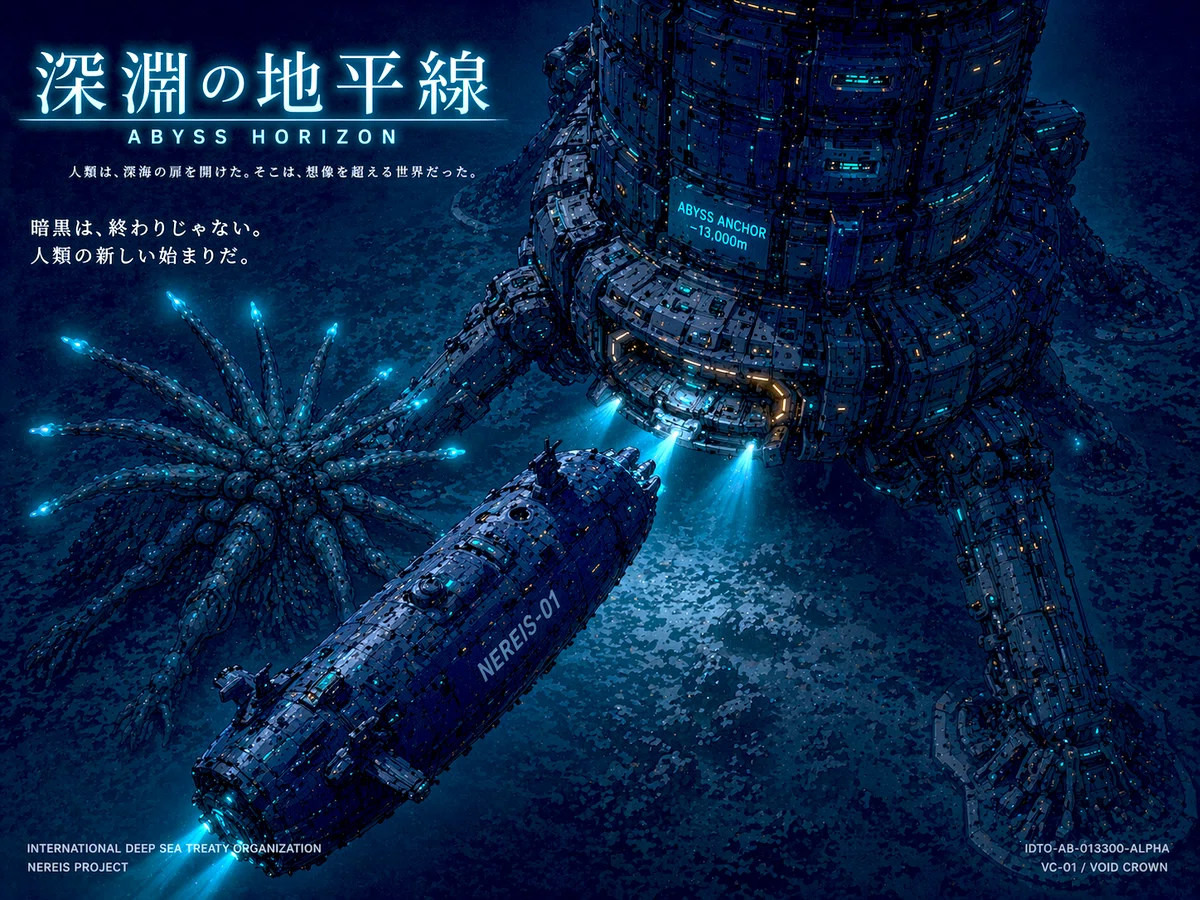
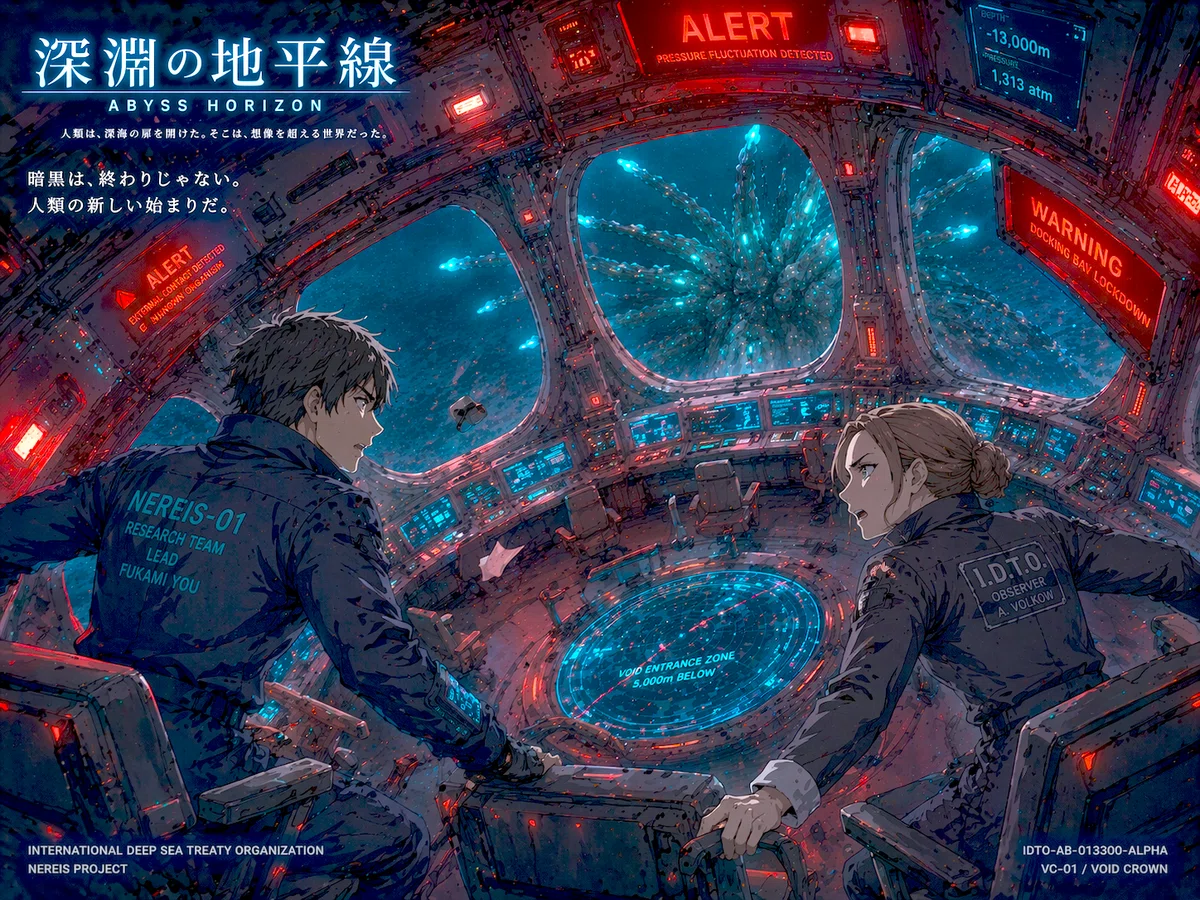
別パターン
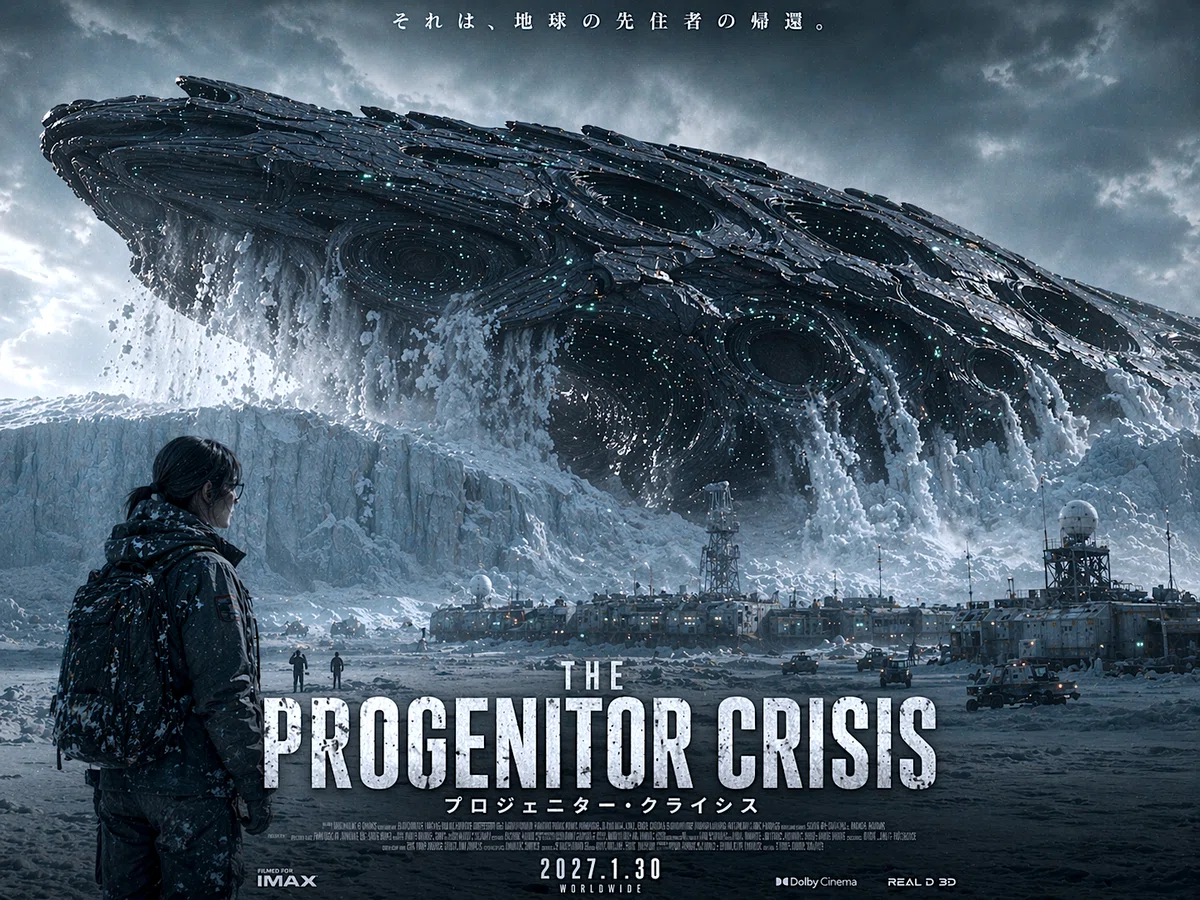
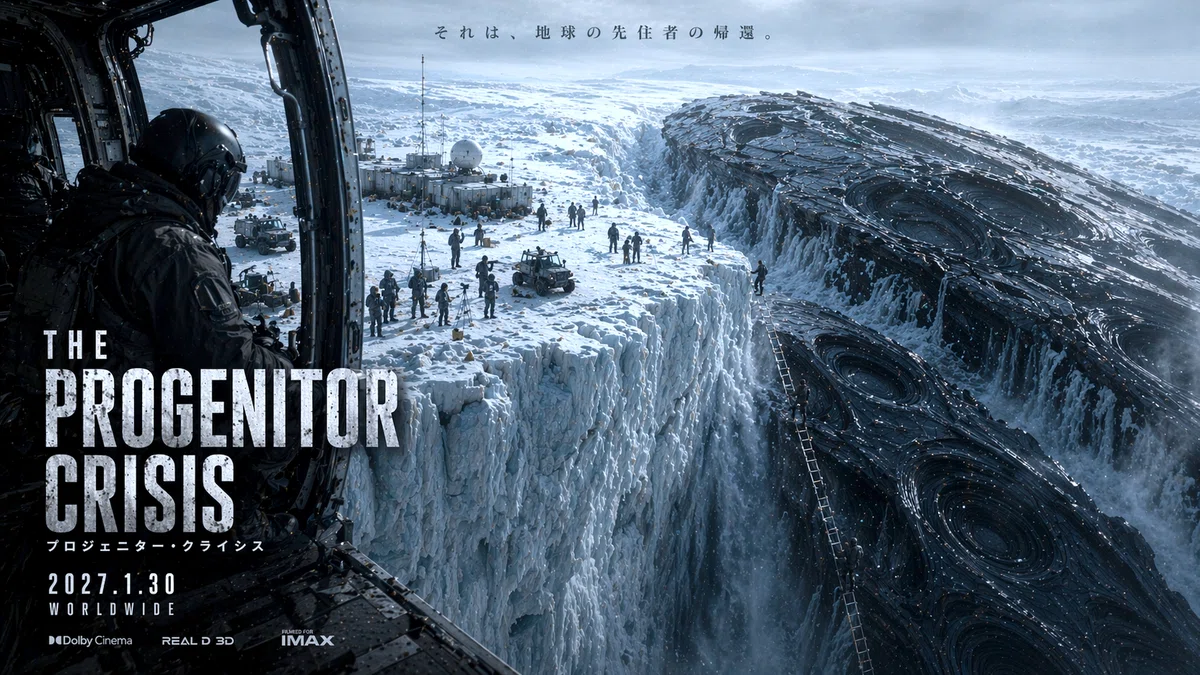
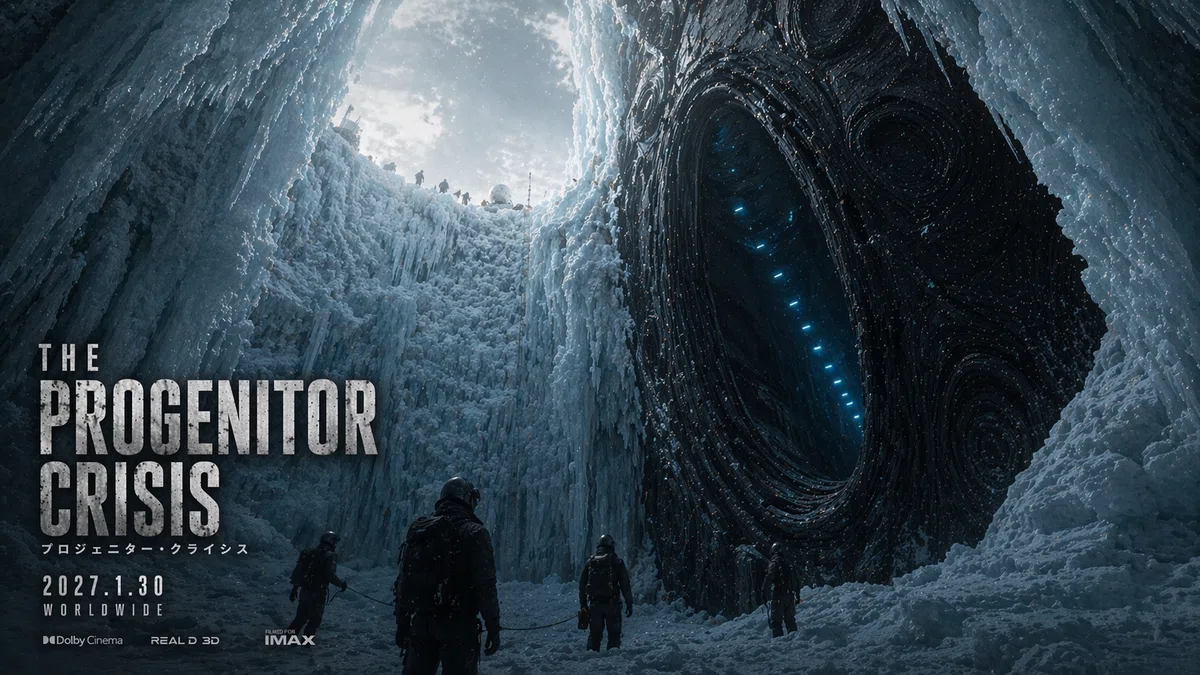
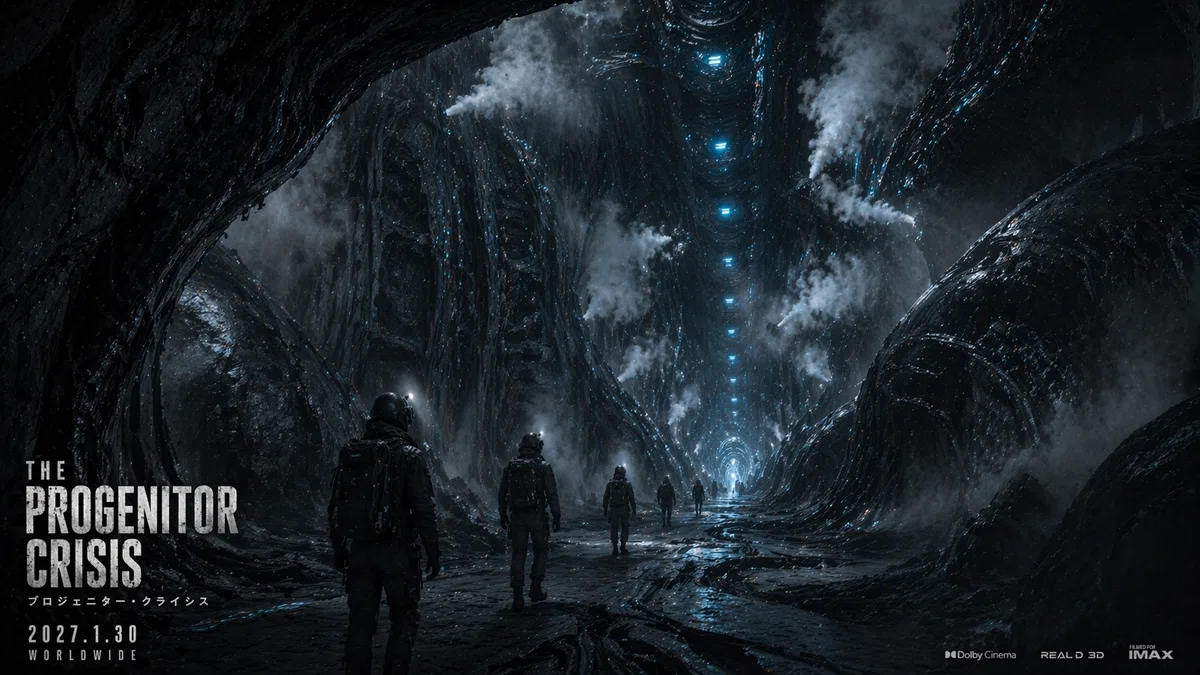
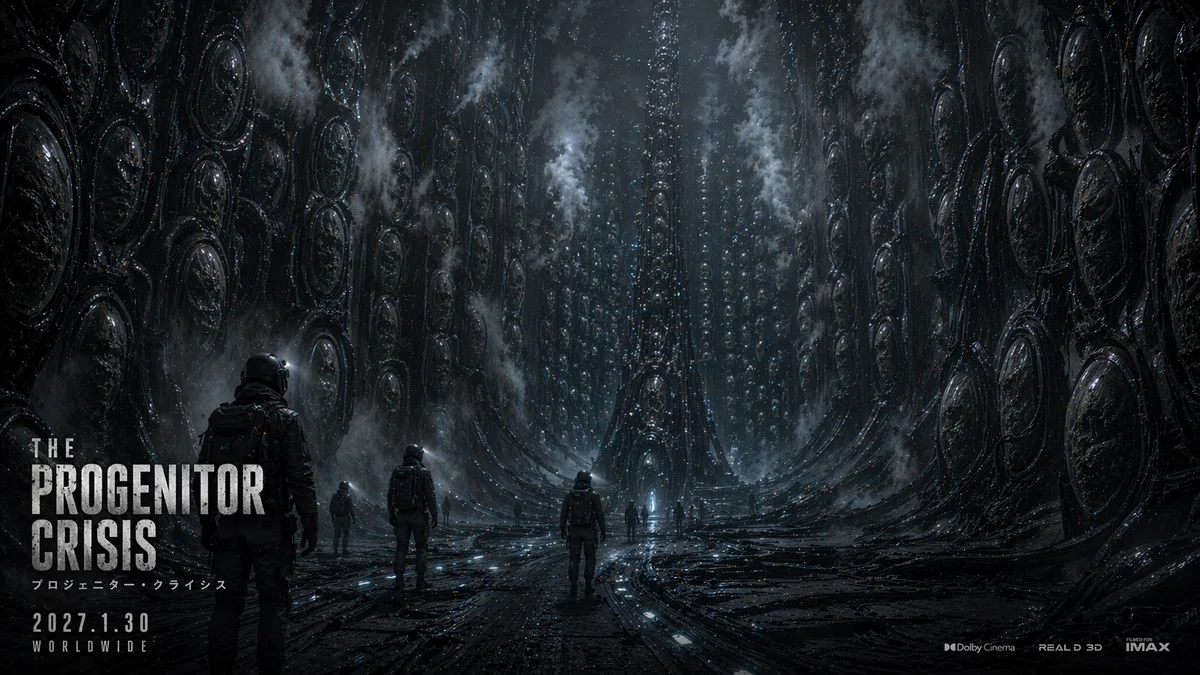
ストーリーボードとして十分すぎる生成機能であることが判ります。
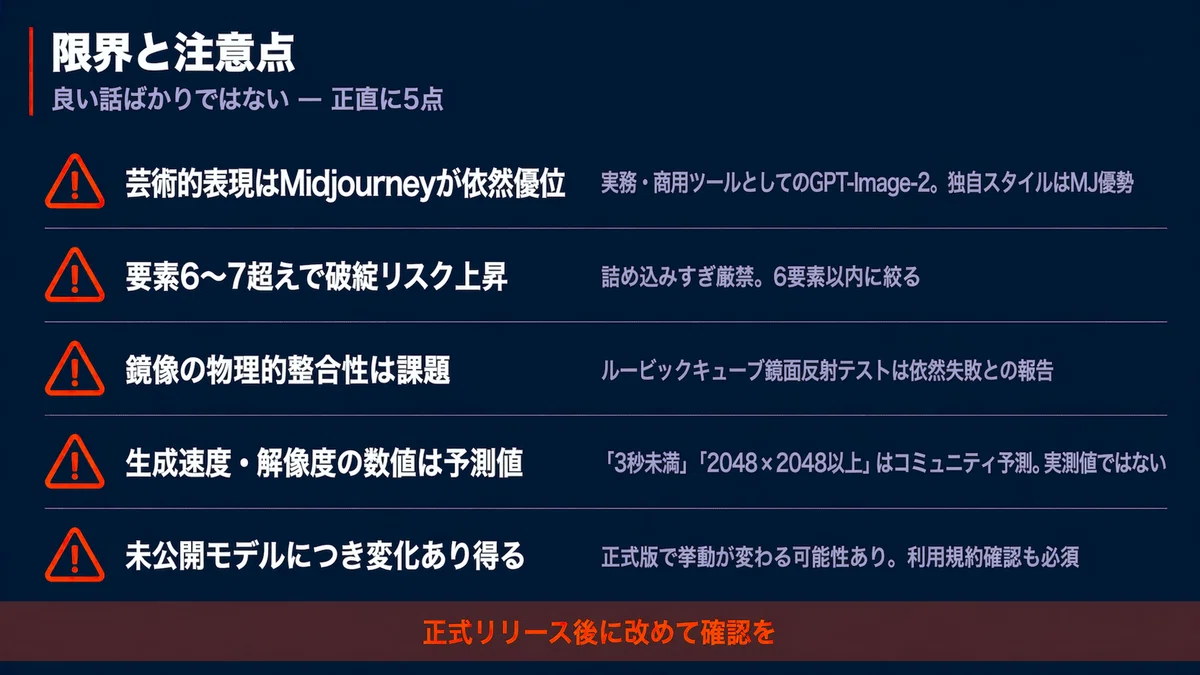
限界と注意点
⚠️ 過剰な構成は崩れる
要素が6〜7を超えてくると破綻リスクが上がります。詰め込みすぎは厳禁。
⚠️ 鏡像の物理的整合性は課題あり
「ルービックキューブの鏡面反射テスト」(鏡に映ったキューブの色配置が物理的に正しいか)は依然失敗するとの報告。この種の物理的整合性はまだ弱い。
⚠️ 生成速度・解像度の数値は予測値
「3秒未満」「2048×2048以上対応」はコミュニティの予測値であり、duct-tapeで実測確認されたわけではありません。
⚠️ 未公開モデルにつき変化あり得る
正式版で挙動が変わる可能性は残ります。正式リリース後の利用規約確認も必須です。
⚠️ 芸術的・幻想的な表現はMidjourneyが依然優位
GPT-Image-2は「実務・商用の信頼できるプロダクションツール」としてのポジション。独自の芸術性や個性的なビジュアルスタイルを求めるならMidjourneyに軍配が上がる場面が多い。
まとめ
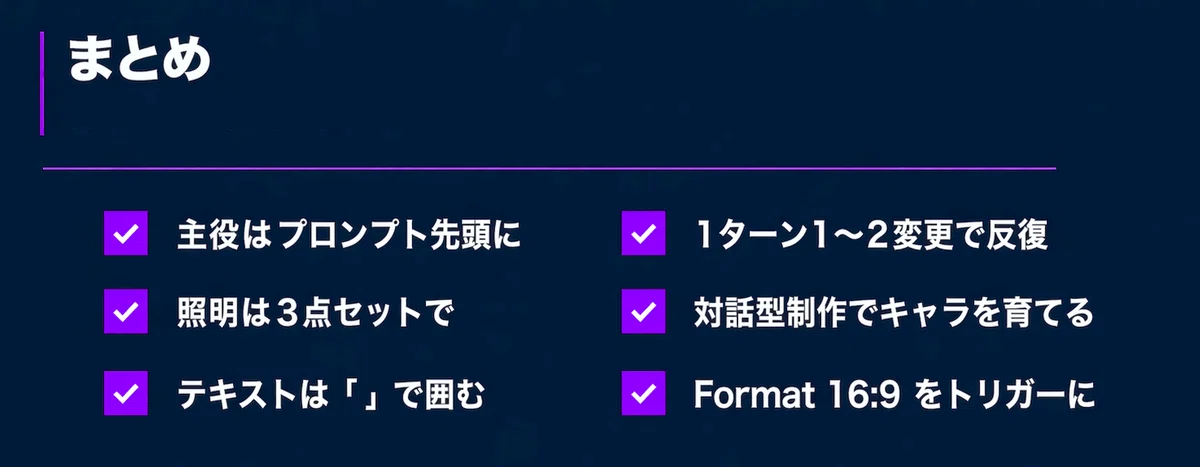
✅️ 主役はプロンプト先頭に(7要素フレームの核心)
✅️ 照明は色温度・方向・硬さの3点セットで
✅️ テキストは「」で囲んで配置まで指定
✅️ 1ターン1〜2変更の反復で仕上げる(OpenAI公式推奨)
✅️ 対話型制作でキャラ・世界観を育てる
✅️ Arenaなら Format 16:9 をトリガーに
メンバーシップやってます!
ご興味あるかたは、ぜひご参加ください。
