


开篇:本系列与第一篇导读
《XCVU13P 开发指南》是一套面向笃远电子 VU13P 开发板的三篇系列文章。本篇为第一篇《平台与产品》,聚焦芯片架构与板卡硬件,建立资源-接口-应用的完整认知。读完本篇你将能够:
- 说清 XCVU13P 的架构家底——逻辑、DSP、BRAM/UltraRAM、GTY、PCIe 硬核各自能干什么,资源瓶颈在哪;
- 完整看懂笃远电子 VU13P 板卡的硬件地图,知道每一个高速接口接的是芯片的哪部分资源;
前置条件:掌握 Verilog/VHDL 基础语法,理解时序约束基本概念(create_clock、set_property PACKAGE_PIN),本机已能运行 Vivado。文中所有具体引脚编号均以随板原理图为准,示例约束中的管脚为教学占位,直接拷贝无法工作——这一点会反复提醒。
2. 产品介绍:笃远电子 VU13P 开发板
2.1 板卡速览
笃远电子 VU13P 是一块标准 PCIe 全高全长形态的加速卡,核心器件为工业级 XCVU13P-2FHGB2104I(温度范围 -40°C~85°C),面向高性能工业视觉、高速信号处理、低时延事务处理与 ASIC 原型验证场景。官方参数如下:
| 项目 | 参数 |
| 开发板型号 | VU13P |
| FPGA | XCVU13P-2FHGB2104I(工业级,-40°C~85°C) |
| 逻辑资源 | 3,780K 逻辑单元 / 1,728K LUT / 3,456K FF |
| DSP / BRAM / UltraRAM | 12,288 个 / 94.5Mb / 360Mb |
| PCIe | 1 × PCIe Gen3 x16 金手指 |
| FMC+ | LA 34 对 + HA 24 对 IO,16 对 GTY 收发器 |
| FMC HPC | LA 34 对 + HA 24 对 IO,8 对 GTY 收发器 |
| OCULINK | 2 个高速互联接口 |
| 板载内存 | 4GB DDR4,2400 MT/s,64bit 位宽 |
| 扩展内存 | DDR4 SODIMM 插槽,72bit(含 ECC),2400 MT/s |
| 配置存储 | QSPI FLASH 2Gbit(256MB) |
2.2 板卡硬件架构与数据通路
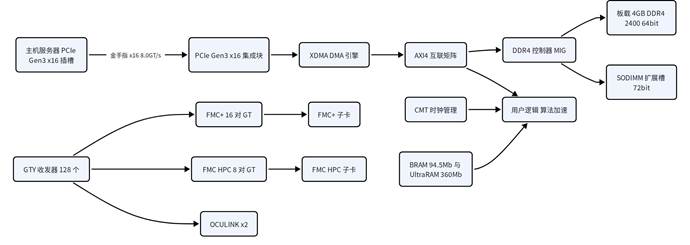
整块板卡的逻辑关系可以浓缩为一张架构图:PCIe 金手指是主机侧唯一入口,DDR4 是数据的大仓库,FMC/OCULINK 是高速 I/O 的出口,而 XCVU13P 是这一切的交换中枢。
2.3 高速互联资源详解
2.3.1 PCIe Gen3 x16:与主机通信的主干道
金手指走 PCIe Gen3 x16,单方向理论带宽约 15.75 GB/s(8 GT/s × 16 lanes × 128/130 编码),双向约 31.5 GB/s。这意味着板卡与主机之间的数据搬运几乎不会成为瓶颈——瓶颈通常出在主机侧驱动和你的 DMA 设计上。VU13P 有 4 个集成 PCIe 块,板卡只引出 1 个 x16,其余硬核资源可自由用于其他 PCIe 通道(例如板卡与板卡互联)。
2.3.2 FMC+ 与 FMC HPC:子卡扩展的高速走廊
FMC(FPGA Mezzanine Card)是 FPGA 板卡扩展的行业标准。VU13P 提供两个扩展口:
- FMC+(VITA 57.4):LA 34 对 + HA 24 对差分 IO,外加 16 对 GTY 高速收发器。FMC+ 是 VITA 57.4 定义的带宽增强版,单连接器最多可承载 24 对 GT 与 40 对 LA/HA/HB IO。这 16 对 GTY 适合接高速 ADC/DAC 子卡(如 JESD204B 接口)、光模块或协议子卡。
- FMC HPC(VITA 57.1):LA 34 对 + HA 24 对 IO,8 对 GTY。HPC 是传统高引脚数 FMC,适合接各类中低速 IO 与少量高速通道。
实操提示:FMC 的管脚分配由 VITA 标准固定(LA00~LA33、HA00~HA23 对应芯片的确定引脚),Vivado 的 FMC 子卡约束可以直接从子卡厂商拿到。换子卡时,GTY 所在的 Quad 和参考时钟引脚必须重新核对原理图,这是 FMC 设计最常见的翻车点。
2.3.3 OCULINK:另一种高速出口
板载 2 个 OCULINK 连接器。OCULINK 是面向 PCIe/外部高速互联的开放标准连接器(每路支持 4 lanes 高速差分),在 VU13P 上通常接 GTY 通道,用于板卡与外部设备、板卡与板卡之间的高速互联,可承载 PCIe Gen3 x4 或自定义 GT 协议(如 Aurora、10G/25G 以太网)。具体 lane 映射以原理图为准。
2.4 存储系统
- 板载 4GB DDR4:2400 MT/s、64bit,理论带宽约 19.2 GB/s,是默认的主数据缓冲。配 MIG(Memory Interface Generator)IP 使用,控制器时钟通常取 1200 MHz(DDR4-2400 的 1:2 时钟比)。
- DDR4 SODIMM 扩展槽:72bit 位宽(含 ECC 校验位),2400 MT/s。插上内存条后可扩展容量,带宽提升到约 21.6 GB/s。做大数据量应用(图像序列、大模型权重、数据库)时,优先用 SODIMM 扩充容量。
- QSPI FLASH 256MB:配置存储,用于上电自启动(Master SPI 模式)或存放 bitstream + 应用数据。2Gbit 容量在 UltraScale+ 板卡中属于大容量配置,甚至可以把 MCAP/多版本 bitstream 一并放进去。
2.5 时钟与供电
高速板卡设计里,"时钟是灵魂"。VU13P 的时钟体系一般包含:FPGA 参考时钟(如 200MHz 差分,用于 MMCM/PLL 生成用户逻辑时钟)、PCIe 参考时钟(100MHz,由金手指 REFCLK 或板载晶振提供)、GT 参考时钟(如 156.25MHz,用于高速收发器)。具体频率与引脚必须查原理图与板卡用户手册,并在 XDC 中用 create_clock 显式声明。
供电上,板卡以 PCIe 金手指 12V 供电为主,并配有辅助供电接口与板载电源树(给 VCCINT/VCCAUX/VCCO 等多路供电轨)。工业级设计意味着电源余量与滤波更充分,但上电前仍应确认供电与散热条件:VU13P 满载功耗可观,必须保证风道与散热器安装到位。
3. 芯片与平台:XCVU13P 的架构家底
3.1 芯片定位:UltraScale+ 家族的计算旗舰
XCVU13P 是 AMD(原 Xilinx)Virtex UltraScale+ 家族中逻辑密度最高、资源最全的成员之一,采用 TSMC 16nm FinFET+ 工艺制造。它的定位非常清晰:用海量可编程逻辑 + 万级 DSP + 大容量片上存储 + 128 个高速收发器,去承接需要极致并行度、极低时延、极高带宽的负载——ASIC 原型验证、5G/6G 基带、高速信号处理、数据中心加速。它不是"跑分好看"的芯片,而是为"把算法变成电路"设计的。
和 Zynq UltraScale+(自带 ARM 核的 SoC)不同,Virtex 系列是纯 FPGA:没有硬 CPU,一切处理逻辑都由你写到可编程 fabric 里。好处是资源全部归你支配,坏处是没有现成的软件栈,一切从 RTL 开始。
3.2 核心资源规格
下表是 XCVU13P 的官方核心参数(AMD DS923 数据手册口径):
| 资源类型 | XCVU13P 数量 | 说明 |
| 系统逻辑单元(Logic Cells) | 3,780K | 约 2000 万 ASIC 等效门 |
| CLB LUT / Flip-Flop | 1,728K / 3,456K | 6 输入 LUT |
| DSP Slice(DSP48E2) | 12,288 | Peak INT8 约 38.3 TOPS |
| Block RAM | 94.5Mb | 36Kb/块,含 FIFO 逻辑 |
| UltraRAM | 360Mb | 288Kb/块,大容量低时延片上缓存 |
| GTY 收发器 | 128 个 | 单通道最高 32.75 Gb/s(NRZ) |
| 集成 PCIe 块 | 4 个 | 每个支持 Gen3 x16 配置 |
| CMT(PLL/MMCM) | 36 个 | 时钟生成与管理 |
| 用户 I/O | 最多 832 个 | HP/HR bank 组合 |
注意两个常见的"数字打架":AMD 官方统计的是芯片原生资源(128 GTY、832 I/O),而开发板手册给出的往往是实际引出/可用数量(例如 76 对 GTY、360 个 IO)。两者口径不同,做选型与管脚规划时务必分清。
3.3 横向对比:VU9P / VU11P / VU13P
| 参数 | XCVU9P | XCVU11P | XCVU13P |
| 系统逻辑单元 | 2,586K | 2,835K | 3,780K |
| DSP Slice | 6,840 | 9,216 | 12,288 |
| 片上存储(BRAM+URAM) | 345.9Mb | 341Mb | 455Mb |
| GTY 收发器 | 120 | 96 | 128 |
| 集成 PCIe Gen3 x16 块 | 3 | 3 | 4 |
一句话选型:需要最大逻辑密度和最多 GTY 时选 VU13P;对功耗/成本敏感、逻辑规模可控时可降级 VU11P/VU9P。
3.4 架构特性解读:决定你写代码方式的关键
3.4.1 GTY 收发器:带宽的入口
GTY 是 UltraScale+ 的通用串行收发器,单通道 NRZ 速率最高 32.75 Gb/s,向下兼容 1.25G~28.21G 等常用档位。128 个 GTY 意味着芯片原生可以同时撑起多路 100G/400G 以太网(100G 需要 4 个 25.78G 通道,400G 用 16 个 25.78G 通道 NRZ),或者大量 PCIe/Interlaken 链路。GTY 内部自带 PCS/PMA、8B/10B 与 64B/66B 编解码、PRBS 测试模块,调试时可以直接用 IP 自带的回环(loopback)先验证物理层,再验证逻辑层。
3.4.2 DSP48E2:算力引擎
每个 DSP48E2 是 27×18 位乘加单元,支持级联、SIMD、以及为 INT8 推理优化的打包模式(一个 DSP 可拆成两个独立 INT8 乘法)。12,288 个 DSP 撑起约 38.3 TOPS 的 INT8 峰值算力——这正是 VU13P 能用于 AI 推理加速的底气。写代码时优先让综合工具推断 DSP(乘法、乘加、卷积),避免用 LUT 搭乘法器浪费资源。
3.4.3 BRAM + UltraRAM:两级片上存储
BRAM(36Kb/块)适合做 FIFO、行缓存、小系数表;UltraRAM(288Kb/块)适合做大容量数据缓存、DMA 缓冲、查找表,其访问时延比外部 DDR 低一个数量级。94.5Mb BRAM + 360Mb UltraRAM 的组合,让很多"必须靠 DDR 才能放下"的中间数据可以留在片上,是低时延设计的关键资源。
3.4.4 集成 PCIe 块:与 CPU 对话的硬核通道
VU13P 原生集成 4 个 PCIe Gen3 x16 硬核块,支持 Root Port / Endpoint 双角色,并支持 CCIX(缓存一致性加速)特性。硬核的意思是:物理层(PHY)和链路层的大部分工作由硅片完成,你只需要通过 AXI 接口读写数据,TLP 封装/解封装、流量控制、错误重传都由硬核处理。这是 PCIe 开发"能实操"的根本前提——不需要手写 TLP。
4. 典型应用落地路径
4.1 ASIC/SoC 原型验证
3,780K 逻辑单元 ≈ 2000 万 ASIC 等效门,配合 4 块集成 PCIe 硬核与 FMC/OCULINK 高速互联,可复刻大规模 SoC 逻辑、跑真实软件负载(通过 PCIe 桥接到主机侧软件栈)。实操路线:RTL 移植到 Vivado → 用厂商 demo 验证平台 → 分模块替代 RAM/时钟 → 逐步接入主机侧仿真。
4.2 5G/6G 基带与高速信号处理
128 个 GTY + 双 FMC + OCULINK 的组合,可直接挂接 JESD204B 射频子卡(FMC+ 的 16 对 GT 正好覆盖 8 收 8 发 ADC/DAC 链路),在 FPGA 内完成波束赋形、信道编解码、FFT 等基带处理。参考数据流:射频子卡 → JESD204B IP → 基带处理(DSP 阵列)→ DDR 缓冲 → PCIe 上送主机。
4.3 数据中心异构加速
PCIe Gen3 x16 提供约 15.75 GB/s 单向带宽,搭配 XDMA + DDR4 + 38.3 TOPS INT8 算力,适合做轻量化 AI 推理、数据库加速、网络卸载等。落地要点:主机侧用标准驱动与用户态库(如 SPDK/DPDK 生态)对接,FPGA 侧保证 DMA 描述符吞吐与中断合并策略,避免"算得快、搬得慢"。
系列预告:第二篇《环境与入门实操》将带你完成 Vivado 环境搭建、第一个工程与核心 IP 配置;第三篇《DMA、调试与工程化》聚焦 PCIe DMA 数据通路、调试排障与工程化实践。


 扫一扫


:平台与产品——基于笃远电子 VU13P 开发板&spm=1001.2101.3001.5002&articleId=165100155&d=1&t=3&u=48cd8ce73e9844bfa91b9cb7d37eacc3)
 1622

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


