


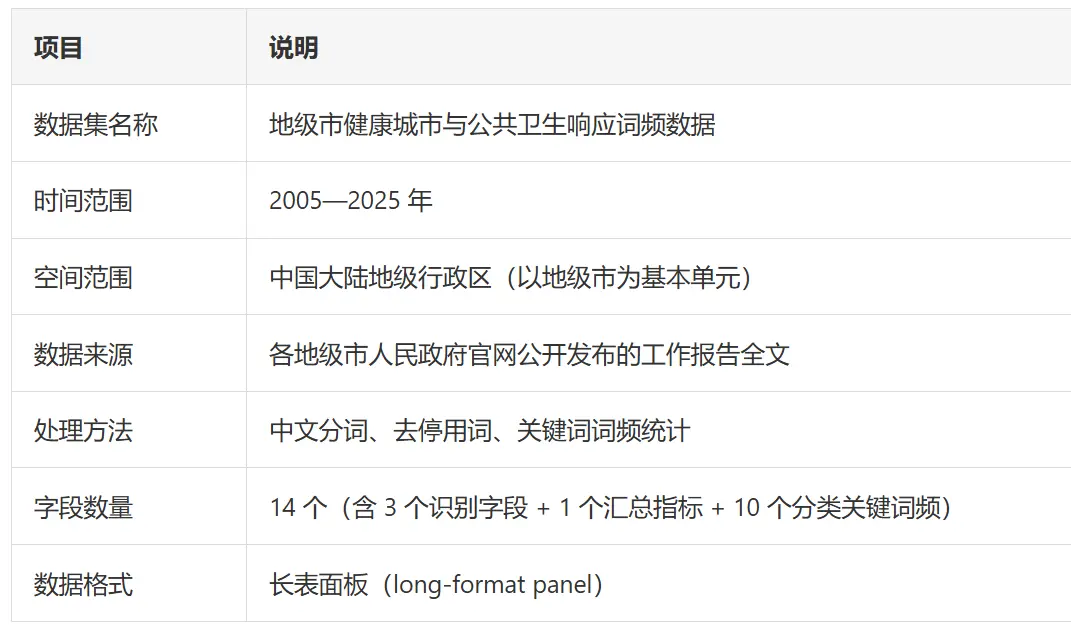
一、数据集基本情况
本数据集系统记录了 2005—2025 年间中国地级市政府工作报告中与"健康城市"和"公共卫生响应"相关的政策文本特征,覆盖词频统计结果,可用于评估地方政府的健康治理关注度与公共卫生议程设置的纵向演化。数据为面板结构,以省—市—年三个维度交叉组织,每行观测对应一个地级市在某一年份工作报告中的关键词频统计结果。
二、指标界定与口径说明
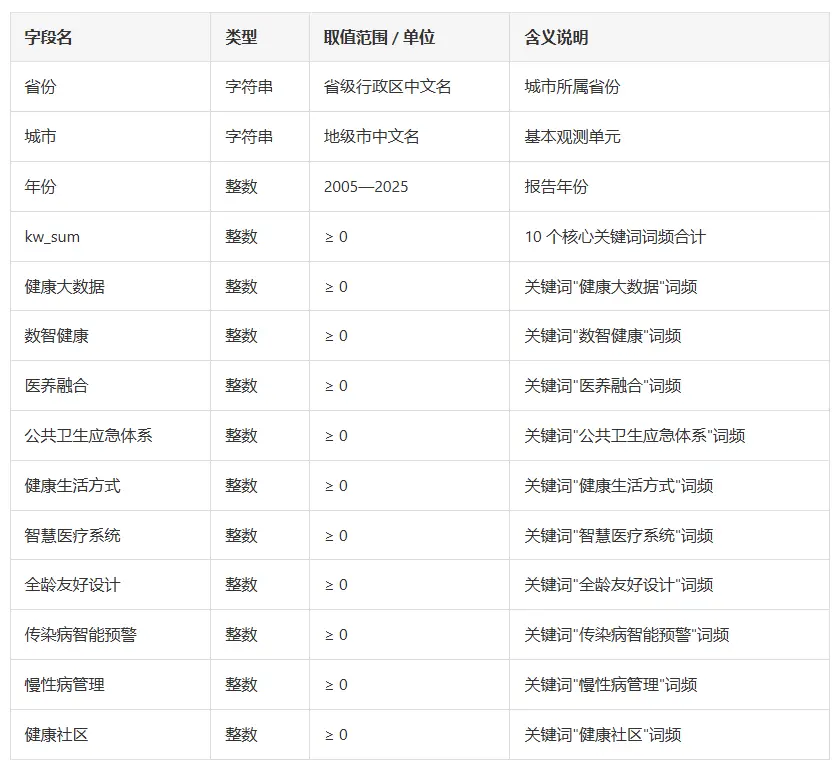
1. 基础识别字段
• 省份:地级市所属省级行政区名称(中文全称)。
• 城市:地级市名称(中文全称)。
• 年份:观测年份,取值范围 2005—2025,类型为整数。
2. 汇总指标
• kw_sum(词频和):当年该市政府工作报告中,纳入统计的 10 个健康城市与公共卫生响应核心关键词的词频合计。该字段反映该年度地方政府对健康议题的整体关注强度。
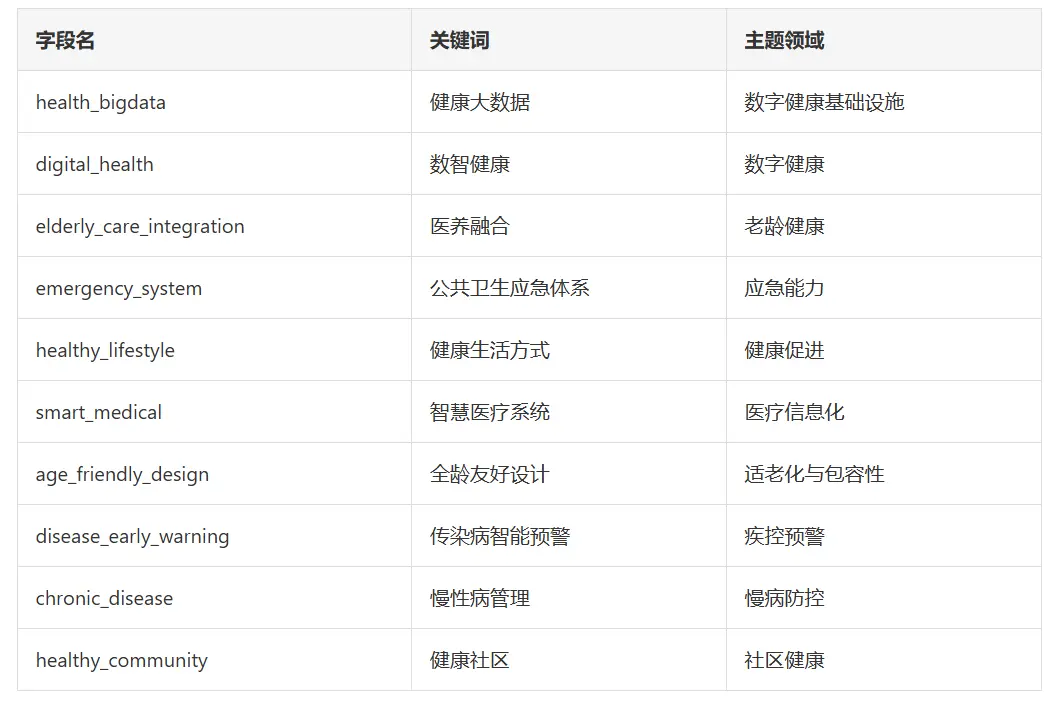
3. 分类关键词频字段(10 个)
每一字段记录对应关键词在当年政府工作报告中的出现次数(0 表示未提及):
4. 口径说明
• 分词标准:采用通用中文分词器对工作报告文本进行分词处理;具体分词工具与词典版本未在数据描述中披露。
• 去停用词:分词后过滤通用停用词(介词、连词、标点等),不涉及自定义停用词表。
• 关键词匹配:基于词面严格匹配,统计关键词在文中出现的总次数,未做词形归一或同义词扩展。
• 统计范围:仅统计每份政府工作报告全文,不含附件、表格、领导讲话等附加材料。
三、计算方法概述
数据构建遵循以下流程:
1. 文本采集:从各地级市人民政府官方网站逐年下载年度政府工作报告全文(HTML 或 PDF),统一转为 UTF-8 纯文本。
2. 文本清洗:去除目录、页眉、页脚、附件链接等非正文内容;保留正文段落。
3. 分词处理:对正文文本运行中文分词器,得到词序列。
4. 停用词过滤:依据通用中文停用词表剔除介词、连词、代词等。
5. 关键词词频统计:对 10 个预设关键词做词面严格匹配,统计每个关键词在当年报告中的出现次数。
6. 面板拼合:以"省份—城市—年份"为唯一键,横向拼接 10 个分类词频与 1 个汇总指标,形成最终面板。
数据描述未披露具体分词器(如 jieba、HanLP、THULAC)的版本与所采用的停用词表详情,亦未提供可复现的代码(Stata/Python do-file)。
五、字段字典
六、部分数据截图
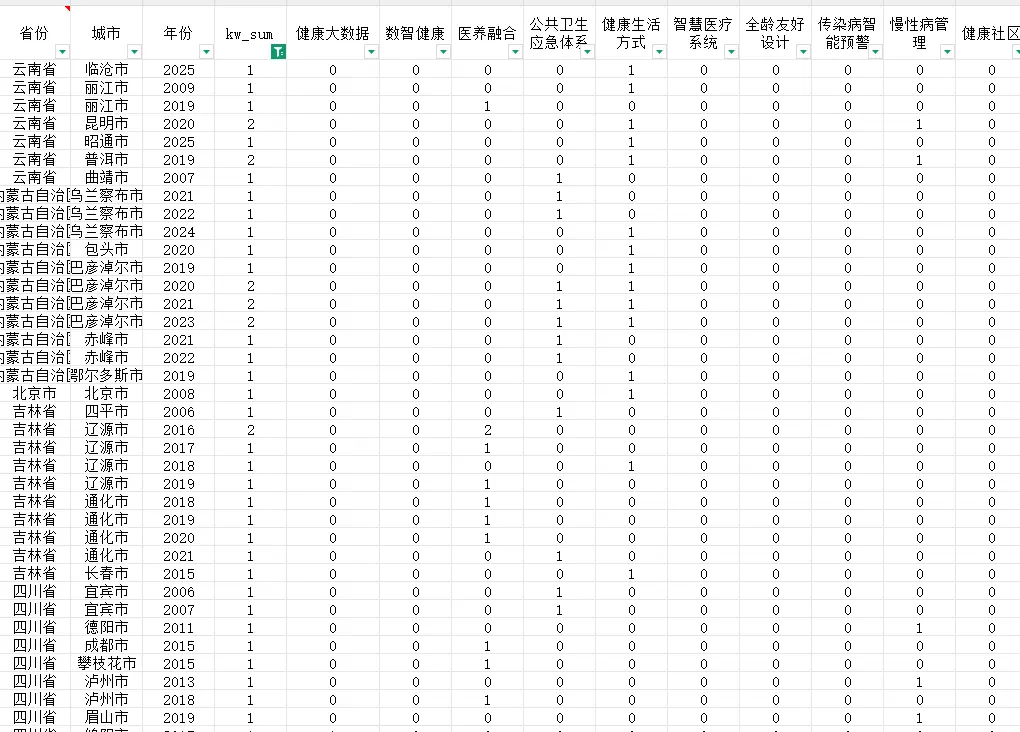
数据样本预览:部分地级市政府工作报告健康城市与公共卫生响应关键词词频(含 14 个字段,截取约 36 行)
八、参考文献
数据描述未提供引用文献。基于该数据所采用的标准文本分析流程,建议在研究使用中引用以下方法学参考:
1. 中国国家卫生健康委员会. 《健康中国行动(2019—2030 年)》. 2019.
2. 国务院. 《"健康中国 2030"规划纲要》. 2016.
3. World Health Organization. *Shanghai Declaration on Promoting Health in the 2030 Agenda for Sustainable Development*. 2016.
4. Salton G, McGill M J. *Introduction to Modern Information Retrieval*. McGraw-Hill, 1983.(词频统计与 TF-IDF 方法的经典文献)
5. 黄昌宁, 赵军. 中文自然语言处理研究进展. *中文信息学报*, 2007.(中文分词与停用词过滤方法学参考)
数据来源:各地级市政府官网公开发布的工作报告文本
顶部专栏分享更多内容
来源: Paper 数据分析


 扫一扫


 237

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


