


一、数组
1、二分查找
left,middle,right 三个索引,注意区间取值;左闭右闭,左闭右开 【循环不变量】。。。
2、移除元素
快慢(双)指针(slow和fast,两个不同的索引号),因为容器和数组访问均是采用下标识索引进行。
3、有序数组平方
采用双指针(快慢索引号),最大值非左即右,并注意返回值类型,创建新容器(数组)时候,记得赋予大小。
4、找到长度最小的子数组
采用滑动窗口方法(称双索引),确定窗口的起始位置和终点位置:初始位置不动,且只能前移不能逆,终点位置遍历,while循环满足条件,初始位置+1,sum和减去原其实位置值,在进行进入for循环
5、螺旋矩阵II
本质就是二维数组,顺时针螺旋排序,主要采用是循环不变量,也就是左闭右开(该原则受欢迎),遍历每一条边,确实循环圈数,以及起始点和终点,每一圈的偏移值,和剩余最后的中间数赋值。
数组总结:
对数组的操作,主要采用的就是数组的下标索引(双指针),结合循环不变量原则和二分查找,确定起始点和终点边界位置。
二、链表
1、移除链表元素
注意加入虚头节点和用头结点两种形式解答题目,要判断操作的那个节点是非空指针或下一个节点的指针域非空,记住设置一个临时节点cur用于遍历整个链表,以及将删除节点的该节点赋值给新设置单个临时节点tmp。
2、设计链表
增(头位置,尾位置,index位置),删(delete/nullptr),查(返回index对应的val),以上部分操作,链表的大小都要变化,要即时判断。采用虚节点形式操作链表,自己需要定义一个链表,并且初始化它。
3、翻转链表
采用双指针实现pre/cur(或递归在该基础上),在原链表上进行操作,(保存下一节点后放入临时指针temp)并改变链表指向,最后返回pre指针。
4、两两交换 链表中的节点(不是交换data)
主要还是采用虚节点(dummyhead)和遍历链表用(临时节点(cur)),按照1-2-3步骤,确定指针指向位置,是否需要保留节点指针和循环条件(边界、更新值等),最后返回虚节点的next指向的节点,释放new的虚节点。
5、删除链表中倒数第N个节点
采用双指针写法(快慢指针移动间隔(n+!)不一致,需要提前画图确定)。先让快指针把间隔移动完毕,然后两者在同时移动,且操控某一节点时候,需要将慢指针防止该节点前方,快指针用于判断边界
6、环形链表
主要采用双指针法(快(2)慢(1)指针),判断操作的快指针等是否为空,从而使两者出现相遇情况,从相遇点到入口点的距离(y)与从头结点到环形入口点(x)距离相等,故只需求出x即可,即出现两者相等情况。
链表总结:
面对链表操作时候,主要1、虚节点法、2、双指针法(考虑循环条件以及指针间隔等) 3、 两者结合,最后返回头结点。4、采用双向指针法等,以上方法都可以解决链表大部分操作。
三、哈希表
1、有效的字母异位词(由相同字母组成,位置可不一致)
考虑哈希法(优先采用数组)初始化0,数值大的采用set,遇到key和val,采用map;分别遍历每个字符串,使其出现的频率在哈希表(hash[s[i]-‘a’]++/--)下标对应元素做标记,判断初始化为0的哈希表是否最后还是0;
2、两个数组的交集
当元素大的时候可选择unordered_set集合,nums1中元素放进该集合中做为哈希表,nums2遍历自身容器找出find与哈希表存在一致元素,insert插入result容器(不包含重复元素),最后返回该容器。法二使用数组法,先将nums1放进整数类型hash表,标记变化频率,nums2遍历自身与hash表对比,再用insert插入result容器。
3、两数之和
主要确定为什么选择map,以及存放什么数值,key和value分别对应元素值(因为我们要在map中选找的元素只有通过key)和下标。利用find(s)与s=target-nums[i]判断是否相等,返回下标集合{,} (采用了列表初始化)
4、四数相加(四数之和却不能采用哈希法)
主要将A,B,C,D四个数组,划分成A+B/C+D形式,采用hash表。然后将A+B放入map[key]中,若有重复的,即map[key]++;反之C+D;在map找寻0-(C+D),判断是否找到,以及count+=val;最后将count返回即可。
5、赎金信
同第一题解法类似,我采用的是unordered_set集合方法,本题需要判断A数组的length是否大于B,return false;以及多了判断hash表小于0的情况,缺少了最后遍历hash表。用判断小于0代替了。
6、三数之和
本题(判断三数之和=0即可)与两数之和(需要返回下标索引)还是存在差别,故本题采用双指针法+遍历i,分别代表三个数正好是a+b+c=0;要对每个数都给考虑去重操作,三元组内可重复,外不可重复,放进二元数组
7、四数之和
其方法和三数之和一样,双指针,双层for循环,则代表A+B+C+D=target,则需要对循环的两个数A/B做剪枝去重操作,需要熟悉如何剪枝,然后分别对CD做去重操作,代码实现类似三数之和,以此类推增加for循环。
哈希表总结:
擅长解决:给你一个元素,判断其在集合中是否出现过。(数组(个数少、优先使用)、set集合(数值大)、map(key(索引值):value(下标)))容器等的用法以及底层实现,哈希表或红黑树,出现哈希碰撞如何处理。
四、字符串
1、反转字符串
同反转链表(有序数平方)操作类似,采用双指针,分别向中间靠拢,两者同步更新,故只需要判断其中一个区间范围(一个for循环),采用库函数swap,或直接用resverse(),两者均是直接在翻转原字符串(数组)。
2、反转字符串II
三种解法;首先对数据的处理,针对于区间段类型的问题,可以采用i+=(2*k)形式更新下标。第一种使用给自己实现的reverse(s,i,i+k);第二种用全局函数的reverse(s.begin(),s.end()),第三种用while循环类似第二种。
3、反转字符串中的单词
思路:在同一数组上操作,主要采用快(遍历旧组旧元素)慢(更新新组新下标)指针1、移除空格(法一:同数组中移除元素类似;法二:可采用分别移除字符的前中(选择性保留一个)后字符)2、实现对整个字符串的反转(可重写reverse函数)3、再对字符串内部连续字符的反转(s.size()和“ ”反转条件),
4、实现strStr()
5、重复的子字符串
KMP算法理论
1、作用:利用前缀表匹配文本串与模式串,2、概念:前缀(需包含首字符,但不包含尾字符的所有子串)和后缀(需包含尾字符,但不包含首字符的所有子串)3、理解最长相等前后缀含义,最后形成的数构成前缀表。4、用法:若在某位置出现不匹配字符,则向前找最长相等前后缀(可利用前缀表),从该位置接着向后匹配。
KMP算法实战(next数组(前缀表使用))
1、求next数组四个步骤——初始化(j:前缀末尾以及最长相等前后缀长度两种含义/i:后缀末尾)——前后缀不相等情况(while:j后退next[j-1])——前后缀相等情况(next[i]=j;j++)——更新next数组
字符串总结
五、栈和队列
1、栈(先进后出)和队列(先进先出)——SGI STL源码——底层实现(deque(双向队列)、vector等)——均成为容器适配器(不是容器)——不支持随机访问(不支持遍历)——push/pop
2、用栈实现队列
采用双栈,即stack_in/stack_out ,将in放入out;出队顺序与出栈顺序一致。用top获取栈顶元素,再用pop弹出,代表一次用栈的出队。Peek()实现用复用(禁止复制)技术。Empty()实现记得要返回两个栈empty()判断。
3、用队列实现栈
采用的是一个队列(两个不适合,并且处理思想也和第二题大相径庭)。出栈:采用循环将该队列中的栈顶元素前n-1个元素重新入队(push(front)+pop),查看top可直接对队列使用back即可,也可复用pop代码修改。
4、有效的括号
括号搭配是用栈的经典问题: 剪枝(个数为奇数return false)三种不匹配情况:左边多括号(造成栈区存留元素):类型不匹配(return false),右边多括号(字符串未遍历完,栈区空),相等,则栈区元素弹出(栈区为空)
5、删除字符串中的所有相邻重复项
删除相邻的相同元素:也是栈的经典问题:本题aabbac采用字符串(不需要将ac转成ca)代替栈的操作,更方便,先遍历,判断字符串empty?或s[i]==str.back()?,然后push_back()添加,相等直接pop_back(),最后return str
6、逆波兰表达式求值
遍历字符串数组,遇到数字放入栈,遇到+-*/,则从栈中弹出两个数字与运算符计算,并将计算值压栈,直到运算符用完,栈中只剩一个元素,将其返回。并pop释放内存,stack<int>/stack<long long >(题目要求),
Stoll的使用:是将字符串类型转换至longlong类型,强制类型转换适合同类型,如:int->flaot/float->double…
7、滑动窗口最大值
后期还得多理解:使用自定义单调队列(维护队列中单增操作),采用deque 双向队列操作实现pop/push/front.主要实现队列:pop用于判断传入val与队front是否相等,push:入队时判断前面元素是否比自己小(pop),大的话就放进去,伴随传入时候具有内部pop操作;最后返回队的front(最大值),主函数直接调用(理解性)。
8、前K个高频元素
1、先获取元素频率map 2、对频率排序小顶堆3、找出k个高频元素 priority_queue 默认是大顶堆(降序),return left>right 就是从大到小,return left<right 就是从小到大。且本题采用的是小顶堆,故需要使用仿函数重写(1、类中成员函数重写 2、普通函数重写)排序顺序(升序),堆中元素以键值对形式存放,利用小顶堆的特性,动态维护堆的大小不变(k);然后逆序遍历优先级队列,
栈的总结
vector类似数组,自动初始化为0;但不自动分配内存空间,访问就越界;是否需要初始化一个容器或变量,取决于它的默认状态和操作行为。栈和队列的使用适用多种情况,做题之前应该先分析是实现步骤,否则bug多
六、二叉树(递归+回溯:两者一一对应)
递/归:函数自身调用,且将终止条件的返回值返回给上一层用;递:传递参数,拆解问题(多个小问题)/归:计算问题,逐层回归;+回溯:++/递归/--,存在递归必存在回溯
1、二叉树理论基础
(1)种类:1、满二叉树(节点数量2k-1,k为树的深度(1,2….)),2、完全二叉树(h层节点数:1~2(h-1)):仅允许最底层(叶子)不满且从左往右排,中间无间隔 3、二叉搜索树:节点数值排序(中序):左<根<右,4、平衡二叉搜索树(AVL树):要求叶子和根的深度差<=1(map,set,multimap,multiset),B树:树的度(阶数N),则每个节点中最多有N个指针,N-1个数;B+树: 在B树基础上,叶子节点包含所有数,且形成双向链表
(2)存储方式:1、链式存储(左右指针) 2、线性存储(数组:从上上往下,从左到右,父坐标:i;左孩子:2i+1;右孩子:2i+2)
(3)二叉树遍历:1、深度优先搜索DFS(解决最大路径问题):递归(栈)操作或迭代法:实现(主要看根在那个位置)前序(中左(左子树)右(右子树)、中序(左中右)、后序(左右中);2、广度优先搜索BFS(最短、最小路径):层序遍历(迭代法:队列一层一层遍历)、相邻节点。(4)二叉树定义
2、二叉树的递归遍历
三部曲:1、确定递归函数的参数(*根节点和存放遍历节点的结果累积容器&vector)->返回值void 2、确定终止条件:深度优先搜索至空节点null结束 3、确定单层递归的逻辑(三序,中:用来将root->val存放至vec中)。
3、二叉树的迭代遍历(底层是栈)
关键点:访问(遍历)节点(栈记录遍历过的节点)、处理节点(出栈元素存放进数组):前序(中左右,由于栈先进后出,故将节点指针放入栈:采用:中右左)和后序(采用:中左右将节点放入栈中,并将数组反转,实现左右中遍历),中序不同;多一个指针用于访问节点,沿着左边至最底层再沿中右,直至指针为空或栈为空
4、二叉树的统一迭代法
10道二叉树遍历经典题:1、层序遍历经典模版;2、层次遍历II:只需将I的结果进行反转;3、右视图:只需将每层最后一个加入结果容器 4、层平均值:每层提取数值后进行相加出循环求平均 5、N二叉树层序遍历:将左右指针换成孩子指针数组 6、每个树行中找最大值:设置一个最大值为INT_MIN,并用三目运算符更新此值 7、填充每个节点(完美二叉树)的右侧节点:设置当前处理节点node和上一个节点nodepre;8、II(普通二叉树):可拿7答案直接解决;9求二叉树最大深度:按照1答案求数组长度(最大层数)或设置depth,每层+1,遍历到最远叶子结点循环结束;10,最小深度:根节点到最近叶子节点(左右无孩子)最短路径的数量。
5、翻转二叉树
本质上是将当前处理节点的左右孩子(节点)进行反转,多种方法:1、递归法:三大条件须记住(前序后序中序(特殊:左中左)),2、层序遍历:采用队列,将每层左右孩子进行对调,3、迭代法(前序遍历):采用栈存储节点,其余部分类似层序遍历总结:层序遍历(队列):先判断指针不为空,加入队列;迭代法(栈)(非递归):先判断指针为空,返回根节点,然后加入栈中。剩余部分两者带代码相似,可相互参考。
6、对称二叉树(相同的树:节点+结构相同)
递归法:实则就是判断左右二叉树是否相等。三大条件:首先判断二叉树是否可以反转的二叉树且反转后不变,从而产生终止条件;然后单层递归逻辑:先外侧在内侧(结构相同+左侧对比左侧,右侧对比右侧)。
7、求二叉树的最大深度(N叉树的最大深度)
二叉树的高度(指的是二叉树中任意一个节点到叶子的距离):用的是后序(实现二叉树从下往上遍历,将左右节点的信息返回给父节点)遍历;二叉树的深度(二叉树任意一个节点到根节点的距离/最短节点数量):用的是前序(实现从上往下遍历,将父节点的信息返回给左右节点)遍历。根节点的高度就是二叉树的最大深度
8、二叉树的最小深度(最小高度即最小深度)
与最大深度求解:区别在于处理左右孩子不为的逻辑,其实主要判断根节点的左右孩子为空情况;一:采用后序遍历:最小高度即最小深度;法二:迭代法:仅左右孩子同时出现为空情况,说明到达最低点(最低深度)。
9、完全二叉树的节点个数(普通二叉树求解)
法一:用普通二叉树的后序方法,求解二叉树节点数量的万能模版,递归思想同上;法二:利用完全二叉树包含多个满二叉树特点(利用左右深度相等寻找)+递归思想:法三:迭代法,利用每一层队列中的元素数量求解
10、平衡二叉树
特点:任何一个节点的 |左右子树的高度差| <=1;采用递归法(后序):求二叉树的高度,若子树不满足平衡二叉树的要求则直接向父节点返回-1;以及|左右树的高度差|>1,记录本节点的高度为-1;否则返回节点实际高度;
11、二叉树的所有路径
要求根据节点到叶子节点,故采用前序遍历;从找到对应路径,递归和回溯一一对应(1、void返回值+多参数(处理节点,存放路径的path,收集结果的result(to_string类型转换(地址拷贝和复制拷贝)))/2、终止条件+收集结果+return+3、前序遍历),处理单程递归回溯逻辑实则是对中节点主要处理,左右节点负责递归遍历。
总结:非递归法(迭代法):前中后序用栈,层序遍历:用队列/也可以用栈
12、左叶子之和
父的左孩子+叶子节点(无左右孩子):递归/迭代法:当前遍历的节点是父节点,才能判断其子节点是不是左叶子,采用后序:将子节点的信息返回给父节点。左(判断是否是左叶子节点并获取值)右中(处理节点逻辑):
13、找树左下角的值
要求最后一层找最左边的值,考虑层序遍法(队/栈)解决;up主以递归讲解:递归+回溯:本题不涉及中操作,故前中后序都行,终止条件(找叶子节点)+收集结果(更新最大深度和其数值),每一次递归则包含一次回溯。
14、路径之和
找出根节点到叶子节点的路径和等于targetSum,遇到这类题目可以选择你想求解,即:计算目标值与遍历过得节点的差值(递减)直至叶子节点是否等于0,采用递归+回溯;并判断递归函数是否需要返回值
15、路径之和II
本题主要遇上一题做比较,要遍历整个树,找到所有路径,所以递归函数不要返回值!,递归+回溯:需要两个容器,一个存放遍历过符合要求的路径的path,和存放路径对应数值的二维数组result(满足要求的所有路径)
16、从中序与后序遍历序列构造二叉树(或前序与中序)
须知:中序数组大小一定和后序数组大小一致;1.后序数组为0,return NULL, 2.后序数组最后一个元素为中节点元素,3、根据后序寻找中序数组位置做切割点,4.切中序数组(循环不变量:左闭右开),5.切后续数组(同上),6、递归处理左区间和后区间:前序+中序,传入两个begin和两个end以及各自数组,然后切割+递归。
17、最大二叉树
构造二叉树:考虑前序:终止条件是到叶子节点,寻找数组最大值并创建该节点,以及下标,并将数组划分为左区间和右区间。根据终止条件判断递归何时需要加入if(是否操作空节点进入递归),采用索引节点内存和时间。
18、合并二叉树
构造二叉树首先前序(本题其他也可),对两个树进行操作(同对称树题),同时同方向遍历,递归:遇到空节点返回对方或NULL,并合并相应的值,法二:迭代法:用双队列,对其一结构改造,法三:二级指针对数直接操作
19、二叉搜索中的搜索(有序性)
利用二叉搜索树的特性:左<根<右;即遍历二叉树不必遍历整个树,对于普通二叉树可能涉及回溯,法一递归:j将最终递归的返回值返回,法二迭代:正常迭代法,深度遍历:栈;广度遍历:队列,本题利用有序性即可。
20、验证二叉搜索树(找出有序性)
中序遍历二叉树:即节点是有序序列,故判断该序列是否递增即可:四种方法:法一:采用递归并将其遍历成数组,对其验证是否是递增序列;法二:递归:设置一个全局最小量(LONG_MIN小于INT_MIN),故可以利用不断更新最小量来判断二叉搜索树;法三:递归加双指针法:将最小量换成当前节点的前一节点,随着遍历更新prenode并比较两者大小,法四:迭代法(中序遍历):利用栈加prenode对其进行判断。
21、二叉搜索树的最小绝对差(二叉搜索树节点最小距离)
利用该树有序的性质:递归加双指针:较容易实现现节点-前一节点值,然后同上题类似,找最小值故设置一个最大值,不断更新该值,法二:转换成数组求最小值,法三:采用迭代法(栈),整题同上一题部分操作类似。
22、二叉搜索树中的众数
法一:遇到普通二叉树:采用递归前序遍历将其和频率存储在map容器中,然后对其转换成vector容器存储进行降序,并找出是否存在多个。法二:利用二叉搜索树的特性:采用中序递归遍历+双指针,更新val频率并记录最大频率放进结果集数组,更新最大频率和清空原结果集数组并更新;法三:迭代法:栈+中的操作逻辑同上
23、二叉树的最近公共祖先
普通二叉树找公共祖先,涉及回溯过程,实现该过程则需要从下往上遍历,故采用后序遍历,中的处理逻辑:找到最近公共祖先则通过回溯返回该节点,否则返回NULL,包含两种情况(p和q其一是祖先或都是孩子)
24、二叉搜索树的最近公共祖先
BST的特性:有序,从上往下:利用节点值判断大小,左<根<右:然后选择性搜索边,找到即返回;法二:采用普通二叉树方法 法三:迭代法,根据比较节点值大小,选择左或右边。总结:在递归函数有返回值的情况下:若要搜索一条边,递归函数返回值不为空的时候,立刻返回,如果搜索整个树,直接用一个变量left、right接住返回值,这个left、right后序还有逻辑处理的需要,也就是后序遍历中处理中间节点的逻辑(也是回溯)
25、二叉搜索树中的插入操作
法一:有返回值的递归函数:直接在叶子节点处插入,创建该节点返回给上一层接收;根据BST特性:判断节点大小,选择合适的叶子进行插入,法二:无返回值递归函数,需要一个父节点parent指向上一个节点,遇到空节点,插入父节点的孩子正确的叶子位置;更新parent节点;单边遍历;法三:迭代法;同法二逻辑一致;
26、删除二叉搜索树中的节点
终止条件有五种情况(夹杂着删除节点的步骤):1、没找到删除节点,return NULL;2、为叶子节点,左右为空:则delete root 释放内存操作并return NULL;3、节点左不空右空:故先保存一下该节点用做return left,再将其释放内存,4、节点左空右不空:则操作方式同 3 return right;5、左不空右不空:逻辑较为复杂:先将其转换为左/右为空状态,将孩子给附近最大/小的孩子接收,然后在删除节点同3/4步骤;最后单程遍历单边BST;
法二:对普通二叉树进行删除操作;法三:迭代法: 需要一个pre记录cur的父节点,方便做删除操作
27、修剪二叉搜索树
判断终止条件:包含了修剪过程,先对该节点判断范围,小于low,遍历右子树,找出比其大的数,返回删除节点的右孩子,让上一层的左孩子接收,大于high,遍历左子树;找出树内在区间中的数,返回左节点,让上一层右孩子接收。最后return root :法二:迭代法:让root位于low和high区间内,并分别剪枝左子树和右子树
28、将有序数组转换为平衡二叉搜索树
构造二叉树的时候尽量不要重新定义左右区间数组,而是用下标来操作原数组,故定义左右区间变量,根据中间节点对有序数组划分左右区间,采用左闭右闭法则;递归下去,可构造平衡二叉搜索树,法二:迭代法;三个队列来模拟,一个队列放遍历的节点,一个队列放左区间下标,一个队列放右区间下标。
29、把二叉搜索树转换为累加树(从二叉搜索树到更大的树:迭代法(两者都可以使用))
需要pre指针(或int变量)记录当前遍历节点cur的前一个节点,做累加操作,累加后值是降序,中序是升序排列,故遍历将中序翻一下即:右中左:中逻辑:对cur->val+=pre;更新该值,最后赋值pre,返回root节点
二叉树总结
完全二叉树一定是平衡二叉树,堆的排序是父节点大于子节点,而搜索树是父节点大于左孩子,小于右孩子,所以堆不是平衡二叉搜索树
七、回溯算法(for循环横向遍历,递归纵向遍历,回溯不断调整结果集,结果均在叶子结点)
1、组合问题 (递归+回溯控制for循环数量)、剪枝优化:i<=n-(k-path.size())+1
求N的数字求K个大小的组合问题,典型的回溯算法,设置两个数组,一个存放结果(二维),一个存放路径(即组合),采用回溯三部曲1、参数和返回值2、终止条件(存放结果)3、利用for循环处理节点+递归+回溯
2、组合总和III (找到树的深度和宽度由什么控制)
递归三部曲:1、返回值和参数;2、剪枝优化(此题超过目标和)+终止条件(收集结果并达到终止退出)3、单步递归逻辑(for循环遍历+优化i初始值)+回溯 ,此题同上题类似,记得先分清情况,在考虑代码如何编写
3、电话号码的字母组合(叶子节点收获结果)
首先,将数字与字符串映射,存储在vector<string >二维数组,然后创建获取的字符串数组s与存储结果数组;递归三部曲,传入字符串索引,终止条件题目给数组大小与索引大小一致,单层递归逻辑,使用回溯进行返回
4、组合总和(求和问题,排序之后+剪枝:常见)
该题组合没有数量要求,且元素可重复选取;故确定何时用startindex,何时不用,以及该值如何更新,采用递归三部曲:该题剪枝优化求和问题需要将其先排序在剪枝操作:总和大于target的值不用搜索(抛弃)
5、组合总和II(注意区别:树层去重/树枝去重)
主要考虑何时去重,先对数组进行排序,进行树层去重,引入bool类型used记录取值情况,相同值直接跳过,递归+回溯,used标注记得回溯;区别树枝与树层去重区别:树层:used[i-1] =false; 树枝去重:used[i-1] =true
6、分割回文串(切割问题类似组合问题思路)
回文串定义:左右两边相同,且中间是回文串,设置回文串判定函数;采用递归三部曲,且收集结果均在叶子结点,注意切割线的起始位置,以及切割字符串的区间[startindex , i]左闭右闭,确定回文串后将其放入path数组
7、复原IP地址(切割问题抽象成树形结构)
注意ip地址的要求规范,会写有效函数,以及在何时增加断点 . 并根据断点数量找到终止条件(判断最后一段是否合法),用起分割字符串为4份;单程递归中判断截取[startIndex, i]字符串是否合法,配合回溯算法i+2;
8、子集问题(收集所有节点的结果)
该题注意结果收集比较不同(收集树形结构的所有节点的结果),不同于组合、分割问题(其收集树形结构中叶子结点的结果),递归+回溯同时运行,最后该题可以不需要终止条件,使用for循环中条件即可。
9、子集II(去重参考组合总和II,代码同子集题)
该题利用子集问题的收集结果方法+组合总和II的树层去重,使用bool类型used容器标注nums数组取值情况,设置去重操作:位置i,该位置值与前值相等以及used数组标注为false;树层不可取重复数,树枝可以取
10、递增子序列
设置一个去重的set数组,仅用于记录本层里面取过的元素,进入下一次递归,则重新创建该数组,因此与去重操作used数组(使用记得排序)不同,注意使用区别,数组,set,map都可以做哈希表,当范围小可用数组
11、全排列(树枝去重)
在树枝上面Used数组作用代表该值已取过,应该跳过,取为false的数值,以及该题的for循环起始i从0开始,而非startindex,注意排列与组合取值的区别,以及何时用used数组/用set数组;并采用树枝/树层去重
12、全排列II
分析题目何种去重/树层去重:i>0&&nums[i]==nums[i-1]&&used[i-1]==false,树枝去重:if (used[i] == true) 表示该值已取continue;used[i]=true;该题采用树层去重操作,故需要先对数组进行排序,并使用used数组标记;
13、重新安排行程
14、N皇后(二组数组的组合问题)
将棋盘看成nxn的二维数组,并且对其用回溯算法,棋盘宽度是for循环的长度,递归的深度是棋盘的高度,row控制棋盘的行,结果在叶子结点并判断是否合法(检查列、45度(左上),135度(右上))对其收集。
15、解数独(二维数组递归问题)
该题进需要一个数组,找到即立刻返回(bool);搜索整条路径用返回值void,单条路径情况出现用bool;采用两层for循环遍历棋盘行列,并判断合法性对其用递归+回溯进行填充;注意合法性(行、列、九宫格不重复)
回溯总结
组合问题和排列问题是在树形结构的叶子节点上收集结果,而子集问题就是取树上所有节点的结果。对于排列问题,树层上去重和树枝上去重,都是可以的,但是树层上去重效率更高;组合问题和排列问题,其实也可以使用set来对同一节点下本层去重,优先使用used去重。组合问题:N个数里面按一定规则找出k个数的集合、排列问题:N个数按一定规则全排列,有几种排列方式、切割问题:一个字符串按一定规则有几种切割方式、子集问题:一个N个数的集合里有多少符合条件的子集、棋盘问题:N皇后,解数独等等
八、贪心算法(找局部最优—>全局最优)
1、分发饼干
法一:可从大饼干开始分配给胃口大孩子,遍历孩子,确定饼干是否满足该孩子胃口,不满足则更换孩子,满足之后饼干减减操作;法二:但从小孩子开始分发小饼干,方法同法一,不能遍历饼干,否则找不到局部最优
2、最长摆动序列
摆动序列指的某点值前后出现正负值变化,从而造成摆动情况出现,解决三种情况:1、上下坡存在平坡;2、首尾元素(右边元素自动算一个)3、单调坡中存在平坡;可类似双指针的方法或动态规划求解(看不懂)
3、最大子序和
贪心算法:局部最优:当前“连续和”为负数的时候立刻放弃,从下一个元素重新计算“连续和”,负数加下一个元素 “连续和”只会变小。全局最优:选取最大“连续和”;暴力接法:双层for循环起始位置+计算连续和(超时)
4、买卖股票的最佳时机II(动态规划+贪心)
本题属于动态规划内容,可采用贪心,收集正利润的区间,就是股票买卖的区间,而我们只需要关注最终利润,不需要记录区间,获取到每天最大的利润从而达到收益最大化;重点在于将N天利润分成一天相加;
5、跳跃游戏
局部最优解:每次取最大跳跃步数(取最大覆盖范围),整体最优解:最后得到整体最大覆盖范围,看是否能到终点。故不能陷入跳几步的策略,而应该采用局部覆盖范围最大,是否能覆盖最后一个数,从而达到全局最优
6、跳跃游戏II(重点)
局部最优:当前可移动距离尽可能多走,如果还没到终点,步数再加一。整体最优:一步尽可能多走,从而达到最少步数,cur记录当前可走最大步,next记录覆盖范围中最大步,更新两者;优化:移动下标i末尾-2位置
7、K次取反后最大化的数组和
贪心:局部最优:让绝对值大的负数变为正数,当前数值达到最大,整体最优:整个数组和达到最大。第一步对其进行绝对值排序,第二找出负数变正K--,第三步利用剩余K值奇数对数组最后元素x-1,最后加和数组。
8、加油站
法一:暴力解法:针对于线性的(起始、终点)采用for循环;环形采用while循环更好;法二:贪心算法:局部最优:则出现当前区间和小于0,则起始位置i+1;出现总和小于0,则说明不满足;推出全局最优情况
9、分发糖果(两次贪心(两个维度问题))
当出现需要比较当前元素两边与自己的大小,必须采用先确定一边,再比较另一边,不可同时比较;一次从前往后,只比较右边孩子评分(i)比左边大(i-1)。一次从后往前,只比较左边孩子评分(i)比右边大(i+1),
10、柠檬水找零
贪心则表现找零钱时候,先给予大额,保留个更多小额;首先该题可分析出找额情况,通过找额情况,可写出代码,遇到这种可列举出来的问题,应当手动模拟出来,再去寻找当中逻辑书写代码
11、根据身高重建队列(两个维度)
两个维度,h和k,看到这种题目一定要想如何确定一个维度,然后再按照另一个维度重新排列,插入操作局部最优:优先按身高高的people的k来插入。插入操作过后的people满足队列属性;链表list速度>数组vector
12、用最小数量的箭引爆气球(左右边界)
局部最优:找到重叠区间用最少的箭来射气球;首先对其按照数组的左边界进行排序,当第i个左边界大于i-1右边界,结果++;其次从右边界进行判断重叠区间,选取最小右边界更新
13、无重叠区间(左右边界)
两题思路接近:采用按左边界(直观)排序思路;共同点:都是找重叠区间,区别:本题端点值相同不能重叠,intervals[i][1]更新第i个位置的右边界,不是[i-1][1]原因是因为,其i值可能出现比有边界值低的问题
14、划分字母最远区间(分割字符串)
三步策略:第一先遍历数组将每个字母对应的最远索引不断更新,放进数组中存储;其次找区间需设置左右变量,更新索引点对应右变量的最大值即区间最大点,结果存放数组,再将左区间移到该点后(+1)
15、合并区间
与第12、13题思路近似,首先遇到重叠问题,对数组进行按照左边界排序,该题先将第一个元素放进result数组,然后判断重叠区间与result的右边界的大小情况,可直接用result更新其右边界最大值,无重叠直接放入
16、单调递增的数字
字符串转换;采用从后往前遍历,设置标志位flag,且初始化为数组尺寸,出现strNum[i - 1] > strNum[i]情况(非单调递增),首先让strNum[i - 1]--,strNum[i]赋值为标志位(更新),最后仅从标志为开始更新为最大值9;
17、监控二叉树(难点)
二叉树的遍历+如何隔两个节点放一个摄像头且放在叶子上面的最近父节点;采用后序遍历(左右中),终止条件:空节点为有覆盖情况;节点有三种状态:0:该节点无覆盖1:本节点有摄像头2:本节点有覆盖;放摄像头有四种方法;1、左或右无覆盖return 1且+1。2、左或右有覆盖return 2;3、左右都有覆盖return 0;局部最优:让叶子节点的父节点安摄像头,所用摄像头最少。
贪心算法总结
首先出现两个维度问题的时候,我们应该先去欸的那个一个维度,再去确定另外一个,不能同时;股票系列问题是动规的专长,其实用贪心也可;针对区间问题也是如此;找出区间局部最优推出全局最优;思路很重要
九、动态规划(动规基础、背包问题、打家劫舍、股票问题、子序列问题)(动规是由前一个状态推导出来的)
动规五部曲:1、dp数组和下标含义;2、递推公式;3、dp数组如何初始化;4、遍历顺序(后面元素依靠前面元素推导(从前向后),反之从后向前);5、打印dp数组(debug)
1、斐波那契数
动规五部曲策略(重点),1、确定dp[i]和下标含义;2、确定递推公式;3、对dp[]数组进行初始化;4、遍历循序;5、打印dp[]数组,确定逻辑是否一致(debug);本题题目条件均已告知,故是简单题;//三个变量+递归
2、爬楼梯(同斐波那契数列)
本题采用动规五部曲;1、dp[i]数组指的是:爬到第i层楼梯,有dp[i]种方法;2、初始化是从1和2开始而不是从0;无意义,其余部分同斐波那契数列一致,但是题目需要自己推导条件;扩展:一次1\2\3\...m阶,有多少方法
3、使用最小花费爬楼梯
五部曲:1、明确dp[i]数组:指的是爬到第i层,最小花费多少体力;2、初始化:允许从0/1台阶开始,故不需要体力;3、遍历顺序:从前往后(当前值受前两个值影响)4、递推公式:从爬一层/爬两层花费/体力中取最小
4、不同路径(二维dp数组、深搜,动规,数论)
首先五部曲:1、dp[i][j]指的是走到i、j点共有多少路径,2、递推公式:是由该点上方点以及左边点推导过来;故dp[i][j]=dp[i][j-1]+dp[i-1][j];3、初始化;行列均只有一次路径,故为1;4、遍历顺序是:从左往右,从上往下
5、不同路径II
本题与上一题相似,但多出障碍,应该在上述五部曲答案中的初始化和递推公式的使用中加入对障碍的判断,以及障碍位于的起点和终点都应该返回0;表示不能到达;其余的代码部分则和上题相似
6、整数拆分
1、dp[i]:分拆数字i,可以得到的最大乘积为dp[i];2、递归公式:dp[i] = max(dp[i], max((i - j) * j, dp[i - j] * j));表示从拆成两个数/三个数以上乘积找到最大值;并且与当前比较;3、初始化0/1拆开无意义故=0;4、遍历j
7、不同的二叉搜索树(重叠子问题)
二叉搜索树:根节点比右节点小,比左节点大(中序遍历)1、dp[i]指的是1-i个元素的二叉搜索树的数量。2、递推公式:dp[i] += dp[j-1]*dp[i-j];第j个头节点;3、初始化空节点为dp[0]=1;4、遍历顺序由前一个节点影响,
8、0-1背包理论基础(一、基础重点:装入背包里物品价值总和最大)
理论:0-1背包:有n种物品,且每个物品只有一个(背包问题的基础且重点);完全背包:有n种物品,每种物品有无限个;多重背包;有n种物品,每种物品的个数各不相同;
暴力解法:每个物品只有两种(取/不取)状态,故可以采用回溯算法进行暴力搜索吗,枚举每个所有情况;
二维数组解法是此类型基础,1、dp[i][j]:所得到的最大价值:i指的是0-i之间的物品放进容量为j的背包中;第i件物品的重量是weight[i],得到的价值是value[i] ;2、递归公式: dp[i][j] = max(dp[i - 1][j], dp[i - 1][j - weight[i]] + value[i]);3、初始化:一定要和dp数组的定义吻合;4、遍历顺序(for物品/for背包顺序都可以)
9、0-1背包理论基础(二)
针对于上题,本题采用一维数组(滚动数组);将二维数组压缩至一维,这里一维指的是将上一层dp[i-1]的值拷贝到dp[i]中;故递推公式:dp[j]=max(dp[j],dp[j-weight[i]]+value[i]);3、初始化:对其可全部初始化为非负最小值;4、遍历顺序采用倒序遍历,正序会将前一个的物品价值重复使用,且遵循先遍历for物品再遍历for背包;
10、分割等和子集(重量=价值:dp能不能装满背包)
首先本题可抽象称01背包问题,其次在本题中重量与价值是相等的存在,动规五部曲:1、dp[j]表示背包容量为j所装的最大价值dp[j];2、递推公式:可由01抽象过来3、初始化为0;4、遍历顺序:先物品在背包(倒序)
11、最后一块石头的重量II(dp尽量装满背包)
关键:将一堆石头分成两堆相近的,则两者碰撞剩余的即是最小的;其余部分本题与上题几乎相等,在返回条件时候,本题是直接返回两堆相近石头的差值;本题的情况也是可以将重量与价值相等进行求解
12、目标和(dp装满背包有多少种方法)
三种方法:1、组合总和问题(回溯法)2、二维数组 dp[i][j]:使用下标为[0, i]的nums[i]能够凑满j(包括j)这么大容量的包,有dp[i][j]种方法;递推公式:dp[i][j] = dp[i - 1][j] + dp[i - 1][j - nums[i]];3、滚动数组;本题采用滚动数组求解:、dp[j]:指的是装满容量j的背包共有dp[j]种方法、递推公式:dp[j] = dp[j] + dp[j - nums[i]] ,即:dp[j] += dp[j - nums[i]]、初始化:dp[0]=1,即对容量0的背包不放、遍历顺序:物品正序,背包倒序;
13、一和零(装满背包最多有多少个物品)
非多重背包;是m和n的二维0/1背包问题;1、dp[i][j]:最多有i个0和j个1的strs的最大子集的大小为dp[i][j];2、递推公式:dp[i][j] = max(dp[i][j],dp[i-x][j-y]+1);3、初始化最小值0;4、先物品在背包(倒序)、
14、完全背包理论基础
完全背包和01背包问题唯一不同的地方就是,每种物品有无限件,dp[i][j]:表示从下标为[0-i]的物品,每个物品可取无限次放进容量为j的背包中,价值总和最大为dp[i][j];递推公式不变,初始化列:即dp[i][0],无论是选取哪些物品,背包价值总和一定为0;初始化行:j < weight[0]的时候,dp[0][j] 应该是 0;大于;说明dp[0][j] 如果能放下weight[0]的话,就一直装,每一种物品有无限个;遍历顺序(可颠倒顺序);先物品后背包(正序)
15、零钱兑换II
首先本题沿着目标和的思路进行求解,组合不强调元素之间的顺序,排列强调元素之间的顺序;注意:采用一维数组dp[j]+=dp[j-nums[i]];遍历顺序:先物品在背包是:组合数;颠倒则产生的是排列数;对于初始化背包容量为0的dp[0]=1问题;
16、组合总和IV
完全背包问题:求的是排列数,可以元素相同顺序不同的组合算两个组合,其实就是求排列!;“组合”与“排列”的核心区别就在于遍历顺,dp数组,递推公式,初始化都几乎一致;如果求组合数就是外层for循环遍历物品,内层for遍历背包;如果求排列数就是外层for遍历背包,内层for循环遍历物品
17、爬楼梯(进阶版)
同上个题目一致;且同属于完全背包问题;dp[i]:爬到有i个台阶的楼顶,有dp[i]种方法;递推公式:dp[i]+=dp[i-j],由于求的是排列数,所以遍历顺序是先容量后物品
18、零钱兑换
题目中说每种硬币的数量是无限的,可以看出是典型的完全背包问题;故设置dp[j]:代表凑足容量为j,最少个数为dp[j];递推公式dp[j]=min(dp[j-coins[i]]+1;dp[j]),取最小值,dp[j-coins[i]]表示放入coins[i],且方法+1;初始化:dp[0]=0;其余全部初始为最大值,因为要取最小值,遍历顺序都可以,无要求
19、完全平方数
题目翻译一下:完全平方数就是物品(可以无限件使用),凑个正整数n就是背包,问凑满这个背包最少有多少物品;递推公式:dp[j] = min(dp[j - i * i] + 1, dp[j]);i*i表示完全平方数;所以非0下标的dp[j]一定要初始为最大值,这样dp[j]在递推的时候才不会被初始值覆盖
20、单词拆分
回溯法:本道是枚举分割所有字符串,判断是否在字典里出现过;换成背包问题;dp[i]:表示字符串长度为i的化,dp[i]为true,表示可以拆分一个或多个字典中出现的的单词;递推公式是 if([j, i] 这个区间的子串出现在字典里 && dp[j]是true) 那么 dp[i] = true;初始化dp[0]=true,其余为false;遍历顺序求排列数故先背包在物品
21、打家劫舍
定义dp[i]数组;表示从下标i开始,窃取到最大金额为dp[i];递推公式:dp[i]=max(dp[i-1],dp[i-2]+nums[i]):分别指不放第i个以及放第i个物品情况;初始化dp[0]=nums[0],dp[1]为数组0/1下标最大数,遍历顺序:从小往大
287:寻找重复数
采用找环形链表,若出现环形链表则返回慢指针对应的数值;把数组转化为链表结构,利用 Floyd 判圈算法 找环入口。相遇点不一定是答案,环入口才是重复的数。
Unordered_set ;常用
快速去重:如统计数组中不同元素个数。
快速查找:判断某个数是否出现过。
实现集合运算(交集、并集、差集)。
常用于 哈希判重、存在性判断。
234 ;回文链表与回文字符串类似;但是要求O(1)空间复杂度;故不能将其放入数组类似字符串判断
答:1、先找到链表的中心,利用快慢指针,当快指针为空或下一个节点为空时,退出while循环,则slow对应链表前半部分的最后一个节点;2、再利用反转链表的思维:设置pre,cur,tmp三个指针进行将第二部分链表(slow->next)后链表进行反转;3、在判断链表前后部分的数值是否相等,移动两个新链表的头节点
74 搜索二维矩阵
一维数组到二位矩阵等的映射关系 : 一维index0~n-1;二维:row=i/n;col=i%n;建立映射关系;再采用一维数组的二分查找方式(时间复杂度O(logn)),即可提升时间效率;
5 最长回文子串:需要结果拆分成两种方式考虑,bab奇数,baab偶数:分别从中间位置往外扩展,判断左右字符是否相等(双指针法);可以根据s.substr();字符串的起始位置以及长度获取 指定字符串(最长回文子串)
75、颜色分类
正常思路直接采用sort排序后返回结果即可,或者采用新的数组记录0,1,2出现的次数然后重新输出结果;上述时间复杂度不符合要求,本次采用i,left,right三个指针的思路解决:如下图所示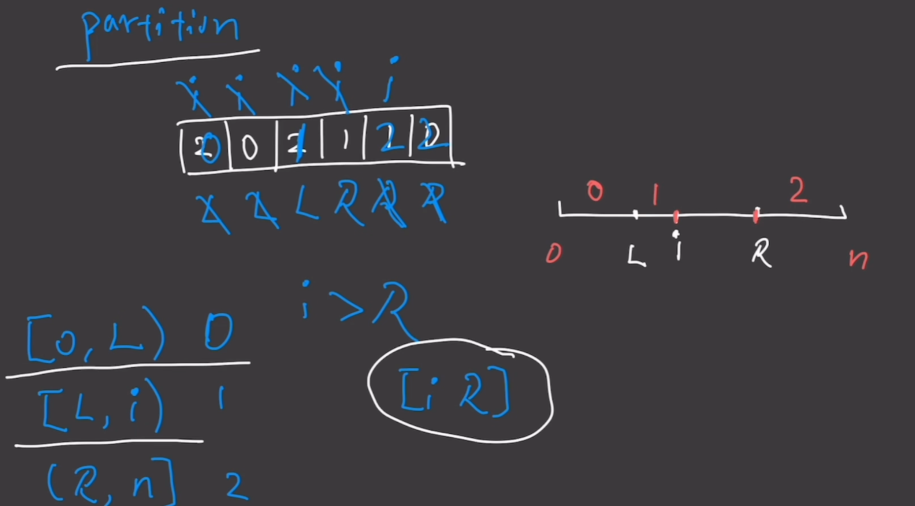
230 、 二叉搜索树中第 K个小的元素
采用迭代 中序遍历方式;先将其入栈,当遇到左孩子节点为空,弹出栈顶元素,并将其右孩子放入栈中,当右孩子的左孩子为空弹出栈顶元素,右孩子的右孩子为空则访问上一级的根节点,循环采用while
42 、 单调栈(场景:找当前元素的左右比它大或比他小的元素)
采用递增单调栈,因为要找比当前元素大的数值;故设计其,栈中存放数组中的元素的下标;先判断当前元素h[i]与栈顶元素h[st.top()]的三种情况(小于,等于,大于),在大于得时候收获结果,将小于弹出,将其压入栈
后序遍历特点:收集孩子信息,并向上返回给根节点;
二分查找特点: 时间复杂度 O(logn);定义 left,right ,mid,找出判断条件
4、寻找两个数组中位数
第一步:找两个数组各自的分割点 i/j;总数是奇数情况下,两者分割点的左侧元素个数之后比右边多1,否则相等;则左侧对应的最大值即中位数;查找i/j:nums1[i-1]<=nums2[j];nums2[j-1]<=nums1[i]; 两种情况
437 路径总和 III:步骤:1、枚举所有路径的起点(采用BFS,用队列存储);2、计算以某一个节点为起点的满足条件路径个数(DFS);DFS函数没有回溯,是因为没有修改需要撤销的共享状态;cur_Sum 是按值传递的局部量,自然不需要回退。需要回溯的典型场景是“引用/全局可变状态、路径容器、visited 标记、前缀表”等
对一棵树进行中序遍历(左中右);得到的是升序序列,则该树是二叉搜索树;转换成二叉搜索树:1、尽可能保证每个节点都有左右子树;2、尽可能保证左右子树的节点数相等
动态规划问题:1、递归出现,2、出现重叠子问题:3、找状态转移方程
- 带备忘录的递归;2、自下而上的迭代
回溯问题:递归:将原始问题分解成独立的子问题,递归过程涉及到状态的选择与撤销;则称为回溯


 扫一扫


 184

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


