


敏捷迭代中需求频繁变更的震荡预警:量化 PRD 变更率对研发交付节奏的破坏
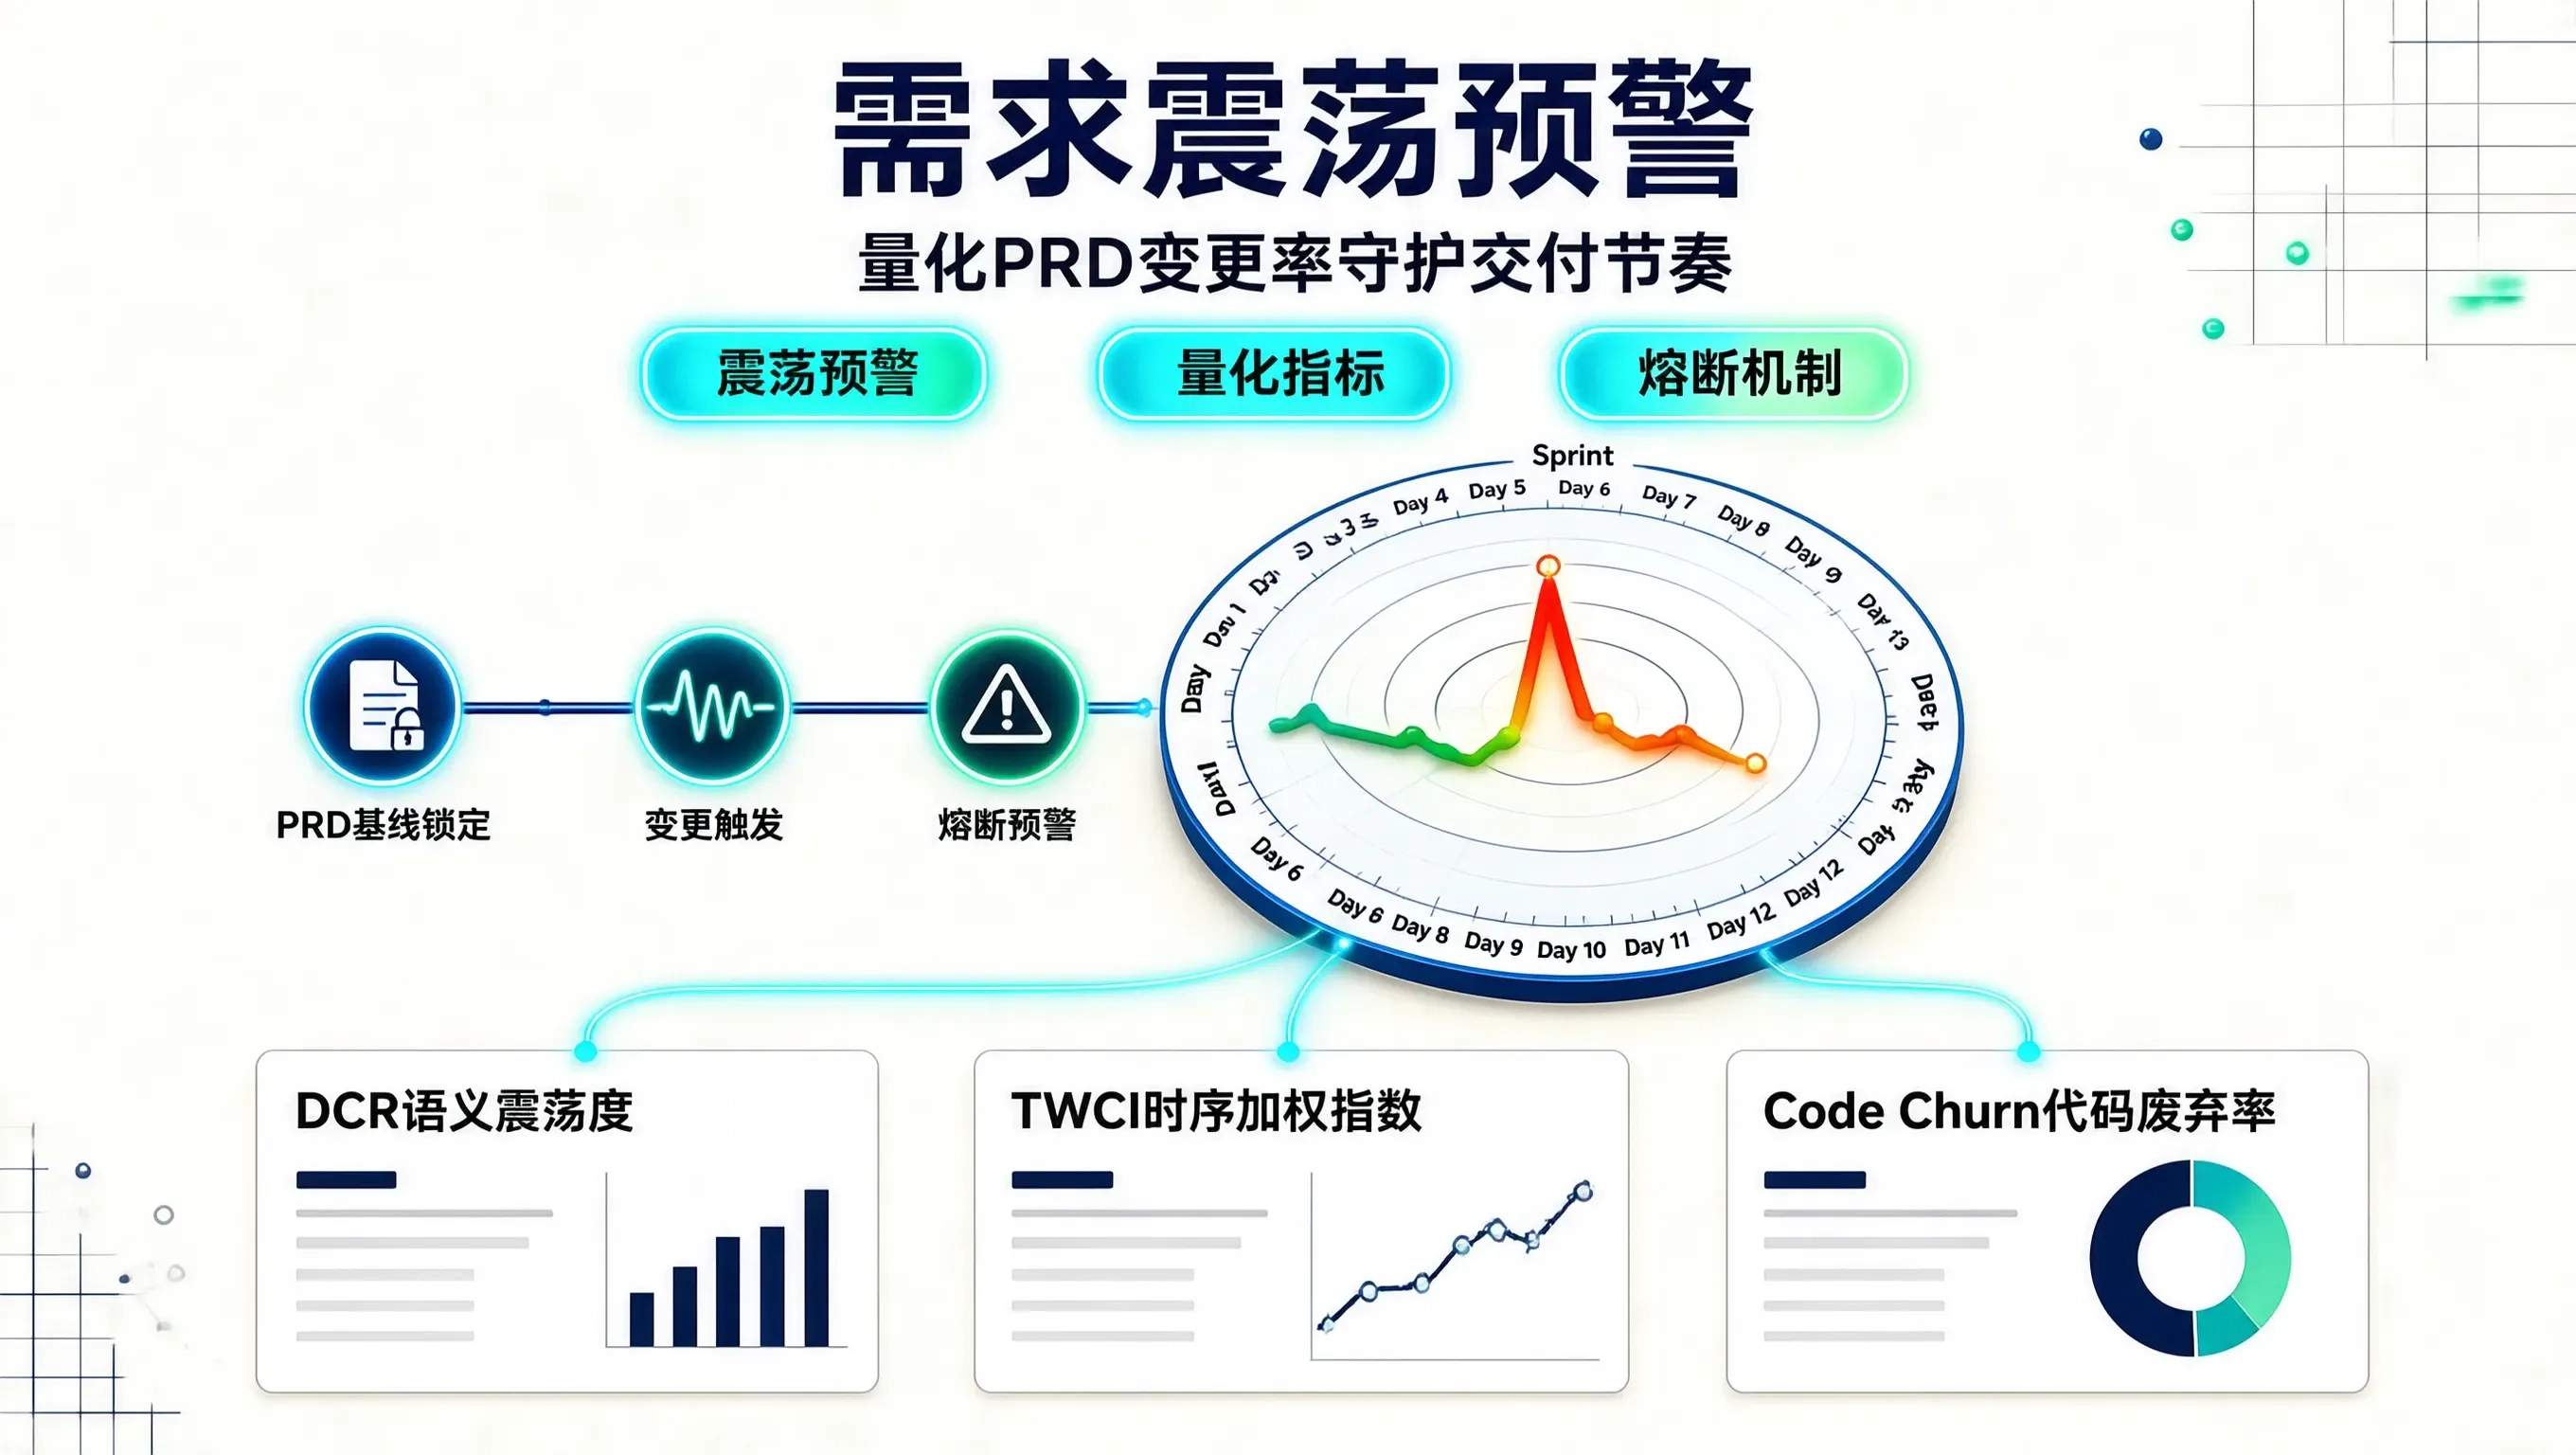
在很多互联网与创业团队中,“敏捷开发、拥抱变化”往往成了产品经理随意、高频修改需求的免死金牌。在 Sprint 迭代进行到第 6 天,PM 突然在飞书文档里改动了 3 个关键字段,并在群里轻描淡写地发一句“这里交互微调了一下,大家按最新版做”。
研发团队看似默默改了代码,但交付质量却迅速崩溃:原本测好的单元测试大面积报错、数据库表结构产生冗余补丁、联调时间翻倍,最终导致发版延期。更严重的是,团队内部会产生极大的挫败感与信任危机。
敏捷不等于无序。需求变更必须被量化,并在震荡超过临界阈值时自动发出熔断预警。
一、需求震荡对工程交付的“非线性破坏”
为什么在迭代中期修改一个看似不起眼的交互逻辑,会带来指数级的工程损耗?
[ Sprint 开始 (Day 1) ] ── 需求基线锁定
           │
           ├── (Day 2-3 正常编码)
           ▼
[ PM 触发非预期变更 (Day 6) ]
           │
           ├── 1. 已编写代码直接作废 (Code Churn 增加 30%)
           ├── 2. 数据库设计/API 契约重新对齐 (引发级联重构)
           ├── 3. 已编写的自动化测试用例全面失效 (测试资产贬值)
           └── 4. 上下文切换心智损耗 (工程师进入疲惫抵触状态)
           │
           ▼
[ 交付延期与上线质量劣化 (上线即 P1 故障) ]
变更代价的非线性规律:
在需求生命周期的不同阶段,单位变更的修复与重构成本呈数量级攀升:
$$\text{Cost}(\text{评审阶段}) : \text{Cost}(\text{开发阶段}) : \text{Cost}(\text{联调测试阶段}) : \text{Cost}(\text{上线后}) = 1 : 5 : 20 : 100$$
如果在联调阶段修改需求核心逻辑,其实际破坏力无异于在高速公路上给正在行驶的汽车更换底盘。
二、如何构建 PRD 变更率的量化指标体系
为了避免研发与产品之间陷入主观的争吵,我们需要建立可观测的客观指标:
- PRD 语义震荡度(Document Churn Rate, DCR):通过文档版本历史的 AST/Markdown 差异,计算有效语义字符的增删改比例。
- 时序加权震荡指数(Time-Weighted Churn Index, TWCI):变更发生得越晚,惩罚权重越大。
- 关联代码废弃率(Code Churn Ratio):在迭代周期内,提交后又在短时间内被
revert或重写的代码行数占总有效代码行数的比例。
时序加权震荡计算公式:
$$\text{TWCI} = \sum_{i=1}^{N} \left( \Delta \text{Scope}i \times \left(\frac{T{\text{change}}}{T_{\text{sprint_total}}}\right)^2 \right)$$
其中 $T_{\text{change}} / T_{\text{sprint_total}}$ 为变更发生的时间点进度比例。越接近发版日,平方项对风险的放大效应越剧烈。
三、需求震荡预警算法的工程实现
我们可以通过轻量级脚本监听知识库(如飞书/Confluence/Notion)文档变更与 Git 提交,实时评估 Sprint 的健康度。
import datetime
from typing import List, Dict

class RequirementChangeEvent:
    def __init__(self, doc_id: str, change_time: datetime.datetime, diff_words_count: int, critical_tag_modified: bool):
        self.doc_id = doc_id
        self.change_time = change_time
        self.diff_words_count = diff_words_count
        self.critical_tag_modified = critical_tag_modified # 是否修改了核心接口/核心业务流

class SprintHealthMonitor:
    def __init__(self, sprint_start: datetime.datetime, sprint_end: datetime.datetime, baseline_word_count: int):
        self.sprint_start = sprint_start
        self.sprint_end = sprint_end
        self.baseline_word_count = max(baseline_word_count, 100)
        self.total_sprint_seconds = (sprint_end - sprint_start).total_seconds()

    def calculate_churn_index(self, changes: List[RequirementChangeEvent], current_time: datetime.datetime) -> Dict[str, any]:
        accumulated_risk_score = 0.0
        details = []

        for chg in changes:
            # 计算该变更发生在 Sprint 的哪个时间百分比点 (0.0 ~ 1.0)
            elapsed = (chg.change_time - self.sprint_start).total_seconds()
            progress_ratio = min(max(elapsed / self.total_sprint_seconds, 0.0), 1.0)

            # 权重:越靠近截止日,指数惩罚越严重 (基底采用 2 次方)
            time_penalty = progress_ratio ** 2

            # 范围改动比例
            scope_ratio = chg.diff_words_count / self.baseline_word_count
            if chg.critical_tag_modified:
                scope_ratio *= 2.5 # 核心逻辑改动加权

            event_score = scope_ratio * time_penalty * 100
            accumulated_risk_score += event_score

            details.append({
                "time": chg.change_time.strftime("%Y-%m-%d %H:%M"),
                "progress_point": f"{progress_ratio*100:.1f}%",
                "diff_words": chg.diff_words_count,
                "event_risk_contribution": round(event_score, 2)
            })

        # 判定健康等级
        if accumulated_risk_score >= 50.0:
            level = "CRITICAL_DESTABILIZATION"
            recommendation = "立即暂停当前迭代,召开需求熔断会议,重新评估发版范围或延期发版"
        elif accumulated_risk_score >= 20.0:
            level = "WARNING"
            recommendation = "启动变更置换原则(加一个需求必须砍掉一个同等工作量的需求)"
        else:
            level = "HEALTHY"
            recommendation = "变更在可控范围内,正常推进"

        return {
            "accumulated_churn_score": round(accumulated_risk_score, 2),
            "health_level": level,
            "recommendation": recommendation,
            "change_history": details
        }
四、团队变更控制机制的落地规范
有了量化数据后,团队必须共同签署“需求变更契约”:
| 迭代阶段 | 变更类型 | 审批与处理机制 |
|---|---|---|
| 开发前期 (Sprint 进度 < 30%) | 细节字段调整、文案优化 | PM 自行修改,在群内 @ 对应负责人即可 |
| 开发中期 (Sprint 进度 30% ~ 70%) | 逻辑流变动、增加小功能 | 必须执行**“等价置换原则”**(增加 1 个新需求,必须从该 Sprint 移出 1 个同等工时的低优任务) |
| 测试与联调期 (Sprint 进度 > 70%) | 任何业务逻辑变动 | 全面冻结(Feature Freeze)。非致命缺陷一律移至下一个 Sprint 处理;若必须修改,必须经过 Tech Lead、PM 负责人与业务三方签字确认延期。 |
成熟的敏捷不是“随心所欲的混乱”,而是“受控环境下的快速响应”。用数据把需求震荡的真实研发成本摆在台面上,才能让团队摆脱无休止的内耗返工,回归健康的交付节奏。


 扫一扫


 582

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


