


端侧 AI 任务与系统 UI 渲染的 CPU 资源争抢:Linux SCHED_IDLE 与 SCHED_BATCH 调度实践
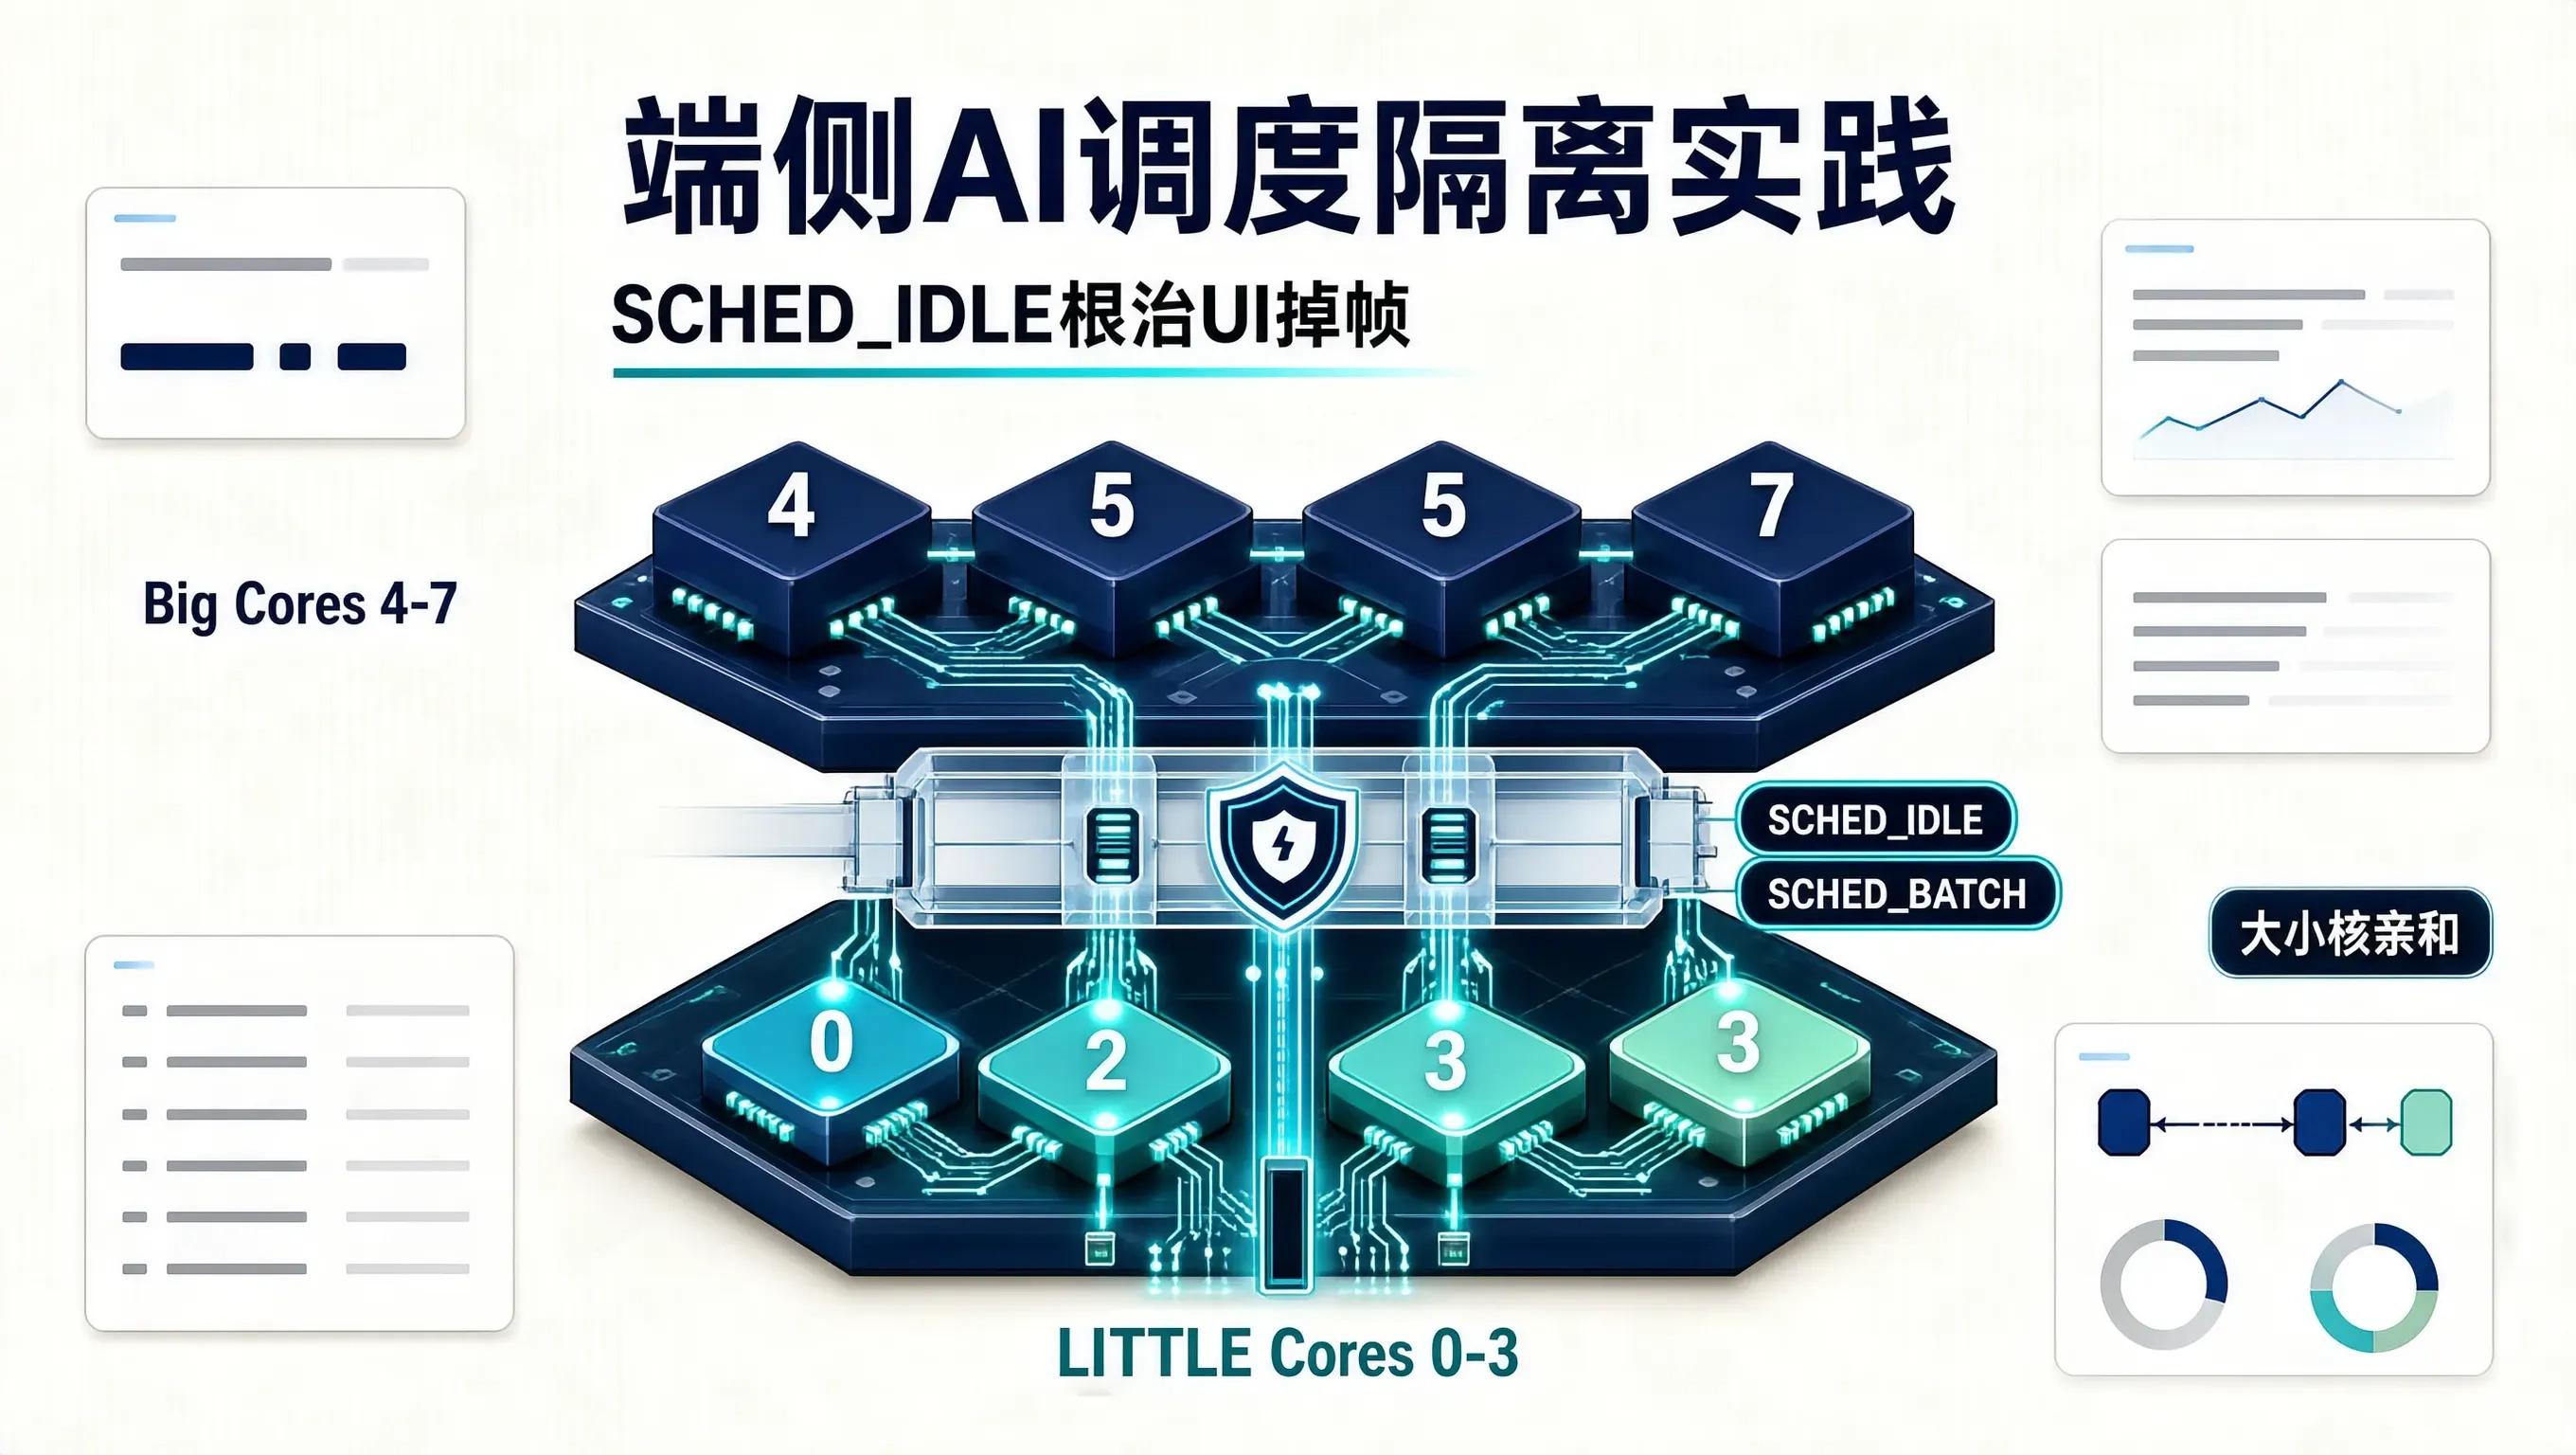
在车载座舱、智能手机或嵌入式 Linux 设备(如边缘工控网关)上运行端侧 AI 任务(如本地语音 ASR 前处理、实时语义检索、本地 3B 模型量化推理)时,一个经典的工程噩梦就是**“前台 UI 剧烈掉帧(Jank)”**。
当用户在屏幕上流畅滑动列表或触发复杂转场动画时,后台如果突然拉起一个由多线程矩阵乘法构成的端侧推理任务,CPU 的 8 个核心会被瞬间打满。默认的 Linux CFS(Completely Fair Scheduler)调度器会根据权重将时间片“公平”地分给后台计算线程,导致前台 UI 渲染线程(如 Wayland/X11 Compositor 或 Flutter/Qt UI 线程)无法在 16.6ms(60Hz)或 8.3ms(120Hz)的垂直同步(VSync)周期内完成帧渲染,界面产生严重的视觉卡死。
很多开发者的第一反应是给后台线程调高 nice 值(例如 nice -n 19),但实测发现前台依然会偶发性卡顿。本文深入剖析 Linux 调度策略底层原理,通过 SCHED_IDLE 与 SCHED_BATCH 彻底根治资源争抢。
一、为什么仅仅调 nice 值无法完全杜绝 UI 掉帧?
在标准 Linux SCHED_OTHER(或最新内核的 SCHED_NORMAL)调度策略下,nice 值为 +19 仅代表该线程在 CFS 红黑树中的权重最小,但它依然具有运行资格,其虚拟运行时间(vruntime)仍会推进。
[ CPU 运行队列 (Runqueue) ]
┌────────────────────────────────────────────────────────┐
│ UI 渲染线程 (Nice 0, 权重 1024)                         │
│ 后台 AI 推理线程 1~4 (Nice 19, 权重 15)                  │
└────────────────────────────────────────────────────────┘
                           │
                           ▼ (CFS 最小粒度调度)
1. 推理线程在每个调度周期(sysctl_sched_min_granularity)内仍会抢占 CPU 1~4ms
2. 当 4 个推理线程同时运行时,累积抢占延迟可达 8~16ms
3. UI 线程错过 VSync 截止时间 ──► 发生掉帧 (Frame Drop)
即使权重很小,当后台推理线程数量较多时,线程间频繁的上下文切换(Context Switch)和 CPU L1/L2 缓存被推理权重数据刷爆(Cache Thrashing),依然会极大拖慢前台 UI 线程的流水线吞吐。
二、SCHED_IDLE 与 SCHED_BATCH 的底层机制
为了应对不同类型的负载,Linux 内核提供了专门的调度策略:
1. SCHED_IDLE:真正的“零争抢”后台调度
- 内核机制:在 CFS 调度器中,
SCHED_IDLE任务被赋予了极其微弱的静态权重(WEIGHT_IDLEPRIO = 3)。更关键的是,内核对SCHED_IDLE设置了严格的抢占抑制规则——只要系统中有任何一个非 IDLE 策略的普通任务(无论 nice 值是多少)处于就绪状态,SCHED_IDLE任务会立即被完全剥夺 CPU 执行权,让出所有算力。 - 适用场景:对实时性完全不敏感的夜间索引构建、后台预热模型、端侧相册离线语义向量提取。
2. SCHED_BATCH:计算密集型批处理
- 内核机制:专为长时间运行且吞吐量优先的批处理设计。调度器假定该任务是计算密集型的(CPU-Bound),不会频繁进行 I/O 阻塞。因此调度器会延长其连续运行时间片,大幅减少唤醒抢占频率,从而将上下文切换的开销降到最低,提升 CPU 缓存命中率。
- 适用场景:端侧模型的 Prefill/Prompt 阶段矩阵运算、批量图像 OCR 处理。
三、调度策略控制实战代码
在 C/C++ 编写的端侧推理引擎(如基于 ONNX Runtime 或 llama.cpp 的运行时)中,可以通过 Linux 系统调用在任务启动时设置线程调度策略:
#define _GNU_SOURCE
#include <stdio.h>
#include <stdlib.h>
#include <pthread.h>
#include <sched.h>
#include <unistd.h>
#include <errno.h>
// 为当前工作线程设置 SCHED_IDLE 调度策略
int set_thread_to_idle_scheduler(void) {
struct sched_param param;
param.sched_priority = 0; // SCHED_IDLE 下优先级必须为 0
// 0 代表修改当前调用线程
if (sched_setscheduler(0, SCHED_IDLE, ¶m) != 0) {
perror("sched_setscheduler SCHED_IDLE failed");
return -1;
}
printf("[SCHED] 当前线程已成功切换为 SCHED_IDLE (极低干扰模式)\n");
return 0;
}
// 为计算密集型推理线程池设置 SCHED_BATCH 调度策略
int set_thread_to_batch_scheduler(int nice_level) {
struct sched_param param;
param.sched_priority = 0;
if (sched_setscheduler(0, SCHED_BATCH, ¶m) != 0) {
perror("sched_setscheduler SCHED_BATCH failed");
return -1;
}
// 设置适度的 nice 值
if (nice(nice_level) == -1 && errno != 0) {
perror("set nice failed");
}
printf("[SCHED] 当前线程已成功切换为 SCHED_BATCH, nice=%d\n", nice_level);
return 0;
}
void* ai_worker_thread(void* arg) {
// 线程启动首行设置调度策略
set_thread_to_idle_scheduler();
// 模拟高负载端侧矩阵乘法运算
while (1) {
volatile double x = 0.0;
for (int i = 0; i < 1000000; i++) {
x += i * 0.001;
}
usleep(100);
}
return NULL;
}
四、全链路资源隔离架构:调度 + 亲和性 + Cgroups
在生产级座舱与移动操作系统中,单靠调度策略依然不足以应对多核异构(big.LITTLE)架构。标准实践是构建**“四重隔离网”**:
[ 系统前台交互层 (UI / Wayland / Audio) ]
  ├── 绑定 CPU 核心: 大核 (Big Cores 4-7)
  ├── 调度策略: SCHED_OTHER (Nice -10) / SCHED_FIFO (实时音频)
  └── 保障: 100% 独占大核 L2/L3 Cache

[ 后台端侧 AI 推理层 (LLM / VLM / ASR) ]
  ├── 绑定 CPU 核心: 小核/能效核 (LITTLE Cores 0-3)
  ├── 调度策略: SCHED_IDLE 或 SCHED_BATCH
  └── Cgroups v2 限制: cpu.max = "200000 100000" (硬限制上限 200% CPU 算力)
生产压测对比(8 核 ARM 芯片,前台 120Hz 列表滚动):
| 配置方案 | UI 帧率 (FPS) | P99 帧延迟 (Jank) | AI 推理任务耗时 | 每秒上下文切换次数 |
|---|---|---|---|---|
| 默认设置 (SCHED_OTHER, Nice 0) | 84 fps (严重掉帧) | 48.2 ms | 12.4 s (基准) | 45,000 /s |
| 调高 nice (Nice 19) | 108 fps (偶发顿挫) | 22.1 ms | 13.1 s (+5.6%) | 38,000 /s |
SCHED_IDLE + 大小核亲和绑定 | 120 fps (满帧丝滑) | 7.8 ms (零掉帧) | 14.2 s (+14.5%) | 4,200 /s (-90%) |
在端侧嵌入式产品开发中,用户体验的“丝滑感”拥有最高的商业优先级。通过深入 Linux 调度器内核策略,牺牲 10%~15% 的后台非关键推理吞吐,换取前台交互的绝对零掉帧,是经过实战检验的最优解。


 扫一扫


 242


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


