


在做与Web爬虫有关的任务时,经常这样需要做这样的判断:对于新爬到的URL,我们需要判断这个新的URL是否已经在已有的URL集合中存在了。但是当已经存在的URL集合的数据量极其庞大时,这个存在性的判断工作就变得很有挑战性。
把这个问题抽象出来,就是说:现在需要一种算法(工具),帮助我们实现一种高效而准确的,元素在集合中的存在性判断。
为了解决上面说的这一类问题,人们从简入难,想出了很多办法:
将元素全部存在一个数据库中。判断存在性时,对整个数据库做线性扫描。显然,这种方法永远不会出错,但是时空效率都不高,时间上讲,线性时间复杂度;空间上讲,存储元素的数据库也相当大。
进一步,很容易想到可以用一些抗碰撞性较强的安全的哈希函数先对每个元素求取哈希值,在将这些哈希值存储到数据库中。如果单个元素的size比较大(至少是大于固定长度的哈希值),就能节省数据库本身的空间。这也是典型的以时间(增加了哈希值的计算)换取空间的做法。
紧接着,人们又在想,上面的方法当中对于查找的过程还都是O(n)的,有没有更快的,接近O(1)的方法。那么好了,散列表(哈希表)就派上了用场,用哈希值来决定元素存储的位置,很快就能查到那个位置有没有元素。当然,为了更节省空间,可以先求取哈希值,再用哈希值构成的集合做散列表。
其实3中已经是把某个元素映射到了某个位置上,只不过这个位置上保存的是元素本身或者哈希值,而这种关系完全可以只用计算机科学中最简洁的符号0,1来表示某个位置是否被映射了。
我们把最后这种方法叫做Bit-Map方法。今天要讲的Bloom Filter就是一中典型的Bit-Map方法。
Bloom Filter 的构造
上面的方法4,无论从时间,还是从空间的角度已经很优了。但是还有一个问题,那就是碰撞的问题,单个哈希函数计算得到哈希值,再把这个哈希值映射到一个二进制数组的某个位置上,就很有可能发生碰撞。但是,换个角度思考,如果我们能通过某种方式,极大程度上降低碰撞的概率,那么,即便依然还有小概率的碰撞可能,在工程实际中也是可以接受的。
误报率(False positive)
这里先补充一个概念:误报率(False positive),又叫假阳性
拿最开始讲的网页爬虫的问题来说,在建立BitMap时,如果发生碰撞,那我们就会认为新爬到的这个URL是已经存在于已有集合中了,而事实上,却是不存在的。这个意思抽象出来,就是把本来不存在的事物(False)误报为已存在事物(Positive)的错误率。在一般的应用场景中,有极小的误报率是可以被接受的。比如爬虫时,少爬几个网页并没有什么太大关系;医疗检查时,一个健康的人被医生误判我们患了某种疾病(False Positive),总比一个有病的人没有被检查出来(False Negative)要强得多。我们把后面一种情况称为假阴性,也就是“漏报”。
好,回归正题,通过上面的分析可知,碰撞在元素针对集合的存在性判断问题中,会导致误报率的发生,而误报率如果不大的话,对这个问题的影响也就不大。所以,当然可以设计一种方法,在降低碰撞概率的前提下,生成相应的bit串。
怎么降低碰撞概率呢?2个途径:
- 使用多个哈希,替代之前的单个哈希;
- 增大bit数组的长度。
基本结构
按照这2个思路,Bloom Filter应运而生。生成步骤如下:
选取 k 个哈希函数,记为
{h1,h2,…,hk} . 至于参数 k 的选择问题,我后面再说。假设现在有
n 个元素需要被映射到bit数组中,bit数组的长度是 m . 初始时,将m 位的bit数组的每个位置的元素都置为0。一样地,关于参数 m 的选择我之后说。现在,把这个
n 个元素依次用第1步选取的 k 个哈希函数映射到bit数组的位置上,bit数组被映射到的位置的元素变为1。显然,一个元素能被映射到k 个位置上。过程如图Fig.1所示,现在把元素集合 {x,y,z} 通过3个哈希函数映射到一个二进制数组中。最后,需要检查一个元素是否在已有的集合中时,同样用这 k 个哈希函数把要判断的元素映射到bit数组的位置上,只要bit数组被映射到的位中有一个位不是1,那一定说明了这个元素不在已有的集合内。如图Fig.1所示,检查
w 是否在集合中时,有一个哈希函数将 w 映射到了bit数组的元素为0的位置。
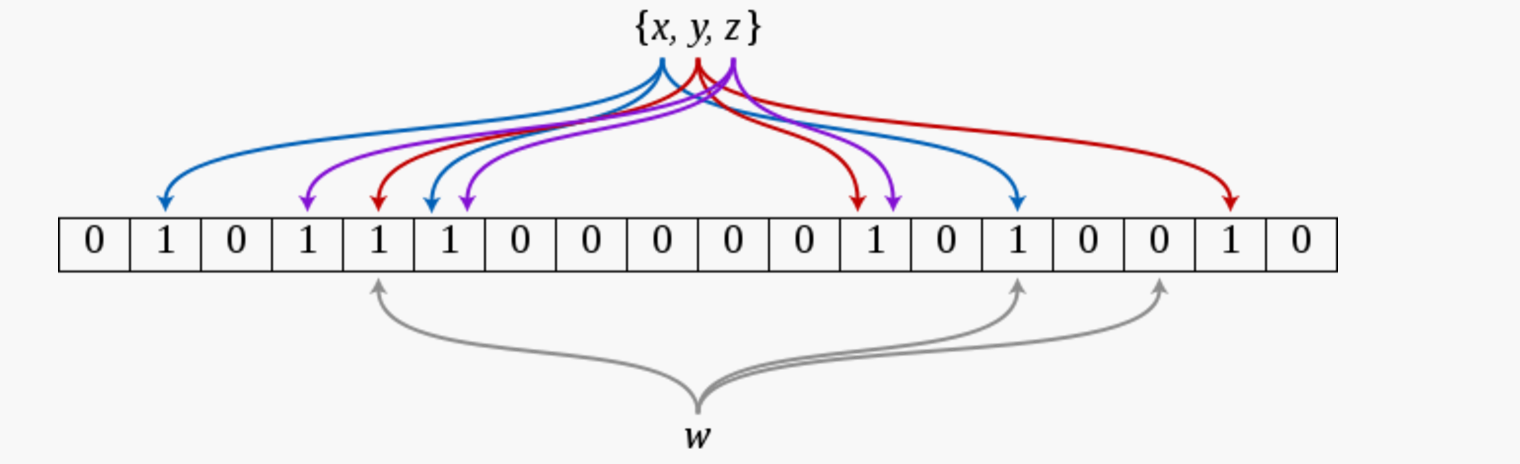
上面用的这张图是我盗的,感谢https://my.oschina.net/kiwivip/blog/133498这篇文章的作者。
参数选择
这一部分是整个Bloom Filter构造的核心内容,因为参数的选择直接决定了误报率的大小,从而直接影响准确性。
我们选择合适参数的目的,就是要降低误报率,所以先看看在什么情况下误报率最低:
- 假设bit数组
m 长,那么任意一个元素,被任意一个哈希函数映射到某一位的概率是平均的,都是 1m ,同理,没有被映射到的概率是 1−1m - 假设现在一共有
k
个不同的哈希函数,那么,bit数组的某一位能,经过这
k 个哈希函数还没有被这个元素映射到的概率是 (1−1m)k - 假设一共有
n
个元素需要被插入bit数组,那么插入
n 个元素后,对于bit数组的某一位来说,依然为0的概率是 (1−1m)nk ,换句话说,某一位为1的概率是: 1−(1−1m)nk - 假设现在对某个特定的元素存在误报,也就是说,这个元素经过
k
个哈希函数映射到的bit数组的
k 个位都是1,这个概率是: [1−(1−1m)nk]k ,换句话说,这个概率就是误报率。
如果你认可我以上的4点的话,那现在的目的就是要使得 [1−(1−1m)nk]k 达到最小值。
把这个式子化简一下:
由上面的公式可知,false positive =[1−e−nkm]k . 令 p=e−nkm ,则
其中, fp 表示误报率。由e指数的性质知, −mn⋅ln(p)ln(1−p) 达到最小时, fp 最低,也就是说, p=e−nkm=12 时,误报率最低。而 p=e−nkm=(1−1m)nk=12 ,可见这种情况下,bit数组中任意一位为0的概率是1/2,那也就是说,有一半的位置还是0.
因此,可以得到以下这个定理:
定理1: 当
nkm=ln(2)
时,误报率达到最低。最低误报率为
(12)k
,此时bit数组中有一半的位还是0。其中,
n
为要插入的元素数,
下面来确定bit数组的长度。首先可以明确的一点是
假设全集中一共有
u
个元素,因为误报率的存在,导致除了正常的
那么,不难推理出,对于某一个确定的bit数组来说,它能表示的集合数为: Cnn+fp⋅(u−n)
如果这个数组有
m
位,那么能表示的集合数为:
再顺着这个思路往前走,全集一共有
u
个元素,那么大小为
所以,要让m位的bit数组能够表示所有n个元素的集合,必须有: 2m⋅Cnn+fp⋅(u−n)>Cnu
把上面不等式化简,提出 m :
每个箭头的详细推理过程,我这里省略了。这么推下来,就可以得到本文涉及的第2个定理:
定理2: 想要Bloom Filter的误报率小于 fp ,则bit数组的长度 m 需满足下面的关系式:
由上面的定理1可知, k=mn⋅ln2 时,误报率最低,达到 (12)k ,而这个值,应该是要比定理2中的 fp 低的。如下:
化简上面的式子:
也就是 m≥1.44n⋅log2(fp−1) ,这个结果比之前定理2中计算的结果还要大1.44倍。
至此,好像Bloom Filter的几个参数都是相互影响的,那到底该如何在算法中设计呢?总结一下上面的内容,可以得到一个定理3.
定理3: 当需要设计一个误报率不超过
fp
的,容纳元素个数为
n
的Bloom Filter时,我们要求bit数组的长度
这样,其实我们做出来的Bloom Filter的误报率会比要求的还要低。
Bloom Filter 的Python 实现
明确了Bloom Filter的参数选择问题,下面的就很简单了,一点点实现就行。我将给出Python代码,供大家参考。
参数生成
先确定参数:
import math


def gen_m(n, falsePositive):
    """m is the length of bit array"""

    return int(1.44 * n * (math.log(1 / falsePositive, 2)))


def gen_k(m, n):
    """k is the number of hash function in hash family"""

    return int(math.log(2, math.e) * (m / n))
怎么确定的上面用了相当大的篇幅讲,不再赘述。
哈希函数族生成
接下来是生成哈希函数族:这里我选用的是传统的MD5算法,为了能生成多个不同的哈希函数,我为每个MD5函数设置了一个种子,简单起见,比如说需要
k
个哈希函数,就选取区间
比如现在需要对消息m映射,那么, k 个哈希函数的计算形式是:
r_1 = md5("0" + "m")
r_2 = md5("1" + "m")
...
r_k = md5("k-1" + "m")
当然可以有其他形式,值需要保证
代码如下:
import hashlib


def genHashFamily(k):
    """generate k hash functions as hash family"""

    result = [hashlib.md5() for i in range(k)]

    for j in range(k):
        result[j].update(str(j).encode())

    return result
插入元素
现在将集合中的元素依次插入bit数组,直接给出代码:
def genBitArray(hashFamily, wordSet, m):
    """map the hash value of each word in word set to bit array according to hash family"""

    result = [0 for i in range(m)]

    for word in wordSet:
        for hashFunc in hashFamily:
            temp = hashFunc.copy()
            temp.update(word.encode())
            result[int(temp.hexdigest(), 16) % m] = 1

    return result
需要注意的两点:
用哈希函数的时候,一定要先复制一下这个md5对象,否则会影响哈希函数族,这也是Python中md5对象使用的特性
我们是通过先将16进制的哈希值转换为整数,再用整数对 m 取余实现元素到位置的映射的。
检测函数
对于一个新的元素,怎样判断是否属于某个集合呢?既然这个集合已经全部映射到了一个Bloom Filter当中,我们就按照同样的思路映射这个新的元素,看看它被映射到的位置是否都是1,只要有一个位是0,就判为false. 函数如下:
def checkWord(word, hashFamily, bitArray):
    """check if the word can be map in bit array correctly with hash family"""

    m = len(bitArray)

    for hashFunc in hashFamily:

        temp = hashFunc.copy()
        temp.update(word.encode())
        if bitArray[int(temp.hexdigest(), 16) % m] != 1:
            return False
return True以上,我只是将各个关键的函数向大家展示一下,至于这个项目的完整代码,请参考我的github主页:https://github.com/guoziqingbupt/Bloom-Filter



 686


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


