Bloom Filter 原理 及C++ 实现

C++海量数据处理:位图与布隆过滤器原理实现与实战应用 在计算机科学中,哈希表是处理键值查询的基础数据结构,提供O(1)的平均操作效率。然而,当数据规模达到海量级别时,传统哈希表的内存开销成为瓶颈。位图通过每个比特位标记整数存在性,实现极致的空间压缩,但仅适用于整数类型。布隆过滤器则通过多个哈希函数将任意数据映射到位图的多个位置,以极小的误判率为代价,实现高效的存在性判断。这种概率数据结构在工程上具有重要价值,广泛应用于缓存系统、数据和大数据处理领域。例如,在缓存穿透防护和垃圾邮件过滤等场景中,布隆过滤器能以百兆内存处理亿级数据,显著提升系统性能与可扩展性。本 阅读详情

布隆过滤器[1](Bloom Filter)是由布隆(Burton Howard Bloom)在1970年提出的。
它实际上是由一个很长的二进制向量和一系列随机映射函数组成,布隆过滤器可以用于检索一个元素是否在一个集合中。

它的优点是空间效率和查询时间都远远超过一般的算法,缺点是有一定的误识别率(假正例False positives,即Bloom Filter报告某一元素存在于某集合中,但是实际上该元素并不在集合中)和删除困难,但是没有识别错误的情形(即假反例False negatives,如果某个元素确实没有在该集合中,那么Bloom Filter 是不会报告该元素存在于集合中的,所以不会漏报)。


主要思路是

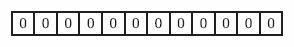
1. 使用位图或者位数组表示m个0的集合M;

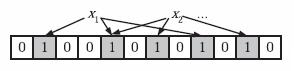
2. 使用K个hash函数将N个元素映射到集合M中的某一位,并使这位为1;

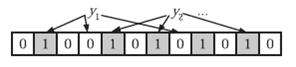
3. 查询时候当给一个query 使用K个hash函数映射后,对应的m为都为1,则存在,否则不存在。

具体思路使用M 位数组表示集合
Bloom filter 会使用K个hash函数 将某一个元素x_i, 映射到M中,如下图所示
判断给定一个元素y在不在这个集合,则用K个hash函数对y做映射,所有位都为1 则存在,否则不存在。
错误率估计

在Chapter 4 “Mining of Massive data”-CMU Anand Rajaraman的书中把错误率的计算:

If a key value is in S, then the element will surely pass through the Bloom filter. However, if the key value is not inS, it might still pass. We need to
understand how to calculate the probability of afalse positive, as a function of n, the bit-array length, mthe number of members of S, and k, the number of
hash functions.
The model to use is throwing darts at targets. Suppose we havextargets
andy darts. Any dart is equally likely to hit any target. After throwing the
darts, how many targets can we expect to be hit at least once?

主要的思路是计算转化为一个飞镖问题,有m个靶位,有n个飞镖,假设每个飞镖有k次机会,(相当于n*k个镖)投中某个特定靶位的概率。

假设我们将hash函数认为是随机的,投镖的过程也是随机的,

那么每次我们投不中特定的靶位的概率为(1-1/m)

投n*k次的话 (1-1/m)^(n*k), 使用
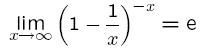
当n*k个镖都投完某一位还为0的概率是p = e^(-kn/m)


最优的hash函数个数及位数组的个数:

对于某个y元素经过k个hash函数映射后 都为1的概率是f =(1-p)^k. 对这个式子取ln,可以得到 g = k ln(1 − e−kn/m)

这样使得

C++进阶系列】:位图和布隆过滤器(附模拟实现的源码) 想要学会位图和布隆过滤器?看这篇文章就够了!万字详解 阅读详情

相关推荐

最优匹配的blossom5算法的C++源码

BLOSSOM V - implementation of Edmonds' algorithm for computing a minimum cost perfect matching in a graph Version 1.0

一般图最大匹配(带花树算法)(学习+模板)

参考博客: https://blog.csdn.net/xuezhongfenfei/article/details/10148445 https://www.cnblogs.com/zhoushuyu/p/8717234.html https://www.cnblogs.com/owenyu/p/6858508.html 经典例题: https://www.cnblogs.com/BA...

birdmanqin的博客 2926

open bloom filter

open bloom filter是我见过的bloom filter之中写的比较好的一个,但是其中的数值范围过大,获取hash函数时测试次数过多。希望对你有所裨益,使用的时候请遵守原作者的权益。见过csdn上好多不要脸的人,别人写的东西,自己上传一下,还要那么多资源分,谴责一下。

C++BloomFilter——布隆过滤器

C++BloomFilter——布隆过滤器

weixin_60478154的博客 1655

C++】哈希的应用:位图(bitset)和布隆过滤器(bloomfilter

面对判断一个数在不在海量数据中的问题,红黑树和哈希表查找效率是挺高的,但是我们光把海量数据存起来够呛,同时红黑树和哈希表附带的内存消耗,所需空间更大,基于这样的原因,提出了位图这种数据结构。布隆过滤器(Bloom Filter)是由布隆在1970年提出的 一种紧凑型的、比较巧妙的概率型数据结构,特点是高效地插入和查询,它的实现是一个「很长的二进制向量(位数组)」和「一系列哈希函数」。可以用来快速判断一个元素一定不存在或者可能存在一个集合中”。...

codewinter的博客 1275

BloomFilter算法概述

Bloom Filter是由Bloom在1970年提出的一种多哈希函数映射的快速查找算法。通常应用在一些需要快速判断某个元素是否属于集合,但是并不严格要求100%正确的场合。一. 实例 为了说明Bloom Filter存在的重要意义,举一个实例: 假设要你写一个网络蜘蛛(web crawler)。由于网络间的链接错综复杂,蜘蛛...

weixin_34082695的博客 707

布隆过滤器 (Bloom Filter) 的底层原理C++ 代码实现

哈希+位图:用多个哈希函数将元素映射到位图概率性存在:用空间换时间,容忍可控误判不可删除:bit位被多个元素共享。

Xzq210509的博客 1021

c++实现Bloom Filter

Bloom Filter(BF) 是由Bloom在1970年提出的一种多哈希函数映射的快速查找算法,用于快速查找某个元素是否属于集合, 但不要求百分百的准确率。 Bloom filter通常用于爬虫的url去重,即判断某个url是否已经被爬过。  为了说明Bloom Filter存在的重要意义,举一个实例:   假设要你写一个网络蜘蛛(web crawler)。由于网络间的链接

The Coding World 2339

bloom filter详细讲解以及代码分析

bloom filter详细讲解以及代码分析 一. 简介 1.什么是bloom filter?      Bloom filter 是由 Howard Bloom 在 1970 年提出的二进制向量数据结构,它具有很好的空间和时间效率,被用来检测一个元素是不是集合中的一个成员,这种检测只会对在集合内的数据错判,而不会对不是集合内的数据进行错判,这样每个检测请求返回有“在集合内(可能错误

chenglinhust的专栏 1885

C++数据结构高阶|布隆过滤器(Bloom Filter)深度解析:从原理到手写实现,面试高频考点全覆盖

布隆过滤器是一种基于哈希思想的空间高效概率型数据结构,广泛应用于缓存穿透拦截、海量数据去重等场景。它通过"多个独立哈希函数+位数组"的组合实现元素存在性判断,具有空间效率高、查询速度快的特点,但存在一定误判率(假阳性)。文章详细解析了布隆过滤器的核心原理、参数计算、C++/Java实现代码,以及与哈希表的区别,并提供了面试常见问题解答和避坑指南。布隆过滤器特别适合海量数据且允许轻微误判的场景,是Redis等中间件的核心组件,也是大厂面试的高频考点。

2402_87794035的博客 493

Bloom Filter(布隆过滤器)

转自:http://blog.csdn.net/hguisu/article/details/7866173 1. Bloom-Filter算法简介         Bloom-Filter,即布隆过滤器,1970年由Bloom中提出。它可以用于检索一个元素是否在一个集合中。        Bloom Filter(BF)是一种空间效率很高的随机数据结构,它利用位数组很简洁地

692

bloom-filter:C语言中的Bloom Filter实现

盛开 纯C中的Bloom过滤器实现: 此实现包括Bloom(如果有) 您想创建自己的util,并基于纯文本名为bloom实现。 当前实现自动选择过滤器大小和哈希函数计数达到指定最大错误率。 当前实现中使用的Murmur哈希: 速度 10 mb / s的最大错误率0.00001 最大错误率0.001时为17 mb / s 这意味着可以在20秒内过滤大约200万个项目。 用法 键入make进行编译并运行./bloom以获取帮助。 执照 麻省理工学院

Bloom过滤器的C++实现

Bloom Filter原理C++实现,并利用Bloom Filter实现简单的词典,进行字词查询

简易布隆过滤器

布隆过滤器 Bloom Filter 一、原理 如果想判断一个元素是不是在一个集合里,一般想到的是将集合中所有元素保存起来,然后通过比较确定。链表、树、散列表(又叫哈希表,Hash table)等等数据结构都是这种思路。但是随着集合中元素的增加,我们需要的存储空间越来越大。同时检索速度也越来越慢。 Bloom Filter 是一种空间效率很高的随机数据结构,Bloom filte

youngyoungla 654

C++】位图+布隆过滤器+哈希切分

本文介绍了两种处理海量数据的高效数据结构:位图和布隆过滤器。位图通过比特位表示数据存在状态,显著节省内存空间,适用于判断元素存在性问题,并详细讲解了位图的实现原理和代码实现。布隆过滤器通过多个哈希函数减少误判率,适用于字符串等复杂数据的快速查询。文章还探讨了哈希切分技术,通过分治思想处理超大规模数据文件。最后给出了多个典型应用场景的解决方案,如查找重复IP、文件交集等。这些技术在大数据处理中具有重要应用价值。

qjx的博客 645

C++哈希扩展:位图与布隆过滤器实战

位图(Bitmap)和布隆过滤器(Bloom Filter)是两种基于哈希扩展的高效数据结构,常用于处理大规模数据集的存储和查询。位图主要用于表示和操作布尔值集合,而布隆过滤器则是一种概率数据结构,用于快速测试元素是否在集合中(可能产生假阳性但不会假阴性)。下面我将逐步介绍它们的概念、原理、优缺点,并提供C++实现代码。位图是一种紧凑的数据结构,用于存储和操作二进制位(bit)。它通过将每个位映射到一个索引来表示布尔值集合,例如表示一个元素是否存在。

geigejif的博客 80

C++ 位图&布隆过滤器

哈希表衍生出的位图和布隆过滤器是解决海量数据查找问题的有效方法。位图通过比特位表示数据存在状态,大幅节省空间(40亿整数仅需0.5GB)。布隆过滤器则通过多个哈希函数将任意类型数据映射到位图中,实现快速查找,但存在一定误判率。两种数据结构适用于不同场景:位图适合处理整数存在性判断,布隆过滤器可扩展至字符串等复杂类型。文中还给出了位图实现代码及典型应用场景,如查找仅出现一次的整数和文件交集问题,展示了这两种数据结构在大数据处理中的高效性和实用性。

m0_74278159的博客 354

C++哈希扩展实战

本文探讨了处理海量数据的两种高效数据结构——位图和布隆过滤器。当数据规模超出内存容量时,位图通过1bit标记整数存在状态,仅需512MB空间即可实现O(1)查询。而针对位图仅支持整型的局限,布隆过滤器通过多哈希函数扩展支持任意数据类型,以可控误判率换取空间效率。

dev_jin的博客 395
上一篇: 快速排序 及应用
下一篇: 文档的Jaccard相似度, MinHash, 及MinHash签名
dannyPolyu
博客等级 码龄14年 4粉丝 19原创
评论 1
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

红包个数最小为10个

红包金额最低5元

当前余额3.43前往充值 >
需支付:10.00
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值