


经验心得
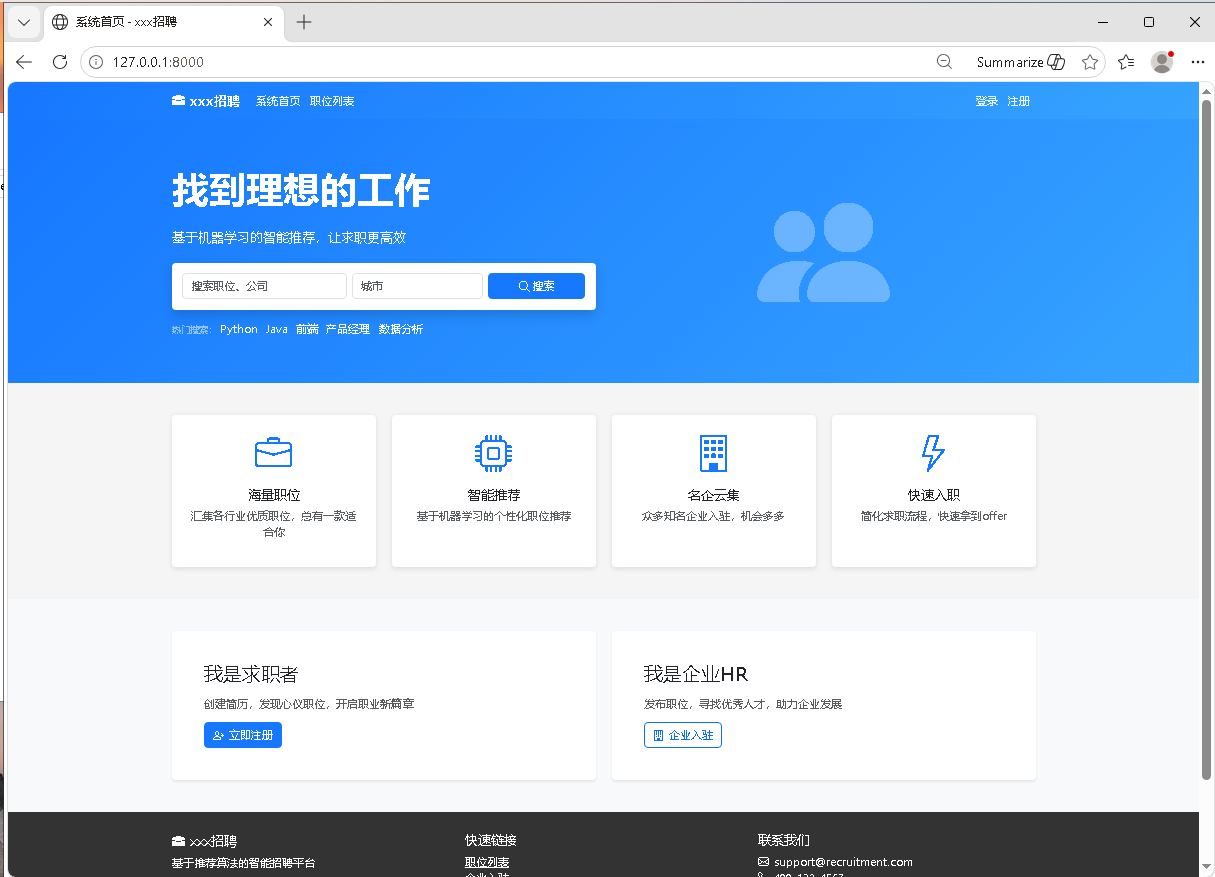
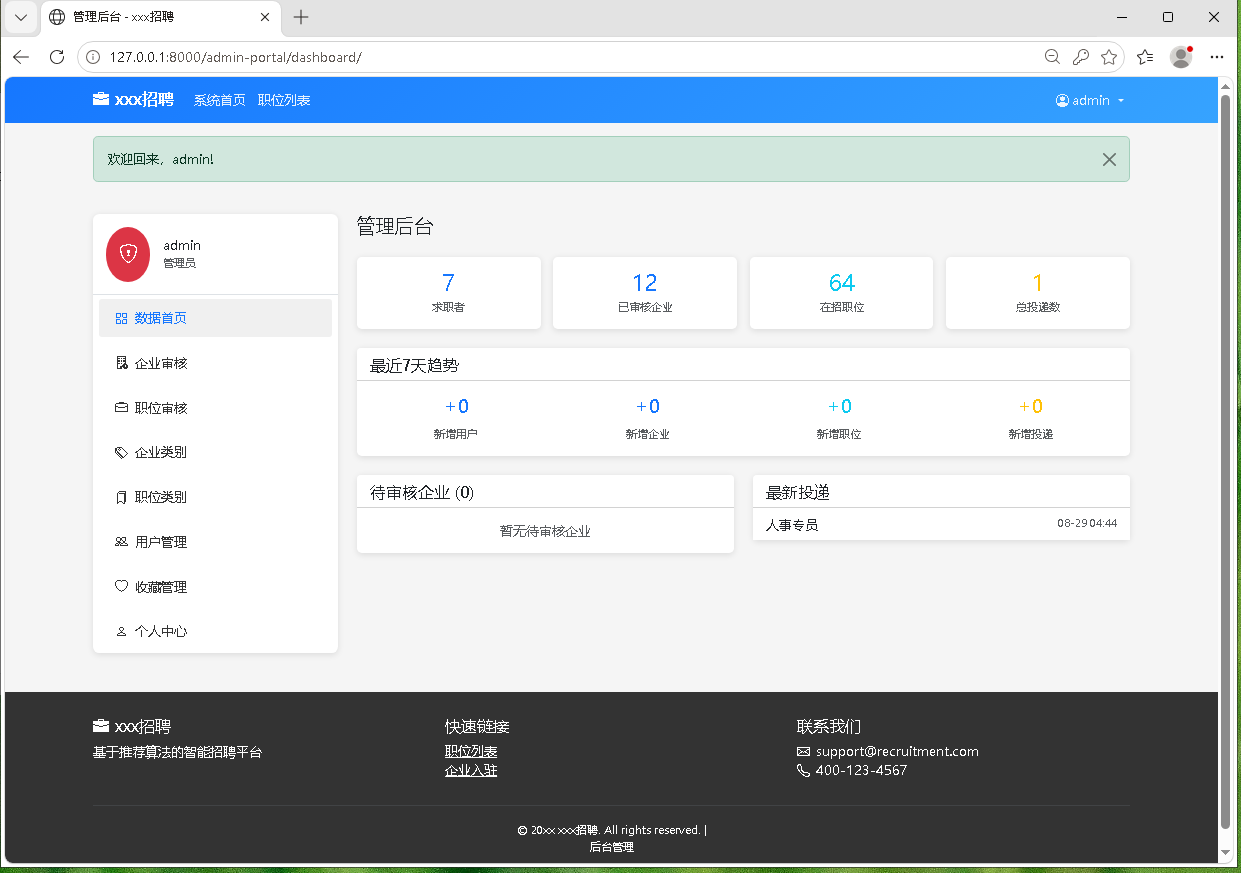
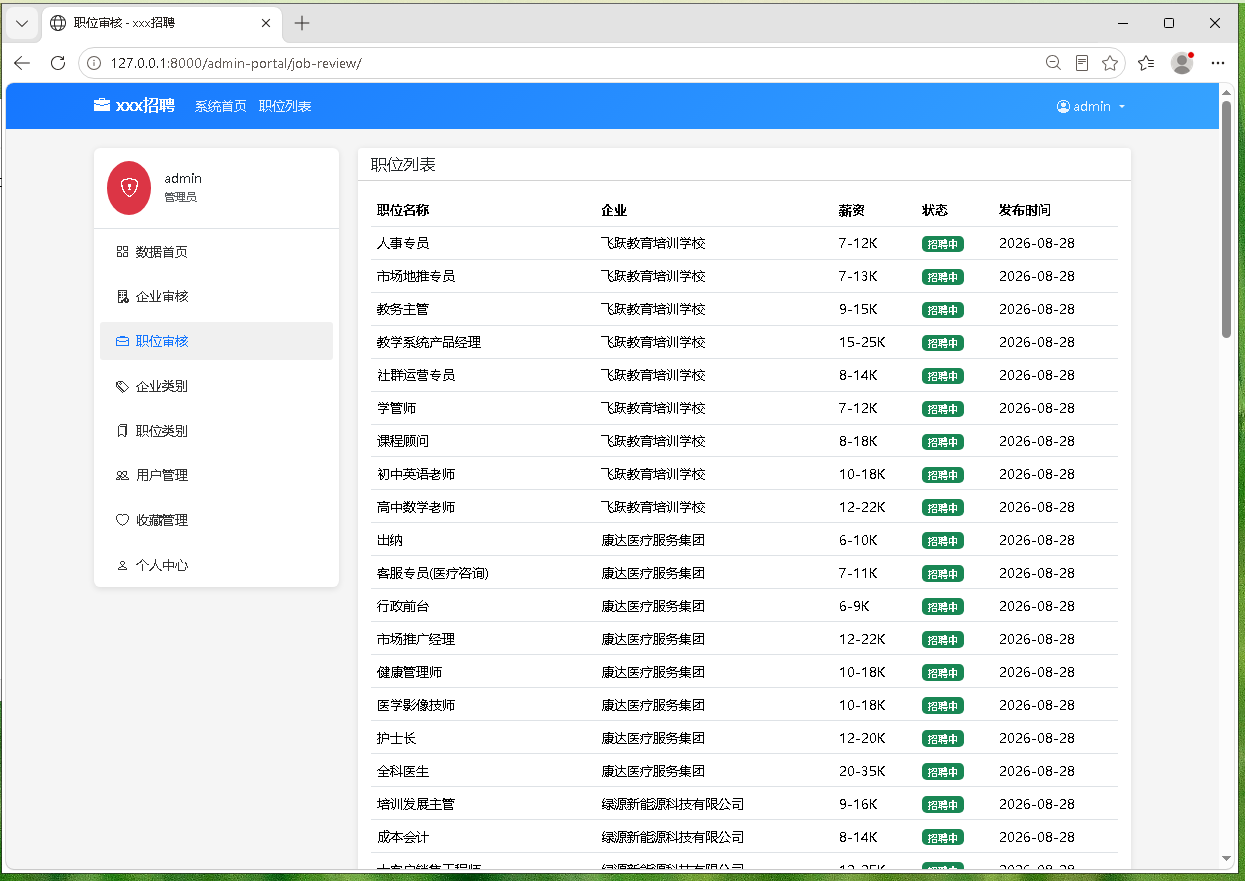
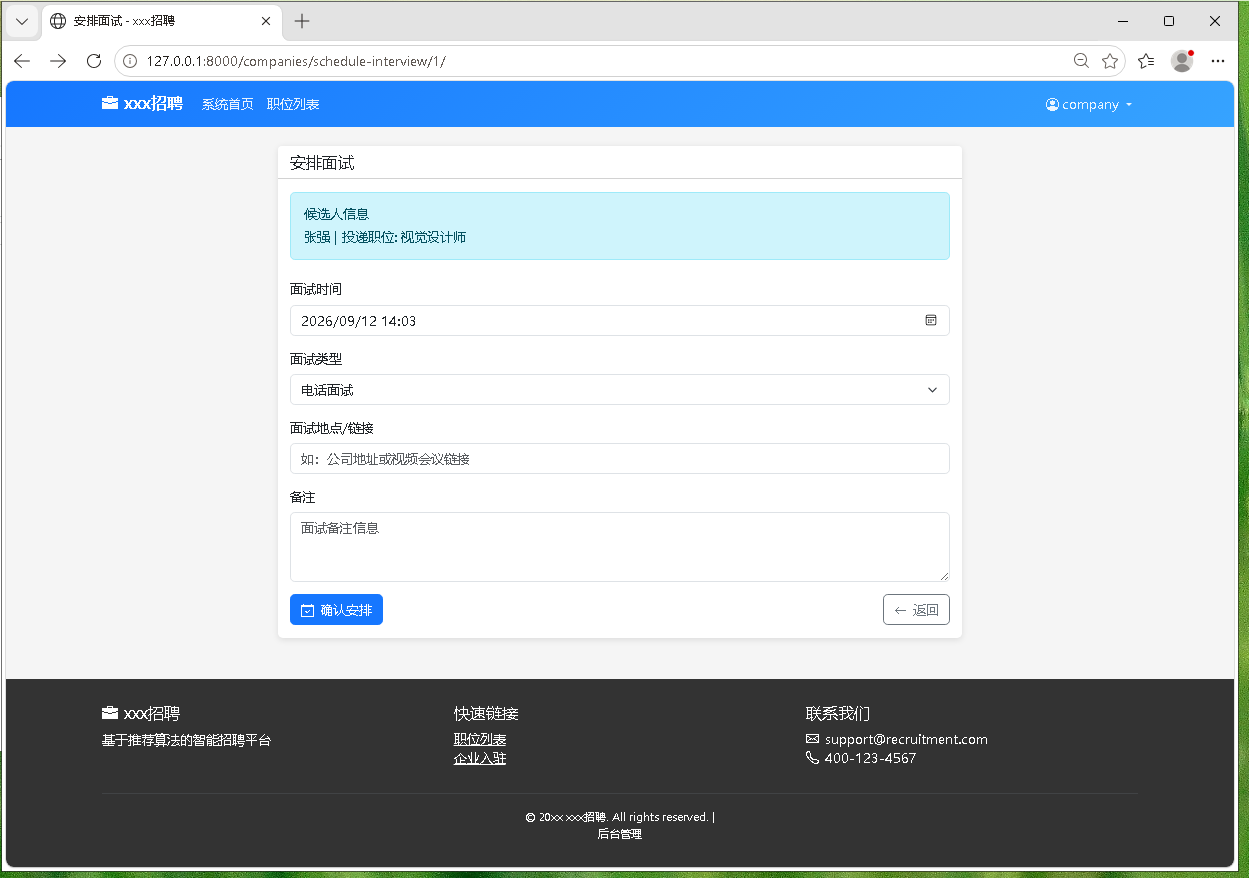
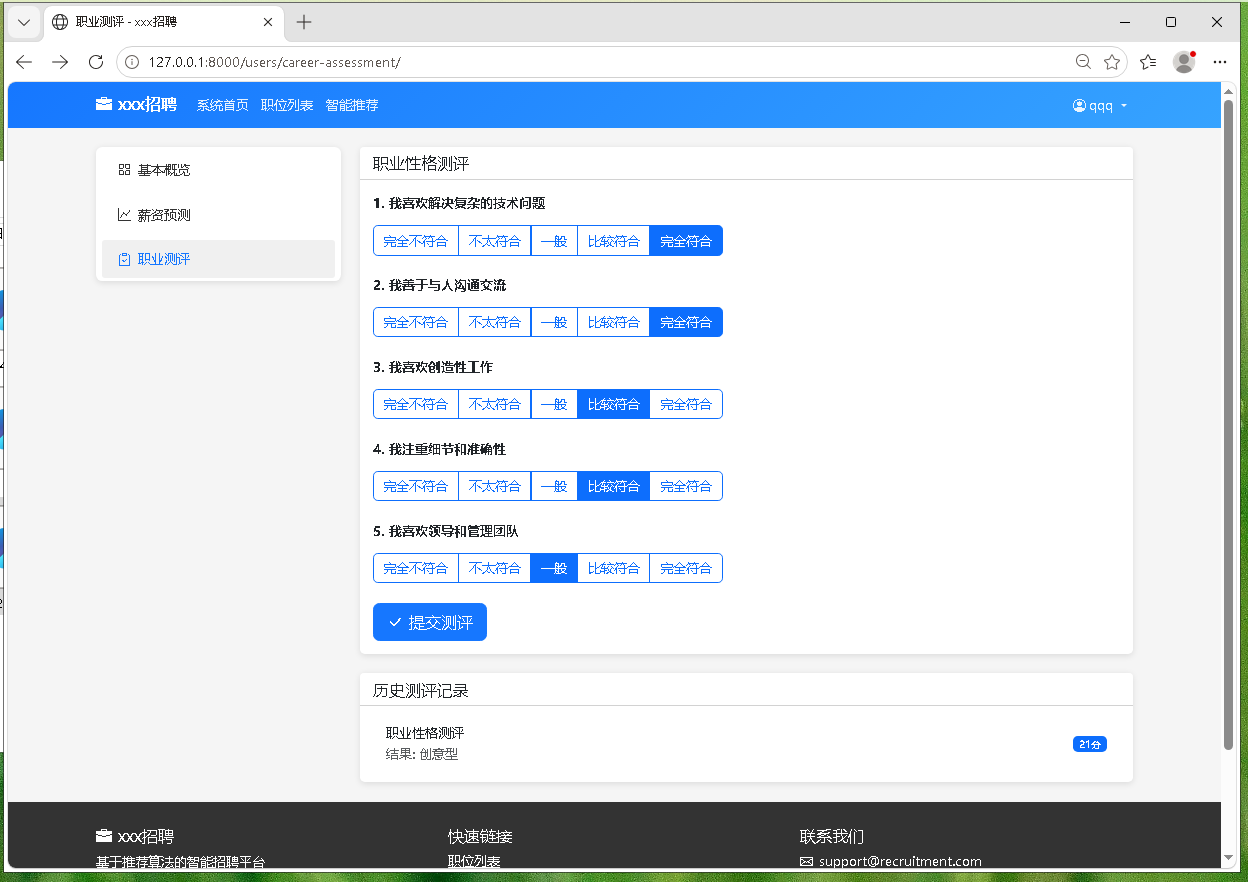
这个也是帮助客户修改的,通过和客户沟通可以发现,上一个技术真的是极其不负责任,界面整体设计也是绿的发慌不懂基本色彩搭配(几年前多亏一位留学哥们提供咱们学习的地方哈哈哈),测试数据集没有,各种错误的问题,直接给客户就不理。代码中很多业务逻辑看似没问题,一旦使用就各种报错出现了。代码是上一个接单人员通过ai生成的,只实现crud就完事了?业务逻辑这里也很容易在没源代码情况发现报错的问题,demo中有个面试时提交的功能,后端大概就是insert插入就不处理其他问题了,如果重复提交表单就会报错,因为django.db.utils.IntegrityError: UNIQUE constraint failed: users_interview.application_id,这就是对业务不熟悉的后果。其他还有更无语的地方,人工智能机器学习推荐算法,其实这个demo里面没有机器学sklearn的库,他就是使用两种基于规则的启发式推荐,协同过滤部分通过相似度找相似用户,再根据相似用户的行为加权推荐,另一个基于内容的推荐部分,根据用户收藏职位的类别,位置等特征,用硬编码的权重打分排序,这也是规则匹配,而非真正的特征学习。所以后面咱们需要帮助客户重新修改一下可以了。
没有模型训练过程:典型的机器学习推荐算法如矩阵分解,神经网络推荐等,咱们再复习一下之前的AI开发流程,需要经历"数据 -> 特征工程 -> 模型训练(fit) -> 预测的流程,会使用 sklearn,TensorFlow,pytorch,yolo等库,所以这段代码完全没有这些步骤。
没有从数据中学习参数:机器学习的关键在于模型能从历史数据中自动学习出参数和模式。而这段代码的所有权重(收藏×1.0,投递×2.0,类别×2.0,位置×1.5 等)都是人工硬编码的,不是从数据中学出来的。
相似度计算是即时计算的:每次请求都实时遍历所有用户计算相似度,而不是预先训练好一个相似度模型。
它实际做了什么:
这段代码实现的是两种基于规则的启发式推荐:
协同过滤部分(get_collaborative_filtering_recommendations):用相似度找相似用户,再根据相似用户的行为加权推荐。思路是对的,但实现方式是纯规则驱动的,没有构建用户-物品评分矩阵,也没有用矩阵分解等模型化方法。
基于内容的推荐部分(get_content_based_recommendations):根据用户收藏职位的类别,位置等特征,用硬编码的权重打分排序。这也是规则匹配,而非真正的特征学习。


 扫一扫


 220

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


