


数据库选型技术债:创业初期误用 MongoDB 替代关系型数据库的血泪重构
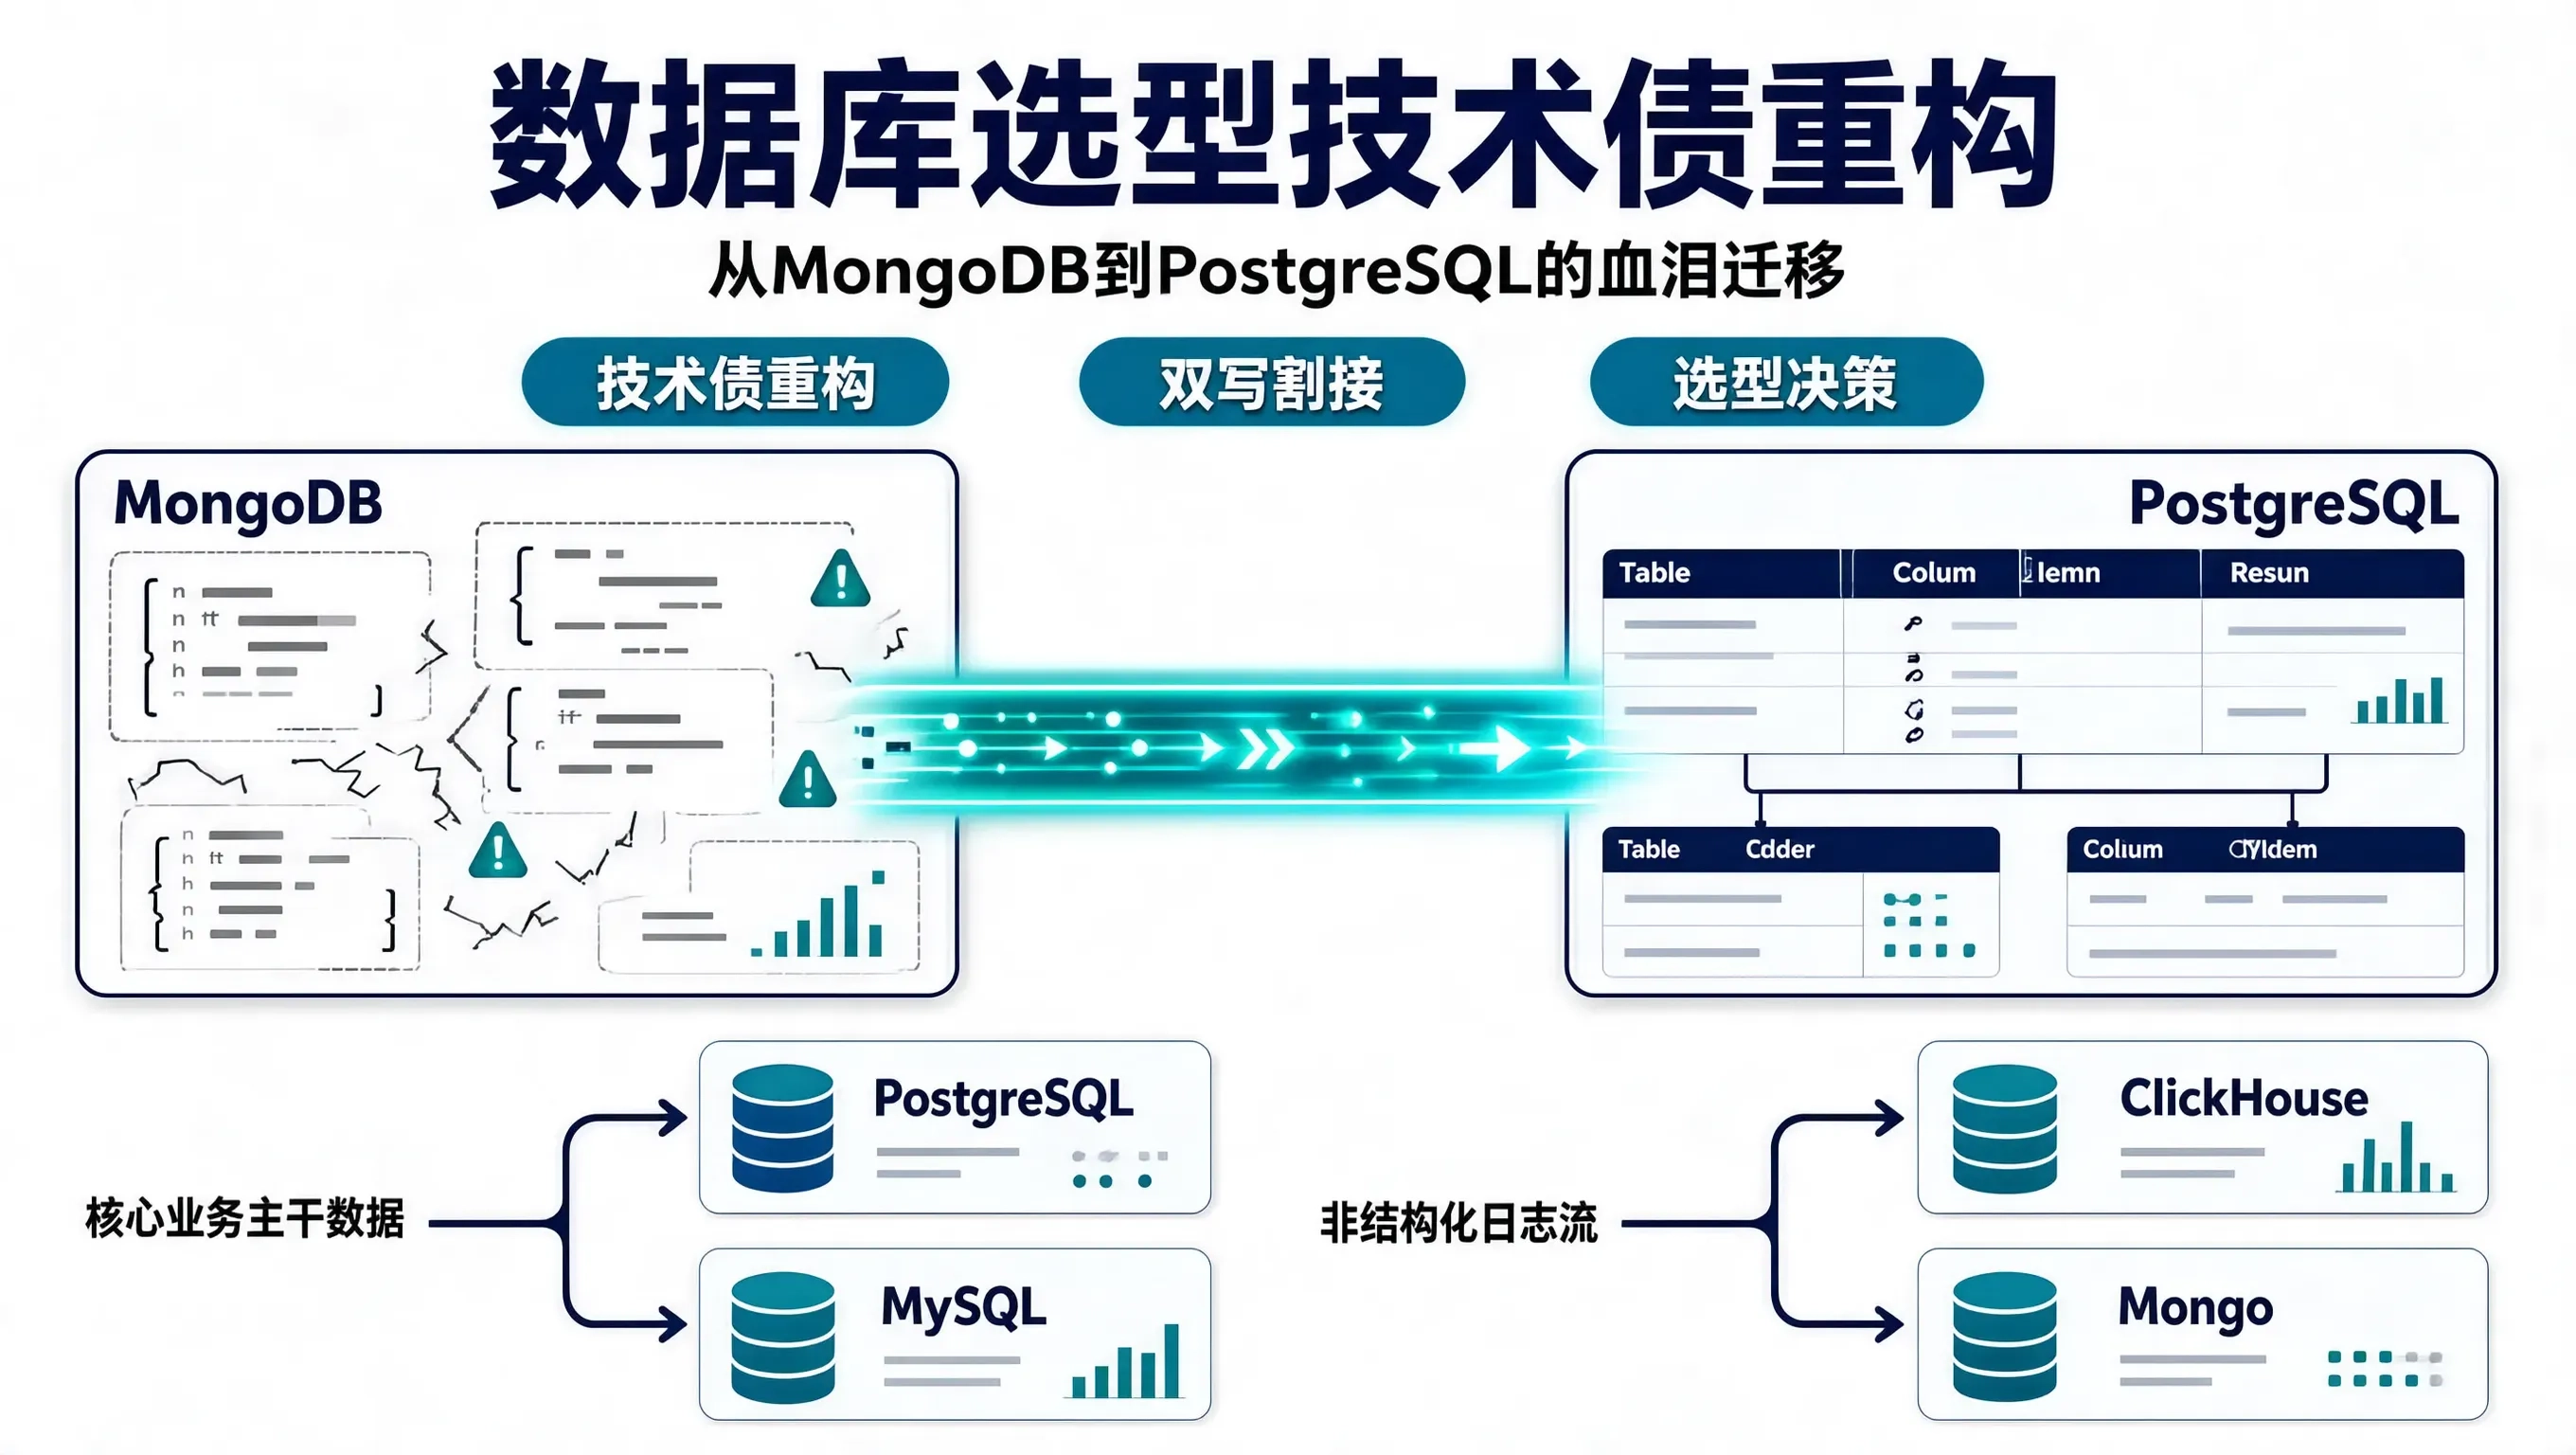
在技术创业的早期,几乎所有团队都会面临“快与对”的巨大撕裂。产品经理每天都在修改需求,今天增加一个“团队折扣”,明天调整一次“优惠券抵扣逻辑”。
很多工程师在快速交付的巨大压力下,容易被 NoSQL 数据库的宣传话术所打动:“无需提前设计表结构”、“Schemaless 随心所欲存 JSON”、“天然支持横向扩展”。于是,团队一拍大腿,决定将包括用户账户、权限体系、订单支付与财务对账在内的核心业务,全部直接用 MongoDB 承载。
在项目跑通前 100 个客户的 MVP 阶段,这种设计确实显得非常敏捷,免去了反复写 DDL 迁移脚本的麻烦。
但当客户量级从百人增长到十万人,业务开始接入多租户、自动扣费、子账号权限隔离和月度财务报表时,曾经以为省下的时间,以百倍的代价变成了吞噬团队精力的技术债黑洞。
今天用真实的重构经历,复盘这段将核心业务从 MongoDB 全面迁移回 PostgreSQL 的血泪教训。
一、Schemaless 带来的四大暗黑技术债
很多初创团队误以为“数据库无模式(Schemaless)”等于“业务没有模式”。实际上,数据必然是有模式的;如果你不在数据库层面做约束,这种约束成本就会以极度丑陋的方式转嫁给应用层代码。
               Schemaless 的技术债转移路径
┌─────────────────────────────────────────────────────────────┐
│ 数据库层 (MongoDB): 放任自由,接收任何 JSON 结构             │
└──────────────────────────────┬──────────────────────────────┘
                               │ (技术债向上溢出)
                               ▼
┌─────────────────────────────────────────────────────────────┐
│ 应用层代码 (Python / Node / Go): 充斥着海量的防御性代码     │
│ - 字段命名混乱: doc.get("userId") or doc.get("user_id")     │
│ - 类型漂移: amount 字段有时是 int(分),有时是 float(元)     │
│ - 脏数据孤岛: 用户注销后,残留的订单关联着不存在的 ID        │
└──────────────────────────────┬──────────────────────────────┘
                               │ (灾难爆发)
                               ▼
┌─────────────────────────────────────────────────────────────┐
│ 财务与业务层: 偶发对账不平、多角色越权、多层 $lookup 查询卡死│
└─────────────────────────────────────────────────────────────┘
1. 字段命名漂移与类型污染
随着不同时期的工程师接手代码,文档结构在不知不觉中分裂:
- 早期代码写入的是
{"userId": "1001", "created_at": 1700000000}; - 中期工程师写成了
{"user_id": 1001, "createdAt": "2024-05-01T10:00:00Z"}; - 后期重构时甚至出现了
{"uid": "U1001"}。
后端代码为了兼容历史数据,每一个读取函数都充斥着密密麻麻的 try...catch 和回退逻辑,代码可读性彻底归零。
2. 外键缺失导致的脏数据孤岛
在关系型数据库中,ON DELETE CASCADE 或 RESTRICT 能在底层卡死数据完整性。而在文档数据库中,当一个用户被管理员物理删除时,应用层一旦在异步队列中漏发了一条清理事件,该用户的历史订单、订阅记录就会永远变成没有归属的“幽灵数据”,直接污染全量统计报表。
3. 复杂聚合查询(Aggregation Pipeline)性能断崖
当管理层需要一份“统计过去 90 天内开通 Enterprise 席位且活跃天数大于 15 天的客户名单”时,MongoDB 的 $lookup(相当于关系数据库的 JOIN)开始原形毕露:
$lookup本质上是在应用内存中进行极其低效的哈希/嵌套循环匹配;- 缺乏成熟基于代价的查询优化器(CBO),数据量稍大时直接触发内存溢出(Exceeded memory limit for $group, but didn't allow external sort);
- 一条原本在 PostgreSQL 中 20ms 内完成的多表关联索引查询,在 Mongo 聚合管道中跑了 8 秒,直接把主节点 CPU 打到 100%。
二、重构方案:从 MongoDB 到 PostgreSQL 的双写与无缝割接
为了在不中断生产业务的前提下完成数据架构纠偏,我们设计了四阶段的迁移策略:
[客户端业务请求]
       │
       ▼
┌─────────────────────────────────────────────────────────────┐
│ 应用层适配网关 (ORM Dual-Write Layer)                       │
│                                                             │
│  ┌───────────────────────────┐  ┌─────────────────────────┐ │
│  │ 主写入: MongoDB (历史主库)│  │ 异步双写: PostgreSQL    │ │
│  └───────────────────────────┘  └─────────────────────────┘ │
└──────────────────────────────┬──────────────────────────────┘
                               │
                               ▼
┌─────────────────────────────────────────────────────────────┐
│ 增量对账与校验后台服务 (Reconciliation Daemon)               │
│ - 定时比对 PG 与 Mongo 的数据一致性与哈希校验和              │
│ - 发现字段缺失或类型不匹配立即告警并就地清洗补齐              │
└─────────────────────────────────────────────────────────────┘
迁移四步法:
- 模式定义与规范化建表:在 PostgreSQL 中严密设计 3NF 规范化表结构,利用强类型(
BIGINT,TIMESTAMPTZ,DECIMAL(12,2))与外键约束;对于真正需要动态扩展的个性化配置字段,采用jsonb字段存储并建立 GIN 索引。 - 全量历史数据清洗与搬迁:编写脱敏与类型规范化脚本,逐条校验字段类型,将分/元统一为整型(分),清洗脏 ID。
- 应用层双写与异步对账:主写 Mongo,同步/异步写 PG,运行后台比对守护进程(Reconciliation Daemon)。
- 读写流量切换:确认 PG 数据一致率达 100% 持续 7 天后,将读写流量一次性切换至 PG,彻底废弃并下线 Mongo。
三、核心数据清洗与迁移对账脚本实现
以下是用 Python 实现的高健壮性历史数据清洗与双向对账脚本:
import psycopg2
from pymongo import MongoClient
from decimal import Decimal
from datetime import datetime
from typing import Optional

class MigrationPipeline:
    def __init__(self, mongo_uri: str, pg_conn_str: str):
        self.mongo_client = MongoClient(mongo_uri)
        self.mongo_db = self.mongo_client["production_db"]
        self.pg_conn = psycopg2.connect(pg_conn_str)
        self.pg_conn.autocommit = False

    def clean_and_migrate_orders(self, batch_size: int = 1000):
        mongo_orders = self.mongo_db["orders"].find().batch_size(batch_size)
        pg_cursor = self.pg_conn.cursor()

        insert_sql = """
        INSERT INTO core_orders (
            order_id, user_id, tenant_id, amount_cents, status, created_at, extra_metadata
        ) VALUES (%s, %s, %s, %s, %s, %s, %s)
        ON CONFLICT (order_id) DO UPDATE
        SET amount_cents = EXCLUDED.amount_cents,
            status = EXCLUDED.status,
            extra_metadata = EXCLUDED.extra_metadata;
        """

        records_to_insert = []
        for doc in mongo_orders:
            # 1. 规范化主键与外键 ID
            order_id = str(doc.get("_id"))
            user_id = str(doc.get("user_id") or doc.get("userId") or "")
            tenant_id = str(doc.get("tenant_id") or doc.get("orgId") or "default_tenant")

            if not user_id:
                print(f"⚠️ [跳过脏数据孤岛] 订单 {order_id} 无所属用户")
                continue

            # 2. 规范化金额类型 (消除浮点数精度风险)
            raw_amount = doc.get("amount") or doc.get("amount_cents") or 0
            if isinstance(raw_amount, float):
                amount_cents = int(round(raw_amount * 100))
            else:
                amount_cents = int(raw_amount)

            # 3. 规范化时间戳
            raw_time = doc.get("created_at") or doc.get("createdAt")
            if isinstance(raw_time, (int, float)):
                created_at = datetime.fromtimestamp(raw_time)
            elif isinstance(raw_time, datetime):
                created_at = raw_time
            else:
                created_at = datetime.utcnow()

            # 4. 动态属性打包为 JSONB
            metadata = doc.get("metadata") or {}

            records_to_insert.append((
                order_id, user_id, tenant_id, amount_cents,
                doc.get("status", "PENDING").upper(),
                created_at, psycopg2.extras.Json(metadata)
            ))

            if len(records_to_insert) >= batch_size:
                pg_cursor.executemany(insert_sql, records_to_insert)
                self.pg_conn.commit()
                print(f"✅ 成功同步 {len(records_to_insert)} 条订单记录")
                records_to_insert.clear()

        if records_to_insert:
            pg_cursor.executemany(insert_sql, records_to_insert)
            self.pg_conn.commit()

        pg_cursor.close()
        print("🎉 全量订单历史数据清洗与迁移完毕!")
四、创业选型复盘:数据库选型决策图谱
这次重构历时 6 周,消耗了 2 名核心工程师的全部精力。这次代价沉重的技术债给我们总结出了一条铁律:
                              业务数据选型决策树
                                      │
                   ┌──────────────────┴──────────────────┐
                   ▼                                     ▼
          [核心业务主干数据]                     [非结构化与日志流]
   (账户、权限、订单、账单、多租户)            (系统日志、行为轨迹、监控打点)
                   │                                     │
                   ▼                                     ▼
    【首选: PostgreSQL / MySQL】               【首选: ClickHouse / Mongo】
   - 强 Schema 约束与外键防线                 - 极致写吞吐与灵活 schema
   - 复杂事务 ACID 保证                       - 允许容忍部分字段不规则
   - JSONB 兼顾局部动态扩展需求
不要在架构的核心支柱上投机取巧。 关系型数据库之所以统治行业数十年,是因为企业业务的本质就是“强实体与强关联”。在创业第一天老老实实写好 DDL,才是走向规模化最高效的捷径。


 扫一扫


 523

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


