



 本文介绍了DPDK中与性能密切相关的几个概念:TLB缓存如何加速地址转换,大页如何减少TLB不命中,DDIO如何提升数据传输效率以降低延迟,以及NUMA架构对DPDK的影响和处理策略。
6. TLB和大页
6.1 TLB
如前所说,TLB也是一种cache,用于存放页表项的cache,方便快速完成逻辑地址到物理地址的转换。
6.2 大页
但是一个常规页4k,假设一个程序用了512页,总共2MB,这就需要TLB里至少方下512个页表项才能保证每次都能命中,但TLB大小有限。所以为了减少TLB不命中的情况,可以使用大页,以1G为单位进行分页。
7. DDIO
7.1 提出DDIO的背景/原因
①随着大数据和云计算的爆炸式增长,宽带的普及以及个人终端网络数据的日益提高,对电信服务节点和数据中心的数据交换能力&网络带宽提出了更高的要求;
②数据中心本身对虚拟化功能的需求也增加了网络带宽需求,需要对内部服务器资源进行升级。
7.2 DDIO的目的
①让服务器能更快处理网络接口的数据;
②提高系统整体的吞吐率,降低延迟;
③减少能源的消耗。
7.3 DDIO改进
没有DDIO的情况下,处理一个报文,CPU和网卡需要多次访问内存,而内存又很慢,造成CPU长时间等待内存。
DDIO让外部网卡和cpu通过LLC Cache交换数据,绕过内存。但是报文要存在LLC Cache中,增加了对LLC Cache的容量需求。(*LLC = Last Level Cache)
7.4网卡读写数据数据
发送报文,网卡读数据,从CPU到网卡经过:
CPU ——> cache ——>内存 ——> PCI ——> NIC
CPU把报文写到内存的时候,会触发一次cache不命中,先把内存放到cache中。当CPU写完后,要通知网卡来读内存,但是网卡读的这个内存,刚刚在cache中被修改过,这个对内存的读请求很有可能还要到cache中,让cache把新数据写到内存中,才能被网卡读到。
当有了DDIO之后,cpu要写内存的时候,就已经把对应内存预取到cache中了,cpu可以直接操作cache。而且cache可以直接送到PCI总线上,被网卡读到。
接收报文,网卡写数据:
NIC ——> PCI ——> 内存 ——> cache ——> CPU
NIC要写内存的时候,如果这段内存在cache中,需要等待回写,也就是说当后面CPU要读报文内容的时候,只能从内存里读,因为NIC写内存的时候势必会把内存地址从cache中拿回到内存里。
引入DDIO之后,网卡可以直接把报文写入cache,如果要写入的内存不再cache中,会在写入后把这段内存放到cache中。这样,CPU取数据的时候,就可以直接从cache中拿到了。
8. NUMA
8.1 SMP和NUMA
SMP:
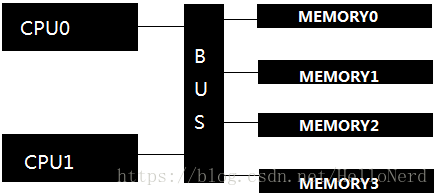
SMP的缺点是:①所有处理器连在一根总线上,负担重,系统总线成为效率瓶颈;②处理器与内存之间通信延迟大。
NUMA:
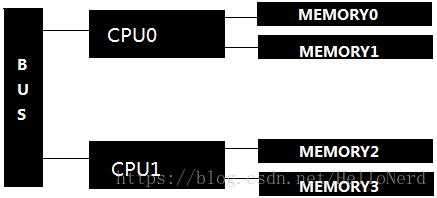
NUMA的优点:本地内存带宽更大,延迟更小;
缺点是访问远程内存效率低下。
8.2 DPDK与NUMA
为了适应NUMA,DPDK代码里做了这些处理:
①Pre-corememory。每个核都有属于自己的内存,经常访问的数据结构有自己的备份。这样既满足了本地内存的需要,又可以避免cache一致性问题。
②本地设备本地处理。如果一个PCI设备在node0上,那这个设备就由Node0处理。比如:
q = rte_zmalloc_socked\t(“fm10k”,sizeof(*q), RTE_CACHE_LINE_SIZE, socket_id);


 扫一扫


 3241

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


