


SST - 语义STEP技术
SST - Semantic STEP Technology
前言
文档定位
本文系统阐述 SST(Semantic STEP Technology,语义 STEP 技术)的核心理念、标准融合策略、技术架构、产品矩阵及开源商业化路径,面向工业软件开发者、企业架构师、数据治理负责人及技术决策者。SST 的底层语义技术具备跨行业通用性,本文以工业领域为首要切入点进行系统阐述。
事实来源
本文涉及的全部关键事实均可在 SST 官方公开渠道核验。技术参数与版本信息以 SST 官方网站及 GitHub 官方仓库发布页为准。
内容导读
全文四章递进展开:
第一章从"标准与数据"的宏观视角切入,剖析工业数据面临的语义鸿沟与标准碎片化困境,阐明 SST 的破局逻辑。
第二章聚焦 SST 技术本身,详解"本体显式化、不依赖推理、封闭世界假设"的设计哲学,以及 SST-Core、SST-Ontologies、SST-EDM 三层产品架构。本章为全书核心,建议全体读者精读。
第三章深入解析 SST-LCI 本体与 ISO 15926 的差异、Core API 与 Repository/Stage 架构、SST-CLI 命令行工具及许可证策略,面向开发者与架构师。
第四章介绍企业概况。
附录另附概念—模块—功能映射表、参考文献及、Go 语言开发示例及命令行参考概要,供技术延伸查阅。
版本与时效
SST 正处于快速迭代期:SST-Core 已演进至 v1.0.1,SST-Ontologies 同步更新,SST-EDM 尚处 MVP 阶段,完整功能版本预计 2026 年底发布。建议读者结合本文档与以下官方渠道获取最新动态:
• SST官网:https://www.semanticstep.com / https://www.semanticstep.cn
• SST-Core 源码:GitHub - semanticstep/sst-core: Semantic STEP Technology Core, a toolkit and database to manage semantic web data for industrial product data based on STEP, ISO 10303 and Life-Cycle Integration, ISO 15926 standards · GitHub
• SST-Ontologies 源码:GitHub - semanticstep/sst-ontologies: Higher level ontologies used by SST-Core · GitHub
• SST-EDM 试用平台:https://edm.semanticstep.net
一、标准与数据:工业智能化的双重驱动
1.1 数据:从信息载体到核心生产要素
数据是客观世界被记录和存储的原始符号,是信息的载体。在计算机科学的语境中,数据是"所有能够输入计算机并被程序处理的符号的总称"。数据本身虽为未经加工的"原材料",但经过处理和分析后,便转化为有意义的信息,进而沉淀为知识,进而支持决策。
进入数字时代,数据已超越单纯的技术概念,成为与劳动、资本、土地、知识、技术并列的新型生产要素。据《数据要素发展报告(2025年)》统计,2024年全国数据生产总量达41.06泽字节(ZB),同比增长25%。数据不仅规模庞大,其价值更呈递进式释放:在业务贯通层面,支撑业务系统运转;在数智驱动层面,通过数据复用优化决策;在跨主体流通层面,赋能多方协作实现价值再创造。
特别是在工业领域,数据贯穿产品从设计、工艺、制造到运维、报废的全生命周期。消费平台上的行为数据、产业互联网上的人机物数据、无人驾驶汽车的感知数据——这些原始数据伴随生产活动同步产生,构成了工业智能化的基础资源。然而,数据的价值并非孤立存在,其释放深度取决于数据关系的挖掘与语义清晰程度。只有当数据被赋予明确的语义、在统一的标准下被组织、在可信的架构中被流通,其潜在价值才能从不可互操作的数据记录转化为可流通的生产要素。
1.2 标准:产业协同与国际竞争的通用语言
数据是工业智能化的基础资源,标准则决定其流通效率与价值转化能力。标准是社会、经济和技术发展的基石,它通过统一技术规范、保障产品质量、提升协作效率、推动持续创新,确保市场秩序和国家竞争力。在工业生产中,统一零部件规格便于大规模生产和组装;在质量管控中,标准明确产品和服务的准则及检验方法;在跨组织协作中,标准提供共同语言和技术依据,使不同企业、部门乃至国家能够顺利沟通和配合。
国际标准的作用更为深远。作为国际贸易的技术协调基础与质量仲裁依据,国际标准为进出口商品质量提供统一依据,减少因技术标准差异导致的技术壁垒,促进贸易自由化。在全球产业竞争格局深刻变革的今天,标准制定权已成为大国科技与经济博弈的核心战场。中国正加速从"国际标准应用者"向"全球规则制定者"转型,在人工智能、绿色低碳、智能制造等前沿领域持续贡献中国方案。
对于工业产品数据而言,标准的重要性尤为突出。从ISO 10303(STEP)到ISO 15926,从IEC 61360到ISO/IEC 81346,这些国际标准构建了工业产品数据交换与管理的知识骨架。没有标准,设计部门的意图无法在制造端准确复现;没有标准,跨企业的质量追溯将沦为"人工翻译"的迷宫;没有标准,AI对工业数据的理解便缺乏统一的语义规则与术语定义。
1.3 工业数据的深层困境:标准不能在数字化过程中落地与语义鸿沟
然而,在工业数据领域,"标准"与"数据"的长期分离造成了深层次的结构性矛盾。
一方面,呈现工业数据标准不能在数字化过程中落地的碎片化格局:W3C语义网标准面向开放世界设计,缺乏工业场景所需的确定性;ISO 15926提供了全生命周期4D框架,但其OWL实现包含大量高度抽象概念,工程落地价值存疑;ISO 10303(STEP)是工业产品数据交换的事实标准,几何表示强大,但PDM/PLM领域语义基础薄弱,内部AIM/MIM/ARM多模型映射复杂。
另一方面,工业数据管理面临三类障碍:数据割裂/碎片化——设计、制造、运维各环节系统繁多,模型不通、协同低效;如何把标准应用到数字化活动当中——工业数据标准不协调,转换导致语义和数据丢失,AI应用难以规模化落地;数据自主——核心数据困于专有格式,面临技术生态锁定与迁移成本风险。
传统解决方案只能在标准之上做格式转换,转换会语义丢失,形成沉重的"语义债务"。设计部门的意图在传递到制造端时会丢失,DFMEA识别的风险无法关联到PFMEA的控制措施,质量闭环难以形成。这种行业困境,根源在于数据缺乏统一的语义基础设施——数据虽被记录,但"这个符号到底指什么、在什么上下文中成立"并未被机器理解。
1.4 SST 的解决路径是:以语义技术融合标准与数据
要解决上述问题,需建立一套融合标准语义与数据实例的技术基础设施:它需同时满足多重要求:继承国际标准的权威性,具备语义网技术的形式化能力,使机器能够直接理解工业数据,并确保跨阶段、跨系统的数据完整流转与来源追溯。
语义STEP技术(SST, Semantic STEP Technology)正是面向这一需求而诞生。SST不是凭空发明一套新的语义体系,而是将制造业中已有的标准语义——包括ISO 15926(生命周期数据集成)、ISO 10303(STEP,产品数据交换)、ISO/IEC 81346(参考命名系统)、IEC 61360(通用数据字典)等——用本体(Ontology)进行显式、形式化且可共享的表达,构建单一集成数据模型。通过W3C语义网标准(RDF/S、OWL 2)作为统一语法基础,SST让工业数据实现机器可直接理解的语义表达,消除格式转换中的语义损耗,实现全生命周期数据贯通。
作为新一代工业数据技术基础设施,SST以"不依赖推理、显式声明"的设计哲学确保数据的确定性与高性能,以Git式修订控制实现工业数据的版本化协同,以云原生架构支撑分布式设备集群的统一管理。它既是国际工业标准在数字时代的语义化延伸,也是工业数据要素价值释放的核心基础设施。
从国内产业实践看,SST 的架构与 GB/T 35119-2017《产品生命周期数据管理规范》所定义的产品全生命周期管理框架高度契合。该标准将产品生命周期管理定义为"采用一系列应用系统,为产品生命周期内企业内或企业间的产品及其过程信息协同产生、管理、分发和使用的应用解决方案",覆盖"概念—设计—采购—生产—销售—售后服务"全过程,并提出了由生命周期维、应用领域维和视图维度构成的三维模型空间,以及产品视图、过程视图、组织视图、资源视图和数据视图五类视图的集成方法。SST 通过 ISO 15926 实现生命周期维的 4D 时空建模,通过 STEP/ISO 10303 覆盖设计/工艺/制造/维护/质量等应用领域,通过 SST-Ontologies 的单一集成数据模型同时支撑产品视图(结构/BOM)、过程视图(工艺/变更)、组织视图(人员/权限)、资源视图(量与单位/参考数据)和数据视图(RDF 三元组/NamedGraph),形成与国际标准及国内 PLM 标准双向对齐的技术基础设施。
二、SST:语义STEP技术
2.1 理解SST的核心概念:本体与语义
2.1.1 什么是语义?
语义解决的是一个朴素的问题:这个符号到底指什么?在什么上下文中成立?
例如,在工业系统中看到"product_id = A-2026-001"——如果你不懂业务,它只是一行字符;但如果你了解这个系统,你知道它指向一个真实的产品,有特定的规格、工艺路线和质量记录。
语义有三个层次:
符号层:字段名、标签、标识符本身。product_id、CustNo、工艺编号——它们只是符号,本身没有意义。
指代层:符号指向了现实世界中的某个对象。product_id = A-2026-001指向了"某型号电路板这个产品"。
解释层:不仅知道"指向谁",还知道"怎么理解和使用这个指向"。例如:该产品的生命周期规则是什么?它可以和其他概念发生什么关系?一个产品可以对应多个工艺,但一个工艺只能属于一个产品。
解释层才是语义真正的内核。在制造业中,语义无处不在——每个系统、每个部门、每个人都有自己对"产品""工艺""质量"的理解。但这些语义通常是隐性的、碎片化的、不一致的,藏在代码注释里、Excel表格里、交接文档里。这种不一致导致数据不一致、合规困难、系统对接失败的问题——这就是语义债务。
2.1.2 什么是本体?
人类日常沟通依赖一种隐性共识:当提及"苹果"时,对话双方默认指向水果而非电子产品;当说"红灯停"时,无需查阅法规即可理解其含义。这种共识来源于共享的语言习惯与语境,但它存在于人的认知中,具有模糊性与个体差异。
工业标准将这种隐性共识转化为显性规则——例如规定螺丝直径精确到毫米、交通信号灯的色度与周期——但标准文档本质上是供人阅读的自然语言文本。本体(Ontology)则更进一步:它将显性规则转化为机器可直接解析的形式化知识框架,明确界定某一领域内存在哪些实体、如何命名、具备何种特征、实体间如何关联、关联数量受到何种约束。计算机不具备"心领神会"的能力,本体即为其提供可执行的概念字典与关系语法。
从信息科学的严格定义来看,本体是指对一个领域内的概念体系进行显式的、形式化的规约。
显式:不能仅停留于认知层面,必须显式、可视化地记录,供所有人共享。
形式化:要用结构化的方式表达——类、属性、关系、约束、公理。
规约:是群体的共识,大家同意按照这套规则来理解和表达。
2.1.3 语义与本体:SST的底层逻辑
语义是意义本身。本体是把意义系统化、显性化、可共享的建制。
没有语义,本体就是空洞的形式主义;缺乏本体,语义便无法统一——个体理解各异、沟通反复错位、系统集成伴随持续的语义损耗。
三个行业类比:阐释语义与本体的关系
场景一:汽车售后维修
在维修场景中,技师对同一零部件的表述往往不一致——有人称之为"节温器",有人称之为"温控开关",亦有简写为"水阀"者。更为严重的是,整车厂的电子零件目录(EPC)中该部件具有唯一标准编号(如 Thermostat, 11537549476),而独立维修厂通常不存在此编码体系。
本体的作用相当于整车厂发布的全球统一维修手册:为每个零部件赋予唯一的标准名称与零件号(Vocabulary);将整车按系统逐层拆解为汽车 → 发动机 → 冷却系统 → 节温器(Breakdown);规定装配时必须对准标记、必须涂覆防卡剂(Axioms);明确一台四缸发动机必须有且仅有四个火花塞(Cardinality Restrictions)。
在此规范下,全球各授权服务网点的维修工单、零件采购单与保修索赔单方可实现跨店、跨国对齐。若缺乏此规范,则"更换了控制冷热的开关"这类描述虽可完成实际维修(数据并非无效),但无法进入系统追溯质保、无法统计故障率——其可用性将显著降低。
场景二:工程机械维保
维修场景中"元件"一词含义模糊——师傅口中的电路板零件,在系统中可能对应程序模块。若制定《工程机械维保规范》,严格区分硬件零部件与软件程序,并统一拆解、报修、采购的数据标准,则工厂、维修站与供应商方可协同;否则记录虽可填写,但三方数据无法互通。
场景三:PCB精密加工
产线上"盲孔"一词在不同工序指向不同结构——钻孔工序的机械盲孔、激光工序的激光盲孔、电镀工序的金属化盲孔,工艺参数各异却名称相同,极易混淆。若建立《PCB制造全流程语义规范》,区分三类盲孔语义、定义拆解单元并设定堆叠规则,设计、数据处理、制造与质量部门才能统一执行;否则设计意图将在传递中丢失,DFMEA 风险无法关联至 PFMEA 控制措施,质量闭环难以形成。
映射到 SST:
上述三类场景在制造业中对应同一问题:语义理解依赖个人经验与局部默契,缺乏跨系统、跨组织的统一规范。SST-Ontologies 的作用即在于此——它将 ISO 15926(生命周期数据集成)、ISO 10303(STEP)、ISO/IEC 81346 等国际标准整合为单一集成数据模型,通过显式公理定义概念、关联与约束,使机器能够直接理解和处理工业产品数据。若无此语义规范,老员工凭经验仍可工作,但系统集成、AI 应用与跨企业协作将难以推进。
跨行业映射示例
为便于非制造业背景读者建立直观认知,以下列举三个跨行业参照:
图书馆分类体系:图书馆学中的《中国图书馆分类法》将知识划分为大类(哲学、自然科学等),并逐层细分(自然科学 → 化学 → 有机化学)。每册文献必须赋予唯一的主分类号,且分类之间存在明确的从属关系(如"有机化学"属于"化学")。该体系即为本体的雏形:先建立知识地图(本体),再为每册文献编目(数据)。缺乏此地图,馆藏将退化为无法检索的随机堆放。
医院科室与诊疗规范:临床医学将疾病划分为大类(内科、外科等),再细分为专科(内科 → 心血管内科 → 冠心病),同时规定硬性诊疗规则——胸痛患者必须先做心电图以排除急性心肌梗死;一张处方必须有且仅有一个主诊断。该体系即医疗领域的本体映射:科室对应 Classes,疾病细分对应 Subclasses / Breakdown,诊疗规范对应 Axioms,病历格式对应 Schema。
在线旅游平台(OTA):在 OTA(在线旅行社)平台上,同一房源在不同渠道的表述往往五花八门——A 平台称之为"豪华海景大床房",B 平台称之为"Deluxe Ocean View King",C 平台仅标注为"海景房"。更棘手的是,各平台对"含早"的定义不一:有的指自助早餐,有的仅提供简餐;取消政策中"免费取消"的截止时间也各有不同——入住前 24 小时、48 小时或 72 小时不等。本体的作用相当于一套全球酒店业统一数据规范:为房型赋予标准编码(Vocabulary);将物理资产逐层拆解为酒店 → 楼层 → 房型 → 具体房间(Breakdown);规定"海景房"必须满足距海岸线直线距离不超过 500 米且视野无遮挡(Axioms);明确一间标准客房最多容纳 2 名成人加 1 名儿童(Cardinality Restrictions)。在此规范下,携程、Booking、Airbnb 等平台的房源信息、价格策略与用户评价方可实现跨平台对齐,AI 推荐引擎亦能基于统一语义精准匹配用户需求。若缺乏此规范,则"适合家庭入住的带景观的大房间"这类描述虽可完成预订(数据并非无效),但无法支持跨平台比价、无法驱动智能推荐、无法实现供应链自动对接——其数据价值将大幅折损。
映射回 SST:工业数据管理同样需要"图书分类法""科室规范"与"酒店数据标准"——明确数据归属何类、类间如何关联、必须满足何种硬性规则,否则系统将产生"误诊"式或"超售"式的数据错误。SST-Ontologies 的作用即在于此:它将 ISO 15926、STEP、ISO/IEC 81346 等标准中的概念通过 OWL/RDF 进行显式、形式化表达,使机器能够直接理解和处理工业产品数据。若无此语义规范,老员工凭经验仍可工作,但系统集成、AI 应用与跨企业协作将难以推进。
2.1.4 制造业语义债务困境与SST破局方向
如第一章所述,工业数据管理面临的三类障碍——数据割裂、如何把标准应用到数字化活动当中与数据自主——根源在于底层语义不通。这使数字孪生、预测性维护与AI决策难以深化,企业错失转型先机。
SST 的设计目标正是破解这一困境:通过语义 STEP 技术,将 ISO 15926、STEP、ISO/IEC 81346、IEC 61360 等制造业既有标准语义用本体显式化、形式化、可共享化,让机器直接理解工业产品数据,实现从"人读"到"机读"的语义跨越,为工业数据的互联互通与智能化升级提供确定性基础设施。
2.2 SST 技术定位
SST(Semantic STEP Technology,语义STEP技术)——新一代工业数据技术基础设施,由德中股东Lothar Klein领导中国团队,援用现有标准,系统性、原创性推出。SST作为面向工业领域的数据基础设施,用于开发Web服务及其他应用程序,聚焦于各类工业产品数据,涵盖产品的设计、生产、维护和使用。SST基于W3C语义网标准构建,针对云计算环境进行性能优化,其技术内核SST-Core采用Go语言实现。SST遵循2.6节阐述的设计哲学——不依赖推理、显式声明——确保数据的确定性与高性能。
SST的定位:SST 并未新建语义体系,而是将制造业中已有的标准语义(ISO标准、行业规范、企业经验)用本体(OWL/RDF)进行显式、形式化且可共享的表达。SST-Ontologies 就是这套语义规范,将ISO 15926、STEP(ISO 10303)、ISO/IEC 81346等国际标准整合为如2.5节所述的单一集成数据模型,让机器(而不仅仅是人)能够理解和处理工业产品数据。
SST 将 W3C Web 标准与 ISO 等一系列工业标准进行最优整合。SST 中的所有应用数据在内部均采用 W3C 定义的语义 Web 技术进行存储,因此 SST 数据对其创建者始终完整可用,并可随时在互联网上与他人共享。实现了产品数据以柔性、高效、精简、分类清晰的,严格无损、一致、可追溯的,中性且跨生命周期、跨系统的交换、集成、存储。
与传统架构 PLM/PDM 及通用图数据库的对比
为便于技术决策者理解 SST 的差异化定位,以下从六个维度进行简要对比。需要说明的是,本表比较的是典型技术架构特征,不构成对特定厂商或产品版本的完整评价;不同 PLM/PDM 产品在 AI 能力、开放性、版本控制等方面的实现存在差异。
| 维度 | 传统架构 PLM/PDM | 通用图数据库 | SST |
| 语义基础 | 多以文件或关系型数据库为核心,领域语义通常分散在数据模型、代码与配置中 | 通常不内置面向工业产品数据的语义模型,需自行建模 | 基于 ISO 15926、ISO 10303(STEP)等标准构建本体,语义显式化、机器可读 |
| 标准兼容 | 通常支持 STEP 等格式导入/导出;当内部模型与 STEP 标准模型存在差异时,转换可能带来语义映射成本或信息损耗 | 通常不原生支持特定工业标准,需要自行定义数据模型及映射规则 | 以 STEP、ISO 15926 等标准语义为内核,通过单一集成数据模型降低多模型映射成本 |
| 推理机制 | 业务规则多由应用层代码或配置实现,深度定制后的扩展与版本演进成本通常较高 | 主要依靠图遍历、查询语言或外部推理组件,语义规则需自行建设 | 采用封闭世界假设和显式声明,不依赖通用 OWL 推理,强调语义确定性与工程可实施性 |
| 版本控制 | 多采用文件版本、对象版本或数据库事务机制;语义级差异比对和跨分支合并能力因产品而异 | 通常依赖外部版本管理工具,或由应用层自行实现版本控制 | 内置 Commit、Branch、Diff、Merge 等 Git 式修订控制能力,作用于 RDF 命名图和数据集 |
| AI 交互 | 以界面操作和 API 查询为主;AI 助手与自然语言交互能力因厂商、产品版本及部署方案而异 | 需由应用方自行接入大模型或开发自然语言接口 | SST-Core v1.0.1 提供 MCP Server,支持 document tools 及 Dataset/Stage 操作,可为支持 MCP 的 AI 应用提供标准化数据访问入口 |
| 数据自主 | 部分系统采用专有数据模型或私有存储格式,深度定制后迁移和二次开发成本可能较高 | 数据库本身可能开源,但工业语义模型和数据治理规则通常需自行构建 | 本体以 MIT 许可发布,核心软件采用商业许可与 PolyForm 非商用许可并行模式;语义数据基于 RDF/Turtle 等开放标准表达,有助于降低生态锁定风险 |
简言之,从架构侧重点看,传统 PLM/PDM 更侧重解决"数据存哪里、流程如何管"的问题,通用图数据库更侧重解决"数据如何关联"的问题,而 SST 的重点在于解决"数据意味着什么、如何让机器直接理解"的问题。
AI 集成优化:SST-Ontologies 通过单一集成数据模型为 AI 技术提供结构化数据基础;SST-Core 通过 MCP Server 实现 AI 原生交互。
发布信息:2026年4月27日,德中技术与德国SST有限责任公司联合发布 SST-Core v1.0.0;2026年7月20日,发布 SST-Core v1.0.1,带来 Dataset/Branch API 增强、AccessMode RBAC 权限控制、MCP Server 落地、STEP P21 Converter 改进等重大更新。以双重许可模式(商业许可 + PolyForm Noncommercial 1.0.0)提供软件。源代码已发布于 https://github.com/semanticstep/sst-core 。2026年7月25日,基于 SST-Core 的终端应用平台 SST-EDM MVP 已发布供公开试用,首要支持基于 ISO/IEC 81346 的分解结构管理。
2.3 SST 核心能力
基于上述技术定位,SST 为工业数据管理提供四项核心能力:
统一工业数据语义表达:基于 ISO 15926、STEP(ISO 10303)、ISO/IEC 81346 等国际标准,使 CAD、CAM、PDM、PLM、ERP、MBSE 等异构系统基于同一语义模型交换数据,消除数据割裂/碎片化效应。如2.5节所述,SST-Ontologies 的单一集成数据模型同时覆盖 PLM 标准框架下的五类核心视图——产品视图(结构/BOM)、过程视图(工艺/变更)、组织视图(人员/权限)、资源视图(量与单位/参考数据)与数据视图(RDF 三元组/NamedGraph)——实现跨视图语义关联。
贯通产品全生命周期数据:覆盖产品设计 → 工艺 → 制造 → 运维 → 报废全流程数据,实现跨阶段、跨系统的数据完整流转与来源追溯。
实现机器可读与可理解:数据自带语义逻辑关系,支持跨系统自动关联与知识沉淀,遵循2.6节所述设计哲学获得确定性。
轻量化云原生与数字孪生支撑:基于 Go 语言与 W3C 语义网标准构建,适配互联网与云平台,支持分布式协同与 AI 原生交互(MCP Server)。
SST 的本质是一种基于国际标准的开放数据语义技术底座,支持异构系统之间高效、可靠的数据流动和语义互操作,消除数据碎片化效应、把标准软件化、实现自主可控。
2.4 核心技术架构:三大标准系列的独特组合
SST 数据建模的基础是三大标准系列的独特组合:
| 标准系列 | 作用 |
| 语义网技术(RDF/S, XSD, OWL等) | 提供数据的形式化表示与机器可理解的语义基础 |
| ISO 15926 (LCI) | 生命周期数据集成的概念框架,提供4D(时空)建模能力 |
| ISO 10303(STEP) | 工业产品数据标准,广泛支持 CAD 系统;涵盖几何、PDM、公差等多部分,重点关注 STEP AP242 应用协议 |
SST 采用"取其精华、去其繁复"的策略:
仅使用ISO 15926-12中约50%的最基础概念,更高级的概念被更简单、更直接可用的概念取代
STEP中关于表示的部分(几何、拓扑、运动学等)被SST直接或仅经最小改动采纳
STEP中PDM和PLM领域的部分被ISO 15926概念或由此衍生的概念取代
此外,SST整合以下标准以覆盖更广泛的数据建模需求:
- ISO/IEC 80000:量与单位
- ISO 13584:零件库
- IEC 61360:通用数据字典(CDD)
- ISO 13399:切削刀具
- eClass:工业分类标准
- ISO/IEC 81346:参考命名系统(RDS)
- ASD S3000L:后勤支持分析(LSA)
2.5 核心价值:单一集成数据模型
SST提供高层本体,把多种标准的数据模型构建为单一集成数据模型(single integrated data model),解决不同标准间兼容性的难题。
这与STEP/ISO 10303不同,后者定义了多个相互映射的独立数据模型(AIM/MIM、ARM、核心模型、域模型)。SST本体通过将不同标准的概念整合到单一集成数据模型中,弥合了这些标准之间的主要不兼容性。
2.6 设计哲学:不依赖推理,显式声明
SST在OWL的使用上做出了一个关键的设计决策:不依赖推理(reasoning)。OWL最初被设计用于支持对RDF数据的逻辑推理,但这种推理可能耗费大量时间和内存。SST不依赖推理;相反,它要求显式陈述所需的基础信息,以便直接利用所提供的数据。
这一决策带来三大优势:
高性能:避免了推理带来的计算开销
确定性:数据的含义完全由显式声明决定,具有确定性
工程化友好:与 SST API 的 Early/Late Binding 双模式结合,应用程序开发更加直接
这一设计哲学与第3.1节讨论的语义与本体关系直接相关:语义是目标,本体是手段。SST选择不依赖推理,是因为推理(reasoning)试图从已有数据中"推导"出隐含的语义,这在开放世界假设【OWL 基于开放世界假设(OWA),而 SST 采用封闭世界假设(CWA)】下可能耗费大量时间且结果不确定。而SST选择显式声明——要求数据的创建者把语义说清楚、写明白,要求数据的创建者显式声明(explicitly state)所需的基础信息——这正是一个成熟本体应有的姿态:不依赖推理,只表达显式声明的共识。
2.7 SST 产品结构
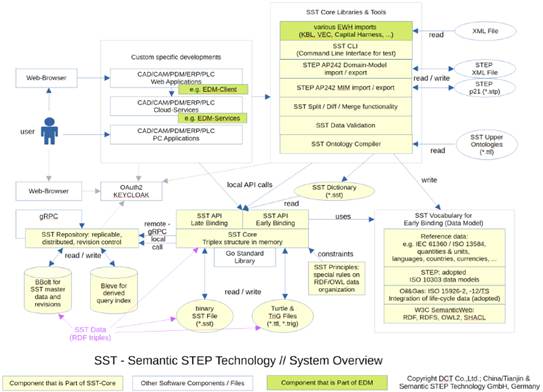
下图展示了 SST 从底层存储到上层应用的完整技术架构:
2.7.1 SST-Core:高性能语义引擎
SST-Core:SST 的技术内核,是基于 W3C 语义网核心技术标准(RDF/S, XSD, OWL 2 等)构建的 Go 语言 API / 库,原生支持 Turtle、TriG 等 RDF 序列化格式。面向软件开发者及企业级应用,通过整合 STEP/ISO 10303 与 ISO 15926 等工业标准的高层本体,为 CAD, CAM, PDM, PLM, ERP, LSA 及其他 CAx 系统提供高性能的工业产品语义数据管理工具包与数据库。
SST-Core 提升 RDF/S、OWL、Turtle 和 TriG 等语义网标准的云计算效率,支持各种 Web 应用,并自带 Git 式修订控制功能,支持分布式存储与历史追溯。
SST API:完全使用 Go 语言编写,支持 Late Binding(通用SST API)和 Early Binding(SST Ontology Compiler生成Go结构体)两种编程模式。
Triplex 三向结构:内存中特殊数据结构,支持从主语、谓语、宾语三个方向高速遍历 RDF 图,区别于仅支持单向或双向的通用RDF工具。
SST Repository:BBolt(主数据持久化)+ Bleve(Lucene式全文检索)+ Document Vault(非RDF文档存储),支持本地与远程部署。
Git 式修订控制:支持提交(Commit)、分支(Branch)、差异比对(Diff)和合并(Merge),支持独立开发后的合并,实现 RDF 数据的协同工作。
SST Ontology Compiler:将 SST-Ontologies 编译为支持 Early Binding 的 Go 语言结构体,简化应用程序开发。
SST-CLI:用于调试和测试 SST-Core 及仓库的命令行界面工具,类似 Git 操作方式。
examples 模块:提供典型使用示例与测试用例。
运行环境要求:SST-Core v1.0.1使用 Go 1.25.0 构建;SST-Ontologies 要求 Go 1.22 或更高版本。
SST-Core 主要组件
| 组件 | 说明 |
| SST Ontology Compiler | 将 SST-Ontologies 编译为支持 Early Binding 的 Go 语言结构体,特别适用于转换器(Converter)与图形用户界面(GUI)开发 |
| SST API / Library | 面向 Go 语言后端开发者的语义网引擎,支持 OWL 2(及 RDF、RDFS)。内置 Triplex 结构允许从主语、谓语或宾语任意方向快速遍历 RDF 图 |
| SST Repository (Master Data) | SST Repository (主数据) | BBolt 嵌入式键值数据库,存储 NamedGraph 及 Git 式修订控制 |
| SST Repository (Index) | SST Repository (索引) | Bleve 全文检索引擎,v1.0.1 重构为异步索引更新 |
| SST Repository (Sync & Access) | SST Repository (同步) | 支持远程仓库同步、配额管理、RBAC 访问控制 |
| SST-CLI | 用于调试和测试 SST-Core 及仓库的命令行界面工具,类似 Git 操作方式;亦可执行 SST 应用程序尚未支持的特定功能。v1.0.1 新增:命令注册表(command registry)、remote-to-remote 同步支持 |
| SST Converter | 转换器组件框架,已落地 STEP P21 Converter 子组件(v1.0.1 重大改进),其他格式转换器持续扩展中 |
| SST Validation(v1.0.1 增强) | 数据验证引擎,支持 ValidateAll(带 reference Stage 对比验证)、Validate 默认全类型检查;改进 rdf:type 主类校验;修复空白节点异常 panic |
| SST Serialization(v1.0.1 增强) | 序列化引擎优化:TriG 空白节点标签唯一性与输出排序;TriG 不再输出 owl:imports;TTL 格式化改进;支持 literal collection 中的 rdfFirst 处理;tilde-escape 往返测试 |
| SST-MCP Server(v1.0.1 新增) | Model Context Protocol(MCP)服务器实现,支持 document tools 及 Dataset/Stage 操作,为上层应用(包括 SST-EDM)提供 AI 原生交互能力。 |
数据类型映射
SST-Core 支持以下核心数据类型与 Go 语言的映射:
| SST 数据类型 | Go 类型 |
| xsd:string | string |
| rdf:langString | TypedString struct { Val string; Type Node } |
| xsd:boolean | bool |
| xsd:decimal | string(字符串表示) |
| xsd:integer | int64 |
| xsd:double | float64 |
| xsd:float | float32 |
| xsd:dateTime / xsd:dateTimeStamp | string |
| xsd:byte | int8 |
| xsd:short | int16 |
| xsd:int | int32 |
| xsd:long | int64 |
| xsd:unsignedByte | uint8 |
| xsd:unsignedShort | uint16 |
| xsd:unsignedInt | uint32 |
| xsd:unsignedLong | uint64 |
Triplex 三向结构详解
Triplex 是 SST-Core 在内存中的特殊数据结构,支持从三个方向高速遍历 RDF 图:
单向(Uni-Directional):从主语出发,遍历谓语和宾语。这是大多数通用 RDF 工具的默认能力。
双向(Bi-Directional):在单向基础上,增加从宾语节点反向遍历谓语和主语的能力。部分工具仅通过查询操作支持。
三向(Tri-Directional):在双向基础上,增加从谓语出发遍历主语和宾语的能力。这对 SST 至关重要,因为工业数据中存在大量带有附加属性的复杂关系(如装配关系附带形状表示信息、几何变换操作等),三向遍历使这类复杂语义关系可被高效分析,无需依赖耗时的逻辑推理。
技术约束:SST-Core 不是通用 RDF 工具包——引入特定限制以实现高性能,SST-Core 生成的 RDF 符合 W3C 标准,但并非所有 RDF 文件都能导入。
STEP P21 Converter(v1.0.1 重大改进):
- 九轮增量改进,支持 Bosch .stp 导入修复
- 新增 raw parse export 与语义转换优化
- Ontology-driven STEP 实体映射
- 规范化语义 STEP 关系输出
- 移除冗余 uncertainty quantity type
- 新增 PMI 分析能力:追踪 PartDesign PMI 图关系
2.7.2 SST-Ontologies:本体
SST-Ontologies:基于工业标准构建的高层语义本体库,是 SST-Core 的语义建模基础。它将 ISO 15926、STEP(ISO 10303)、ISO/IEC 81346 等国际标准中的建模概念整合为单一集成数据模型,弥合不同标准间的差异,为工业产品数据提供机器可理解的知识骨架。
高层本体库源代码发布于 https://github.com/semanticstep/sst-ontologies。
| 名称 | 核心标准 | 本体文件 | 核心能力 |
| 基础语义 | RDF, RDFS, XML Schema | rdf, rdfs, xsd | 三元组图结构基础;数据类型约束 |
| 知识组织与约束 | SKOS, SHACL | skos, sh | 概念层级组织;数据形状约束(本体已定义,基础验证引擎已落地,完整形状约束检查持续完善中) |
| OWL 2 逻辑与 SST 元框架 | OWL 2 (owl:imports) | owl, ssmeta | owl:W3C OWL 2 标准词汇(类、属性、约束、继承、等价关系),提供统一逻辑表达基础;ssmeta:SST 元概念框架(ConnotationalClass / OptionClass),定义 STEP 实体映射规则(stepImEntityMap / stepImMapAttributeOrder) |
| LCI 本体 | ISO 15926 | lci | 全生命周期4D概念框架(时间、空间、演化) |
| 几何与表示 | ISO 10303-43(主);另覆盖 -41、-42、-45、-46、-101、-108;v1.0.1 扩展覆盖 -47 (-47 由 sso 本体覆盖)及 -113;-105、-109 处于规划阶段(尚未覆盖), mechanical_design_schema 与 sso 本体协同 | rep | 几何/拓扑/运动学、视觉呈现/制图、测量表示项、整数表示项、布尔列表、机械设计,v1.0.1 扩展:新增 ISO 10303-46 Visual presentation 完整 schema 覆盖(presentation_organization_schema、presentation_definition_schema、presentation_appearance_schema、presentation_resource_schema);新增 ISO 10303-101 draughting_element_schema;新增 ISO 10303-113 mechanical_design_schema(与 sso 本体协同);新增 rep:MeasureRepresentationItem(作为 ssmeta:OptionClass,与 qau 子类型配合使用)、rep:IntegerRepresentationItem、rep:ListOfBoolean;将 rep:GeometricRepresentation 定义为 ssmeta:ConnotationalClass(该概念在 STEP IR/MIM 中不存在);修复 rep:BSplineSurfaceWithKnots;扩展 ssmeta:stepImEntityMap 与 ssmeta:stepImMapAttributeOrder 的 RDF 实体定义 |
| PDM、公差、参考代号与产品属性 | ISO 10303-41(PDM 相关 schema), -44, -47, AP242, ISO/IEC 81346 | sso | PDM模型、Breakdown/BreakdownOccurrence 结构、81346 参考代号进一步特化、公差/尺寸/基准(GeometricTolerance, DatumSystem, Datum, DatumFeature 等),v1.0.1 扩展:新增 sso:Breakdown 及 aspect specific subtypes 用于表示顶层节点,与 sso:BreakdownOccurrence 节点(带参考代号的节点)分离;移除 sso:refDes81346_12_top_node_domains(非 refDes);新增 refDes81346 针对其他未覆盖 81346 ClassSystems 的进一步特化;新增 ISO 10303-47 shape_tolerance_schemas 与 shape_dimension_schema,涵盖sso:DimensionalLocation、sso:DimensionalSize及其子类型和相关对象;新增 ISO 10303-113 mechanical_design_schema(与 rep 本体协同);将 property_definition_representation、item_identified_representation_usage 及其子类型从 rep 本体迁移至 sso 本体 |
| 量与单位 | ISO 80000 | qau | 量与单位(替代 ISO 10303-41 measure_schema;新增 PropagationCoefficient) |
| 参考数据 | — | countrycodes, currencycodes, color | 国家代码、货币代码、颜色代码标准化(跨行业通用属性枚举值) |
| 应用数据实例 | 电气/电子数据(Schematic Diagrams,原理图) | eed | 原理图、工程数据管理 |
注:lci、sso、rep 等本体在 v1.0.0 发布时为基础版本,v1.0.1 已大幅扩展完善。
SST-Ontologies 目前共包含 15 个本体文件,版本 v1.0.1,按字母顺序完整清单如下:
color(颜色本体)、countrycodes(国家代码本体)、currencycodes(货币代码本体)、eed(电气/电子数据本体)、lci(生命周期集成本体)、owl(OWL本体定义)、qau(量与单位本体)、rdf(RDF本体定义)、rdfs(RDFS本体定义)、rep(表示本体)、sh(SHACL本体定义)、skos(SKOS本体定义)、ssmeta(SST元本体)、sso(语义STEP本体)、xsd(XML Schema数据类型定义)。
v1.0.1 编译器增强:
- 新增 circular subClassOf 循环检测,防止无限递归
- 引入 reasoner 解决 union 问题
- 词汇表重新编译
- 将编译器中非必需的文件迁移至本体模块
- v1.0.1 编译器适配:编译器与 P21 转换器适配新本体结构
2.7.3 SST-EDM:工程数据管理应用平台
SST-EDM(Engineering Data Management):面向终端用户的工程数据管理 Web 应用,基于底层 SST 核心功能构建,围绕 CAD、CAM、ERP、PDM 数据管理。首要应用基于 ISO/IEC 81346 RDS 的分解结构;电气线束设计(EWH)——将支持 KBL/VEC/Capital Harness 等既有行业格式导入,并直接支持基于 STEP AP242 的数据交换。
当前状态:2026年7月25日,SST-EDM MVP(Minimum Viable Product)已发布供公开试用(public access),访问地址 https://edm.semanticstep.net。MVP 阶段仅覆盖核心功能,完整能力持续迭代中,预计2026年底推出完整功能版本。
SST-EDM 采用 Web 应用架构,提供直观的图形化界面。用户可通过左侧导航栏访问总览(All)、分解结构(Breakdown Systems)、通用零件(General Parts)、产品族(Product Families)、组织(Organizations)、分类系统(Class Systems)、模板(Templates)、人员(Person)、物理个体(Physical Individual)、文档(Document)、导入(Import)、关于(About)等模块。右侧视图支持主视图(Main)、属性编辑(Property)、分解结构浏览(Breakdown Occurrence Trees)、Turtle 源码查看及 CSV 导出(Download CSV)功能。
SST-EDM MVP 已发布功能
- 使用 ISO/IEC 81346 参考命名系统的分解结构管理
- 类和关联属性的分类系统
- 支持通用 PDM 能力:零件、产品族、组织、模板、人员、活动、文档等
开发中功能
- 电气线束设计(EWH)——将支持 KBL/VEC/Capital Harness 等既有行业格式导入,并直接支持基于 STEP AP242(ISO 10303-242:2025)的数据交换
- 其他应用领域(Other application areas to follow)
2.8 SST 技术特点总结
| 特点 | 说明 |
| 三大标准系列独特组合 | 以 W3C 语义网为统一语法层;ISO 15926 取精弃冗(仅保留 50% 核心概念),替代 STEP 的 PDM/PLM 语义层;STEP 表示层(几何/拓扑/运动学)直接采纳。整合 IEC 61360/81346 等,形成覆盖工业数据全维度的单一语义底座。 |
| 单一集成数据模型 | 15 个本体文件(v1.0.1)构建统一高层语义库,将多标准概念整合为单一层级数据模型,消除 AIM/MIM/ARM 多模型映射的语义衰减与维护成本。 |
| 属性作为一等公民 | 事物特征直接以 RDF 属性表达个体,而非定义"具有相同属性值的类";应用数据仅复用上层本体已定义属性,保证模型统一性,避免属性层面的冗余与碎片化。 |
| 不依赖推理 | 采用封闭世界假设(CWA)+ 显式声明:要求数据创建者显式陈述全部基础信息(如 rdf:type),数据含义完全由显式声明决定,杜绝推理带来的不确定性与性能开销。 |
| Triplex 三向结构 | 主/谓/宾三向遍历,突破通用 RDF 工具的单/双向限制;支撑复杂语义关系的高效图分析,无需耗时逻辑推理即可解析带有附加元信息的关系结构。 |
| 高性能 | Go 语言实现,针对云环境优化;Repository 采用 BBolt 主数据 + Bleve 全文索引 + Document Vault 分层解耦,v1.0.1 索引更新异步化,实现高速存取与灵活查询分离。 |
| 全生命周期 | 基于 ISO 15926 的 4D(时空/演化)框架,管理产品从概念到退役的完整生命周期数据。 |
| Git 式修订控制 | Commit/Branch/Diff/Merge 直达 RDF 语义数据;Dataset-Revision 通过 NamedGraph 哈希级联计算,确保导入图全量处于严格版本控制之下。 |
| 远程访问与安全 | 标准 Web 认证协议 + Keycloak OIDC;v1.0.1 引入 AccessMode RBAC(含 SuperAdmin、客户端 ID 级控制)与 Repository 配额管理,支撑分布式集群统一治理。 |
| AI 集成优化 | SST-Ontologies 提供结构化数据基础;SST-MCP Server(v1.0.1)支持 document tools 及 Dataset/Stage 操作,实现自然语言驱动的工业数据交互。 |
三、SST 技术深度解析(面向技术开发者与架构师)
3.1 SST-LCI 生命周期集成本体与 ISO 15926 对比
SST-LCI(Life-Cycle Integration)本体衍生自 ISO 15926 系列标准,特别是:
ISO 15926-2:2003《工业自动化系统和集成——过程工厂生命周期数据集成,包括石油和天然气生产设施,第 2 部分:数据模型》
ISO/TS 15926-12:2018《以 Web 本体语言(OWL)表示的生命周期集成本体》
SST-LCI 继承了 ISO 15926 的 4D(时空)建模理念,但在实现方式上存在显著差异,其结果是 ISO/TS 15926-12 中约 50% 的术语被直接复用,另外 50% 以不同方式实现。
核心差异如下:
1. 显式声明复杂关系:SST-LCI 充分利用 OWL 的表达能力,通过显式声明策略完整覆盖 ISO 15926-2 的所有能力。不同于依赖通用推理推断隐含语义,SST 要求将工业数据中的复杂关系及其附加属性(如形状表示、变换操作等)直接显式声明,确保数据含义完全由显式陈述决定,兼具表达能力和工程可实施性。
2. 不依赖推理:OWL 最初为开放世界假设(OWA)下的逻辑推理而设计,但通用推理可能耗费大量时间和内存。SST-LCI 基于封闭世界假设(CWA),要求对每个节点显式声明 rdf:type 信息,因此通用 OWL 推理在 SST 中既不适合也不必要。
3. 属性作为一等公民:在 SST-LCI 中,事物的属性(特征)直接通过 RDF 属性为个体表达;而 ISO 15926 更倾向于定义"具有相同属性值的类"(例如,所有"红色"事物的类)。
4. 显式定义域细化:SST-LCI 将 rdfs:isDefinedBy 细化为子属性 lci:isDefinedBy,其定义域(domain)为另一个 SST-LCI 资源,而非供人类消费的网页。
5. 个体层面更冗长,类层面更精简:SST-LCI 在个体层面要求更详细的显式声明,同时移除了 ISO/TS 15926-12 中许多高度抽象且实用价值 存疑的高级类概念(如 class_of_class_of_class)。
6. lci:Event 与 lci:PointInTime 建模调整:v1.0.1 将 lci:PointInTime 定义为 lci:Event(及 lci:PointOrPeriodInTime)的子类型——即"点时刻是零时长的事件",lci:ClassOfPointInTime 同步定义为 lci:ClassOfEvent 的子类型,强化时间维度在生命周期建模中的核心地位。
7. rep:GeometricRepresentation 建模变更:v1.0.1 将 rep:GeometricRepresentation 定义为 ssmeta:ConnotationalClass,因该概念在 STEP IR/MIM 中不存在,需通过 SST 元本体机制显式声明。
8. 本体依赖关系重构:v1.0.1 调整 sso 依赖 rep 但 rep 不依赖 sso。
9. ssmeta:ConnotationalClass 澄清:v1.0.1 对 ssmeta:ConnotationalClass 的概念边界与使用场景进行了进一步澄清。
SST 对复杂关系及其附加属性的表达方式持续演进,以平衡表达能力、验证严格性与工具链兼容性。
3.2 SST-Core 核心概念与术语
在开发基于 SST-Core API 的应用程序之前,需熟悉以下核心概念:
3.2.1 标识与节点
| 术语 | 说明 |
| IRI | 国际化资源标识符,RDF 的基础。SST 大量使用 UUID-URN 和 URL |
| UUID | 通用唯一标识符。SST 主要使用随机版本 4 UUID,确保跨组织数据交换时不会发生 IRI 冲突 |
| UUID URN | 默认用于标识新创建的 Dataset 及其默认 NamedGraph,例如 urn:uuid:8D8AC610-566D-4EF0-9C22-186B2A5ED793 |
| UUID Fragment | NamedGraph 内 IBNode 的 IRI 片段,默认使用随机 UUID。v1.0.1 限制:IBNode.ID() 仅适用于空白节点 |
| Hash | 二进制 SHA256 值,用于唯一标识 DatasetRevision、NamedGraphRevision 或 Commit |
3.2.2 图与数据集
| 术语 | 说明 |
| Dataset(数据集) | 由默认 NamedGraph 及通过 owl:imports 导入的其他 NamedGraph 组成。Dataset 与其默认 NamedGraph 共享相同的基础 IRI(无片段) |
| NamedGraph(命名图) | 由一组 RDF 三元组组成,通过 IRI(无片段)标识。在支持修订历史的仓库中,同一 NamedGraph 可存在多个修订版本 |
| NamedGraphRevision | 仓库中 NamedGraph 的特定版本,由 Hash 值标识 |
| DatasetRevision | 由默认 NamedGraphRevision 及所有直接/间接导入的 NamedGraphRevision 组成,由 Hash 值标识 |
3.2.3 内存与持久化
| 术语 | 说明 |
| Stage(暂存区/工作区) | 内存中打开、创建、修改或删除 NamedGraph 的地方。Stage 可链接到 Repository 以实现持久化。一个应用可并行使用多个 Stage。v1.0.1 增强:支持 LinkToRepository 显式链接、alignhistory 历史对齐操作;移除 Stage.ForUndefinedIBNodes |
| Local NamedGraph | 本地命名图,包含该 NamedGraph"拥有"的所有 IBNode 及其主语三向(Subject Triplexes) |
| Referenced NamedGraph | 引用命名图,仅包含被其他本地命名图引用的 IBNode,无主语三向。可从 Repository 加载或从 RDF 文件读取以转换为本地状态 |
| Commit(提交) | 将 Stage 中修改的 NamedGraph 写入链接的 Repository,产生新的 Commit 记录、DatasetRevision 和 NamedGraphRevision |
| Branch(分支) | Dataset 的命名修订。每个 Dataset 可拥有独立的分支名称,分支名称不在仓库的数据集之间自动协调。v1.0.1 Branch API 增强:SetBranchCommit(重命名自 SetBranch)、SetBranchRevision、CommitForRevision |
3.2.4 三元组与遍历
| 术语 | 说明 |
| Triple(三元组) | 由主语、谓语、宾语(或字面量)组成的 RDF 陈述。SST 中主语节点由定义该三元组的 NamedGraph 拥有 |
| IBNode | IRI 节点或空白节点的统称(IBNode: either an IRI node or a blank node)。注意:TermCollection 与 LiteralCollection 均不是 IBNode |
| Subject Triplex | 从主语 IBNode 出发,指向谓语和宾语/字面量 |
| Predicate Triplex | 从谓语 IBNode 出发,指向主语和宾语/字面量(可选) |
| Object Triplex | 从宾语 IBNode 出发,指向主语和谓语(可选) |
| TermCollection | RDF 集合:有序的 RDF 节点或字面量列表,可嵌套(可包含其他 TermCollection 作为元素) |
| LiteralCollection | 特殊优化的集合类型,所有项必须为相同字面量类型,仅可用作三元组宾语,不可在多个三元组间共享 |
3.2.5 SST 对 RDF 的额外限制
SST-Core 不是通用 RDF 工具包。为实现高性能,SST 引入了以下核心约束:
- 每个 Dataset 和 NamedGraph 均由不带片段的 URI(URN 或 URL)标识
- 数据集的默认图也是一个 NamedGraph,与数据集共享相同的 URI
- IBNode 仅位于一个 NamedGraph 中,其基础 URI 与 NamedGraph 相同,附加片段
- 每个 NamedGraph 包含一个隐式 IBNode(无片段),代表整个 NamedGraph 作为 owl:Ontology
- 空白节点只能在其定义的同一 NamedGraph 内作为宾语被引用
- SST 对数据集采用封闭世界假设(CWA),仅验证默认 NamedGraph 及所有导入的 NamedGraph;仅被引用的 NamedGraph 提供从封闭世界到开放世界的"窗口",且不在修订控制范围内
3.2.6 验证与序列化
Validation(验证)
SST-Core 提供内置数据验证机制,确保 RDF 数据符合本体约束:
ValidateAll:支持带 reference Stage 的对比验证,可检测当前 Stage 与参考版本之间的数据差异
Validate:默认检查所有数据类型(kinds),包括 rdf:type 主类一致性、属性值域约束等
rdf:type 主类检查:改进的 main-class 校验逻辑,确保实例数据正确关联到本体定义的类型层次
空白节点安全:修复空白节点相关 panic(no-IRI panic、Fragment/IRI panic),提升边界场景稳定性
Serialization(序列化)
SST-Core 支持多种 RDF 序列化格式,v1.0.1 带来以下改进:
TriG 优化:修复空白节点标签唯一性问题,确保输出排序一致性;不再输出 owl:imports(由数据集结构隐式管理)
TTL 格式化:改进 Turtle 输出格式,提升可读性
Literal Collection:支持 literal collection 三元组中的 rdfFirst 处理
Tilde-escape:支持包含特殊字符的 IRI 的 tilde-escape 编码与解码往返测试
3.3 SST-Core API 架构
SST-Core API 的所有函数和方法可分为两大组:Repository 操作(持久化存储)和 Stage 操作(内存数据)。
3.3.1 Repository 架构
SST Repository 是持久化存储 RDF 数据的核心组件,由三个主要部分构成:
| 组件 | 技术/说明 |
| BBolt | 嵌入式、可序列化、事务性键值数据库,用于存储主数据(Master Data),包括 RDF Dataset 和 NamedGraph 及其完整的类 Git 修订控制(Commit、Log、Branch/Revision)。同时存储非 RDF 文档的元信息 |
| Bleve | 嵌入式搜索引擎,提供 Lucene 风格的全文检索和索引能力。索引包含从主数据派生的数据,实现主数据高速加载/保存与灵活查询能力的分离。v1.0.1 重构:异步索引更新(BleveIndexUpdater 接口)、修复同步操作未更新 Bleve 索引的问题、日志记录索引更新成功 |
| Document Vault | 用于存储任何类型的非 RDF 文档(如图像、PDF 文件),与 RDF 数据协同管理 |
| Diff 引擎 | v1.0.1 重构:修复同一三元组增删错误,支持 NamedGraph.Diff |
Dataset 定位与签出:Repository 通过 Dataset(dataset-IRI) 方法定位特定数据集。数据集可包含多个修订或命名分支,通过 CheckoutBranch、CheckoutRevision 或 CheckoutCommit 方法访问。
NamedGraph-Revision 存储:所有 NamedGraph 修订均使用 SST 专用二进制格式编码,计算 SHA256 哈希值作为索引,BLOB 作为值存储于 BBolt 数据库。
Dataset-Revision 计算:由默认 NamedGraph-Revision 的哈希值及所有直接/间接导入 NamedGraph 的哈希值共同计算得出,确保所有导入图均处于完整修订控制之下。
查询定位:SST 不采用 SPARQL 作为数据访问机制——这是 SST 与通用 RDF/Linked Data 存储方案的根本区别(后者以 SPARQL 为主要访问机制)。SST 通过 Triplex 三向结构、Repository API 与 Bleve 可定制索引(Lucene 式全文检索)提供高性能数据访问路径,实现主数据高速存取与灵活查询能力的分离。
Repository 配额管理(v1.0.1 新增):
- 支持 Repository 级配额管理,统计信息重构为 int64 类型
- 通过 AccessMode 枚举实现 RBAC 细粒度访问控制
远程同步优化(v1.0.1 增强):
- 修复 source tip → leaf commits 的同步路径,确保分支末端提交正确同步
- 优化 sync & commit-details 处理,提升大仓库同步性能
- 支持不同 Dataset 内容的远程仓库同步测试验证(含专用测试用例)
- Protobuf 协议强化:GetRepoBleveInfoRequest 新增 RepoName 字段;commitInfo 验证逻辑加固
3.3.2 Stage 架构
Stage 是内存中的一个或多个 NamedGraph 及其关联三元组的表示。Stage 可通过以下方式创建:
- 从 Repository 签出(Checkout)DatasetRevision
- 创建新的空 Stage
- 导入 Turtle、TriG、SST 或其他格式文件
Stage 中的 NamedGraph 分为两类:
- Local(本地):包含所有拥有的 IBNode 及其主语三向,可直接修改和保存
- Referenced(引用):仅包含被其他本地命名图引用的 IBNode,无主语三向,可通过加载转换为本地状态
Stage 支持通过 Mode 参数控制启用的 Triplex 类型(单向、双向或三向)。
3.4 SST-CLI 命令行界面
SST-CLI 是 SST-Core 的命令行界面工具,直接在 SST-Core API 之上实现,类似于 Git 命令行应用程序。
主要定位:SST-CLI 是 SST-Core 的命令行界面工具,支持调试、测试及数据操作。v1.0.1 大幅扩充交互命令集,支持完整的 Stage 提交、分支管理、版本签出、远程同步等操作。主要用例包括:
- 测试和验证 SST 功能
- 无需编写软件即可提供 SST 测试用例
- 识别和报告 SST-Core API 中的潜在问题
- 执行 SST 应用程序尚未支持的特定功能
- v1.0.1 新增:Stage 提交、分支管理、版本签出、远程同步等数据操作
工作方式:
- 所有签出的 SST 数据以可读的 Turtle(.ttl)文件形式呈现,文件以其对应 NamedGraph 的 UUID 命名
- 数据存储在扁平工作目录中(而非 Git 的工作树结构)
- 配置数据和可选的本地 Repository 存储在 .sst 隐藏子目录中(类似于 Git 的 .git)
- 签出基于 Dataset 进行,工作目录由数据集 UUID 后接分支名称标识
- v1.0.1 新增:支持 .env.sst-cli 环境配置文件
- v1.0.1 移除:queryuuid 命令、stage.validate 的 verbose 标志
启动方式:
$ go build -o cli/sst ./cli/main.go
$ ./sst
v1.0.1 新增命令示例(s1、d1、r1、r2 分别为交互模式自动分配的 Stage、Dataset、Repository 资源别名):
sst > s1.commit "Initial commit"
sst > d1.checkoutrevision "abc123..."
sst > d1.setbranchcommit "abc123..." "main"
sst > r2.syncfrom r1 main
CLI 支持 Stage 提交、分支管理、版本签出、远程同步等核心操作。交互模式下支持资源别名(如 r1, d1)及 Tab 补全,数据以 Turtle(.ttl)文件形式呈现,配置存储于 .sst 目录(类 Git 的 .git 机制)。v1.0.1 新增核心命令包括 commit(Stage 提交)、setbranchcommit、syncfrom、listcommits 等。
开发说明(v1.0.1):通过 forbidigo lint 规则清理代码,禁止直接使用 fmt.Print* 等不规范输出,确保日志输出一致性。
3.5 许可证与开源策略
SST-Core 提供双重许可模式:商业许可 或 PolyForm Noncommercial 1.0.0 许可。
PolyForm Noncommercial 许可要点:
- 明确禁止任何商业使用
- 不是 OSI 定义的 Open Source™
- 不是 FSF 定义的 Free Software
- 属于"源代码可获取但带有使用限制"的许可模式
商业许可联系方式:
| 地区 | 机构 | 邮箱 |
| 德国 | Semantic STEP Technology GmbH | info@semanticstep.com |
| 中国 | 德中(天津)技术发展股份有限公司 | sst@dct-china.cn |
SST-Core 源代码发布于:https://github.com/semanticstep/sst-core。
SST-Ontologies(高层本体)及数据建模规范作为开放数据结构公开文档化,源代码已在GitHub发布,采用 MIT 许可证(OSI 认证开源) 。
SST-EDM 当前以公开试用方式提供;预计2026年底推出完整功能版本,采用双许可模式:小规模设计与测试免费使用(无时间限制)+ 商业许可(全功能与保障内存空间)。
SST-Core 采用开源获客、增值收费的可持续商业模式:非商业用途可免费使用,商业用途需购买商业许可;德中通过 SST-EDM 企业版、行业数据模型定制开发、SST 技术咨询与培训等增值服务实现商业变现。
四、企业概况
德中(天津)技术发展股份有限公司(证券代码:839939)成立于1998年,由几位在中国从事德国式职业教育的教师共同创立,是一家以直接加工技术(Direct Processing Technique)为核心的强研发型中德合资企业。公司是国家级高新技术企业、国家级专精特新“小巨人”企业、国家科技型中小企业、天津市“专精特新”中小企业、天津市首台(套)重大技术装备集成应用企业、天津市企业技术中心、天津市“一带一路”联合实验室(研究中心)。公司项目曾获天津市科学技术进步奖三等奖,牵头编制的《激光精密加工设备检验检测规范》获2022年全国工商联商会团体标准“领先者”。
公司以直接加工为特色、闭环自证为手段,系统性开发独体设备及成套技术装备、工业软件和设备控制用硬件、电路板制作工艺方法。客户分布在前沿研发、工业生产、技术教育三大领域。依靠机械、激光、电子、软件等方面技术的深度融合,德中研发制造的多个系列工业设备,已广泛应用于集成电路、新能源汽车、智能电子等多个制造领域。
附录A:概念—模块—功能映射表
本表提供全文核心概念与 SST-Core 模块的完整映射,供技术读者进一步查阅。
| 概念 | 定义 | SST-Core对应模块 | SST-EDM功能 |
| 格式 | 数据的物理载体与编码规则,决定数据如何被存储、序列化与传输。在SST中,TTL是"母语"(内部通用语言),STEP-21和JSON-LD是"外语"(工业交换与Web交换),XML作为辅助语言,支持遗留系统对接。 | TTL序列化引擎、STEP-21解析器、XML读写支持、JSON-LD支持(均属 SST Serialization 模块,详见 2.7.1) | 数据导入/导出格式转换(.ttl / .stp / .xml / .json-ld) |
| 数据 | 关于工业对象的原始事实记录,以RDF三元组形式表达(主语-谓语-宾语)。SST中所有应用数据均以RDF格式存储,是W3C语义网标准的核心数据结构。 | RDF三元组存储、SST Repository(命名图与数据集)、BBolt持久化引擎、Bleve索引引擎 | 实例数据管理(持久化存储与查询) |
| 元数据 | 描述数据的结构与含义的"数据说明书"。ISO/IEC 11179-1:2023定义为descriptions of data。通过 ssmeta 元本体(定义 SST-Core 操作规则与配置参数)与 SST Dictionary 提供数据的结构与含义上下文。 | ssmeta元本体、SST Dictionary | 数据资产目录与发现(语义索引) |
| 参考数据 | 跨系统的统一编码字典,提供分类、度量与术语的标准基准。DAMA-DMBOK2定义为any data used to categorize or relate other data, or to relate data to information outside the organization。典型形态包括ISO/IEC 81346 RDS及量/单位/语言/国家/货币等标准词典。 | 参考数据管理模块(ISO/IEC 81346 RDS、量/单位/语言/国家/货币等分类词典) | 分类编码与主数据对齐(基于ISO/IEC 81346 RDS) |
| 语义 | 符号与所指对象之间的意义映射,确保数据在不同语境下含义一致。Tim Berners-Lee定义语义网为an extension of the current web in which information is given well-defined meaning。SST通过RDF语义层与SKOS词汇管理实现多语言语义对齐。 | RDF语义层、SKOS词汇管理(多语言标签/同义词) | 多语言语义对齐与术语映射 |
| 本体 | 领域概念的共享形式化规范,定义实体类型及其关系。Gruber(1993)定义为 an explicit specification of a conceptualization。SST 通过其统一的 RDF 数据模型与 SST-Ontologies,将 ISO 15926(生命周期数据集成)、ISO 10303(STEP)、ISO/IEC 81346 等国际标准中的概念通过 OWL/RDF 进行语义化整合与重建,形成机器可理解的知识骨架。 | OWL本体库(ISO 15926-12、STEP、ISO 80000、ISO/IEC 81346)、SST Ontology Compiler(本体编译器) | 概念建模与显式声明(不依赖推理)的数据管理 |
| 模型 | 特定目的下对现实世界的抽象表示,由数据与规则共同构成。ISO/IEC/IEEE 24765:2017定义为abstraction of a system or a complete description of a system from a particular perspective。SST基于STEP数据模型(ISO 10303),通过SST Ontology Compiler与通用SST API,支持Early Binding(编译时类型检查)与Late Binding(运行时通用接口)两种编程模式。 | STEP数据模型支持(ISO 10303)、SST Ontology Compiler(本体编译器)、通用SST API(支持Late Binding) | 产品数据模型管理(支持Early Binding与Late Binding两种编程模式) |
| 规范 | 模型必须满足的技术要求与约束规则,确保数据质量与合规性。ISO/IEC Guide 2:2004定义为document that prescribes requirements for a product, process or service。SST通过SHACL约束语言实现形状约束检查与模型验证自动化。 | SHACL约束语言(本体已定义,基础验证引擎已落地,完整形状约束检查持续完善中) | 模型验证与合规审计(形状约束检查) |
| 全生命周期 | 人造实体(系统、产品、服务、项目等)从概念构思到退役报废的演进全过程。ISO 15926 提供4D(时空)生命周期数据集成框架;ISO/IEC/IEEE 15288:2023定义为evolution of a system, product, service, project or other human-made entity from conception through retirement。SST通过 Git 式版本化时间轴(Commit / Branch / Diff / Merge:提交/分支/差异比对/合并)贯穿全生命周期。 | Git 式版本化时间轴(Commit / Branch / Diff / Merge:提交/分支/差异比对/合并) | 数据血缘与全生命周期溯源 |
| STEP | ISO 10303(工业自动化系统与集成——产品数据表示与交换),提供中性、计算机可解释的产品数据表示与交换机制,独立于任何特定系统,覆盖产品全生命周期(设计/制造/使用/维护/处置)。SST通过STEP数据模型支持(ISO 10303)、STEP AP242 Domain-Model/MIM导入/导出及SST Ontology Compiler(本体编译器)实现STEP数据语义化接入。 | STEP数据模型支持(ISO 10303)、STEP AP242 Domain-Model import/export、STEP AP242 MIM import/export、SST Ontology Compiler(本体编译器) | 与PLM/MBSE系统对接,实现STEP AP242数据交换 |
| 互操作性 | 多个功能单元之间进行通信、执行程序或传输数据的能力,且几乎无需用户了解各单元的独特特性(ISO/IEC 2382:2015)。SST采用分层设计:内部通信通过gRPC/Local API实现高性能模块间协作;通过 STEP P21 与 AP242 XML 导入/导出及 JSON-LD 实现跨系统数据交换集成,通过MCP协议支持实现AI原生交互。 | gRPC / Local API(内部高性能通信)、STEP P21 / AP242 XML / JSON-LD(跨系统数据交换)、MCP协议支持(AI原生交互) | 跨系统数据交换与分布式协同 |
| MCP协议 | Model Context Protocol(模型上下文协议),AI原生交互协议标准,实现AI与数据仓库的直接通信。SST-MCP Server支持document tools及Dataset/Stage操作,为上层应用提供AI原生交互能力。 | SST-MCP Server | AI辅助数据查询、自然语言操作接口 |
| 核心原则 | SST关于RDF/OWL数据组织的特殊规则与最佳实践(SST Principles)。核心包括:① 封闭世界假设(Closed World Assumption)——未显式声明的事实视为不存在;② 显式声明——不依赖推理,要求数据完整自描述;③显式声明复杂关系——将工业数据中的复杂关系(如装配关系、形状表示关系、几何变换等)及其附加属性通过显式声明表达,确保数据含义完全由显式陈述决定,不依赖通用推理,兼顾表达能力和工程可实施性;④不同IRI标识不同实体。这些原则是SST高性能与工程化落地的底层保证。 | SST Principles(RDF/OWL数据组织特殊规则) | 确保RDF/OWL数据在SST中的一致性、可维护性与高性能 |
| 安全与权限 | 系统访问控制与身份认证机制,基于OAuth2标准框架(RFC 6749)与Keycloak集成,支持OIDC(OpenID Connect)认证层;AccessMode枚举实现RBAC细粒度访问控制(含SuperAdmin角色、Keycloak客户端ID级访问控制、Repository配额管理),保障数据与操作的安全性。 | OAuth2标准框架、Keycloak集成、AccessMode RBAC | 身份认证、访问控制、配额管理 |
| 工具与导入 | 辅助开发、调试与数据导入的命令行工具及领域专用导入器。SST CLI提供与 Git 类似的命令行界面,用于调试与测试SST Core及仓库;EWH导入器支持KBL/VEC/Capital Harness等电气线束行业标准格式的导入。 | SST CLI(命令行测试工具)、EWH导入器(KBL / VEC / Capital Harness等) | 电气线束设计数据导入与交换 |
| IBNode | 命名图(NamedGraph)内节点的统称(IBNode: either an IRI node or a blank node),是RDF三元组中主语和宾语的基本构成单元。每个IBNode由且仅由一个命名图(NamedGraph)拥有,其IRI由命名图的基础IRI加片段(Fragment)组成。【术语定义基于sst-core代码仓库】 | SST Core核心数据模型 | RDF数据节点管理 |
| NamedGraph | 由一组RDF三元组构成的命名图(NamedGraph: RDF graph that is defined as a set of RDF triples and that is identified by an IRI),由IRI(不带片段)唯一标识。在SST中,每个命名图对应一个Turtle文件(.ttl),是SST数据组织、导入/导出与版本控制的基本单元。【术语定义基于sst-core代码仓库】 | SST Repository核心存储单元 | 数据组织与版本管理 |
| Triplex | SST内存中的三向数据结构(Triplex structure: a special data structure in memory to represent all the triples),支持从主语、谓语、宾语三个方向高速遍历RDF图,是实现SST高性能查询的核心技术之一,区别于仅支持单向或双向遍历的通用RDF工具。【术语定义基于sst-core代码仓库】 | SST Core内存引擎 | 高性能RDF图遍历与查询 |
| SST Repository | SST数据的持久化存储仓库(SST-Repository is the place to store RDF data in a persistent way),支持:① RDF数据以SST二进制格式存储;② Git 式版本控制(提交/分支/合并/变更追踪);③ 事务控制;④ Bleve索引支持自定义全文检索与语义查询。分为本地仓库与远程仓库两种类型;远程仓库是SST在Web上发布数据的默认方式。【术语定义基于sst-core代码仓库】 | SST Repository(本地/远程)、BBolt数据库、Bleve索引引擎 | 数据持久化存储、版本控制与语义检索 |
| 派生索引 | 基于NamedGraph数据派生的自定义Bleve索引映射配置,面向高级用户优化全文检索性能。 | defaultderive模块(高级用户专用,配置派生NamedGraph数据的特定索引映射) | 自定义检索优化(高级配置,暂未面向终端用户开放) |
| Breakdown(分解) | 将系统逐层拆分为组件的层级结构 | sso 本体中的 Breakdown / BreakdownOccurrence | 基于 ISO/IEC 81346 的分解结构管理 |
| Dataset(数据集) | 由默认 NamedGraph 及导入图组成的逻辑数据单元 | SST Repository(Dataset / NamedGraph 管理) | 数据组织与版本管理 |
| 公理/规则 | 更高层次的逻辑约束 | SHACL 约束语言、SST Validation 引擎 | 模型验证与合规审计 |
附录B:参考文献
国际标准
[1] ISO/IEC 2382:2015. Information technology --- Vocabulary [S]. Geneva: ISO/IEC, 2015.
[2] ISO/IEC 11179-1:2023. Information technology --- Metadata registries (MDR) --- Part 1: Framework [S]. Geneva: ISO/IEC, 2023.
[3] ISO/IEC/IEEE 24765:2017. Systems and software engineering --- Vocabulary [S]. Geneva: ISO/IEC/IEEE, 2017.
[4] ISO/IEC/IEEE 15288:2023. Systems and software engineering --- System life cycle processes [S]. Geneva: ISO/IEC/IEEE, 2023.
[5] ISO 10303-1:2024. Industrial automation systems and integration --- Product data representation and exchange --- Part 1: Overview and fundamental principles [S]. Geneva: ISO, 2024.
[6] ISO 10303-242:2025. Industrial automation systems and integration --- Product data representation and exchange --- Part 242: Application protocol: Managed model-based 3D engineering [S]. Geneva: ISO, 2025.
[7] ISO 15926-2:2003. Industrial automation systems and integration --- Integration of life-cycle data for process plants --- Part 2: Data model [S]. Geneva: ISO, 2003.
[8] ISO/TS 15926-12:2018. Industrial automation systems and integration --- Integration of life-cycle data for process plants including oil and gas production facilities --- Part 12: Life-cycle integration ontology represented in Web Ontology Language (OWL) [S]. Geneva: ISO, 2018.
[9] ISO 15926-6:2024. Industrial automation systems and integration --- Integration of life-cycle data for process plants including oil and gas production facilities --- Part 6: Rules for the development and validation of reference data of ISO/TS 15926-4 [S]. Geneva: ISO, 2024.
[10] ISO 14040:2006. Environmental management --- Life cycle assessment --- Principles and framework [S]. Geneva: ISO, 2006.
[11] ISO/IEC Guide 2:2004. Standardization and related activities --- General vocabulary [S]. Geneva: ISO/IEC, 2004.
[12] ISO/IEC 21838-1:2021. Information technology --- Top-level ontologies --- Part 1: Framework [S]. Geneva: ISO/IEC, 2021.
学术文献
[13] Gruber, T. R. A translation approach to portable ontology specifications [J]. Knowledge Acquisition, 1993, 5(2): 199-220.
[14] Studer, R., Benjamins, V. R., Fensel, D. Knowledge engineering: principles and methods [J]. Data & Knowledge Engineering, 1998, 25(1-2): 161-197.
[15] Berners-Lee, T., Hendler, J., Lassila, O. The Semantic Web [J]. Scientific American, 2001.
[16] Barbau, R., Krima, S., Fiorentini, X., et al. OntoSTEP: Enriching Product Model Data Using Ontologies [J]. Computer-Aided Design, 2012, 44(6): 575-590.
行业标准与框架
[17] DAMA International. DAMA-DMBOK2: Data Management Body of Knowledge (2nd Edition) [M]. Basking Ridge: Technics Publications, 2017.
[18] Plattform Industrie 4.0. Reference Architecture Model Industrie 4.0 (RAMI4.0) [S]. Berlin: Federal Ministry for Economic Affairs and Energy, 2015.
[19] W3C. RDF 1.1 Concepts and Abstract Syntax [S]. W3C Recommendation, 2014.
[20] W3C. RDF 1.1 Semantics [S]. W3C Recommendation, 2014.
[21] W3C. Data Catalog Vocabulary (DCAT) Version 3 [S]. W3C Recommendation, 2024.
中国国家标准
[22] GB/T 5271.1-2008. 信息技术 词汇 第1部分:基本术语 [S]. 北京:中国标准出版社, 2008.
[23] GB/T 18391.1-2026. 信息技术 元数据注册系统 (MDR) 第1部分:框架 [S]. 北京:中国标准出版社, 2026.
[24] GB/T 11457-2006. 信息技术 软件工程术语 [S]. 北京:中国标准出版社, 2006.
[25] GB/T 8566-2022. 系统与软件工程 软件生存周期过程 [S]. 北京:中国标准出版社, 2022.
[26] GB/T 35119-2017. 产品生命周期数据管理规范 [S]. 北京:中国标准出版社, 2017.
网络资源
[27] Semantic STEP Technology. About SST & EDM [EB/OL]. https://www.semanticstep.com, [引用日期:2026-08].
[28] Semantic STEP Technology. SST-Core GitHub Repository [EB/OL]. https://github.com/semanticstep/sst-core, [引用日期:2026-08].
[29] Semantic STEP Technology. SST-Ontologies GitHub Repository [EB/OL]. https://github.com/semanticstep/sst-ontologies, [引用日期:2026-08].
[30] Semantic STEP Technology. SST-Core v1.0.1 Release Notes [EB/OL]. 2026-07-20. https://github.com/semanticstep/sst-core/releases/tag/v1.0.1, [引用日期:2026-08].
[31] OFweek. 语义STEP技术内核,以PolyForm协议发布 [EB/OL]. 2026-04-27. https://ee.ofweek.com/2026-04/ART-8300-2800-30686163.html, [引用日期:2026-08].
[32] Semantic STEP Technology. SST-EDM MVP(最小可行产品)发布 [EB/OL].
2026-07-25. https://edm.semanticstep.net, [引用日期:2026-08].
附录C:Go 语言开发示例(HelloWorldWrite)
SST-Core 完全使用 Go 语言实现,开发环境推荐使用 Visual Studio Code(VSC)等 IDE。
关键导入说明:github.com/semanticstep/sst-core/vocabularies/dict 包包含 SST 默认词汇/字典的初始化代码,必须手动导入并添加前导 _ 以防止被自动移除:
package main
import (
"fmt"
"log"
"os"
"github.com/semanticstep/sst-core/sst"
// 该下划线导入为固定要求,用于初始化 SST 默认词汇/字典,须手动添加
_ "github.com/semanticstep/sst-core/vocabularies/dict"
"github.com/semanticstep/sst-core/vocabularies/lci"
"github.com/semanticstep/sst-core/vocabularies/rdfs"
"github.com/google/uuid"
)
完整示例及 Go 文档详见:https://www.semanticstep.com/sst_core/hellowrite/
附录D:命令行参考概要
• sst interactive:进入交互模式(默认)
• sst version:显示版本
• commit(v1.0.1,Stage 命令,用法 s1.commit "提交信息"):将 Stage 修改提交至 Repository,支持自定义提交信息
• checkoutrevision(v1.0.1 新增):按 DatasetRevision 哈希签出特定版本(用法:d1.checkoutrevision <hash>);checkoutcommit 继续保留——Dataset 级(d1.checkoutcommit <hash>)按 Commit 签出单个数据集,Repository 级(r1.checkoutcommit <hash>)按 Commit 签出该提交涉及的全部 NamedGraph
• setbranchcommit / setbranchrevision / removebranch(v1.0.1):将分支指向指定 Commit 或 DatasetRevision、删除分支(对应 API:SetBranchCommit 重命名自 SetBranch、SetBranchRevision)
• alignhistory(v1.0.1):历史对齐操作
• syncfrom(v1.0.1 增强):从另一已打开仓库同步(用法:r2.syncfrom r1 [分支] [数据集…]);支持 remote-to-remote 同步;sync log 查看同步日志
• sstread/sstwrite(v1.0.1):SST 文件读写
• remote-to-remote sync(v1.0.1):支持远程仓库到远程仓库的同步
• listcommits(v1.0.1):提交历史列表
• createlocalrepository(v1.0.1):本地仓库创建
• derivedValue(v1.0.1):派生值计算
• writesstfilesdirectory(v1.0.1):SST 文件目录批量写入(由 WriteToSstFilesWithBaseURL → WriteToSstFiles → WriteSstFilesDirectory 演进)
• GlobalLogger 支持(v1.0.1):采用 opt-in 全局日志注入,统一日志输出格式;tools/validate 等工具中的 fmt.Print* 直接输出已移除,改由 GlobalLogger 输出
• sync log(v1.0.1):查看同步日志,追踪远程同步历史
交互模式下支持资源别名(如 r1, d1)和 alias.command 操作模式
使用 readline 库支持编辑、历史记录和 Tab 补全
输出选项:
• v1.0.1 新增:支持 -o 可选输出标志
• v1.0.1 新增:支持 pretty-print 美化输出
德中官网:https://www.dct-china.cn
SST 官网:https://www.semanticstep.com / https://www.semanticstep.cn
SST-Core GitHub:https://github.com/semanticstep/sst-core
SST-Ontologies GitHub:https://github.com/semanticstep/sst-ontologies
2026年8月


 扫一扫


 412

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


