CVPR神组合:Resnet+注意力!热门buff叠加!简单好学易上手

带有SE注意力机制ResNet残差网络构建 阅读详情

CVPR神组合:Resnet+注意力!热门buff叠加!简单好学易上手

AI科研技术派 2024年11月30日 21:40

ResNet与注意力机制结合,是当前的研究热点。其不仅能提高模型的性能,还能提升模型的解释性和泛化能力。

具体来说:ResNet独特的残差连接结构,解决了深度神经网络中的梯度消失和爆炸问题,使网络能构建得更深、更复杂。而注意力机制的动态分配权重特点,则使ResNet能够更准确地识别和利用任务相关的特征,从而提高模型的准确性。

目前,该思路在图像分类、目标检测、语义分割、情感分析、医学影像等领域,都取得了显著成功!比如CVPR的SpikingResformer模型,性能和能效方面都远超SOTA;Nature子刊的Journal,则在准确率高达99.48%的同时,计算时间降低43.24%……

为让大家能够紧跟领域前沿,找到更多idea,我给大家准备了9种创新思路,原文和源码都有!

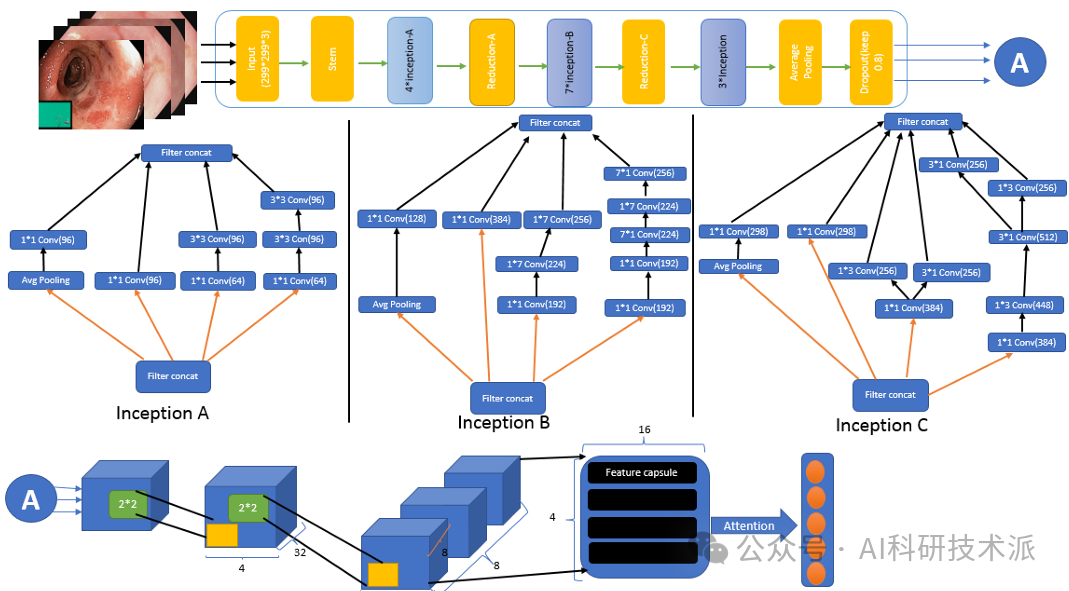
InceptionCapsule: Inception-Resnet and CapsuleNet with self-attention  for medical image Classification

内容:文章介绍了一种名为InceptionCapsule的新型深度学习框架,它结合了Inception-ResNet和CapsuleNet,并加入了自注意力机制,用于医学图像分类。该框架利用迁移学习避免随机权重选择的问题,并从ImageNet获取初始权重,同时使用Inception-ResNet模型的中间层输出来生成丰富的向量特征,供胶囊网络学习。在Kvasir数据集上进行的5类和8类分类测试中,该模型表现出了较高的准确率,在BUSI与GT数据集上也取得了令人满意的精确度、召回率和F1分数。
图片

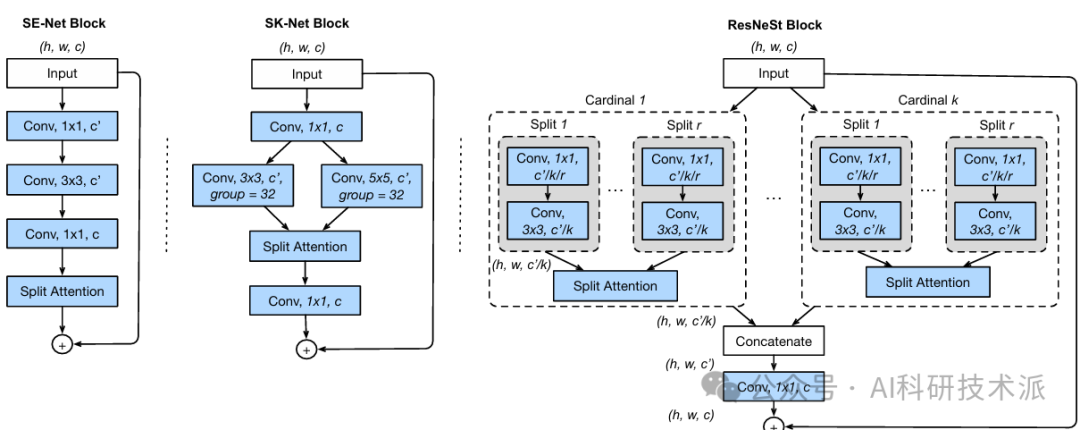
ResNeSt: Split-Attention Networks

内容:论文介绍了一种名为ResNeSt的新型卷积神经网络架构,它通过结合通道注意力机制和多路径表示,提出了一个简单的多分支架构,能够在不同网络分支间应用通道-wise注意力,以增强特征图注意力和多路径表示的互补优势。ResNeSt在多个计算机视觉任务中通过学习更丰富的网络表示来提升性能,其设计空间直接改善了现有网络架构,如RegNet-Y和FBNetV2,并在准确性和延迟的权衡上超越了EfficientNet。
图片

扫描下方二维码,回复「9残差注意

免费获取全部论文合集及项目代码

图片

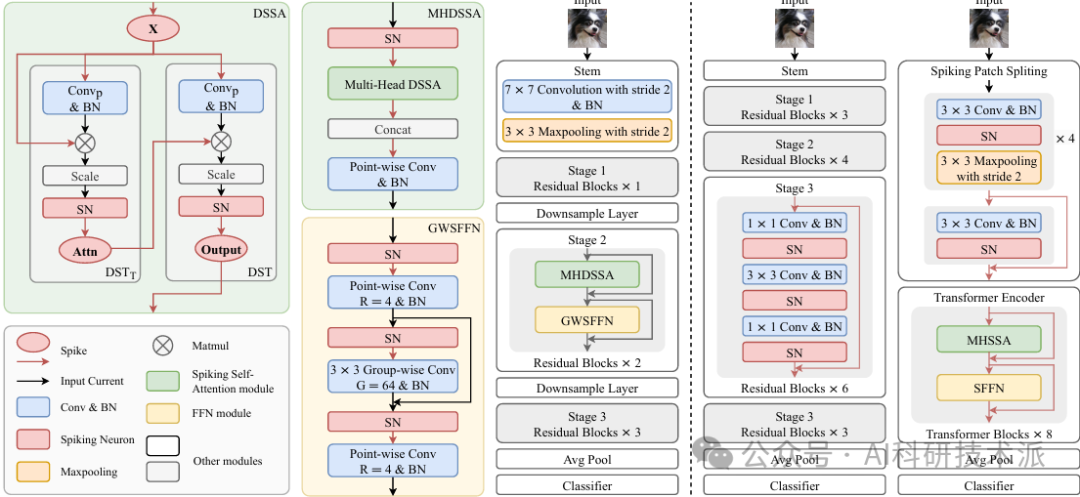
SpikingResformer: Bridging ResNet and Vision Transformer in Spiking Neural  Networks

内容:论文提出了一种名为SpikingResformer的新型尖峰神经网络架构,它通过结合ResNet的多阶段架构和新提出的双尖峰自注意力)机制,实现了在尖峰神经网络中对Vision Transformer的模拟。SpikingResformer在保持参数数量少和能耗低的同时,达到了更高的准确率和能效,特别是在ImageNet数据集上取得了79.40%的top-1准确率,成为SNN领域的最新成果。
图片

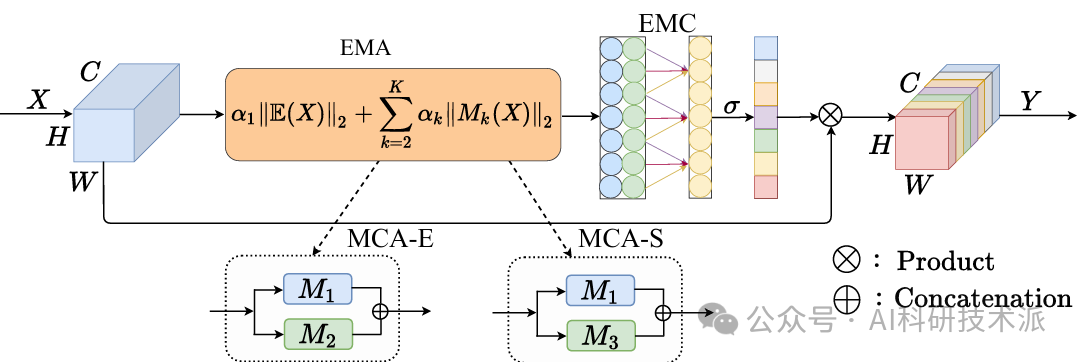
MCA: Moment Channel Attention Networks

内容:文章介绍了一种名为MCA的新型网络框架,它通过引入广泛的矩聚合机制和交叉矩卷积模块来捕捉特征图中的高阶统计矩,从而增强网络的表示能力。MCA框架能够以最小的额外计算成本有效地整合多级基于矩的信息,实验结果表明,在图像分类、目标检测和实例分割等任务中,MCA方法达到了最先进的结果,超越了现有的通道注意力方法。
图片

ResNet注意力机制:深度学习中的强强联合 本文详细介绍了ResNet注意力机制的基本原理,并探讨了如何将两者结合,以提升网络的性能。通过在ResNet中引入注意力机制,网络可以自适应地调整特征图的重要性,从而更加关注于关键区域,提升模型的性能。实验结果表明,引入注意力机制后,ResNet的性能得到了显著提升。未来,随着注意力机制的不断发展,我们可以期待更多创新的网络架构和训练方法,进一步提升深度学习模型的性能。 阅读详情

相关推荐

Resnet 改进:添加SE注意力机制模块

第一个全连接层把C个通道压缩成了C/r个通道来降低计算量,通过一个RELU非线性激活层,第二个全连接层将通道数恢复回为C个通道,再通过Sigmoid激活得到权重s,最后得到的这个s的维度是1×1×C,它是用来刻画特征图U中C个feature map的权重。提高网络的表示能力。使网络能够执行特征重新校准,通过这种机制可以学习使用全局信息来选择性地强调信息特征并抑制不太有用的特征。,将下文的model替换即可。想要完整的分类代码,请参考。

Henry的博客 2089

注意力机制引入ResNet,视觉领域涨点技巧来了!附使用方法

最近,加州大学伯克利分校和谷歌的科研团队共同提出了一个概念上非常简单,但是功能很强大的骨架网络,该网络将自注意力机制纳入了各种计算机视觉任务,包括图像分类、目标检测和实例分割,指标都有了很大的提升,该网络叫做 BoTNet(Bottleneck Transformer)。 为什么要使用 BoTNet?设计思想 近年来,卷积骨架网络在计算机视觉的各个领域取得了非常大的进展,这得益于卷积能够有效捕捉图像中局部的信息,但是对于实例分割、目标检测和关键点检测之类的视觉任务,需要对长期的依赖进行建模。 一、为什么要引

Chris Blog 1万+

ResNet引入注意力模块的详解

ResNet注意力机制融合已成为提升模型性能的主流方法。实践表明,坐标注意力在移动端效果显著(计算量仅增3%),而层级注意力在医学影像分割中Dice系数提升4.2%。

浩瀚之水的专栏 1149

ResNet注意力机制完美结合!11个创新方案让模型性能倍增

可以在保持网络深度的同时,提高模型对任务相关特征的识别和利用能力,以及对关键信息的捕捉能力。具体来说,结合的方式通常是在RetNet的基础上添加注意力模块。这些模块(自注意力机制/通道注意力机制)通过对特征图进行分析,为不同的特征或特征通道分配不同的权重,从而突出重要的信息并抑制不重要的信息。这种结合策略。因此,RetNet结合注意力机制已经成为深度学习领域的一个研究热点。本文整理了,每种方案可参考的方法以及创新点我也做了简单介绍,希望能给各位的论文添砖加瓦。论文原文以及开源代码需要的同学看文末。

学姐带你玩AI的博客 9174

GaussianLSS:用高斯泼溅与不确定性建模革新BEV感知,实现2.5倍加速

在自动驾驶与机器人领域,鸟瞰图(BEV)感知是实现统一环境理解的关键技术。其核心原理在于将多视角的2D图像特征通过几何投影或注意力机制,转换到统一的3D鸟瞰图空间,从而为检测、分割等下游任务提供一致的表示。传统方法如基于注意力的投影范式虽精度高,但计算开销巨大;而基于几何的反投影方法(如Lift-Splat-Shoot)虽高效,却对深度估计的不确定性建模不足。GaussianLSS技术通过引入高斯分布来建模深度估计的不确定性,并利用高斯泼溅(Gaussian Splatting)这一源自计算机图形学的思想进

weixin_30879833的博客 335

注意力机制以及实现

注意力机制、通道注意力、空间注意力

1900的博客 5929

深度学习中的注意力机制模型及代码实现(SE Attention、CBAM Attention)

常用的注意力机制多为SE Attention和CBAM Attention。它们基本都可以当成一个简单的网络。例如SE注意力机制,它主要就是由两个全连接层组成,这就是一个简单的MLP模型,只是它的输出变了样。所以,在我们把注意力机制加入主干网络里时,所选注意力机制的复杂程度也是我们要考虑的一个方面,因为增加注意力机制,也变相的增加了我们网络的深度,大小。

L888666Q的博客 9935

MMDetection中对Resnet增加注意力机制Attention的简单方法

resnet为例子,我在多个尺度的特征层输出增加注意力机制,以此编写一个基类,子类只需要实现这个attention即可。简单的方法是,添加backbone注册修饰器,并在train.py和test.py中,import 该文件。(2)需要注意增加网络的输入输出形状,可能还需要考虑不同宽高输入时网络输出是否与设计一致。(3)增加注意力机制不一定有效涨点,搞数据才是最重要的。(1)这是基于mmdet 2.x版本的改动。

qq_21904447的博客 6793

【深度学习】Pytorch:在 ResNet 中加入注意力机制

在这篇教程中,我们将介绍如何在ResNet网络中加入注意力机制模块。我们将通过对标准ResNet50进行改进,向网络中添加两个自定义的注意力模块,并展示如何实现这一过程。

2303_80346267的博客 4321

【每天一篇深度学习论文】(水论文组合ResNet+注意力

InceptionCapsule: Inception-Resnet and CapsuleNet with self-attention for medical image Classification链接: https://arxiv.org/pdf/2402.02274InceptionCapsule模型的总体架构可以概括为以下几个关键部分:Inception-ResNet层:这是模型的基础特征提取部分,它使用不同大小的卷积核(如3∗33*33∗3和5∗55*55∗5)同时进行多种卷积操作,然后将这些

Magnolia_He的博客 2274

CBAM非官方代码及官方代码

非官方代码 两大模块: class ChannelAttention(nn.Module): def __init__(self, in_planes, ratio=16): super(ChannelAttention, self).__init__() self.avg_pool = nn.AdaptiveAvgPool2d(1) self.max_pool = nn.AdaptiveMaxPool2d(1) self.fc1..

weixin_45612763的博客 8084

pytorch中加入注意力机制(CBAM),以ResNet为例。到底要不要用ImageNet预训练?如何加预训练参数?

第一步:找到ResNet源代码 在里面添加通道注意力机制和空间注意力机制 通道注意力机制 class ChannelAttention(nn.Module): def __init__(self, in_planes, ratio=16): super(ChannelAttention, self).__init__() self.avg_pool = nn...

qq_38410428的博客 5万+

【pytorch】ECA-NET注意力机制应用于ResNet的代码实现

一、前言 ECA-NET(CVPR 2020)简介: 论文名: ECA-Net: Effificient Channel Attention for Deep Convolutional Neural Networks 论文地址: https://arxiv.org/abs/1910.03151 开源代码: https://github.com/BangguWu/ECANet 作为一种轻量级的注意力机制,ECA-Net其实也是通道注意力机制的一种实现形式。 ECA-Net

Leon的博客 1万+

【亲测免费】 ResNet_Attention: ResNet + 注意力机制

ResNet_Attention: ResNet + 注意力机制 去发现同类优质开源项目:https://gitcode.com/ 资源描述 本仓库提供了一个名为 ResNet_Attention 的资源文件,该文件结合了 ResNet注意力机制(包括 CBAM 和 SE)。该模型主要用于图像分类任务,特别是在 CIFAR10 数据集上的训练和验证。 环境要求 操作系统:Ubuntu 20....

gitblog_09718的博客 792

2022年顶会、顶刊SNN相关论文

2022年顶会、顶刊脉冲经网络相关优秀论文收集

lanpeople的博客 1万+

注意力机制集锦】Channel Attention通道注意力网络结构、源码解读系列一

本文从原文、网络结构、代码实现三个方面系统总结了SENet、SKNET、CBAM三种注意力机制

日拱一卒,功不唐捐 1万+

注意力机制代码_pytorch中加入注意力机制(CBAM),以ResNet为例

对于注意力机制的个人理解:网络越深、越宽、结构越复杂,注意力机制对网络的影响就越小。在网络中加上CBAM不一定带来性能上的提升,对性能影响因素有数据集、网络自身、注意力所在的位置等等。建议直接在网络中加上SE系列,大部分情况下性能都会有提升的。CBAM的 解析:heu御林军:CBAM:卷积注意力机制模块​zhuanlan.zhihu.com贴出一些和SE相关的:初识CV:SE-Inception ...

weixin_39787089的博客 1万+
上一篇: 不到百行代码实现自然语言数据库查询:解密AI Agent的ReAct框架
下一篇: 大模型推理和训练所占用的显存怎么估算?
我是机器人曾小健具身
博客等级 码龄2年 410粉丝 29原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

红包个数最小为10个

红包金额最低5元

当前余额3.43前往充值 >
需支付:10.00
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值