


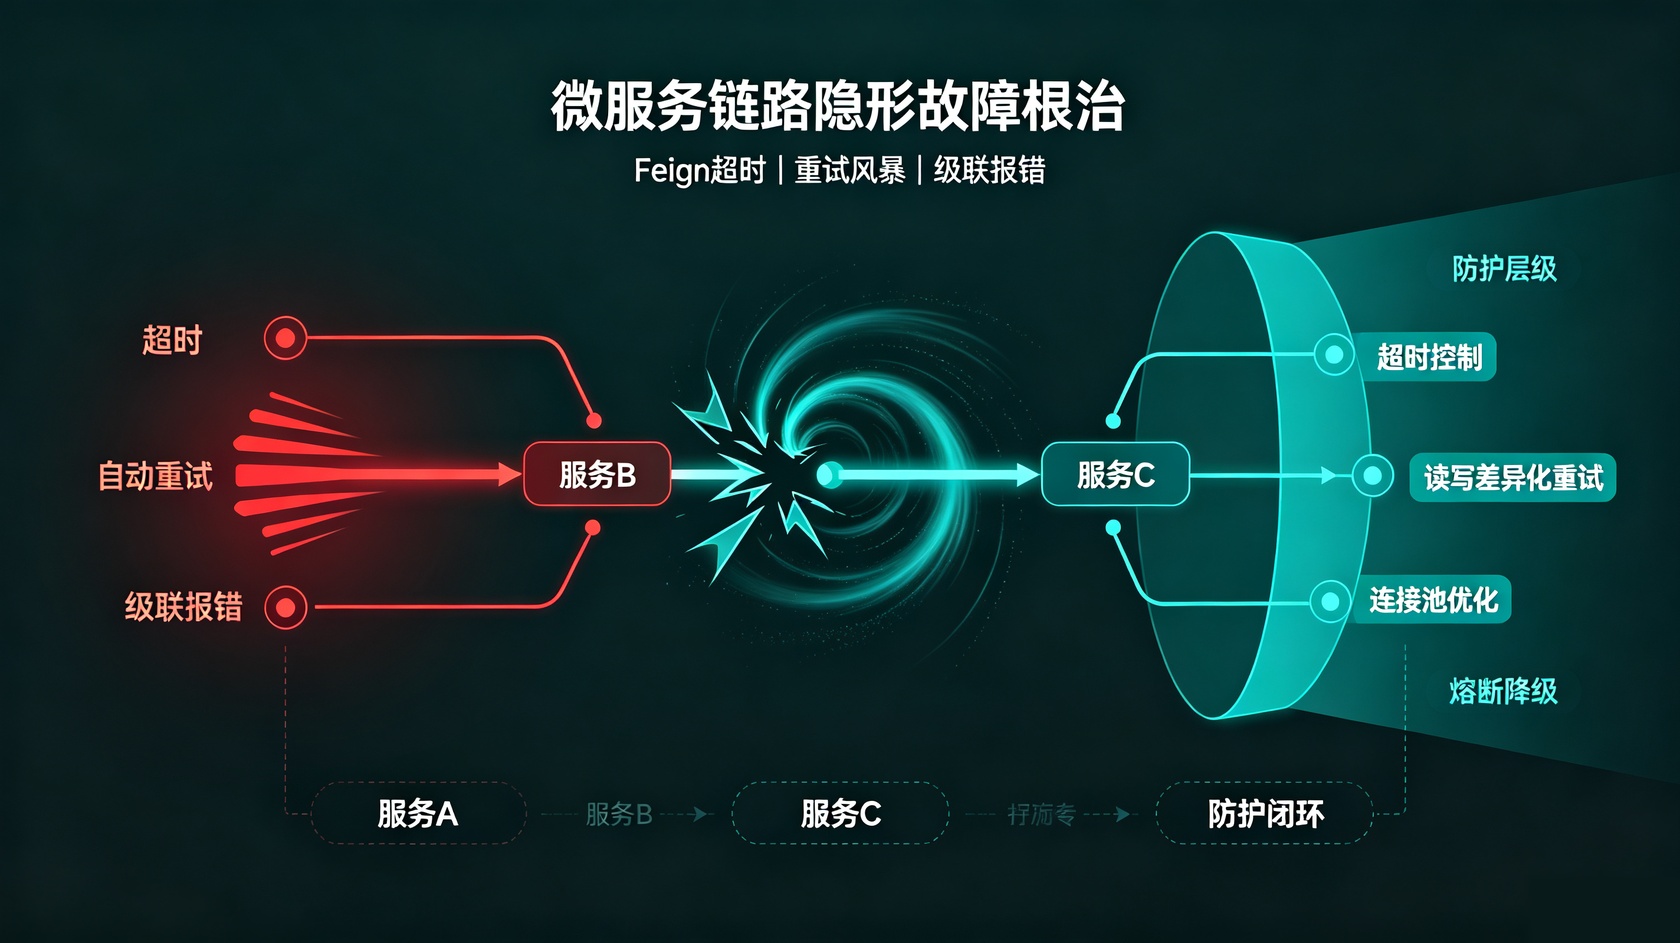
很多SpringCloud微服务项目,线上都存在「玄学故障」:
接口偶尔超时、偶尔成功、毫无规律;单个服务轻微卡顿,直接导致整条调用链路雪崩;明明业务代码无BUG,却频繁出现重试报错、重复提交、数据脏写。
绝大多数团队排查几周找不到根因,最后归结为「网络波动」。
真相:90%的微服务链路抖动、随机超时、级联报错,都是Feign默认配置挖坑导致的人为故障。
SpringCloud的Feign远程调用,默认的超时时间、重试机制、连接策略完全不适合生产环境。本地低并发场景感知不到问题,一旦上线高并发、多服务链式调用,所有隐性缺陷全部爆发。
今天抛开空泛理论,结合真实生产事故,拆解Feign五大致命坑点、错误配置、根治方案,附带全套可直接上线的YAML配置、工具代码,彻底解决微服务链路不稳定问题。
一、为什么微服务线上总抖动?Feign默认配置的致命缺陷
原生Feign为了适配本地开发,默认配置极度宽松、完全不适合生产,核心坑点集中在三点:
1、默认超时时间极短,轻微业务卡顿直接触发超时;
2、默认开启自动重试,超时、异常立刻重试,引发重复请求、雪崩;
3、无差异化重试策略,读请求、写请求统一重试,导致下单、扣款、数据更新重复执行。
链式调用场景下,A调B、B调C,下游轻微超时,上游疯狂重试,瞬间堆积上万请求,直接压垮整条微服务链路。
二、Feign生产五大高频致命坑(逐条拆解)
1、默认1秒超时,误杀大量正常业务
Feign默认读取超时 1000ms、连接超时 500ms。
生产环境数据库查询、复杂业务计算、第三方接口调用,很容易超过1秒。本地测试数据量小秒级响应,线上大数据量直接超时,出现随机报错。
这是微服务随机超时、偶现报错的第一元凶。
2、超时自动重试,引发重复下单、重复扣款
原生Feign默认开启重试机制 DefaultRetryer,请求超时、连接异常、链路抖动时,会自动重试 3次。
对于非幂等写接口(下单、退款、扣款、新增数据),超时未响应并不代表请求未执行,自动重试会直接导致:订单重复创建、资金重复扣减、数据库脏数据。
无数线上资金事故,根源都是这个默认重试机制。
3、无区分重试,读、写请求一刀切
合理的重试逻辑应该是:查询接口可重试,写入/修改接口禁止重试。
但原生Feign全局统一重试策略,无法区分请求类型,写接口重试必然引发业务事故。
4、未开启连接池,频繁创建销毁连接
默认单次请求单次连接,高并发下频繁握手、断开,产生大量TIME_WAIT连接,导致端口占用、请求卡顿、链路抖动。
5、超时、异常无熔断,单点故障全局雪崩
下游服务卡顿、宕机时,Feign无熔断保护,上游持续疯狂调用,故障无限向上传递,最终整个微服务集群瘫痪。
三、生产级根治配置
针对以上坑点,下面给出企业标准的完整 Feign 配置,适配所有 SpringCloud 版本,彻底解决超时、重试、链路抖动问题。
1、核心依赖保证
确保项目引入负载均衡、Feign核心依赖,避免版本兼容问题:
<dependency>
    <groupId>org.springframework.cloud</groupId>
    <artifactId>spring-cloud-starter-openfeign</artifactId>
</dependency>
<dependency>
    <groupId>org.springframework.cloud</groupId>
    <artifactId>spring-cloud-starter-loadbalancer</artifactId>
</dependency>
2、生产最优超时+重试YAML配置
关闭默认暴力重试、合理调整超时时间、开启连接池优化:
# Feign生产级优化配置
feign:
  # 关闭默认重试器(核心!杜绝重复提交)
  client:
    config:
      default:
        # 连接超时时间 3秒
        connectTimeout: 3000
        # 读取超时时间 5秒
        readTimeout: 5000
        # 关闭自动重试
        retryer: NEVER_RETRY

# 开启HTTP连接池,优化链路抖动
httpclient:
  enabled: true
  max-connections: 200
max-connections-per-route: 50关键说明:生产环境必须关闭全局自动重试,所有重试交由业务层手动控制,禁止框架自动重试写接口。
3、自定义重试策略:只读可重试、写入禁止重试
全局禁止自动重试后,手写精准重试器,只允许GET查询接口重试,POST写接口彻底禁止,兼顾稳定性与可用性。
import feign.RetryableException;
import feign.Retryer;
import org.springframework.http.HttpMethod;

public class FeignCustomRetryer implements Retryer {

    private final int maxAttempts;
    private final long backoff;
    int attempt;

    public FeignCustomRetryer() {
        this(2, 1000);
    }

    public FeignCustomRetryer(int maxAttempts, long backoff) {
        this.maxAttempts = maxAttempts;
        this.backoff = backoff;
        this.attempt = 1;
    }

    @Override
    public void continueOrPropagate(RetryableException e) {
        // 非GET请求,禁止重试,直接抛出异常
        if (!HttpMethod.GET.name().equals(e.request().httpMethod().name())) {
            throw e;
        }
        // 超过最大重试次数,抛出异常
        if (attempt >= maxAttempts) {
            throw e;
        }
        attempt++;
        try {
            Thread.sleep(backoff);
        } catch (InterruptedException ignored) {
            Thread.currentThread().interrupt();
        }
    }

    @Override
    public Retryer clone() {
        return new FeignCustomRetryer(maxAttempts, backoff);
    }
}
4、注册自定义重试器,覆盖默认规则
import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;

@Configuration
public class FeignConfig {
    @Bean
    public Retryer feignRetryer() {
        // 自定义重试:仅GET查询重试,最多重试2次
        return new FeignCustomRetryer(2, 1000);
    }
}
四、结合Sentinel熔断,彻底杜绝级联雪崩
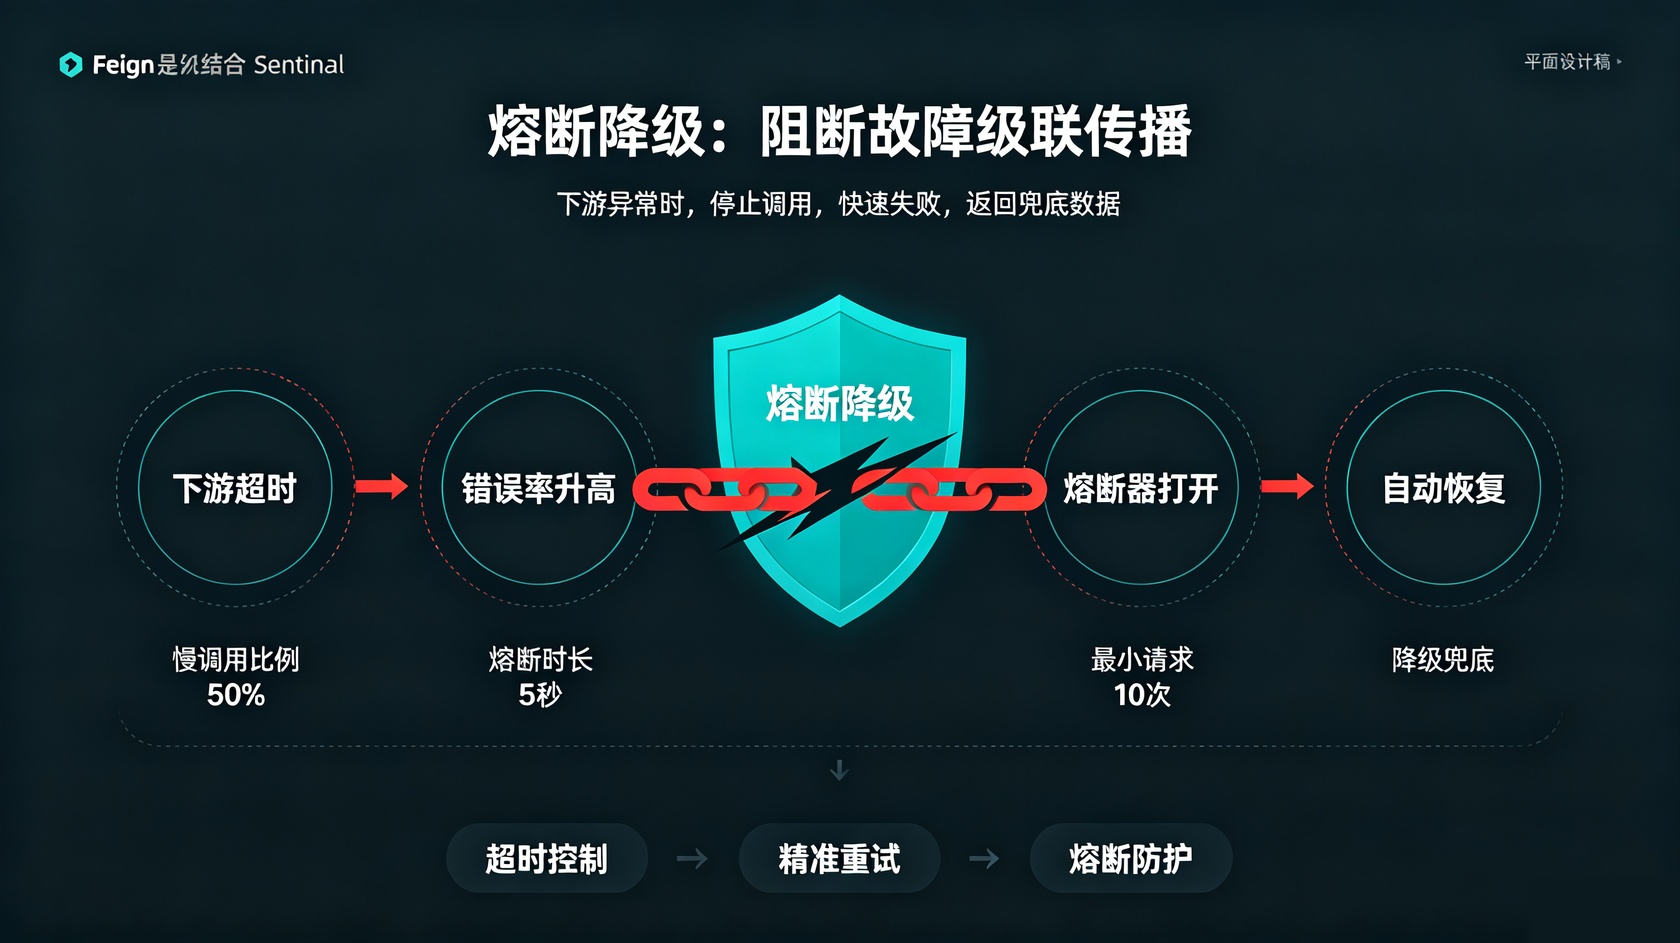
仅优化Feign超时重试还不够,必须搭配熔断降级,下游故障自动切断链路、返回兜底数据,避免故障向上蔓延。
Sentinel生产核心配置
spring:
  cloud:
    sentinel:
      feign:
        enabled: true
      # 熔断降级规则
      degrade:
        default-rule:
          # 慢调用比例熔断:1秒超时判定为慢调用
          slow-threshold: 1000
          # 慢调用比例超过50%触发熔断
          slow-ratio: 0.5
          # 熔断时长5秒
          degrade-time: 5000
          # 最小触发熔断请求数
          min-request-count: 10
配置生效后:下游服务卡顿、超时、报错比例过高时,自动熔断,不再反复调用故障服务,完美阻断级联雪崩。
五、微服务Feign生产强制规范
1、绝对禁止使用Feign默认重试,全局关闭自动重试,杜绝重复业务操作;
2、区分读写请求,仅查询接口允许有限重试,写入、修改、支付类接口零重试;
3、超时时间按需配置,禁止使用默认1秒超时,避免误杀正常业务;
4、必须开启HTTP连接池,减少频繁连接销毁带来的链路抖动;
5、Feign调用必须搭配熔断降级,形成「超时控制+精准重试+熔断防护」三重防护;
6、所有远程调用接口必须做幂等设计,兜底应对极个别重试场景。
六、总结
微服务80%的链路不稳定、随机超时、级联报错、重复数据问题,都不是业务BUG,而是框架默认配置不适配生产导致。
Feign默认的短超时、暴力重试、无差异化策略,在本地开发毫无问题,在生产高并发场景下就是致命隐患。
通过「关闭全局重试 + 自定义读写差异化重试 + 合理超时配置 + 连接池优化 + 熔断降级」这套完整方案,可以彻底根治微服务链路抖动、随机超时、级联雪崩问题,让分布式服务稳定运行。


 扫一扫


 4356

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


