


前言
本文介绍篇来自Google的ICLR2023的论文:F-VLM,开源地址。
1、出发点
本篇论文想将clip这种VLM强大的zero-shot分类能力迁移给开放词汇检测任务。那么就得要求特征层包含“局部感知”和“判别特征”的能力。本文通过K-means聚类clip的Image Encoder的特征层,并将其用于分类,发现效果还不错:
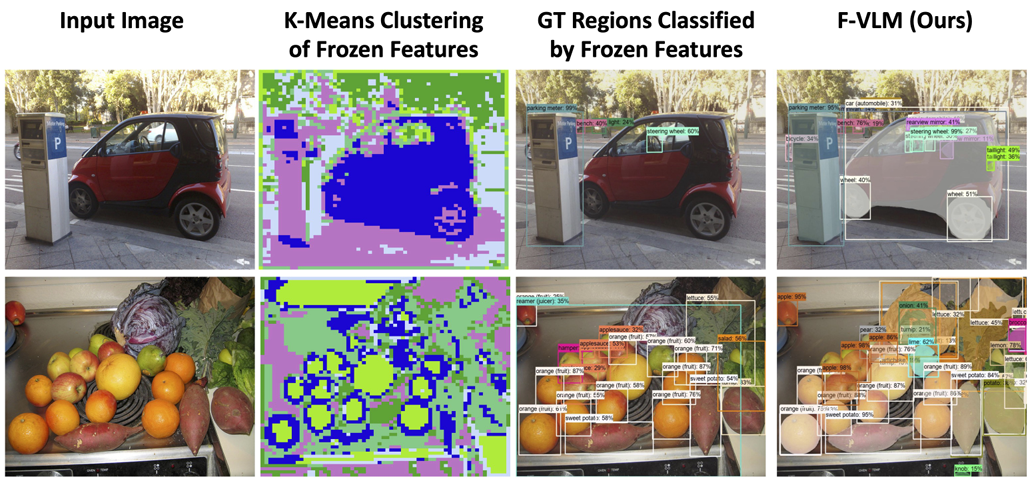
于是作者想到直接冻结clip的特征提取层,然后微调一个检测器不就能得到一个不错的开放词汇检测器了吗。
2、方法
这里简单补充下解决的任务:模型在 C B C_B CB的检测数据上训练;在 C N + C B C_N+C_B CN+CB上进行评测。其中 C N C_N CN不包含在 C B C_B CB中。




 扫一扫


 6058

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


