


智能体开发的过程,就是 拆分需求的过程。需求分解成多个细小的步骤,利用工作流自主规划,完成需求。
智能体中有很多可以使用的构建模块(building blocks),主要分成两个方面:大模型(大语言模型-llm or 多模态模型-multi-modal models-如识别图像 or 其他ai模型-如转换text为语音)、调用软件工具api(如web search\发邮件\获取储存数据等)
工作流开发,就是组装构建模块的过程。
1、reflection反射设计模式
- 什么是反射:abc模型的循环流程
即:对模型A的输出结果,利用模型B进行审核评价,再利用模型C进行输出结果的优化(根据评价、指导内容,对结果进行优化)。
此过程可以多次重复,已达到最优结果。
-
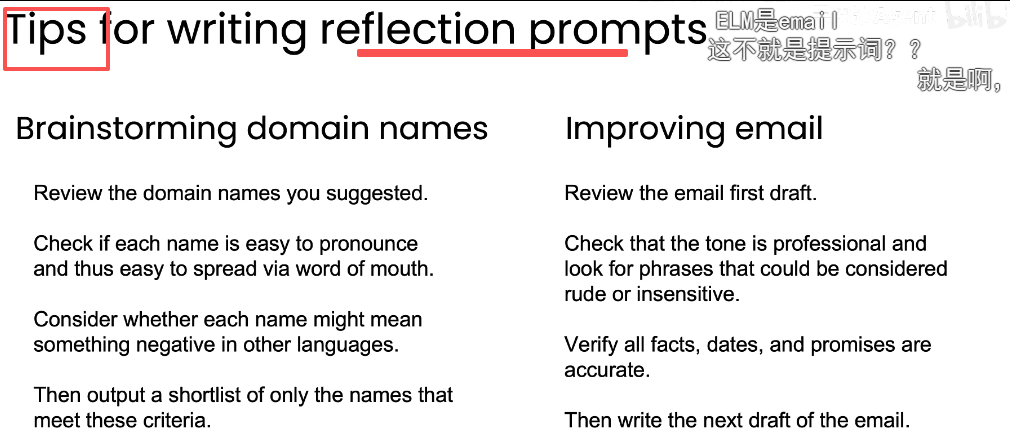
如何写“基础反射提示词”-审核模型的审核提示词(reflection prompt):
- 区别是否需要示例。零示例提示词zero-shot prompt、一或多示例提示词one or few shot prompt。
- 如何审核:按什么流程、什么标准去检查;
- 在哪些方面审核:如逻辑是否自洽、事实是否准确、是否遗漏关键点、表达是否清晰等;
- 输出什么:给出具体的评价意见和修改建议,供模型C据此优化。
- 除了掌握相关专业的知识,还可以多看看开源智能体的提示词,多看多学习。
-
模型的选择
不同类型的模型,特长的方面不同。
比如
思考模型(thinking model),适合给出结果。
推理模型(resoning model),适合对结果进行审核分析(revision) -
结果质量的评估方法
- 评价对象:
- 对最终结果 end to end
- 流程中某一步的输出 component level
- 对 LLM 的中间结果 trace of llm —— 思考过程?下面是一些工作流开发的方法。
- 评测工具:
- 程序更适合进行客观评价,大模型更适合进行主观评价
- 可以客观评价的,利用自定义程序
如:有客观的评价标准,比如获取销量最好的产品,有数据证明,但agenti结果实际上不是100%准确的 - 只能主观评价的,利用大模型
如:不同展示形式的图表,哪种方式展示有一定的主观性。利用大模型评价时,可以给一些评价标准,用1/0算满足标准的总分,进行评价。
- 评价对象:
-
外部反馈的反射(reflection from external feedback),也是提升输出结果质量的高效方式
前面提到的反射,是利用工作流中定义的内部llm输出reflection审核结果,利用reflection结果对首次输出进行再次优化。
而外部反馈,具体只来自工作流外部的反馈,如利用外部api工具进行字数统计进行实现字数限制目的、利用搜集的外部网站数据获取事实依据实现对结果的事实准确判断。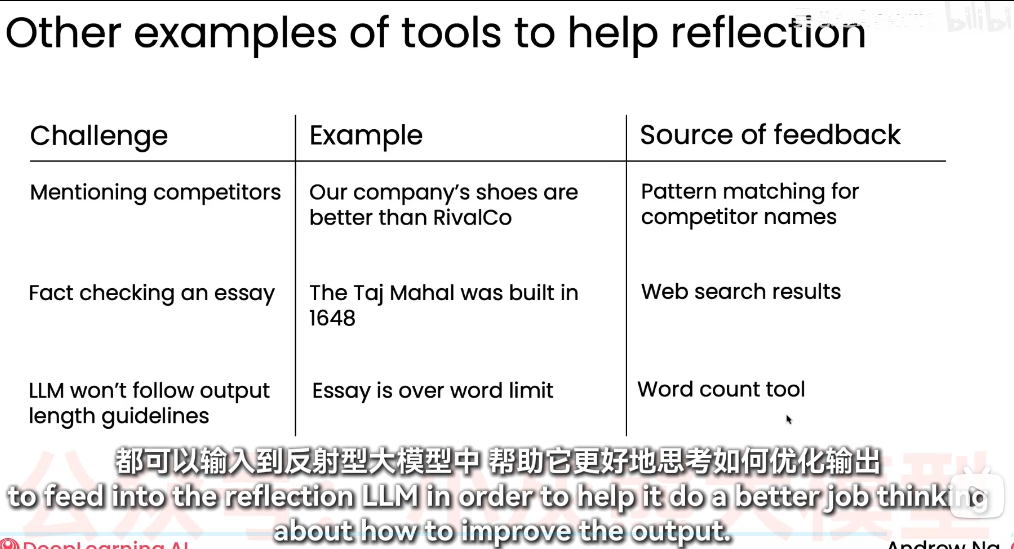
2、工具的使用 Tool Use
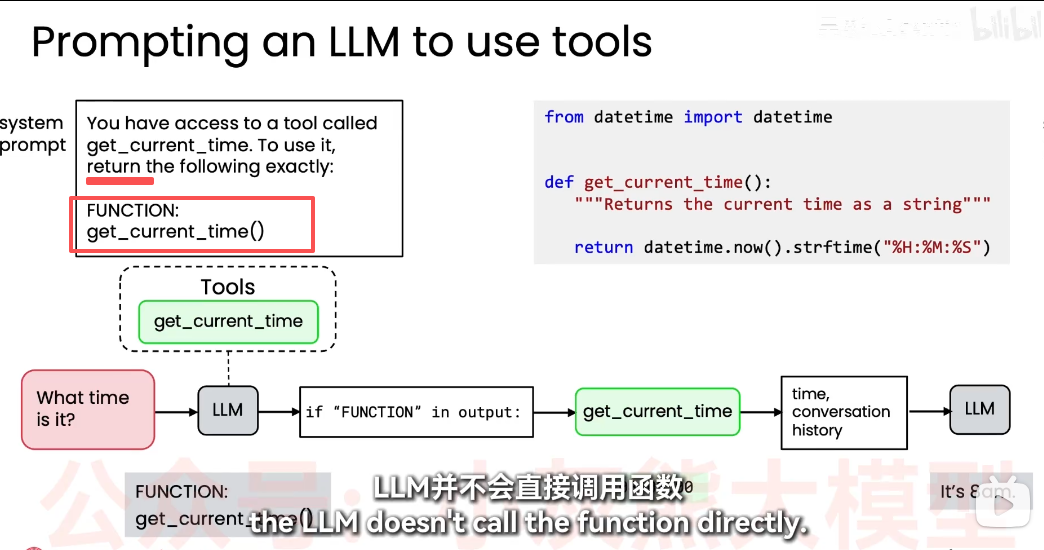
调用工具的原理:
1、提供工具
2、提供提示词,让大模型llm输出内容,指定调用哪个工具
3、接受大模型llm输出,判断出需要哪个工具,并使用对应的工具
4、得到工具结果,对进过进行处理后输出
实际使用:
1、如何调用具体的工具:python代码实现,只需指定提供的一系列工具,内部实现会自动选择合适的工具调用。
2、不提供工具,利用 llm生成代码的能力
让llm根据需求,自己生成代码,实现功能,再利用python exec执行代码的功能,执行llm生成的代码
MCP(model context protocol, 模型上下文协议)
用于获取工具和上下文的协议
3、构建智能体的技巧
-
端到端评估
1、先搭框架,简单、粗糙的流程,在错误中优化、细化具体实现
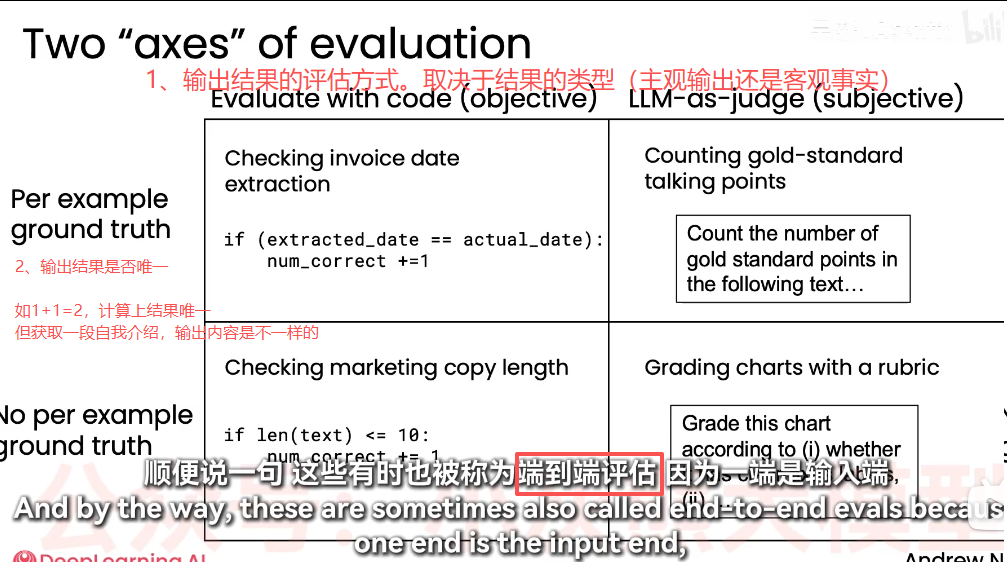
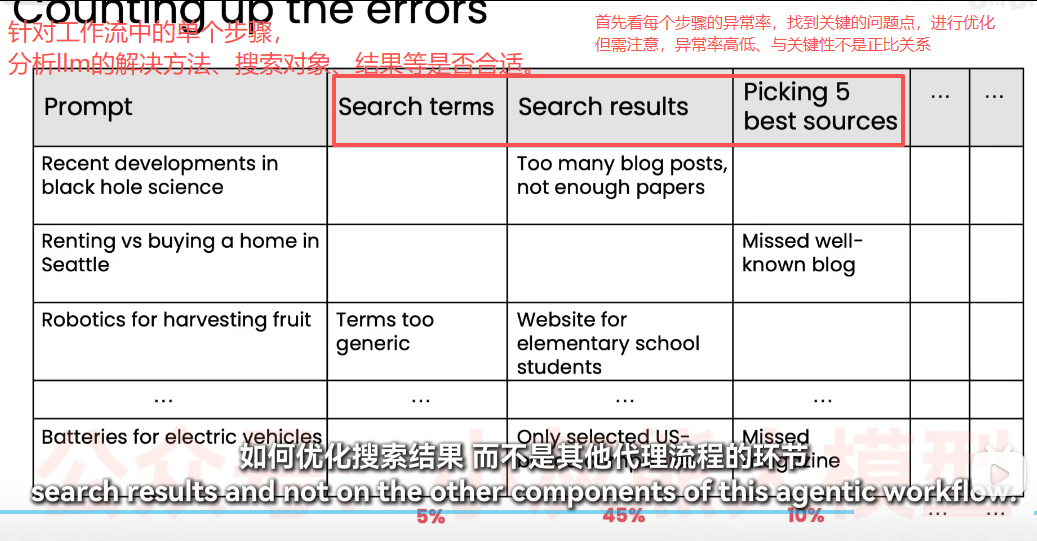
2、使用二维表评估智能体,找问题
how:参考下面的二维表,先确定问题的评估方式。
再列举适量的例子,进行测试,查看具体有哪些失败情况(还可以从不同方面评价,从失败率最高、或失败的初始原因入手);(这样就找到了问题)
最后需要找到关键的问题,解决。 —— 找不到问题也会导致方向错误而优化效果不佳。
3、对结果不满意、或不符合期待的内容,进行优化。
-
中间结果评估(误差分析 error analysis output)
需要细看步骤的执行过程trace,对步骤的思考、推理等过程进行分析,定位,优化


 扫一扫


 3440

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


