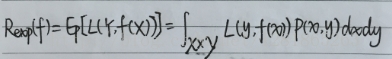统计学习-基本术语和概念

AI权益加码!Claude Code、Cursor等20+工具免费用! 购周边限时加赠Coding Plan Lite,畅享主流AI工具!学习进阶更高效! 阅读详情

1.统计学习和机器学习:
统计学习就是计算机系统利用数据和统计方法提高系统性能的机器学习,如今的机器学习一般指的就是统计学习。所谓的系统性能一般指对数据的分析和预测能力。

2.输入空间,输出空间,特征空间
将输入和输出所有可能的取值称之为输入空间和输出空间;
每个输入实例通常由一个特征向量进行表示,这样所有的特征向量构成了特征空间。有的时候输入空间和特征空间是相同的,有的时候是不同(比如:输入是一张图片实例,在图片识别分类中,我们需要对图片进行特征提取)

3.统计学习三要素
模型:就是我们需要学习的条件概率分布或者决策函数。模型的假设空间(hypothesis space)包含所有可能的条件概率分布或决策函数。比如,假若决策函数是输入变量的线性函数,那么模型的假设空间就是所有线性函数构成的集合。
顺便提一下,由决策函数表示的模型称之非概率模型;由条件概率表示的模型称之概率模型。

策略:就是如何从假设空间中选择最优的模型。这就涉及到选择的好坏问题,如何度量这种好坏就得引入损失函数(L(Y,f(X)))和风险函数(Rexp(f)=Ep[L(Y,f(X))])。
损失函数度量模型一次预测的好坏,对于非概率模型的损失函数一般有0-1损失函数,平方损失函数和绝对损失函数,对于概率模型的损失函数有对数损失函数。具体定义如下:
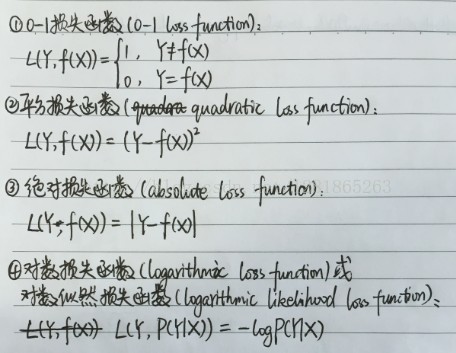
这里写图片描述
风险函数度量平均意义下模型的预测好坏:
这里写图片描述
但是风险函数的求解需要获得X,Y的联合概率P(x,y)。实际上,我们如果知道P(x,y)就可以直接获得输出的条件概率P(y|x)了,这就是一个鸡生蛋,蛋生鸡的问题。换个角度再想想,我们可以通过计算给定样本的平均损失(即经验风险)来估计期望风险:
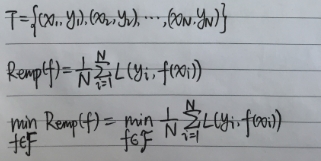
这里写图片描述
原因是:根据大数定律,当样本容量N趋于无穷时,经验风险趋于实际的期望风险。但是一般而言我们的样本是有限的,所以单纯的通过经验风险估计期望风险所得到模型的泛化能力一般都是不足的。
针对经验风险最小化(empirical risk minimization,ERM)泛化能力不足的问题,我们可以在代价函数中添加正则项,即结构风险最小化(structural risk minimization,SRM).
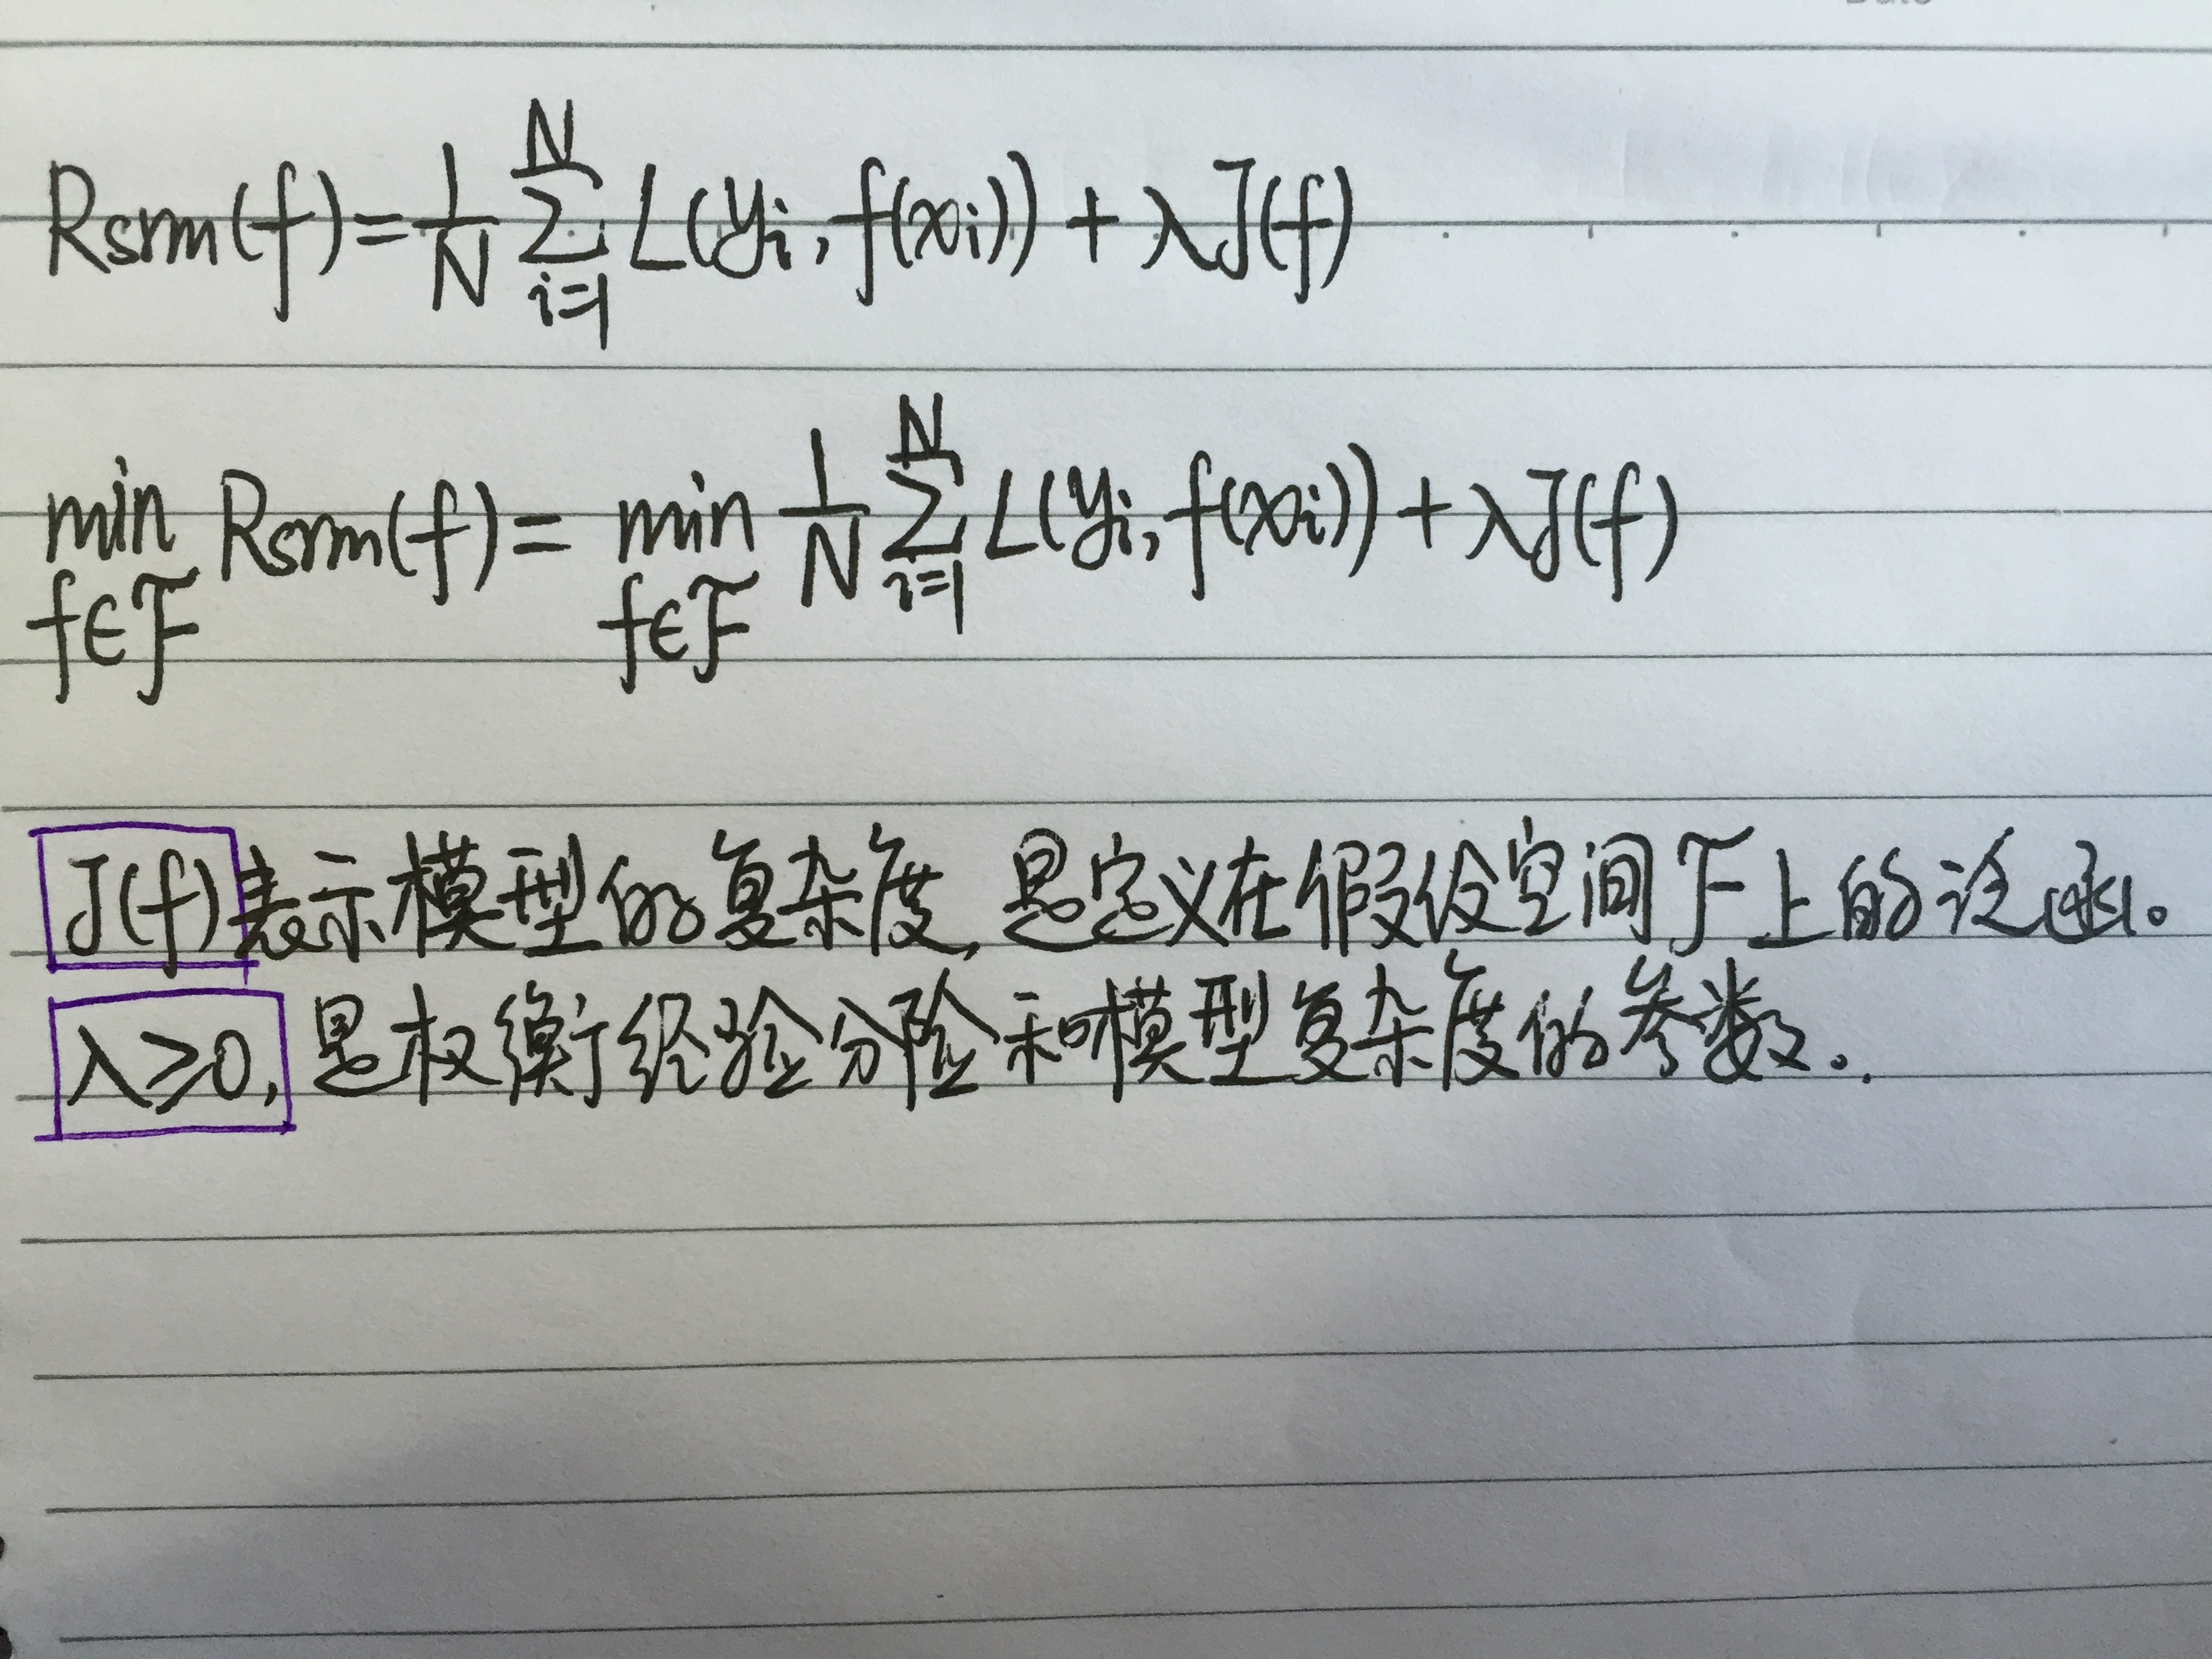
这里写图片描述

算法:是指学习模型的具体计算方法。统计学习基于训练数据集,根据学习策略从假设空间中选择最优模型,最后需要考虑的就是用什么样的方法求解最优模型,这个时候就是在已知代价函数的基础下求解模型参数。

4.正则化:在原本的经验风险代价函数的后面添加一个用于描述模型复杂度的项目,该项目被称作正则化项,正则化符合奥卡姆剃刀原理。所谓奥卡姆剃刀原理应用于模型选择时就是:在所有可能的选择的模型中,能够很好的解释已知的数据并且十分简单才是最好的模型。一般用于描述模型复杂度的有L0,L1和L2范数。
L0范数是指向量中非0的元素的个数。如果我们用L0范数来规则化一个参数矩阵W的话,就是希望W的大部分元素都是0。这太直观了,太露骨了吧,换句话说,让参数W是稀疏的。
L1范数是指向量中各个元素绝对值之和,也有个美称叫“稀疏规则算子”(Lasso regularization)。L0范数很难优化求解(NP难问题),而L1范数是L0范数的最优凸近似,而且它比L0范数要容易优化求解,L0和L1都是用来进行特征选择的。
L2范数是指向量各元素的平方和然后求平方根。我们让L2范数的规则项||W||2最小,可以使得W的每个元素都很小,都接近于0,但与L1范数不同,它不会让它等于0,而是接近于0,L2范数可以提高模型的泛化能力,同时L2范数方便优化求解,获取的特征相比于L1和L0更加平滑。

5.交叉验证(cross validation)
首先涉及三类数据:训练集(training set),验证集(validation set)以及测试集(test set)。训练集用来模型的训练,验证集用于模型的选择,测试集用于最终对学习方法的评估。
1.简单交叉验证:将数据的70%作为训练集,30%作为测试集。然后用训练集在各种条件下训练模型,从而得到不同的模型,在测试集上评价各个模型的测试误差,选出测试误差最小的模型。
2.S折交叉验证:将数据随机地切分为S个互不相交的大小相同的子集;然后利用S-1个子集的数据训练模型,利用余下的子集测试模型;将这一个过程对可能的S种选择重复进行,最后选择S次评测中平均测试误差最小的模型;
3.留一交叉验证:往往在数据缺乏的情况下使用,假设存在N个数据,一般将S=N

6.生成模型和判别模型:
监督学习可以分为生成方法(generative approach)和判别方法(discriminative approach)。
生成方法由数据学习联合概率分布P(X,Y),然后求出条件概率分布P(Y|X)作为预测的模型,即生成模型:P(Y|X)=P(X,Y)P(X),这种方法之所以称为生成方法是因为模型表示了给定输入X产生输出Y的生成关系,典型的生成模型有朴素贝叶斯和隐马尔科夫模型。
判别模型则是由数据直接学习决策函数f(X)或者条件概率分布P(Y|X)作为预测的模型,典型的判别模型比如:kNN,感知机,决策树,LR,最大熵模型,svm,提升方法(比如:AdaBoost,bagging,随机森林)和条件随机场。

7.准确率(precision),召回率(recall)和F1
TP(真阳):将正类预测为正类
FP(假阳):将负类预测为正类
TN(真阴):将负类预测为负类
FN(假阴): 将正类预测为负类
P()=TPTP+FP
R()=TPTP+FN
2F1=1P+1R,准确率和召回率都高时,F1值也会高。
TPR=TPTP+FN
FPR=FPFP+TN
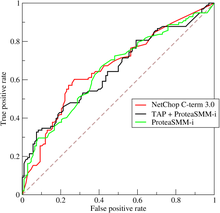
这里写图片描述
从图中可以看出,ROC曲线一般在(0,0)和(1,1)直线的上方。(因为对于二分类问题而言,这条直线就代表随机猜测,0.5的概率预测正确)
在ROC 空间中,每个点的横坐标是FPR,纵坐标是TPR,这也就描绘了分类器在TP(真正的正例)和FP(错误的正例)间的trade-off。Area Under roc Curve(AUC)就出现了。顾名思义,AUC的值就是处于ROC curve下方的那部分面积的大小。通常,AUC的值介于0.5到1.0之间,较大的AUC代表了较好的Performance。

8.监督学习的三类问题:
1.分类问题:当输出变量Y取有限个离散值时,预测问题便成为分类问题
2.标注问题:是分类问题的一个推广,标注问题又是更复杂的结构预测。标注问题的目标在于学习一个模型,使它能够对观测序列给出标记序列作为预测。(可能的标记个数是有限的,但其组合所成的标记序列的个数是依序列长度呈指数级别增长的),标注常用的统计学习方法有:隐马尔科夫模型和条件随机场。
3.回归问题:用于预测输入变量和输出变量之间的关系,回归问题的学习等价于函数拟合,选择一条函数曲线使其可以很好地拟合已知数据且很好地预测未知数据。

统计学习方法——概述 统计学习方法李航第二版 第一章概述 阅读详情

相关推荐

《机器学习》周志华_自学记录

第一章绪论## 1.1引言机器学习所研究的主要内容,是关于在计算机上从数据中产生"模型"(model)的算法,即"学习算法"(learning algorithm).在面对新的情况时(例如看到一个没剖开的西瓜),模型会给我们提供相应的判断(例如好瓜).如果说计算机科学是研究关于"算法"的学问,那么类似的,可以说机器学习是研究关于"学习算法"的学问.## 1.2基本术语:用于预测离散值,例如将样本分为“好瓜”或“坏瓜”。:用于预测连续值,例如西瓜的成熟度(如0.95、0.37)。

2201_75296678的博客 2489

统计学习导论(ISLR)(二):统计学习概述

2.统计学习(Statistical Learning) 统计学习是指用于理解数据的大量方法 这些方法可以分为有监督的或无监督的, 广义上讲,有监督的统计学习涉及建立一个统计模型,根据一个或多个输入来预测或估计输出,无监督统计学习,有输入但无监督输出;尽管如此,我们还是可以从这些数据中看出相关的关系结构。 2.1 什么是统计学习? 为了激发我们对统计学习的研究,我们从一个简单的例子开始。假设我们是客户聘请的统计顾问,调查特定广告销售之间的相关产品。这个广告数据集包括产品在200个特定市场的销量,以及三个

阿里云专家博主、数据科学领域优质创作者、统计er在读 4270

An Introduction to Statistical Learning with Applicatio

作者:禅与计算机程序设计艺术 1.简介 1.1定义 统计学习(statistical learning)是一门研究如何从数据中提取知识并应用于预测、决策或其他目的的一门学科。它是机器学习、数据挖掘、计算机视觉等领域的一个分支,是当前热门的AI方向。

AI天才研究院 1665

统计学习方法——机器学习统计学习介绍及基本入门

1.统计学习是关于计算机基于数据构建概率统计模型并运用模型对数据进行分析与预测的一门学科。统计学习包括监督学习、非监督学习、半监督学习强化学习。2.统计学习方法三要素——模型、策略、算法,对理解统计学习方法起到提纲挈领的作用。3.本书主要讨论监督学习,监督学习可以概括如下:从给定有限的训练数据出发, 假设数据是独立同分布...

Small world 1222

1.1 统计学习

统计学习简介

weixin_44028809的博客 707

统计学习概论

输入空间(Input Space):输入的所有可能取值的集合。实例(Instance):每一个具体的输入,通常由特征向量(Feature Vector)表示。特征空间(Feature Space):所有特征向量存在的空间。根据变量类型的不同:输入变量与输出变量均为连续变量(回归问题)。输出变量为有限个离散变量(分类问题)。输入变量与输出变量均为变量序列(标注问题)。监督学习的基本假设:XY具有联合概率分布P(X, Y)。

2301_79853469的博客 1406

统计学习方法chapter1

统计学习方法chapter1 统计学习概述 对象 object 统计学习的对象为数据,从数据出发,提取数据的特征(特征工程),抽象出数据的模型(建立模型),发现数据中的知识,又回到对数据的分析与预测中去(回归/分类) 用途 purpose 用于对数据的预测与分析 方法 method 统计学习的方法是基于数据构建概率统计模型从而对数据进行预测分析(即整合对象用途),统计学习主要由监督学习,无监督学习,半监督学习,强化学习等组成。 术语 onym 模型:从输入到输出的映射 假设空间:模型的集合 概率模型:

松阁 294

统计学习方法概论

1 统计学习 对象:数据(data),以变量或变量组表示。 目的:预测分析。 方法:监督学习(supervised learning)、非监督学习(unsupervised learning)、半监督学习(semi-unsupervised learning)、强化学习(reinforcement learning)。 概念:训练数据(training data)、假设空间(hy...

MeowingCat 255

《西瓜书》笔记01:机器学习绪论

1. 概述“朝霞不出门,晚霞行千里”日常生活中,我们积累了许多经验,通过对经验的利用,就能对新情况做出有效决策。机器学习:致力于研究如何通过计算的手段,利用经验来改善系统自身性能。计算机系统中,经验以数据形式存在。ML研究的主要内容:关于在计算机上从数据中产生模型的算法。有了学习算法,把经验数据提供给它,就能基于这些数据产生模型。面对新情况,模型会提供相应判断。2. 基本术语数据集,样本/示例,属性

鸟恋旧林的博客 886

《机器学习》学习笔记chapter1 绪论(占坑)

更多参考:百度搜索《机器学习》周志华 学习笔记 第一章绪论1.基本术语2.假设空间&&归纳偏好这里有个推理流程图科学推理的两大基本手段: 演绎推理:从公理到具体的“特化”过程 归纳:从具体到一般规律的“泛化”过程 归纳学习 概念学习 布尔概念学习 假设空间 版本空间 归纳偏好 NFL定理 算法优劣的判断 3.机器学习发展历程 1950s-70s:智能∝逻辑推理能力 1970s-

ml_1019的博客 484

周志华机器学习西瓜书学习笔记(一)| 第一章 绪论

注:Mitchell在1997年给出了一个更形式化的定义:假设用P评估计算机程序在某任务类T上的性能,若一个程序通过利用经验E在T中任务上获得了性能改善,我们则说关于TP,该程序对E进行了学习。如果没有偏好,学习算法产生的模型每次在进行预测时随机抽选训练集上的等效假设,那么对新示例学得模型时而告诉我们它是好的、时而告诉我们它是不好的,这样的学习结果显然没有意义。的过程,搜索目标是找到与训练集“匹配”(fit)的假设,即能够将训练集中的对象判断正确的假设。要谈论算法的相对优劣,必须要针对具体的学习问题。

2201_75859438的博客 1610

周志华《机器学习》——第一章绪论笔记

机器学习——第一章绪论笔记一、引言二、基本术语三、假设空间四、归纳偏好 一、引言 机器学习研究的主要内容是关于在计算机上从数据中产生“模型”的算法,即学习算法(learning algorithm)。 有了学习算法,我们把经验数据提供给它,就能基于这些数据产生模型;在面对新的情况时,模型可以给出预测。 机器学习是研究关于“学习算法”的学问。 本书用“模型”泛指从数据中学得的结果。有文献用“模型”指全局性结果(例如一棵决策树),而用“模式”指局部性结果(例如一条规则)。 二、基本术语 数据集(data set

qq_43169299的博客 968

机器学习《Machine Learning1》----机器学习经典总结:入门必读

机器学习《Machine Learning1》----机器学习经典总结:入门必读

拥有百余位万粉技术博主、200余位可合作代发博主,私域技术社群规模达千人,商务合作私信 3707

初学者看机器学习

机器学习入门认知——概念理解 Reference:Zhihua Zhou. Machine learning[M]. Tsinghua University Press, 2016. 一、基本术语 分类(classification):预测离散值; 回归(regression):预测连续值; 二分类(binary classification):正类反类; 多分类(multi-cla...

qq_43564050的博客 198

关于svm

名词解释: (1) SVM(Support Vector Machine)是从瓦普尼克(Vapnik)的统计学习理论发展而来的,主要针对小样本数据进行学习、分类预测(有时也叫回归)的一种方法,能解决神经网络不能解决的过学习问题。作者以为,类似的根据样本进行学习的方法还有基于案例的推理(Case-Based Reasoning),决策树归纳算法C4.5等,以后将详细阐述这两种方法。 (

1537

统计学习方法概述

本文是老猿学习《统计学习方法》(李航 著)一书的感悟总结,大部分内容来源与书本,之所以将原文的大部分内容在博客中呈现,是因为老猿觉得这些内容对新人学习非常重要,会起到提纲挈领的作用。 统计学习是处理海量数据的有效方法,是计算机智能化的有效手段,更是计算机科学发展的一个重要组成部分,对应计算机科学系统、计算、信息三个组成部分的信息这个部分。统计学习是基于数据构建概率统计模型从而对数据进行分析预测,统计学习三要素为模型(model)、策略(strategy)算法(algorithm),模型是基础,定义

老猿Python 1284

[统计学习方法]第一章:统计学习方法概述

统计学习方法概论 1.1统计学习

半笔书生的专栏 659

机器学习的主要研究领域、基本概念相关术语的解释

1.主要研究领域: 1.1机器学习的两大学派: 机器学习:人工智能的重要分支 构造具有学习能力的智能系统 知识、推理、学习 手段:统计,逻辑,代数…… 统计机器学习 从大量样本出发,运用统计方法,发现统计规律 有监督学习、无监督学习、半监督学习 问题:分类,聚类,回归...

csdnliu123的博客 1万+

机器学习相关概念术语总结

再比如垃圾邮件筛选器,经验E就是程序从垃圾邮件成千上万次的自我练习的经验而任务是当邮件过来时,给邮件分类是正常邮件还是垃圾邮件,性能P就是对垃圾邮件正确分类的准确率;与监督学习不同,无监督学习不需要已知输出的训练数据,而是通过对数据进行聚类、降维、关联规则挖掘等技术来发现数据中的隐藏结构模式。监督学习是机器学习的一种方法,它使用已知输入对应的输出数据来训练模型,以便模型能够预测新的输入数据对应的输出。在监督学习中,训练数据包括输入特征目标输出,模型通过学习输入输出之间的关系来进行预测。

weixin_43597208的博客 990
上一篇: caffe源码解析-im2col
下一篇: 统计学习-感知机
小羊哈利
博客等级 码龄13年 49粉丝 122原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

红包个数最小为10个

红包金额最低5元

当前余额3.43前往充值 >
需支付:10.00
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值