


 Kafka Streams是一个轻量级的客户端库,用于构建处理Kafka数据的应用。它支持流处理、聚合、窗口计算等操作,具有容错、状态管理、低延迟等特点。本文介绍了Stream Processing Topology、时间概念、聚合、窗口计算和WordCount示例,展示了如何准备输入数据、启动应用程序及处理数据。Kafka Streams将流和表的概念融合,提供了一种处理无限数据流的高效方式。
Kafka Streams是用于构建应用程序和微服务的client library,其中输入和输出数据存储在Kafka集群中。 它结合了在客户端编写和部署标准Java和Scala应用程序的简便性以及Kafka服务器端集群技术的优势。
Line app使用了kafka stream,除此之外,世界上很多著名的应用程序也使用了kafka.
Kafka Streams的一些亮点:
- 设计为简单轻量级的客户端库,可以轻松地将其嵌入任何Java应用程序中,并与用户为其流应用程序所拥有的任何现有打包,部署和操作工具集成。
- 除了Apache Kafka本身作为内部消息传递层之外,对系统没有任何外部依赖性;值得注意的是,它使用Kafka的分区模型来水平扩展处理,同时保持有力的订购保证。
- 支持容错本地状态,该状态可实现非常快速和有效的有状态操作,例如窗口连接和聚合。
- 支持一次精确的处理语义,以确保即使在处理过程中Streams客户端或Kafka代理发生故障时,每条记录也只会被处理一次。
- 采用一次一个记录的处理以实现毫秒级的处理延迟,并支持基于事件时间的窗口操作以及记录的无序到达。
- 提供必要的流处理原语,以及高级Streams DSL和低级Processor API。
下面我们一起来学习一下kafka的核心概念.
Stream Processing Topology-流处理拓扑
- 流是Kafka Streams提供的最重要的抽象:它表示无限制的,不断更新的数据集。 流是不可变数据记录的有序,可重播和容错序列,其中数据记录定义为键值对。
- 任何使用Kafka Streams库的程序都是一个流处理应用程序。 它通过一个或多个 processor topologies处理器拓扑定义其计算逻辑,其中处理器拓扑是由流(edges)连接的流处理器(nodes)的图。
- 流处理器stream processor 是处理器拓扑中的一个节点node 。 它表示一个处理步骤,通过一次从topology中的上游处理器接收一个输入记录,对其应用操作,来转换流中的数据,然后可以向其下游处理器生成一个或多个输出记录。
拓扑topology中有两个特殊processors 处理器:
- Source Processor: Source Processor源处理器是一种特殊类型的流处理器, source processor没有任何上游处理器。 它通过使用一个或多个Kafka topic的记录,并将它们转发到其下游处理器,从而从一个或多个Kafka topic生成一个输入到其拓扑topology的流。
即source processor接收topic的输入发送给下游processor - Sink Processor: Sink Processor接收器处理器是一种特殊类型的流处理器,它没有下游处理器。 它将所有从上游处理器接收到的记录发送到指定的Kafka topic。
即Sink Processor下游没有Processor,而是将收到的消息发送给topic.
另外我们需要注意,在普通处理器节点中,在处理当前记录时也可以访问其他远程系统 remote systems。 因此,处理后的结果可以流回Kafka或写入外部系统。
Kafka Streams提供了两种定义流处理拓扑的方法:Kafka Streams DSL提供了最通用的数据转换操作,例如开箱即用的map,filter,join和aggregation方法。更加底层的 Processor API 允许开发人员定义和连接自定义处理器以及与状态存储进行交互。
处理器拓扑processor topology仅仅是流处理代码的逻辑抽象。 在运行时,将在应用程序内部实例化并复制逻辑拓扑以进行并行处理
Time时间
流处理中的一个关键点是时间的概念,以及如何对其进行建模和集成。 例如,某些操作是基于时间边界定义的。
流中常见的时间概念是:
- Event time 事件或数据记录发生的时间点,即最初是在“source”上创建的。 示例:如果事件是汽车中GPS传感器报告的地理位置变化,则关联的事件时间将是GPS传感器捕获位置变化的时间。
- Processing time 即当流处理应用程序开始进行处理 事件或数据记录的时间点,即记录被消耗时的时间点。 处理时间可能比原始事件时间晚几毫秒,几小时或几天等。 示例:设想一个分析应用程序读取并处理从汽车传感器报告的地理位置数据,并将其呈现给车队管理仪表板。 在这里,分析应用程序中的处理时间可能是事件发生后的毫秒或秒(例如,基于Apache Kafka和Kafka Streams的实时管道)或几小时(例如,基于Apache Hadoop或Apache Spark的批处理管道)。
- Ingestion time Kafka broker将事件或数据记录存储在主题分区中的时间点。 和事件时间区别在于,摄取记录是在Kafka代理将记录添加到目标topic时生成的,而不是在“源头”创建记录时生成的。 处理时间的区别在于处理时间是流处理应用程序处理记录的时间。 例如,如果一条记录从未被处理过,则没有处理时间的概念,但它仍具有提取时间
Aggregations 聚合
聚合操作使用一个输入流或表,并通过将多个输入记录合并为一个输出记录来产生一个新表。 聚合的示例是计算counts 或sum。
在Kafka Streams DSL中,聚合的输入流可以是KStream或KTable,但输出流始终是KTable。 这使得Kafka Streams在产生和发出值之后,如果其他记录无序到达,则可以更新汇总值。 当发生无序到达时,聚合的KStream或KTable会发出新的聚合值。 由于输出是KTable,因此在后续处理步骤中,新值将被视为使用相同的键覆盖旧值。
Windowing窗口计算
Windowing可以控制如何对具有相同键的记录进行分组,以进行有状态操作。windows会跟踪每个记录的键。
Kafka Streams DSL中提供了窗口操作。使用窗口时,可以为窗口指定宽限期。该宽限期控制Kafka Streams将等待给定窗口多长时间的无序数据记录。如果在窗口的宽限期过去之后到达记录,则该记录将被丢弃,并且不会在该窗口中进行处理。具体来说,如果一条记录的时间戳指示它属于某个窗口,则该记录将被丢弃,但是当前流时间大于该窗口的末尾加上宽限期。
乱序记录在现实世界中始终是可能的,并且应在您的应用程序中适当考虑。这取决于有效时间语义,如何处理乱序记录。在处理时间的情况下,语义是“正在处理记录时”,这意味着无序记录的概念不适用,因为根据定义,没有记录可以是无序的。因此,无序记录只能被认为是事件时间。在这两种情况下,Kafka Streams都能正确处理乱序记录。
Duality of Streams and Tables
wordcount示例
下面的代码示例实现了一个WordCount应用程序,该应用程序具有伸缩性,高度可扩展性,容错性,是有状态的
package com.dr.kafka.stream;

/*
 * Licensed to the Apache Software Foundation (ASF) under one or more
 * contributor license agreements. See the NOTICE file distributed with
 * this work for additional information regarding copyright ownership.
 * The ASF licenses this file to You under the Apache License, Version 2.0
 * (the "License"); you may not use this file except in compliance with
 * the License. You may obtain a copy of the License at
 *
 *    http://www.apache.org/licenses/LICENSE-2.0
 *
 * Unless required by applicable law or agreed to in writing, software
 * distributed under the License is distributed on an "AS IS" BASIS,
 * WITHOUT WARRANTIES OR CONDITIONS OF ANY KIND, either express or implied.
 * See the License for the specific language governing permissions and
 * limitations under the License.
 */

import org.apache.kafka.clients.consumer.ConsumerConfig;
import org.apache.kafka.common.serialization.Serdes;
import org.apache.kafka.streams.KafkaStreams;
import org.apache.kafka.streams.StreamsBuilder;
import org.apache.kafka.streams.StreamsConfig;
import org.apache.kafka.streams.kstream.KStream;
import org.apache.kafka.streams.kstream.KTable;
import org.apache.kafka.streams.kstream.Produced;

import java.util.Arrays;
import java.util.Locale;
import java.util.Properties;
import java.util.concurrent.CountDownLatch;

/**
 * Demonstrates, using the high-level KStream DSL, how to implement the WordCount program
 * that computes a simple word occurrence histogram from an input text.
 * <p>
 * In this example, the input stream reads from a topic named "streams-plaintext-input", where the values of messages
 * represent lines of text; and the histogram output is written to topic "streams-wordcount-output" where each record
 * is an updated count of a single word.
 * <p>
 * Before running this example you must create the input topic and the output topic (e.g. via
 * {@code bin/kafka-topics.sh --create ...}), and write some data to the input topic (e.g. via
 * {@code bin/kafka-console-producer.sh}). Otherwise you won't see any data arriving in the output topic.
 */
public final class WordCountDemo {

    public static final String INPUT_TOPIC = "streams-plaintext-input";
    public static final String OUTPUT_TOPIC = "streams-wordcount-output";

    static Properties getStreamsConfig() {
        final Properties props = new Properties();
        props.put(StreamsConfig.APPLICATION_ID_CONFIG, "streams-wordcount");
        props.put(StreamsConfig.BOOTSTRAP_SERVERS_CONFIG, "localhost:9092");
        props.put(StreamsConfig.CACHE_MAX_BYTES_BUFFERING_CONFIG, 0);
        props.put(StreamsConfig.DEFAULT_KEY_SERDE_CLASS_CONFIG, Serdes.String().getClass().getName());
        props.put(StreamsConfig.DEFAULT_VALUE_SERDE_CLASS_CONFIG, Serdes.String().getClass().getName());

        // setting offset reset to earliest so that we can re-run the demo code with the same pre-loaded data
        // Note: To re-run the demo, you need to use the offset reset tool:
        // https://cwiki.apache.org/confluence/display/KAFKA/Kafka+Streams+Application+Reset+Tool
        props.put(ConsumerConfig.AUTO_OFFSET_RESET_CONFIG, "earliest");
        return props;
    }

    static void createWordCountStream(final StreamsBuilder builder) {
        final KStream<String, String> source = builder.stream(INPUT_TOPIC);

        final KTable<String, Long> counts = source
                .flatMapValues(value -> Arrays.asList(value.toLowerCase(Locale.getDefault()).split(" ")))
                .groupBy((key, value) -> value)
                .count();

        // need to override value serde to Long type
        counts.toStream().to(OUTPUT_TOPIC, Produced.with(Serdes.String(), Serdes.Long()));
    }

    public static void main(final String[] args) {
        final Properties props = getStreamsConfig();

        final StreamsBuilder builder = new StreamsBuilder();
        createWordCountStream(builder);
        final KafkaStreams streams = new KafkaStreams(builder.build(), props);
        final CountDownLatch latch = new CountDownLatch(1);

        // attach shutdown handler to catch control-c
        Runtime.getRuntime().addShutdownHook(new Thread("streams-wordcount-shutdown-hook") {
            @Override
            public void run() {
                streams.close();
                latch.countDown();
            }
        });

        try {
            streams.start();
            latch.await();
        } catch (final Throwable e) {
            System.exit(1);
        }
        System.exit(0);
    }
}
它实现了WordCount算法,该算法从输入文本中计算单词出现的直方图。 但是,与您之前可能看到的其他WordCount示例不同,WordCount演示应用程序的行为略有不同,因为它被设计为对无限的无限制数据流进行操作。 与有界变体类似,它是一种有状态算法,可跟踪和更新单词计数。 但是,由于它必须假定可能不受限制的输入数据,因此它将定期输出其当前状态和结果,同时继续处理更多数据,因为它不知道何时处理了“所有”输入数据。
第一步,我们将启动Kafka,然后我们将为Kafka topic准备输入数据,随后将由Kafka Streams应用程序对其进行处理。
启动单节点的zookeeper
> bin/zookeeper-server-start.sh config/zookeeper.properties
[2013-04-22 15:01:37,495] INFO Reading configuration from: config/zookeeper.properties (org.apache.zookeeper.server.quorum.QuorumPeerConfig)
...
启动kafka
> bin/kafka-server-start.sh config/server.properties
[2013-04-22 15:01:47,028] INFO Verifying properties (kafka.utils.VerifiableProperties)
[2013-04-22 15:01:47,051] INFO Property socket.send.buffer.bytes is overridden to 1048576 (kafka.utils.VerifiableProperties)
...
准备输入的topic并且启动Kafka producer
创建输入的topic
bin\windows\kafka-topics.bat --create --bootstrap-server localhost:9092 --replication-factor 1 --partitions 1 --topic streams-plaintext-input
接下来我们创建output topic,该topic需要激活compaction属性,原因是因为输出流是可变更的日志流
bin\windows\kafka-topics.bat --create --bootstrap-server localhost:9092 --replication-factor 1 --partitions 1 --topic streams-wordcount-output --config cleanup.policy=compact
创建的topic可以使用同一个kafka-topic tool进行描述
kafka-topics.bat --bootstrap-server localhost:9092 --describe
Topic: streams-plaintext-input  PartitionCount: 1       ReplicationFactor: 1    Configs: segment.bytes=1073741824
        Topic: streams-plaintext-input  Partition: 0    Leader: 0       Replicas: 0     Isr: 0
Topic: streams-wordcount-output PartitionCount: 1       ReplicationFactor: 1    Configs: cleanup.policy=compact,segment.bytes=1073741824
        Topic: streams-wordcount-output Partition: 0    Leader: 0       Replicas: 0     Isr: 0
Topic: test     PartitionCount: 1       ReplicationFactor: 1    Configs: segment.bytes=1073741824
启动wordcount application
以下命令启动WordCount应用程序:
bin\windows\kafka-run-class.bat org.apache.kafka.streams.examples.wordcount.WordCountDemo
问题: 这里的org.apache.kafka.streams.examples.wordcount.WordCountDemo程序在哪儿?
该应用程序将从输入的topic流-streams-plaintext-input中读取内容,对每个读取的消息执行WordCount算法的计算,并将其当前结果连续写入输出topic streams-wordcount-output中。 因此,除了日志条目外,没有任何STDOUT输出,因为结果被写回到Kafka中。
现在,我们可以在单独的终端中启动控制台producer,以向该topic写入一些输入数据:
bin\windows\kafka-console-producer.bat --bootstrap-server localhost:9092 --topic streams-plaintext-input
并通过在单独的终端中与控制台consumer一起读取WordCount演示应用程序的输出topic来检查其输出:
bin\windows\kafka-console-consumer.bat --bootstrap-server localhost:9092 --topic streams-wordcount-output --from-beginning --formatter kafka.tools.DefaultMessageFormatter --property print.key=true --property print.value=true --property key.deserializer=org.apache.kafka.common.serialization.StringDeserializer --property value.deserializer=org.apache.kafka.common.serialization.LongDeserializer
处理数据
现在,让我们通过控制台生产者通过输入一行文本,然后单击<RETURN>,将一些消息写到输入主题streams-plaintext-input中。 这会将新消息发送到输入主题,其中如果消息键为null,则消息值是刚输入的字符串编码的文本行(实际上,应用程序的输入数据通常会不断地流到Kafka中,而不是 手动输入。
输入:
>
>test
>123
>ray
>all 1
>kafka 1
>to 1
>
输出:
        1
test    1
123     1
ray     1
all     1
1       1
kafka   1
1       2
to      1
1       3
输出当中,第一列是java.lang.String格式的Kafka消息键key,表示要计数的单词,第二列是java.lang.Longformat的消息值,表示单词的最新计数。
现在,让我们继续向控制台prudcer一起向输入topic streams-plaintext-input中写入一条消息。 输入文本行“ hello kafka streams”,然后单击<RETURN>。 的终端应如下所示
hello kafka streams
输出如下:
        1
test    1
123     1
ray     1
all     1
1       1
kafka   1
1       2
to      1
1       3
hello   1
kafka   2
streams 1
在这里,打印的行kafka 2表示对kafka key和流的计数已从1递增到2的。每当向输入topic编写更多输入消息时,都会观察到新消息添加到word count输出流中- ,表示由WordCount应用程序计算的最新单词计数。 让我们输入最后一个文本行“ join kafka summit”:
        1
test    1
123     1
ray     1
all     1
1       1
kafka   1
1       2
to      1
1       3
hello   1
kafka   2
streams 1
join    1
kafka   3
summit  1
如看到的一样,Wordcount应用程序的输出实际上是连续的更新流,其中每个输出记录(即上面原始输出中的每一行)是单个单词(也称为记录键,例如“ kafka”)的更新计数。 对于具有相同键的多个记录,以后的每个记录都是前一个记录的更新。
下面的两个图说明了背后的实质情况。 第一列显示了KTable <String,Long>当前状态的演变,该状态正在对单词出现进行计数。 第二列显示了更改记录,这些更改记录是由KTable的状态更新产生的,并已发送到输出Kafka主题streams-wordcount-output。
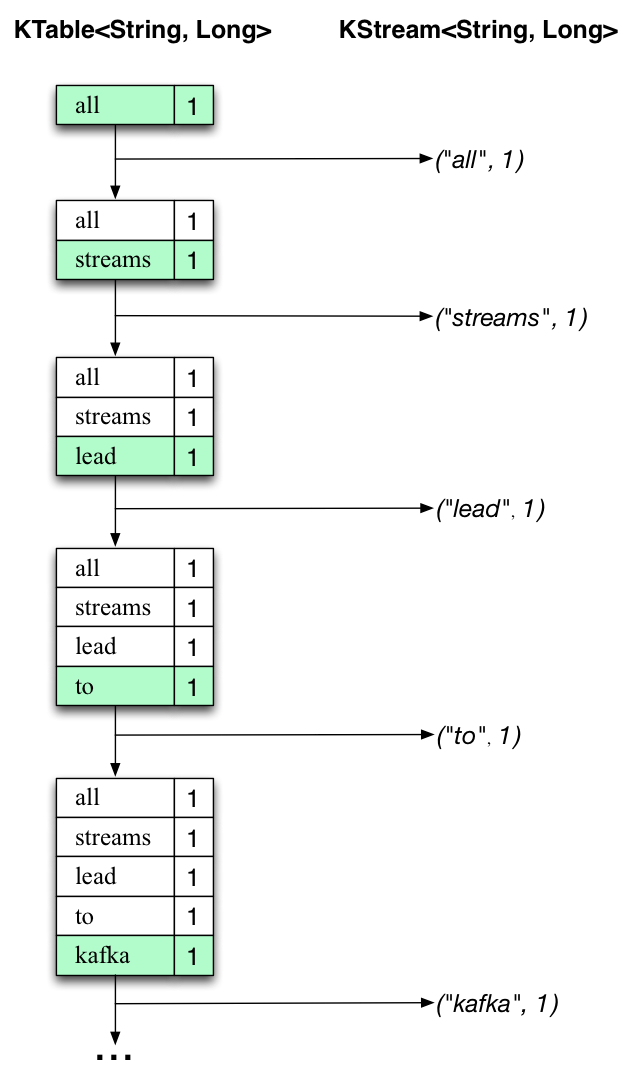
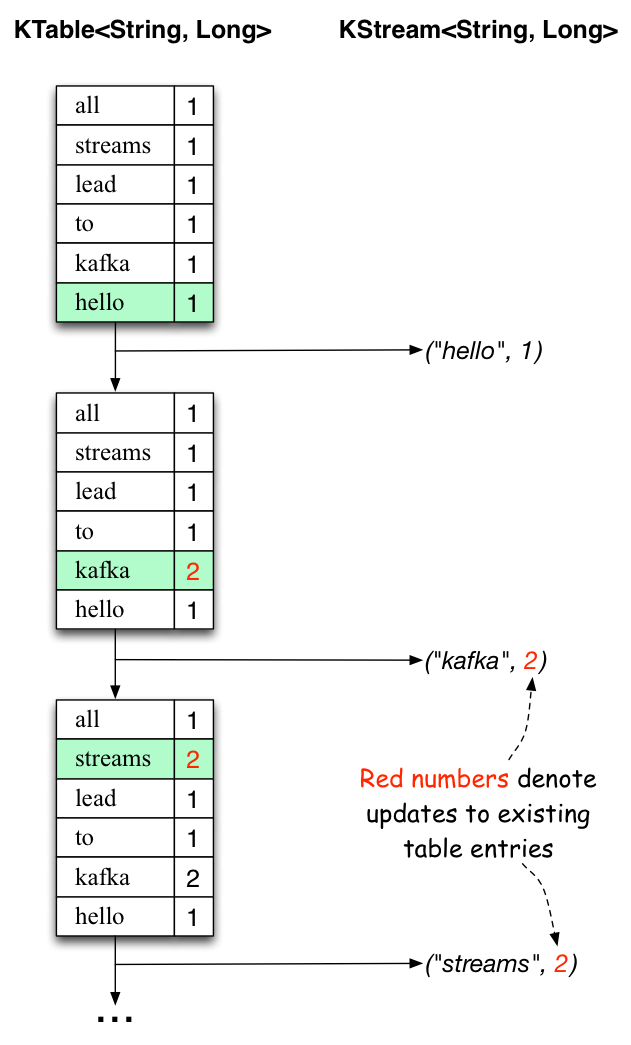
在第一幅图中,正在处理文本行“all streams lead to kafka”。随着每个新单词产生一个新表条目(以绿色背景突出显示),将建立KTable,并将相应的更改记录发送到下游KStream。
处理第二个文本行“ hello kafka streams”时,我们第一次观察到KTable中的现有条目正在更新(此处:单词“ kafka”和“ streams”)。同样,更改记录将发送到输出topic。
依此类推。这解释了为什么输出主题具有上面显示的内容,因为它包含更改的完整记录。
Kafka Streams在此所做的工作是利用了table与changelog流之间的关系(注意:table = KTable,changelog流=下游KStream):我们可以将此table的任何一个改动都发布成一个流,如果从头到尾使用整个changelog流,则可以重现表的内容。


 扫一扫


 1617

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


