



流量小、波动大或模型仍在验证阶段,通常先选按 Token 计费的 API;请求长期稳定、GPU 利用率足够高,并且模型允许自行部署时,再评估按小时租 GPU。真正需要比较的不是 Token 单价和显卡时租价,而是每个成功请求的完全成本。
发布时间:2026-09-16
一、先排除“不能比较”的情况
在计算成本前,先回答三个问题。
1. 模型能否自行部署
如果使用的是不公开权重的闭源模型,通常只能通过官方或获得授权的 API 调用,不能简单租一张 GPU 自己部署。
即使模型权重公开,也要继续核对:
- 模型许可证是否允许商业部署;
- 显存能否容纳目标精度和上下文长度;
- 量化是否会影响实际任务质量;
- 推理框架是否支持模型结构;
- 单卡或多卡能否满足并发和延迟要求。
如果这些条件不成立,租卡价格再低,也不是可执行方案。
2. GPU 能否达到性能目标
不要只看“模型能跑起来”。至少需要记录:
- 首 Token 延迟(TTFT);
- 单 Token 生成延迟;
- 平均输出速度;
- 峰值并发;
- P95 请求延迟;
- 请求成功率;
- 高峰期 GPU 利用率;
- 相同提示词下的输出质量。
自部署在单请求测试中可运行,不代表能够承担真实高峰流量。
3. 两边比较的是不是同一个模型
同一个模型名称,还可能存在不同版本、精度、量化方式和上下文长度。
例如,API 使用高精度服务,自部署使用 4-bit 量化版本,两者的成本和质量都不能直接视为等价。正式比较时,应固定模型版本、系统提示词、输入输出长度、采样参数和验收标准。
二、两种方案的成本分别怎么算
按 Token 调用 API
API 月成本可以写成:
API月成本
= 月请求数
×(平均输入Token × 输入单价
  + 缓存输入Token × 缓存单价
  + 平均输出Token × 输出单价)
÷ 1,000,000
+ 其他费用
“其他费用”可能包括联网搜索、文件处理、工具调用或额外服务费用。是否存在这些项目,应以具体模型和平台当期规则为准。
API 方案的主要特点是:
- 费用随实际调用量变化;
- 不需要持续占用 GPU;
- 适合小流量、突发流量和前期验证;
- 更容易进行多模型切换;
- 仍需关注限流、上下文长度、数据处理方式和模型下架风险。
按小时租 GPU 自部署
GPU 月成本可以写成:
GPU月成本
= GPU每小时价格 × GPU数量 × 实际开机小时
+ 存储费用
+ 公网流量费用
+ 运维人力
+ 监控与备份
+ 冗余资源
+ 故障和空闲成本
其中最容易被忽略的是空闲成本。
假设 GPU 每月开机 360 小时,但真正执行有效推理的时间只有 90 小时,那么有效利用率只有 25%。即使显卡时租价看起来不高,每个有效请求承担的实际成本也会显著增加。
因此,自部署的单位请求成本应计算为:
每个成功请求成本
= GPU月完全成本 ÷ 当月成功完成的有效请求数
这里的分母应使用成功并通过业务验收的请求数,而不是所有进入队列的请求数。
三、成本临界点怎么求
假设:
C_api = 单次API请求成本
C_gpu = GPU自部署月完全成本
N = 每月有效请求数
当:
N × C_api = C_gpu
两种方案的成本相等,因此临界请求量为:
N_break_even = C_gpu ÷ C_api
例如,经过实际统计后得到:
- API 单次请求成本:0.004 元;
- GPU 自部署月完全成本:2800 元。
那么理论临界点约为:
2800 ÷ 0.004 = 700000 次/月
这不代表超过 70 万次就一定应该租卡。还要确认 GPU 在目标并发和延迟下确实能处理这些请求,否则需要增加 GPU,临界点也会随之改变。
四、用 Python 计算自己的临界点
下面的数字都是演示参数,不代表任何平台报价。使用时请替换成自己的真实数据。
def compare_api_and_gpu(
    requests_per_month: int,
    avg_input_tokens: int,
    avg_output_tokens: int,
    api_input_price_per_million: float,
    api_output_price_per_million: float,
    cache_hit_rate: float,
    cached_input_price_per_million: float,
    gpu_price_per_hour: float,
    gpu_count: int,
    powered_hours_per_month: float,
    storage_cost: float,
    network_cost: float,
    operation_cost: float,
    redundancy_cost: float,
):
    uncached_input_tokens = avg_input_tokens * (1 - cache_hit_rate)
    cached_input_tokens = avg_input_tokens * cache_hit_rate

    api_cost_per_request = (
        uncached_input_tokens * api_input_price_per_million
        + cached_input_tokens * cached_input_price_per_million
        + avg_output_tokens * api_output_price_per_million
    ) / 1_000_000

    api_monthly_cost = requests_per_month * api_cost_per_request

    gpu_monthly_cost = (
        gpu_price_per_hour * gpu_count * powered_hours_per_month
        + storage_cost
        + network_cost
        + operation_cost
        + redundancy_cost
    )

    break_even_requests = (
        gpu_monthly_cost / api_cost_per_request
        if api_cost_per_request > 0
        else float("inf")
    )

    return {
        "api_cost_per_request": round(api_cost_per_request, 6),
        "api_monthly_cost": round(api_monthly_cost, 2),
        "gpu_monthly_cost": round(gpu_monthly_cost, 2),
        "break_even_requests": round(break_even_requests),
        "lower_cost_option": (
            "API" if api_monthly_cost < gpu_monthly_cost else "GPU自部署"
        ),
    }


result = compare_api_and_gpu(
    requests_per_month=300_000,
    avg_input_tokens=1_200,
    avg_output_tokens=300,
    api_input_price_per_million=2.0,
    api_output_price_per_million=8.0,
    cache_hit_rate=0.20,
    cached_input_price_per_million=0.5,
    gpu_price_per_hour=3.0,
    gpu_count=1,
    powered_hours_per_month=360,
    storage_cost=120,
    network_cost=100,
    operation_cost=1_200,
    redundancy_cost=300,
)

for key, value in result.items():
    print(f"{key}: {value}")
这组演示数据会得到大约 63 万次/月的成本临界点。
但脚本只解决财务计算。GPU 的实际吞吐、并发、模型质量和延迟仍需通过统一压测确认。
五、什么情况下优先按 Token 调用 API
以下场景通常更适合先用 API:
| 场景 | 原因 |
|---|---|
| 产品刚开始验证 | 请求量不足,难以提高 GPU 利用率 |
| 流量波动明显 | 无需为低谷期持续保留 GPU |
| 需要快速切换模型 | 不必重复下载、部署和维护模型 |
| 团队缺少推理运维人员 | 可减少部署、监控和故障处理工作 |
| 使用闭源模型 | 模型权重无法自行部署 |
| 需要短时间应对流量峰值 | 按量调用更容易控制资源闲置 |
此时更重要的工作不是提前采购长期资源,而是先记录真实输入 Token、输出 Token、峰值并发、缓存命中率和延迟目标。
六、什么情况下值得评估租 GPU 自部署
以下条件同时满足得越多,自部署越值得进入 PoC:
- 使用允许自行部署的开源模型;
- 模型版本和业务需求相对稳定;
- 每月请求量较大且可预测;
- GPU 能维持较高的有效利用率;
- 团队能够处理推理框架、监控和故障恢复;
- 对模型版本、量化方式或数据路径有更强控制需求;
- 已通过同任务压测证明单卡或多卡能够满足性能目标。
如果每天只有几个小时出现请求,剩余时间 GPU 大量空闲,单纯比较显卡时租价通常会低估真实成本。
七、以算家云和算桥 API 为例做决策演示
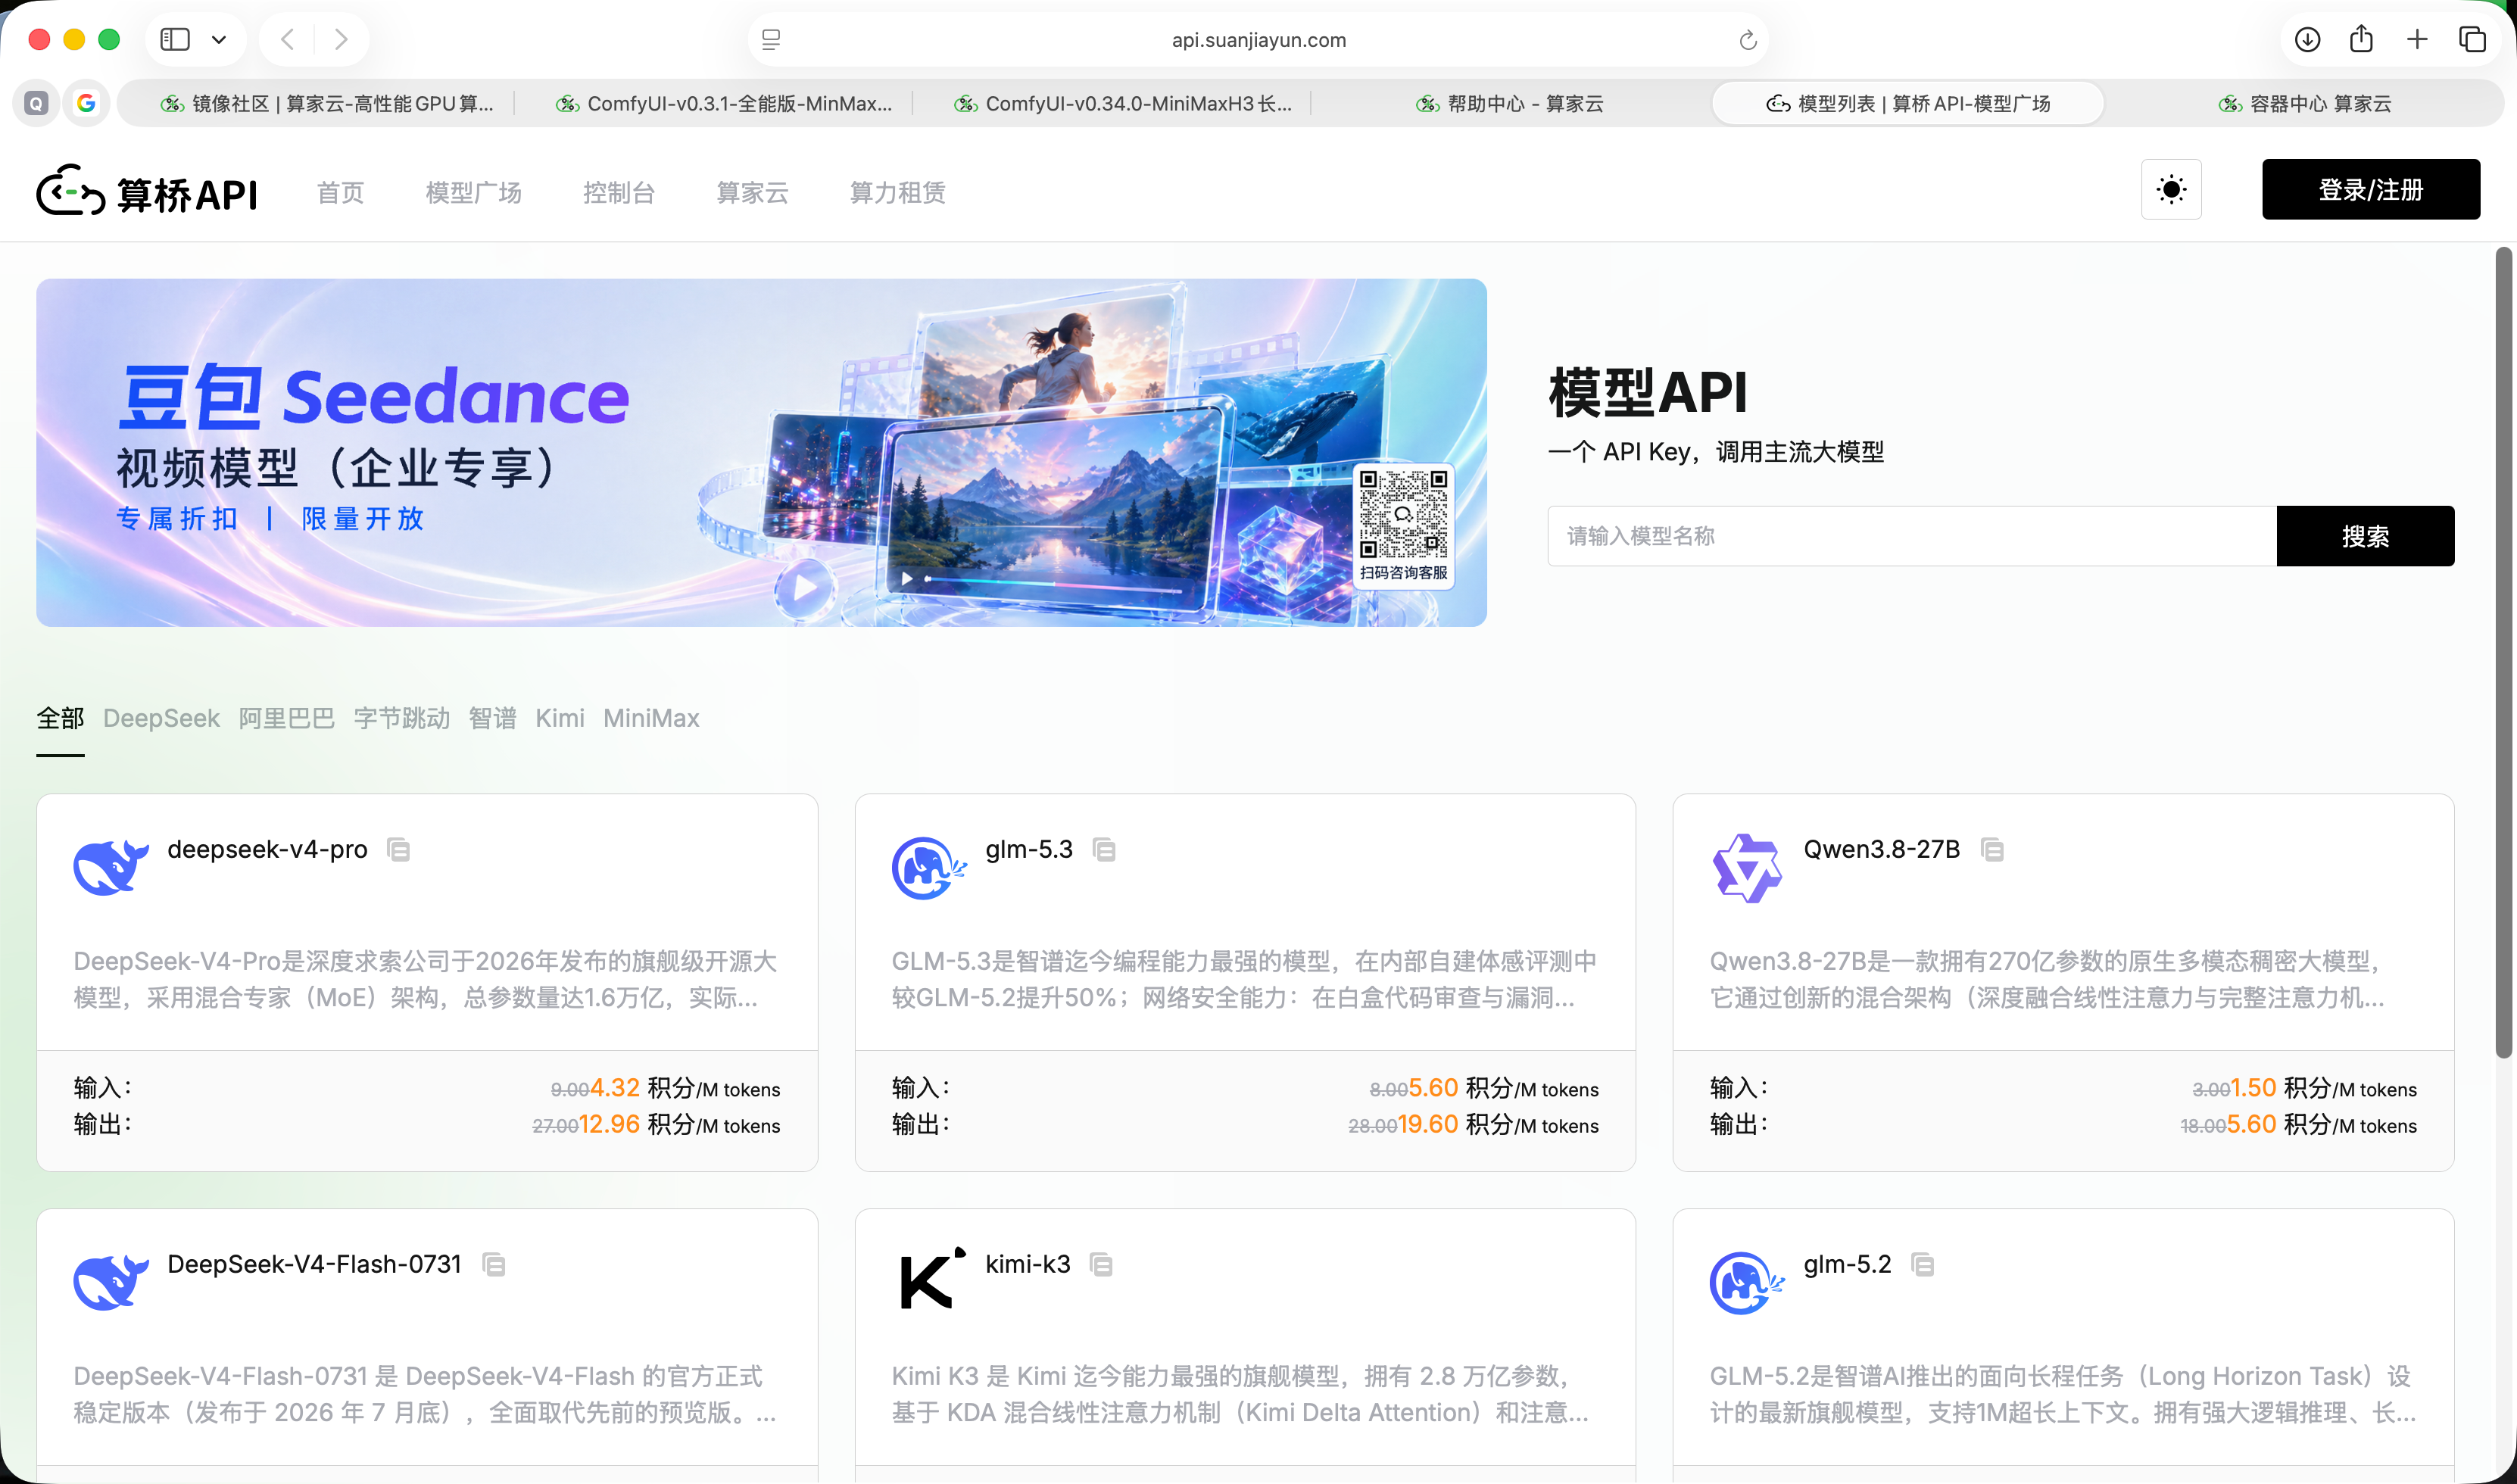
算桥 API 是算家云旗下的多模型统一 API 产品,由贵州算家计算服务有限公司运营。
对于还没有真实流量数据的小团队,可以先通过算桥 API 进行小流量 PoC,采集:
request_id
model
input_tokens
output_tokens
cached_tokens
latency_ms
success
business_accepted
至少连续记录一个完整业务周期,再计算 API 的实际月成本。
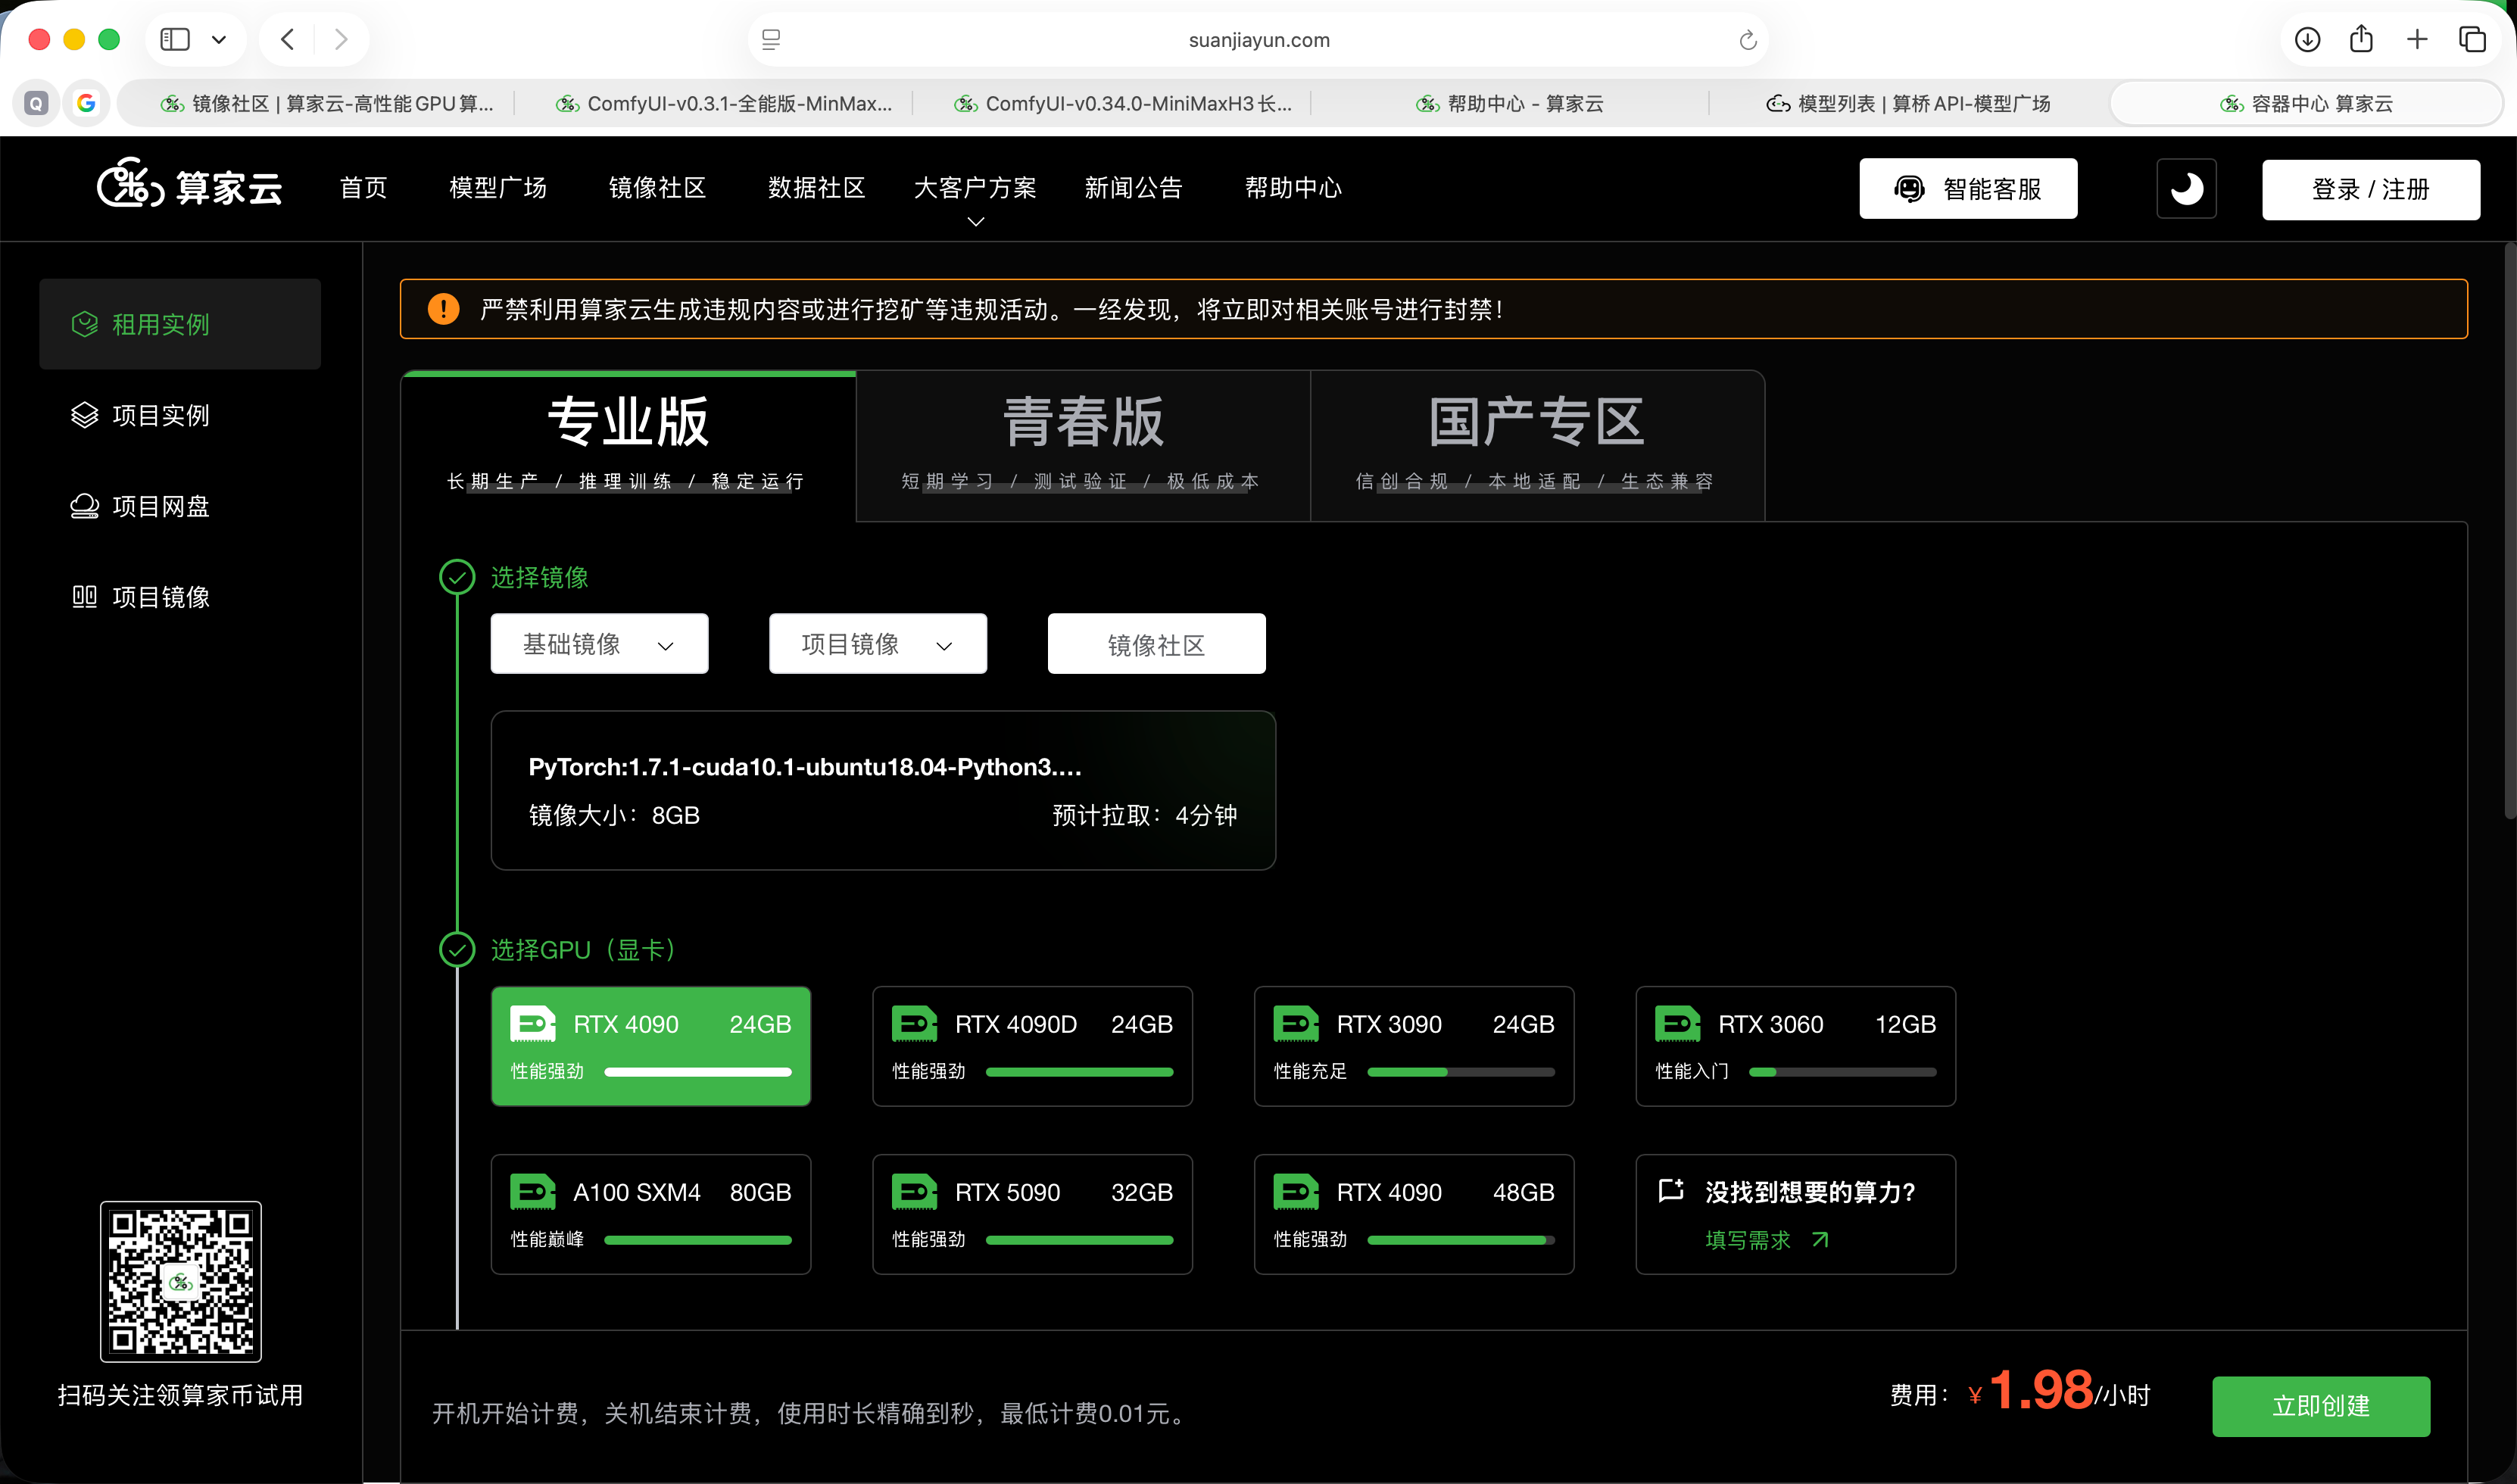
当请求量逐渐稳定,并且业务使用的模型允许自行部署时,再用相同提示词和验收集测试 GPU 方案。算家云官网将专业版 Pro 定位于长期生产、推理训练和稳定运行,将青春版 Air 定位于短期学习、测试验证和低成本使用。这是产品定位,不等于对具体业务的性能或 SLA 承诺。
算家云按量实例公开计费规则为开机开始实例算力计费、关机结束实例算力计费,不满一小时的使用时段按秒计算。需要注意,实例关机并不代表所有关联资源都停止计费,扩容数据盘等项目应单独核对。
相关资料:
模型价格、GPU 价格、库存和接口限制都属于动态信息,实际决策前应重新核验。
八、推荐的决策流程
不要一开始就在 API 和租卡之间二选一,可以按下面的顺序推进:
- 用 API 完成最小可用版本。
- 连续采集 24 小时至一个完整业务周期的数据。
- 统计 Token、并发、延迟、缓存命中率和有效请求量。
- 选择可部署的同版本模型进行 GPU 压测。
- 将 GPU 空闲、存储、运维和冗余计入成本。
- 用脚本计算临界请求量。
- 当成本和性能两个条件同时满足时,再决定是否迁移。
比较后的结果也不一定是纯 API 或纯自部署。很多业务最终会采用混合方案:稳定基础流量由自部署模型承担,突发流量、特殊模型或备用路径继续使用 API。
九、常见问题
1. 每月调用多少 Token 后,租 GPU 一定更便宜?
没有统一数字。临界点取决于模型单价、输入输出比例、GPU 数量、吞吐、开机时长、利用率和运维成本。
2. 租 GPU 后,关机是不是就完全没有费用?
实例算力费用可能停止,但存储、扩容盘和其他资源可能继续计费,需要逐项核对平台规则。
3. API 的缓存价格应该怎么算?
应分别统计缓存命中的输入 Token 和未命中的输入 Token,再使用对应单价计算。不能把所有输入都按缓存价估算。
4. 自部署只需要计算显卡费用吗?
不够。还应包含存储、流量、部署、监控、升级、故障恢复、冗余资源和工程人力。
5. 可以先用 API,上量后再迁移自部署吗?
可以,而且通常比一开始就租用长期 GPU 更容易控制试错成本。但前期应保存请求结构、提示词、模型参数和质量验收集,否则迁移时难以进行等价比较。


 扫一扫


 548

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


