


上周末,一个读者私信我:我面阿里 Agent 架构岗,挂了。复盘的时候面试官只问了一个问题——"你做的 Agent 怎么管理记忆?"他当时答:接个向量数据库,做 RAG 检索。面试官追了两句就笑了,说"你这套停留在 demo 阶段"。
我让他把当时怎么答的、面试官又追问了什么,原原本本发我。看完我回他一句话:你不是能力不行,是没踩过生产的坑。
只靠"向量库 + RAG"回答记忆管理,是大多数人的第一反应,但也恰恰在面试官眼里暴露了同一件事:你没真正跑过生产级 Agent。向量库在精确查找和时间状态管理上有天然劣势。真正的生产级 Agent 记忆,是一套包含分层设计、显式读写策略、时间状态治理和程序性经验沉淀的完整系统。下面我就按当时帮他把这道题拆开的逻辑,一层层讲清楚。
第一层:只靠向量库 + RAG 的四大致命缺陷
第一,仅靠相似度排序,无法区分信息重要程度。向量检索只看语义距离,会把无关琐碎内容优先召回,核心事实容易被淹没。更危险的是语义漂移:稠密向量对否定不敏感,"支持退款"与"不支持退款"向量距离很近,相似度检索分不出真伪,相近向量却可能指向完全相反的事实,容易造成事实性错误。
第二,缺少时间维度与状态治理。向量库不以时间、状态为一等公民,默认只按相似度召回,无法自动区分新旧事实。用户修改信息后,新旧冲突数据会同时存在于向量空间,无法自动覆盖失效记忆,也难以跟踪任务执行的中间状态。
第三,无结构化精确检索能力。向量检索擅长模糊语义匹配,但订单 ID、用户手机号、配置参数这类精确数据,向量*本身*做不了高效的等值查询——精确字段要靠结构化存储或元数据过滤配合;若把这些都塞进纯语义检索,只能全量扫描,线上性能极差。
第四,缺少准入、合并、过期清理机制。全部对话无差别存入向量库,长期运行数据熵增严重。大量冗余、过时、低置信度记忆占用存储、拉高噪声;为凑够召回又被迫往上下文塞大量低质记忆,反而会引发长上下文的"Lost in the Middle"问题。
一句话:向量库是记忆系统的其中一层语义检索工具,绝对不能等同于完整的 Agent 记忆管理。
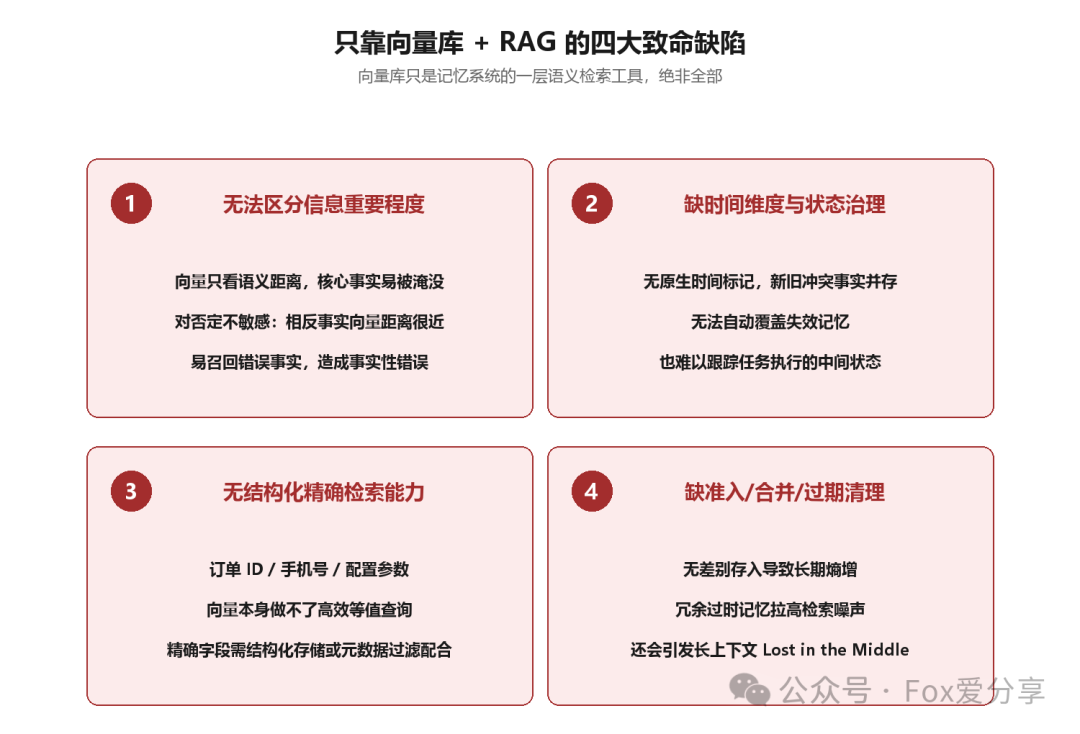
图:纯向量库 + RAG 的四大致命缺陷
第二层:生产级四层冷热分层架构
核心是冷热分层:热数据放内存、低延迟;冷数据落库、可永久检索。四层各管一段生命周期。
|
层级 |
存储介质 |
生命周期 |
核心职责 |
|---|---|---|---|
|
第 0 层 |
LLM 原生上下文 |
单会话临时 |
当前轮实时交互;滑动窗口淘汰老旧对话;摘要压缩省 token;不持久化 |
|
第 1 层 |
Redis 缓存 |
单任务周期 |
结构化任务状态、工具调用临时结果、实时配置;精确键值查询,补向量库短板 |
|
第 2 层 |
Redis Stream |
最近多轮滚动 |
留存单会话原始对话;异步生成摘要;作为长期记忆来源;支撑回溯原文 |
|
第 3 层 |
PostgreSQL 结构化 |
跨会话永久 |
沉淀长期偏好、历史产出、经验反思;仅作兜底语义检索层,写入必经准入过滤 |
注:上表是一种成熟落地形态,不是唯一答案。面试时讲清"为什么这么分"比背层级更重要。
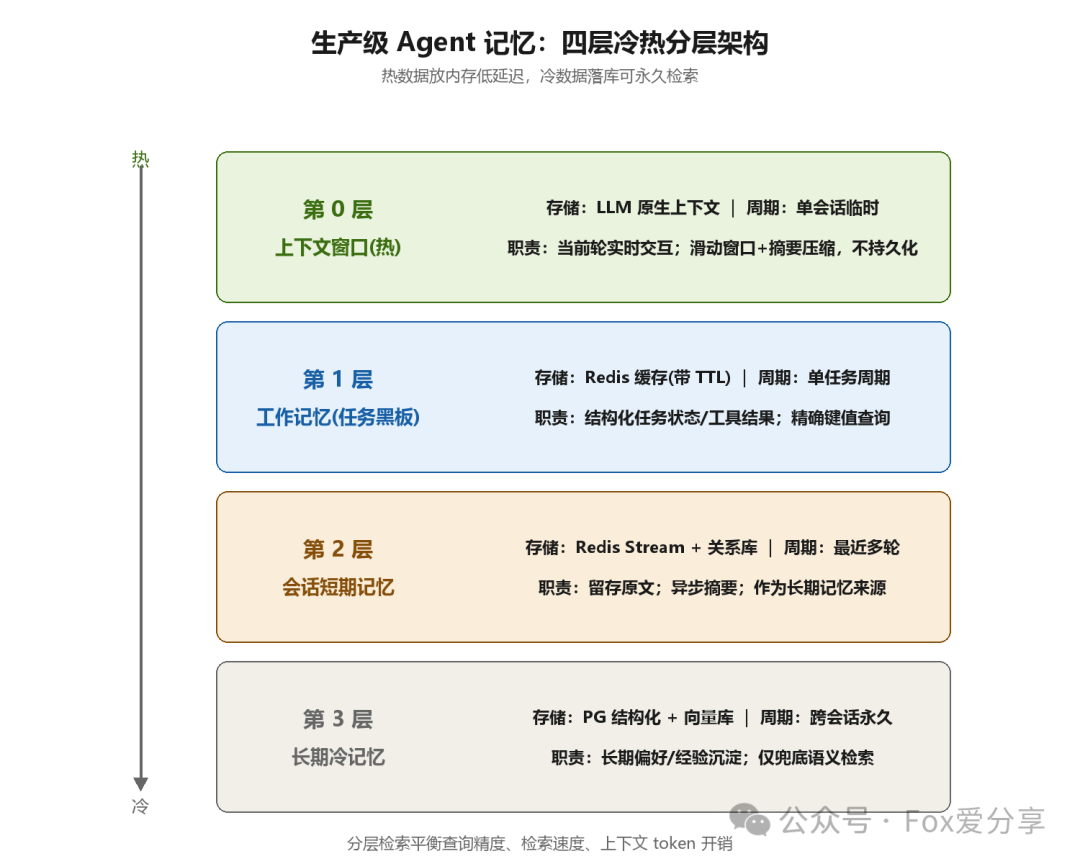
图:四层冷热分层架构
第三层:生产环境三大配套核心机制
机制一:记忆系统三件套(ledger / views / policy)
ledger 原始账本:所有对话与用户事实仅追加写入(append-only),事实内容不可原地修改或物理抹除,保证可溯源、可审计、可追责。合规删除不靠改行,而是追加一条撤回(tombstone)事件。
views 派生视图:基于账本异步生成多种格式——结构化画像入数据库,语义片段向量化入向量库。不同任务读对应视图,降低实时计算压力。更重要的是,智能体定期对账本做反思(reflection):把零散事实升华为经验规则,例如从"用户三次比价后下单"推出"该用户价格敏感"。这正是 Stanford Generative Agents 的核心机制。反思不能每轮都跑——成本太高,通常触发在会话结束、记忆条数超阈值或定时批跑时异步执行,避免拖累在线推理延迟。
policy 管控策略:定义完整生命周期规则——何时写入、哪些允许存、低置信度直接过滤、多久合并相似记忆、过期自动清理、新旧冲突自动淘汰旧数据。
合规提醒:ledger 仅追加 ≠ 永不删除。金融、医疗等受监管场景要支持"被遗忘权"(GDPR / 个保法),做法是追加撤回(tombstone)事件,由独立合规流程维护删除标记,账本原始行不物理抹除,审计链不断。
机制二:双时间戳机制解决事实更新冲突(双时态模型)
这是数据库领域的双时态模型(bitemporal modeling),面试说出术语专业度直接拉满:
real time(真实时间):记录事实在现实世界的有效时间段,比如用户收货地址的有效期。注意 real_end 大多为 NULL(开放有效期),只有等新事实到达时才回溯补齐——把旧记录的 real_end 设为新记录的写入时间,地址类事实就"自动过期"了。
transaction time(写入时间):记录记忆写入系统的时刻。
双时间戳先解决"哪个版本当前生效"的冲突判定——选出 real_time 有效、且未被撤回的版本;再交由机制三的时效性维度计算排序权重。这样用户更新信息后,旧记忆自动失效,不会出现新旧事实混杂召回。
机制三:记忆检索加权打分规则
参考 Stanford Generative Agents 论文(Park et al., 2023),检索结果由三个维度加权综合评分,而非单纯语义相似度:
|
维度 |
含义 |
工程注意点 |
|---|---|---|
|
时效性 |
近期记忆权重更高,随时间衰减 |
用 real time 计算衰减,而非写入时间 |
|
重要性 |
LLM 预打分 1–10,核心偏好高分 |
异步批量预打分,别每次对话都烧 token |
|
相关性 |
与当前提问的向量语义相似度 |
仅作粗召回,最终靠综合分精排 |
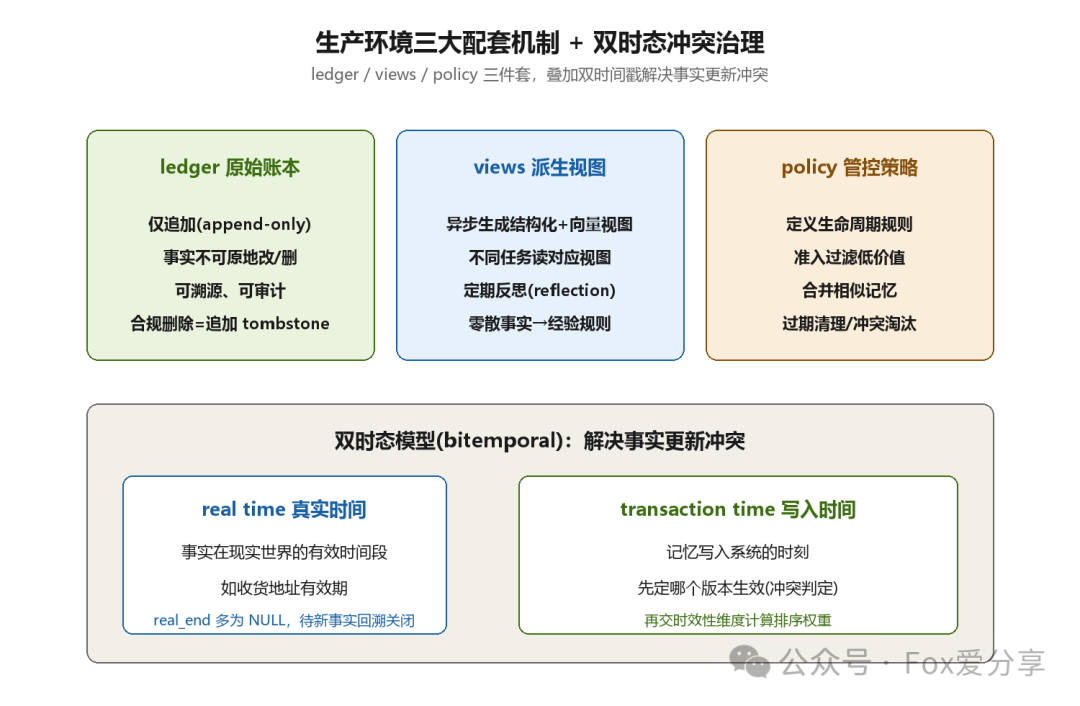
图:三大机制与双时态冲突治理
第四层:完整读写流程(显式读写策略)
写入流程:对话产生新事实 → policy 过滤准入(低价值闲聊直接丢弃)→ ledger 账本追加 → 异步生成结构化视图入数据库、语义片段向量化入向量库 → 自动对比历史,相似记忆合并,冲突旧记忆标记过期。
读取流程:优先读第 0 层上下文窗口 → 需任务状态查第 1 层 Redis 精确键值 → 需近期回溯查第 2 层会话记忆 → 跨会话查历史事实,先结构化库精确匹配,再向量库语义粗召回 → 三维加权精排,过滤过期/低重要 → 注入模型上下文完成推理。
落到表结构,双时态账本大致长这样:
CREATE TABLE memory_ledger (
id BIGINT PRIMARY KEY,
user_id VARCHAR(32),
fact TEXT, -- 事实内容
real_start TIMESTAMP, -- 真实时间:生效起点
real_end TIMESTAMP, -- 真实时间:失效终点(NULL 表示有效)
tx_time TIMESTAMP, -- 写入时间
importance SMALLINT, -- 重要性 1-10
deleted BOOLEAN DEFAULT FALSE -- 合规撤回标记(独立流程维护, 账本行不物理删)
);
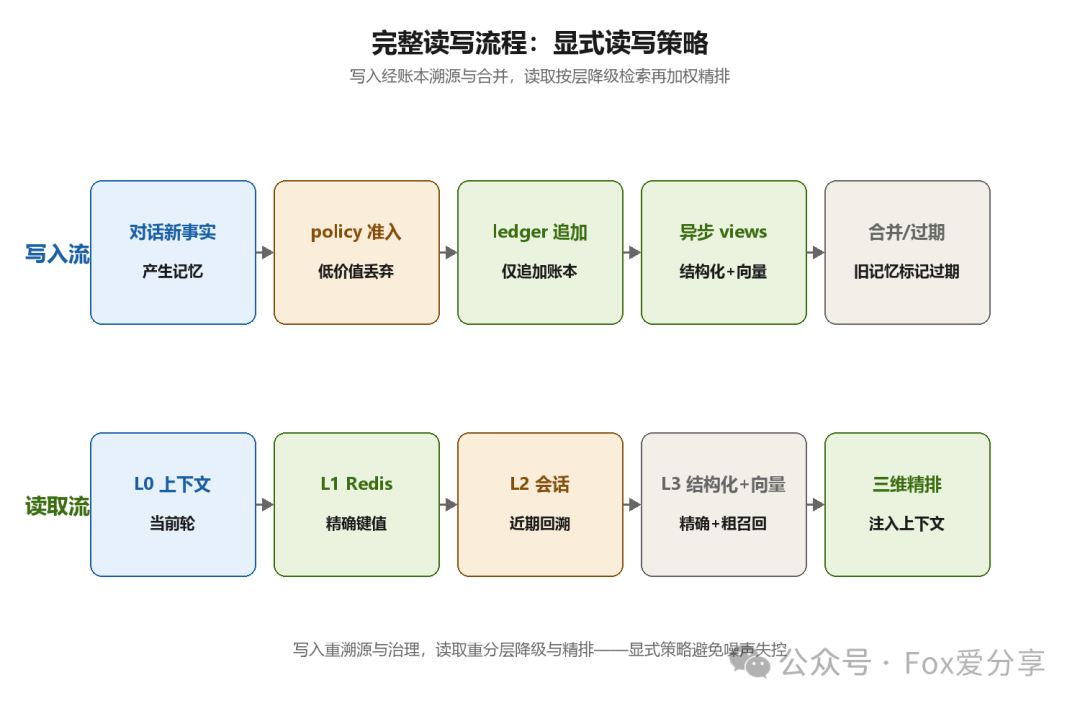
图:完整读写流程(显式读写策略)
第五层:面试加分总结
向量数据库 + RAG 只是记忆系统的其中一层语义检索工具。生产级记忆系统的核心逻辑是:
冷热分层存储,结构化精确检索负责状态与实体查询,向量库仅兜底语义模糊检索;搭配账本溯源、双时间戳冲突治理、记忆生命周期管控三大机制,解决单一向量库的事实冲突、状态丢失、检索噪声、无法精确查找四大线上问题。
这套系统最终带来三大价值:
1. 保证多轮对话、跨会话交互连贯且个性化;
2. 可管控记忆数据,支持审计、清理、更新,避免长期运行数据失控;
3. 分层检索平衡查询精度、检索速度、上下文 token 开销,适配客服、企业知识库、智能体任务规划等场景。
记住一句话:能说清"什么时候不检向量库"的人,才真正懂 Agent 记忆。RAG 是工具,分层与治理才是架构。


 扫一扫


 1030

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


