


本文专为想尝试阅读ultralytics源码并准备尝试修改原模型的同学准备,希望可以帮助大家更好的阅读源码
1 Ultralytics 项目简介
1.1 ultralytics的优点
为什么选ultralytics?这里梳理几个ultralytics的优点
-
团队强大:开源团队来自专注CV领域的公司ultralytics,该公司先后提出了v5、v8、11
-
功能强大:目前已经涵盖v3-11所有YOLO模型,并提供分类、分割、目标跟踪等其他功能
-
更新及时:仓库持续保持更新,功能不断完善
-
文档丰富:该仓库的文档丰富,适合零基础入门
-
接口简洁:对于用户,仅需要少量的修改即可使用YOLO模型
ultralytics是由ultralytics公司开源的计算机视觉算法工具仓库,除了YOLO目标检测系列外,还基于YOLO结构实现图像分类、图像分割、目标跟踪、人体姿态检测等计算机视觉任务。同时还提供了大量的下游任务解决方案代码, 例如物体计数、速度估计和安全预警等。
ultralytics的功能不仅强大,而且接口调用非常简洁,同时具备完整丰富易读的文档。
1.2 ultralytics主要功能
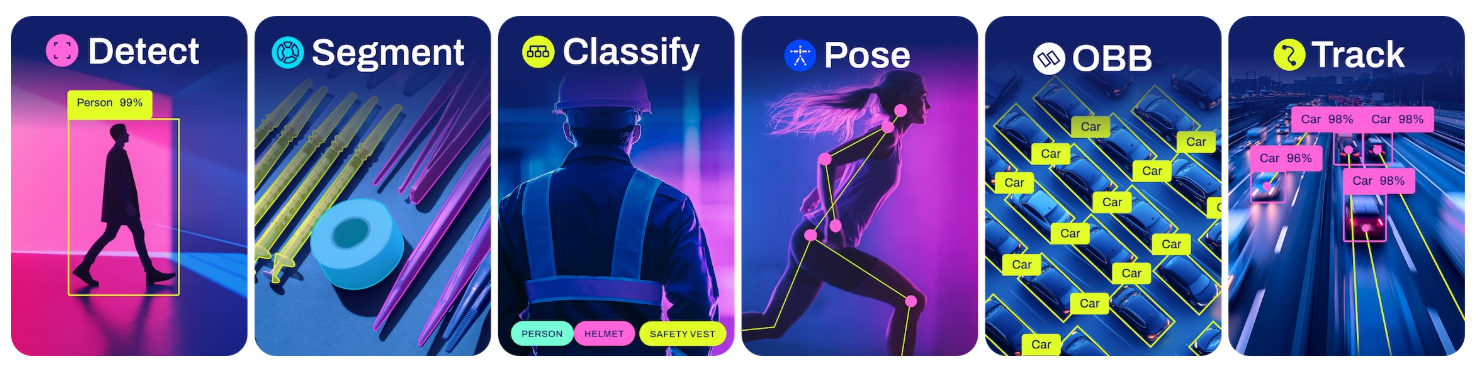
CV基础任务:ultralytics提供了基于YOLO的目标检测、图像分类、图像分割、姿态检测和目标跟踪实现。
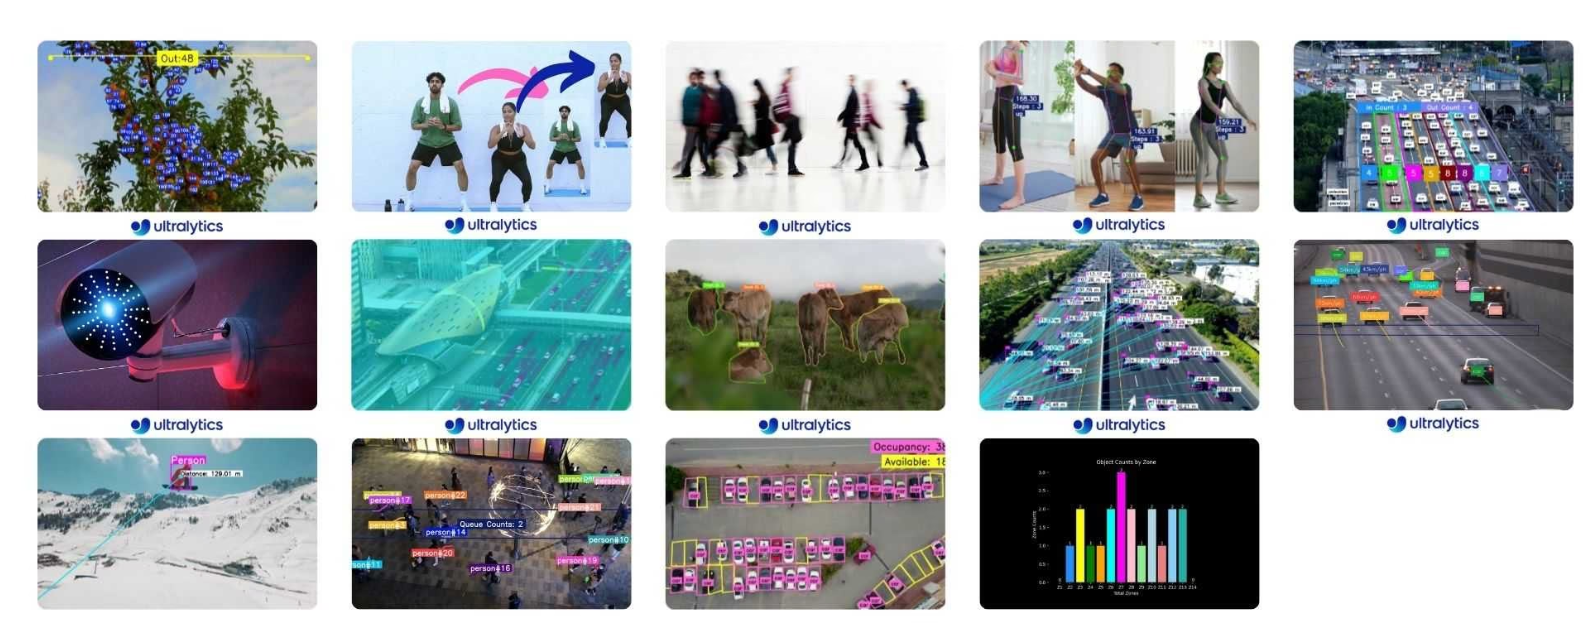
下游任务:物体计数、物体裁剪、物体模糊、锻炼监控、区域物体计数、安全预警系统、热力图、实例分割的物体跟踪,物体举例计算、运动速度估计、排队管理、停车场管理等等。
除了任务方面,在整个算法模型开发环节,提供了全流程工具链,包括:训练、评估、预测推理、模型导出和benchmark对比。
1.3 项目代码结构分析
上面对ultralytics功能和文档进行了简要介绍,下面讲解项目代码结构,这将帮助使用者理解ultralytics运行逻辑,并在未来修改底层代码提供帮助。
这里要强调一点,ultralytics项目与其他常见的项目不同,repo中没有给train.py, predict.py等之类的运行代码,这些实际应用的代码需要大家官方文档自己编写。
ultralytics项目之所以这么做,或许是它们的项目代码封装得太好了,train.py, predict.py之类的代码只需要3行代码就实现,也就没必要单独列出代码。
因此,前面提及的官方文档需要提前阅读,这样才能用好ultralytics提供的工具类。
开源repo最外层是相关的内容,核心代码是位于ultralytics文件夹下,该文件夹下主要内容如下:
├── __init__.py
├── assets: 测试图片
├── cfg: 配置文件,包括数据集、模型、目标跟踪等
├── data: 数据集处理代码,
├── engine: 核心引擎代码,包括YOLO模型结构代码、预测引擎代码、训练器代码
├── hub: Ultralytics Hub登录、连接等相关代码
├── models: 模型定义代码,包含YOLO, SAM, RTDetr,nas等
├── nn: 神经网络模块定义代码,基础组件所在处
├── solutions: 下游任务解决方案代码,如目标跟踪、区域计数、速度估计等
├── trackers: 目标跟踪模块代码,包括具体跟踪算法实现,如bot sort、byte tracker等
└── utils: 工具函数
只看代码结构可能比较抽象,这里以训练一个YOLO模型为例,看看用了什么内容。
三行代码,实现了YOLO的训练,首先是从ultralytics导入YOLO对象,然后实例化,最后调用YOLO对象的train方法实现了整个训练过程。
from ultralytics import YOLO
model = YOLO("yolo11n.yaml")  # build a new model from YAML
results = model.train(data="coco8.yaml", epochs=100, imgsz=640)
由此发现,YOLO类是开放给用户的,内部对于数据集路径的读取、所有图片路径的遍历、标签的读取、损失函数和优化器设置、循环迭代训练这些常规操作均包含在YOLO类(\ultralytics\models\yolo\model.py)
1.4 环境配置
自YOLOv8开始,项目名称不再以YOLO命名,而是以公司名称Ultralytics命名,以此表明该项目不再局限于目标检测,而是一个计算机视觉通用、高效、易用的工具。(由于ultralytics既是仓库名称,也是其公司名称,在后续不特别说明时,均表示该仓库项目名称)
ultralytics 是一家专注于计算机视觉和深度学习技术的公司,先后开发了YOLOv5/v8/11,并将计算机视觉算法打包为SaaS对外提供服务。详情可参考官网:https://www.ultralytics.com/about
官方文档,https://docs.ultralytics.com/在Quickstart章节详细介绍了如何安装,包括pip/conda install安装、git clone 安装和 docker安装三种方式。
1 pip/conda install安装:

pip install ultralytics
conda install -c conda-forge ultralytics


2 git clone从源代码安装,当希望使用最新的ultralytics时可以用这个方式

# 下载仓库
git clone https://github.com/ultralytics/ultralytics
# 进入文件夹
cd ultralytics
# 安装
pip install -e .

3 docker安装, ultralytics提供了多个镜像,可适用于不同场景,例如训练场景、cpu、jetson等终端。

# 拉取镜像
sudo docker pull ultralytics/ultralytics:latest
1.5 ultralytics中面向对象的项目设计模式
为了更清晰了解ultralytics是如何对YOLO封装、设计的,下面绘制了简要的UML图来分解代码设计。(以下部分为进阶内容,对底层代码有修改、理解和分析需求的读者可以阅读本部分)
对于模型训练的代码设计方面,可以分为四大块理解。
-
第一块,YOLO(Model),这是开放给用户的YOLO类,其核心功能实现是继承了Model。Model包含1000多行代码,是核心主体。Model中将训练环节的功能外包给了BaseTrainer, 将模型构建的功能外包给了BaseModel。
-
第二块,BaseTrainer,为了实现深度学习模型训练环节的各个步骤,特地设计了这个类。其中与用户最密切的是数据集创建,关于数据集的功能外包给了BaseDataset。
-
第三块,BaseDataset,这里实现对用户传入的yaml中的路径进行检索遍历,获取图片、标签路径,并进行加载等一系列数据集相关的操作。
-
第四块,BaseModel,所有的模型基类,对于该项目核心是目标检测模型,因此有DetectionModel继承于此,目标检测下还有旋转目标检测,因此有了OBBModelModel。
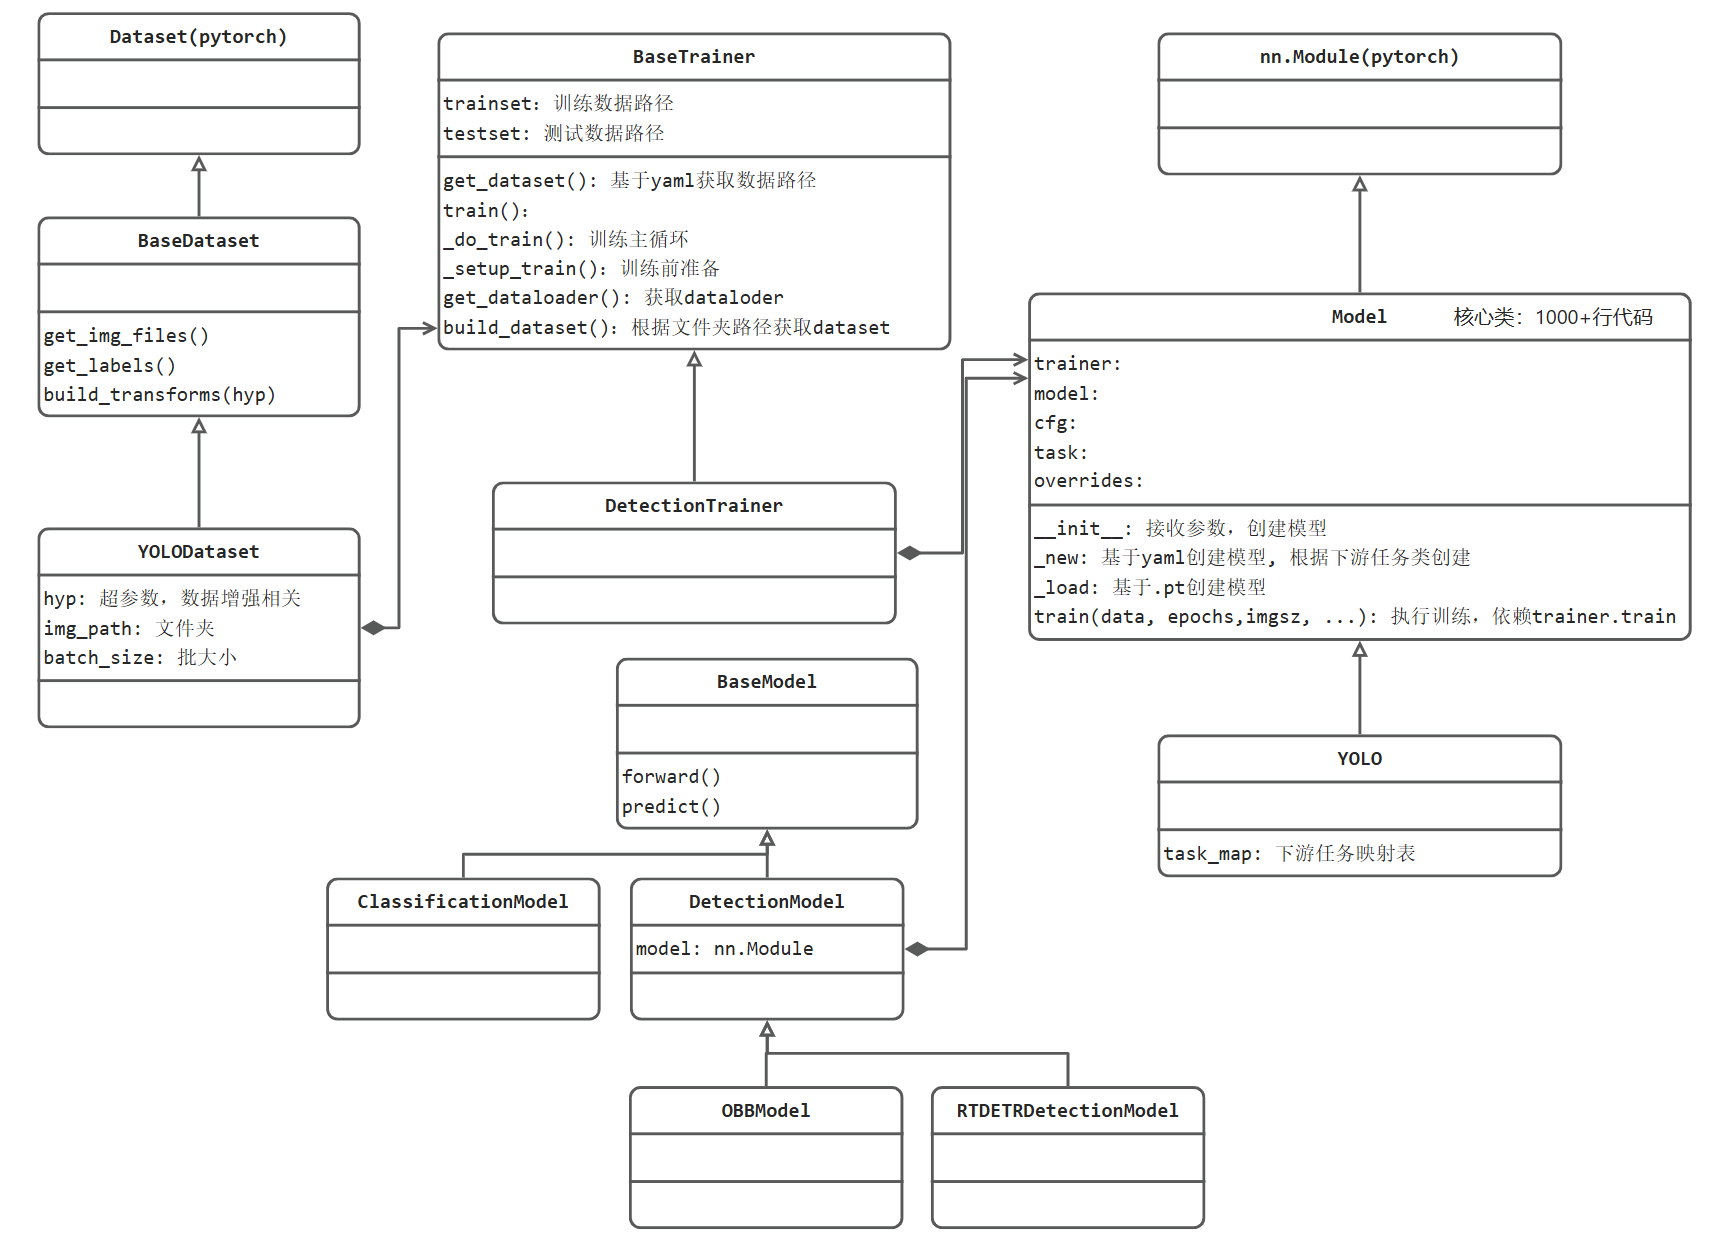
以上是自底向上的分析,属于用户角度。但对于项目开发团队,应当自顶向下规划设计,从以上UML看出这非常符合面向对象的逻辑,将相同的功能提炼、抽象、封装。数据模块、模型模块、训练模块均进行了面向对象设计,相当规范,手动点赞。
1.6 ultralytics项目使用流程逻辑
得益于项目的高度封装,用户仅需要传入配置文件,使用YOLO对象的接口即可完成YOLO目标检测算法的训练、评估和推理。
这里简要介绍与用户高度相关的操作流程和步骤。
第一,数据。用户的数据集通过yaml配置文件形式传入,只需要将数据集制作成YOLO格式,然后编写yaml文件即可。
第二,模型。用户可通过yaml或者.pt文件选择所需要的YOLO模型,这块可参考文档中提供的模型,下载对应权重即可。
第三,训练。训练过程的超参数可通过yaml配置文件,或者是函数入参直接赋值,这部分将在下面章节介绍。
第四,评估,同上。
第五,推理,推理过程使用的是YOLO对象中集成的Predictor对象,用户只需了解入参有哪些即可。
2 源码文件推荐阅读
2.1 ultralytics/nn/modules目录下的多个文件
2.1.1 block.py (多个主要模块)
2.1.1.1 SPPF模块(Spatial Pyramid Pooling - Fast)
SPPF模块是一种改进的空间金字塔池化(SPP)结构,通过在主干网络提取的特征图上施加 多个串联的最大池化操作(通常是相同 kernel size,例如 5x5),从而以更少的计算开销提取多尺度上下文信息。
其能够增强模型的感受野(Receptive Field),一般情况下,卷积层的感受野有限,尤其在浅层特征图中难以覆盖全局信息。SPPF 通过多次串联的大核大小池化(如 5x5 max pooling),以非常小的计算成本模拟大感受野的效果。另外,池化后的特征图保留了不同级别的语义信息(逐步抽象),代表不同尺度的结构。SPPF 将多个池化层的输出与原始输入进行拼接(concat),融合了局部+全局+中间尺度的信息。相较于传统的 SPP,SPPF 使用的是串联池化而不是并联,结构更简单,参数和计算量更低。其代码在介绍ultralytics/cfg/models文件夹的部分(2.b)。
2.1.1.2 C2f(CSP BottleNeck with 2 convolutions)
C2f 模块是 YOLOv8 中引入的一个结构优化模块,旨在进一步提升网络效率与性能。它是 YOLOv5 中的 CSP(Cross Stage Partial)结构的轻量变种,主要作用是减少冗余计算、提升特征复用,同时保持或提升检测精度。换句话说,C2f(Concatenate to fusions)通过减少中间通道传输冗余,提升轻量化模型的特征表达能力与计算效率。其代码如下所示:
class C2f(nn.Module):
    """Faster Implementation of CSP Bottleneck with 2 convolutions."""
    def __init__(self, c1, c2, n=1, shortcut=False, g=1, e=0.5):
        super().__init__()
        self.c = int(c2 * e)  # 隐藏层通道数(e为扩展系数)
        self.cv1 = Conv(c1, 2 * self.c, 1, 1)  # 通道倍增卷积
        self.cv2 = Conv((2 + n) * self.c, c2, 1)  # 特征聚合卷积
        self.m = nn.ModuleList(
            Bottleneck(self.c, self.c, shortcut, g, k=((3, 3), (3, 3)), e=1.0)
            for _ in range(n))  # Bottleneck堆叠

    def forward(self, x):
        y = list(self.cv1(x).chunk(2, 1))  # 通道切分 [part1, part2]
        y.extend(m(y[-1]) for m in self.m)  # 增量处理part2
        return self.cv2(torch.cat(y, 1))  # 全量特征拼接
2.1.1.3 PSA模块(position-sentitive Attention)
PSA是一种 显式引入空间位置信息 的注意力机制,它不像标准的注意力机制那样仅对全局内容建模,而是让模型在关注内容的同时感知“在哪”发生了这些特征。标准的自注意力(如 Transformer)对空间位置不敏感,它们更关注通道或全局内容相关性,但在视觉任务中位置信息 = 结构、边界、相对位置,失去位置意味着模糊目标边界或特征定位不准确,因此,“位置敏感”就是让注意力机制知道自己在关注哪个区域,并按位置决定关注强度。
class PSA(nn.Module):
    def __init__(self, c1, c2, e=0.5):
        super().__init__()
        assert c1 == c2
        self.c = int(c1 * e)  # 注意力支路通道数
        self.cv1 = Conv(c1, 2*self.c, 1)        # 通道倍增分割
        self.cv2 = Conv(2*self.c, c1, 1)        # 特征融合

        # 自适应头数计算:总通道//64(最小1头)
        self.attn = Attention(self.c, attn_ratio=0.5, num_heads=max(1, self.c//64))

        # 扩张式FFN:Conv1x1升维→Conv1x1降维
        self.ffn = nn.Sequential(
            Conv(self.c, 2*self.c, 1),
            Conv(2*self.c, self.c, 1, act=False)
        )

    def forward(self, x):
        a, b = self.cv1(x).split([self.c, self.c], dim=1)  # 通道均分
        b = b + self.attn(b)          # 残差注意力
        b = b + self.ffn(b)           # 残差FFN
        return self.cv2(torch.cat((a, b), 1))  # 双支路融合
2.1.1.4 C2fAttn(C2f with Attention)
C2f-Attn 是在标准的 C2f 模块中引入注意力机制,用于进一步提升特征表示能力,让模块不仅融合不同路径特征,还能“关注更重要的通道或空间位置”。比起C2f来说,C2fAttn使用通道注意力提升重要特征响应,引入空间注意力(如 CBAM/PSA)解决C2f不具备空间选择能力的问题。另外,通过注意力机制聚焦关键区域,并且注意力模块能可自动抑制无关信息。
class C2fAttn(nn.Module):
    """C2f 模块(Concatenate-to-Fusion)增强版,集成了注意力机制(如 MaxSigmoidAttnBlock)。"""

    def __init__(
        self,
        c1: int,   # 输入通道数
        c2: int,   # 输出通道数
        n: int = 1,  # Bottleneck 块的数量
        ec: int = 128,  # Attention 的嵌入通道数
        nh: int = 1,    # Attention 的多头数量
        gc: int = 512,  # Attention 的引导特征通道数
        shortcut: bool = False,  # 是否使用残差连接
        g: int = 1,      # 卷积分组数
        e: float = 0.5   # 通道扩展比例,用于控制 Bottleneck 的隐藏通道维度
    ):
        super().__init__()

        # 计算中间层通道数(hidden channels),通常为输出通道数的 e 倍
        self.c = int(c2 * e)

        # 第一个卷积层,将输入特征通道映射到 2 × hidden 通道,用于后续拆分
        self.cv1 = Conv(c1, 2 * self.c, 1, 1)

        # 构造 n 个 Bottleneck 块,输入和输出都是 hidden 通道
        # Bottleneck 内部通常包含卷积 + 残差
        self.m = nn.ModuleList(
            Bottleneck(self.c, self.c, shortcut, g, k=((3, 3), (3, 3)), e=1.0) for _ in range(n)
        )

        # 第二个卷积层:将 concat 的所有特征统一映射为 c2 通道
        self.cv2 = Conv((3 + n) * self.c, c2, 1)

        # 加入一个注意力模块,通常是 MaxSigmoidAttnBlock(结合最大池化 + sigmoid)
        self.attn = MaxSigmoidAttnBlock(self.c, self.c, gc=gc, ec=ec, nh=nh)
    def forward(self, x: torch.Tensor, guide: torch.Tensor) -> torch.Tensor:
        """
        正向传播主函数,使用 chunk() 拆分输入通道,并加入注意力引导。
        guide: 引导特征图(可来自高层或引导网络)
        """
        # 将输入 x 通过 cv1 映射为 2 * c 通道后,沿通道维度拆分为两份
        y = list(self.cv1(x).chunk(2, 1))

        # 对每个 Bottleneck 块进行逐级计算,每次都以上一个输出为输入
        y.extend(m(y[-1]) for m in self.m)

        # 在最后一层 Bottleneck 输出上引入注意力模块(使用 guide 特征图引导)
        y.append(self.attn(y[-1], guide))

        # 将所有中间输出 concat 后,通过卷积映射为 c2 通道输出
        return self.cv2(torch.cat(y, 1))
    def forward_split(self, x: torch.Tensor, guide: torch.Tensor) -> torch.Tensor:
        """
        使用 split() 替代 chunk() 的正向传播(更灵活,不要求均匀分割)。
        """
        # 这里 split((c, c)) 显式指定通道数的切分方式(相比 chunk 更稳定)
        y = list(self.cv1(x).split((self.c, self.c), 1))

        # 与 forward 一致,执行串行 Bottleneck + 注意力
        y.extend(m(y[-1]) for m in self.m)
        y.append(self.attn(y[-1], guide))

        # 输出通道融合
        return self.cv2(torch.cat(y, 1))
2.1.1.5 SPPELAN(SPP-ELAN)
SPPELAN是一种结合了SPP(Spatial Pyramid Pooling,空间金字塔池化)和ELAN(Efficient Layer Aggregation Network,高效层聚合网络)的改进机制。在 SPP 之后加入 ELAN 聚合结构,增强了多尺度特征间的信息流动和层间互补,同时提升了语义表达能力,特别是在检测小目标或复杂背景下效果显著
class SPPELAN(nn.Module):
    """SPP-ELAN 模块:结合 SPP(空间金字塔池化)与 ELAN(高效层聚合)的结构。"""

    def __init__(self, c1: int, c2: int, c3: int, k: int = 5):
        """
        初始化 SPP-ELAN 模块。

        Args:
            c1 (int): 输入特征图的通道数(Input channels)。
            c2 (int): 输出特征图的通道数(Output channels)。
            c3 (int): 中间通道数(Intermediate feature channels,用于池化前卷积映射)。
            k (int): 最大池化核大小,决定感受野大小(如5表示5×5 kernel)。
        """
        super().__init__()

        # 设置中间通道数
        self.c = c3

        # Step 1: 将输入特征图通过 1x1 卷积降维到 c3 通道
        self.cv1 = Conv(c1, c3, 1, 1)

        # Step 2-4: 三个独立的 MaxPool 层(均为核大小 k,步长为1,padding自动对齐)
        # 注意:三次池化操作是串联在一起使用同一个输入的(不是堆叠)
        self.cv2 = nn.MaxPool2d(kernel_size=k, stride=1, padding=k // 2)
        self.cv3 = nn.MaxPool2d(kernel_size=k, stride=1, padding=k // 2)
        self.cv4 = nn.MaxPool2d(kernel_size=k, stride=1, padding=k // 2)

        # Step 5: 将 4 个特征图(原始+3个池化)拼接后的通道数映射回 c2
        self.cv5 = Conv(4 * c3, c2, 1, 1)
    def forward(self, x: torch.Tensor) -> torch.Tensor:
        """执行 SPP-ELAN 的正向传播过程。"""

        # 对输入进行 1×1 卷积映射(降维/通道压缩)
        y = [self.cv1(x)]

        # 对降维后的结果 y[-1] 分别进行三次最大池化(感受野增强)
        # 每个池化层都是独立作用于 y[-1] 的(而不是层层堆叠)
        y.extend(m(y[-1]) for m in [self.cv2, self.cv3, self.cv4])

        # 将原始特征和三个池化后的特征图按通道维拼接 → [B, 4*c3, H, W]
        out = torch.cat(y, dim=1)

        # 再通过 1×1 卷积映射为最终输出通道数 c2
        return self.cv5(out)
2.2 ultralytics/cfg目录下的多个文件
2.2.1 datasets文件夹 (数据集)
datasets文件夹中是不同类型数据集对应的yaml文件,例如ImageNet.yaml、VOC.yaml、coco.yaml等。这里对yaml文件做一个简单的介绍:
YAML(YAML Ain't Markup Language)是一种人类可读的数据化语言,设计初衷是以简洁、清晰的方式表示层次化的数据结构。与传统的XML和json相比,YAML更加强调语义表达的直观性和书写的轻便性,因而在文件配置、数据交换、实验参数管理等方面被广泛采用。
这里以VOC.yaml为例进行分析:
首先定义了数据集的路径(path),以及其中的训练集(train)、验证集(val)和测试集(test)的相对路径。我们能够看到,在训练集和验证集中出现了VOC2007和VOC2012两个不同的子数据集,这表明我们的数据集可以是将来自多个数据源的图像合并为一个统一的数据集。接下来是关于类别(classes),在这里定义了目标检测的所有类别的编号以及名称(names)。
在前面定义好数据集的相关内容之后,接下来就是在线下载数据集以及将VOC格式转为YOLO格式的Python代码。
2.2.2 models文件夹 (模型架构)
models文件夹中包含不同版本的模型架构,例如11、12、v10以及一些更早的版本,而每种版本的模型由于执行任务或者规模的不同,也会分为许多不同的模型架构,例如11里面也有yolo11.yaml、yolo11-cls.yaml(侧重于分类任务)、yolo11-obb.yaml(侧重于含有倾斜目标框的任务)、yolo11-pose.yaml(侧重于人体姿态检测)、yolo11-seg.yaml(侧重于目标分割任务)等等。这里以yolo11.yaml为例进行分析:
首先,nc代表种类数,这里默认的是coco数据集的80个种类。接下来的scales代表模型缩放系数(model scaling factors),它是一个长度为3的形如[depth,width,max_channels]的list:depth代表网络深度系数(depth multiplier),代表网络层数的缩放程度;width代表通道宽度系数(width multiplier),代表通道数的缩放程度;max_channels代表最大通道数(maximum channels),代表对于通道数最大值的限制。这里给出了yolo11n(nano)、yolo11s(small)、yolo11m(medium)、yolo11l(large)、yolo11x(xlarge)的模型缩放系数、层数、参数量、大小等信息,能够看出yolo11n的规模较小、较为轻量;而yolo11x的规模庞大,参数量大。
其次是主干网络(backbone)的部分,其格式是[from,repeats,module,args],其中from表示当前层的输入来源,如果from=-1,就代表当前层的输入来自上一层的输出;repeats表示重复次数;module代表模块名称,而args就代表该模块的一些参数。
例如第一层,[-1,1,conv,[64,3,2]],不难看出这是一个卷积层,其输出为64通道,在卷积时使用3×3的卷积核,且卷积步长为2,此时分辨率会减半。我们可以通过如下的代码进行查看这个卷积层的具体信息:
from ultralytics import YOLO
model=YOLO("yolo11.yaml")
print(model.model.model[0])
能够得到
Conv2d(3,64,kernel_size=(3,3),stride=(2,2),padding=(1,1),bias=False)而C3k2层是C3模块(Cross Stage partial Network)的优化版本,C3模块是一种多分支模块,除过基本的卷积层以外,还有一个残差分支(ShortCut Path),这个残差分支直接传递输入信息,最后使用特征拼接(Concat)合并两分支的输出。C3k2在其基础上降低了计算量和参数量,打破了传统的标准卷积,采用了深度的可分离卷积和小核优化。例如[-1,2,C3k2,[256,False,0.25]]中,256代表输出层特征图的通道数,False代表这里并未使用残差连接,而0.25代表模块内瓶颈层(BottleNeck)的通道压缩比例。
class C3k2(nn.Module):
    def __init__(self,c1,c2,repeats=2,shortcut=False,ratio=0.25):
        super.__init__()
        c_=int(c2 * ratio)# 压缩通道数,c2代表输出通道数
        self.cv1=Conv(c1,c_,1)#压缩
        self.dwconv=nn.Conv2d(c_,c_,kernel_size=3,groups=c_)#卷积
        self.cv2=Conv(c_,c2,1)#恢复
        self.shortcut= shortcut and c1==c2 ## 是否残差连接
    def forward(self,x):
        y=self.cv2(self.dwconv(self.cv1(x)))
return x+y if self.shortcut else ySPPF层是SPP(Spatial Pyramid Pooling)的优化版本,主要用于快速多尺度特征提取,相比于传统SPP,SPPF计算量降低,同时保持同等精度。例如[-1, 1, SPPF, [1024, 5]]中,1024代表通道数,5代表池化核大小。
class SPPF(nn.Module):
    def __init__(self, c1, c2, k=5):  # c1=输入通道, c2=输出通道, k=池化核大小
        super().__init__()
        c_ = c1 // 2  # 压缩后的通道数
        self.conv1 = nn.Conv2d(c1, c_, 1, bias=False)  # 1×1 压缩卷积
        self.conv2 = nn.Conv2d(c_ * 4, c2, 1, bias=False)  # 1×1 输出卷积
        self.pool = nn.MaxPool2d(k, stride=1, padding=k // 2)  # 共享池化层

    def forward(self, x):
        x = self.conv1(x)  # 压缩通道
        y1 = self.pool(x)   # 第1次池化
        y2 = self.pool(y1)  # 第2次池化(等效9×9)
        y3 = self.pool(y2)  # 第3次池化(等效13×13)
        y = torch.cat([x, y1, y2, y3], 1)  # 拼接多尺度特征
return self.conv2(y) # 输出融合而C2SPA(Cross Stage Partial Fusion with Spatial Attention)是增强版跨阶段特征融合模块,比起传统的CSP,其能够降低计算量,同时能够兼顾多尺度空间注意力。
class C2f_SPA(nn.Module):
    def __init__(self, c1, c2, n=1, shortcut=False):
        super().__init__()
        self.c = c2 // 2  # CSP 分组
        self.cv1 = Conv(c1, self.c, 1)  # 初始拆分卷积
        self.cv2 = Conv(c1, self.c, 1)  # 跳连支路

        # 主分支处理(含 SPA)
        self.m = nn.Sequential(
            Conv(self.c, self.c, 1),  # 压缩
            DepthwiseConv(self.c, self.c, k=3),  # 深度卷积
            SPA(self.c)  # 空间金字塔注意力
        )
        self.cv3 = Conv(2 * self.c, c2, 1)  # 最终合并

    def forward(self, x):
        y = torch.cat(
            (self.m(self.cv1(x)), self.cv2(x)),
            dim=1
        )
        return self.cv3(y)

class SPA(nn.Module):
    """空间金字塔注意力"""
    def __init__(self, c):
        super().__init__()
        self.pool1 = nn.MaxPool2d(5, stride=1, padding=2)
        self.pool2 = nn.MaxPool2d(9, stride=1, padding=4)
        self.pool3 = nn.MaxPool2d(13, stride=1, padding=6)
        self.se = SE(c * 4)  # 通道注意力

    def forward(self, x):
        x1 = self.pool1(x)
        x2 = self.pool2(x)
        x3 = self.pool3(x)
        y = self.se(torch.cat([x, x1, x2, x3], dim=1))
        return y
接下来是网络的head部分,其中包含了上采样(Upsample)、拼接(Concat)、C3k2、conv、检测(Detect)等部分。
所谓上采样,就是传统的采样(下采样)过程相反,能够提高分辨率。以[-1, 1, nn.Upsample, [None, 2, "nearest"]]这个上采样为例,其中第一个参数代表不指定输出尺寸而改用缩放因子,2代表将输入的宽和高放大到2倍,而"nearest"代表使用最邻近插值法。
import torch.nn as nn

upsample_layer = nn.Upsample(
    scale_factor=2,          # 放大2倍
    mode='nearest',          # 最近邻插值
    recompute_scale_factor=None  # 不重新计算缩放因子
)

# 使用示例
input_tensor = torch.randn(1, 256, 40, 40)
output = upsample_layer(input_tensor) # 输出 [1, 256, 80, 80]拼接是将两个特征图连接到一起的过程,以[[-1, 6], 1, Concat, [1]]为例,-1代表当前的输入(一般为上一层的输出),6代表骨干网络中第6层的输出,第一个1代表重复次数为1,而后一个1代表沿着维度1进行拼接。
input1=[1,256,80,80] ##来自上一层的输出
input2=[1,512,80,80] ##来自骨干网络第6层的输出
output = torch.cat([input1, input2], dim=1)  # 沿通道维拼接
print(output) ##输出结果为[1,768,80,80]
class Concat(nn.Module):
def __init__(self, dimension=1):
super().__init__()
self.d = dimension # 拼接维度
def forward(self, x):
# x 是输入张量的列表
return torch.cat(x, dim=self.d)
# 使用示例
concat_layer = Concat(1)
output = concat_layer([input1, input2]) # 输入需是同尺寸的张量列表最后就是检测头部分(Detect Head),[[16, 19, 22], 1, Detect, [nc]],其中[16,19,22]表示三个不同尺度的特征图来源层索引,1代表重复次数,而nc在之前也提到过,就是种类数。



 扫一扫


 3941

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


