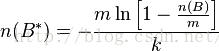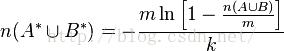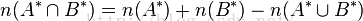布隆过滤器(Bloom Filter)

Redis-布隆过滤器Bloom Filter)详解 什么是布隆过滤器 布隆过滤器Bloom Filter)是 1970 年由布隆提出的,是一种非常节省空间的概率数据结构,运行速度快,占用内存小,但是有一定的误判率且无法删除元素。它实际上是一个很长的二进制向量一系列随机映射函数组成,主要用于判断一个元素是否在一个集合中。 通常我们都会遇到判断一个元素是否在某个集合中的业务场景,这个时候我们可能都是采用 HashMap的Put方法或者其他集合将数据保存起来,然后进行比较确定,但是如果元素很多的情况下,采用这种方式就会非常浪费空间,最终达到瓶颈,检索速度也会越 阅读详情

布隆过滤器简介

布隆过滤器(BloomFilter)是1970年由布隆提出的一种空间空间效率很高的随机数据结构,它利用位数组很简洁地表示一个集合,并判断一个元素是否属于这个集合。使用布隆过滤器,存在第一类出错(Falsepositive),但是不会存在第二类错误(Falsenegative),因此,布隆过滤器拥有100%的召回率。也就是说,布隆过滤器能够准确判断一个元素不在集合内,但只能判断一个元素可能在集合内。因此,BloomFilter不适合“零错误”的应用场合。在能够容忍低错误的应用场合下,BloomFilter通过极少的错误换取了存储空间的极大节省。我们可以向布隆过滤器里添加元素,但是不能从中移除元素(普通布隆过滤器,增强的布隆过滤器是可以移除元素的)。随着布隆过滤器中元素的增加,犯第一类错误的可能性也随之增大。直观的说,bloom算法类似一个hash set,用来判断某个元素(key)是否在某个集合中。和一般的hash set不同的是,这个算法无需存储key的值,对于每个key,只需要k个比特位,每个存储一个标志,用来判断key是否在集合中。

  算法:
1. 首先需要k个hash函数,每个函数可以把key散列成为1个整数
2. 初始化时,需要一个长度为n比特的数组,每个比特位初始化为0
3. 某个key加入集合时,用k个hash函数计算出k个散列值,并把数组中对应的比特位置为1

4. 判断某个key是否在集合时,用k个hash函数计算出k个散列值,并查询数组中对应的比特位,如果所有的比特位都是1,认为在集合中。

优点:不需要存储key,节省空间

缺点:

1. 算法判断key在集合中时,有一定的概率key其实不在集合中

2. 无法删除

典型的应用场景:
某些存储系统的设计中,会存在空查询缺陷:当查询一个不存在的key时,需要访问慢设备,导致效率低下。

比如一个前端页面的缓存系统,可能这样设计:先查询某个页面在本地是否存在,如果存在就直接返回,如果不存在,就从后端获取。但是当频繁从缓存系统查询一个页面时,缓存系统将会频繁请求后端,把压力导入后端。


(Bloom Filter)是由布隆(Burton Howard Bloom)在1970年提出的。它实际上是由一个很长的二进制向量和一系列随机映射函数组成,布隆过滤器可以用于检索一个元素是否在一个集合中。它的优点是空间效率和查询时间都远远超过一般的算法,缺点是有一定的误识别率(假正例False positives,即Bloom Filter报告某一元素存在于某集合中,但是实际上该元素并不在集合中)和删除困难,但是没有识别错误的情形(即假反例False negatives,如果某个元素确实没有在该集合中,那么Bloom Filter 是不会报告该元素存在于集合中的,所以不会漏报)。

哈希表通过一个一个Hash函数将一个元素映射成一个位阵列(Bit Array)中的一个点。这样一来,我们只要看看这个点是不是 1 就知道可以集合中有没有它了。这就是布隆过滤器的基本思想。Hash面临的问题就是冲突。假设 Hash 函数是良好的,如果我们的位阵列长度为 m 个点,那么如果我们想将冲突率降低到例如 1%, 这个散列表就只能容纳 m/100 个元素。显然这就不叫空间有效了(Space-efficient)。解决方法也简单,就是使用多个 Hash,如果它们有一个说元素不在集合中,那肯定就不在。如果它们都说在,虽然也有一定可能性它们在说谎,不过直觉上判断这种事情的概率是比较低的。

优点

相比于其它的数据结构,布隆过滤器在空间和时间方面都有巨大的优势。布隆过滤器存储空间和插入/查询时间都是常数。另外, Hash 函数相互之间没有关系,方便由硬件并行实现。布隆过滤器不需要存储元素本身,在某些对保密要求非常严格的场合有优势。

布隆过滤器可以表示全集,其它任何数据结构都不能;

k 和 m 相同,使用同一组 Hash 函数的两个布隆过滤器的交并差运算可以使用位操作进行。

缺点

但是布隆过滤器的缺点和优点一样明显。误算率(False Positive)是其中之一。随着存入的元素数量增加,误算率随之增加。但是如果元素数量太少,则使用散列表足矣。

另外,一般情况下不能从布隆过滤器中删除元素. 我们很容易想到把位列阵变成整数数组,每插入一个元素相应的计数器加1, 这样删除元素时将计数器减掉就可以了。然而要保证安全的删除元素并非如此简单。首先我们必须保证删除的元素的确在布隆过滤器里面. 这一点单凭这个过滤器是无法保证的。另外计数器回绕也会造成问题。

False positives 概率推导

假设 Hash 函数以等概率条件选择并设置 Bit Array 中的某一位,m 是该位数组的大小,k 是 Hash 函数的个数,那么位数组中某一特定的位在进行元素插入时的 Hash 操作中没有被置位的概率是:

那么在所有 k 次 Hash 操作后该位都没有被置 "1" 的概率是:

如果我们插入了 n 个元素,那么某一位仍然为 "0" 的概率是:

因而该位为 "1"的概率是:

现在检测某一元素是否在该集合中。标明某个元素是否在集合中所需的 k 个位置都按照如上的方法设置为 "1",但是该方法可能会使算法错误的认为某一原本不在集合中的元素却被检测为在该集合中(False Positives),该概率由以下公式确定:

其实上述结果是在假定由每个 Hash 计算出需要设置的位(bit) 的位置是相互独立为前提计算出来的,不难看出,随着 m (位数组大小)的增加,假正例(False Positives)的概率会下降,同时随着插入元素个数 n 的增加,False Positives的概率又会上升,对于给定的m,n,如何选择Hash函数个数 k 由以下公式确定:

此时False Positives的概率为:

而对于给定的False Positives概率 p,如何选择最优的位数组大小 m 呢,

上式表明,位数组的大小最好与插入元素的个数成线性关系,对于给定的 m,n,k,假正例概率最大为:

这种计算方法不严格,因为前面假设哈希函数和散列后值的分布是相互独立的。但是,这个假设随着m和n的增大误判率更接近真实的误判率。

Mitzenmacher and Upfal证明无假设情况下的误判率的期望值相同。

最优的哈希函数个数

既然布隆过滤器将集合映射到位数组中,那么选多少个hash函数才是错误率最低的情况。这里有两个互斥的理由:如果哈希函数的个数多,那么在对一个不属于集合的元素进行查询时得到0的概率就大;但另一方面,如果哈希函数的个数少,那么位数组中的0就多。为了得到最优的哈希函数个数,我们需要根据上一小节中的错误率公式进行计算。

误判率
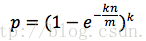

两边取自然对数,
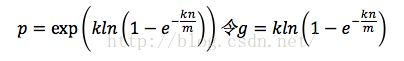

,只要g取最小值,p就能取到最小值。由于p=e^(-nk/m),我们可以将g改写为
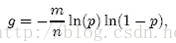

根据对称法则可以得到当p1/2时,也就是k=ln2*(m/n)时,g取得最小值,在这种情况下,最小的错误率p=(1/2^k(0.6185)^(m/n)。p=1/2对应着位数组中01各半。换句话说,想保持错误率低,最好让位数组有一半还空着。

位数组的大小

在给定n(集合中元素的个数)和错误率(最优函数个数k的的错误率)的情况下,位数组M的大小计算,在最优k的情况下
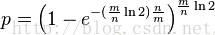

化简为
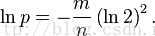

得到
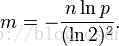

这意味着在错误率为p的情况下,布隆过滤器的长度为m才能容纳n个元素(以上计算基于n,m->∞)。

布隆过滤器中元素个数的估算

Swamidass & Baldi (2007)给出了布隆过滤器元素个数估算的方法(详细证明方式参考论文)
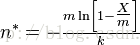

其中,n*表示布隆过滤元素个数的估算值,m表示布隆过滤器的大小,k表示哈希函数的个数,X表示布隆过滤器位值位1的个数。

布隆过滤器的并和交

布隆过滤器可以用来估算两个集合之间的并合交。一下给出两个集合之间并的计算方式:
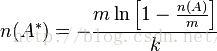


AB之间的并集的个数为:


所以A*B*之间的交集的个数为:


布隆过滤的特性

布隆过滤器能够容纳任意多的元素(误判率会增加),总是能向布隆过滤器中添加元素,不会报错(OutMemory等);

布隆过滤器可以很方便的通过计算机的or \and操作计算两个集合元素之间的交集(intersection)和并集(union,但是同样影响布隆过滤的准确性。


【Redis】布隆过滤器(Bloom Filter) 布隆过滤器Bloom Filter)是1970年由布隆提出的。它实际上是一个很长的二进制向量一系列随机映射函数。布隆过滤器可以用于检索一个元素是否在一个集合中。它的优点是空间效率查询时间都比一般的算法要好的多,缺点是有一定的误识别率删除困难。可以把布隆过滤器理解为一个set集合,我们可以通过add往里面添加元素,通过contains来判断是否包含某个元素。 阅读详情

相关推荐

布隆(Bloom Filter)过滤器——全面讲解,建议收藏

本文已收录于专栏??《Redis之大厂必备技能包》??欢迎各位关注、三连博主的文章及专栏,全套Redis学习资料,大厂必备技能!目录1、什么是布隆过滤器2、布隆过滤器的使用场景3、布隆过滤器的原理3.1 数据结构3.2 空间计算3.3 增加元素3.4 查询元素3.5 修改元素3.6 删除元素4、Redis集成布隆过滤器4.1 版本要求4.2 安装&编译4.3 Redis集成5、Redis中布隆过滤器指令使用5.1 bf.add5.2 bf.madd5.3 bf.exists5.3 bf.mexists6、J

hjseo_seg的博客 3344

布隆过滤器Bloom Filter简介

背景: 如果在平时我们要判断一个元素是否在一个集合中,通常会采用查找比较的方法,下面分析不同的数据结构查找效率: 采用线性表存储,查找时间复杂度为O(N) 采用平衡二叉排序树(AVL、红黑树)存储,查找时间复杂度为O(logN) 采用哈希表存储,考虑到哈希碰撞,整体时间复杂度也要O[log(n/m)] 当需要判断一个元素是否存在于海量数据集合中,不仅查找时间慢,还会占用大量存储空间,接下来看一下布隆过滤器如何解决这个问题 1、什么是布隆过滤器布隆过滤器是一种空间效率很高的随机数据结..

张维鹏的博客 3013

scrapy_redis对接布隆过滤器(Bloom Filter)

使用方式: pip3 install scrapy-redis-bloomfilter 使用的方法Scrapy-Redis基本相似,在这里说明几个关键配置。 # 去重类,要使用Bloom Filter请替换DUPEFILTER_CLASS DUPEFILTER_CLASS = "scrapy_redis_bloomfilter.dupefilter.RFPDupeFilter" #...

徐代龙的技术专栏 3295

一篇文章告诉你什么是BloomFilter

缓存宕机、缓存击穿场景,一般判断用户是否在缓存中,如果在则直接返回结果,不在则查询db,如果来一波冷数据,会导致缓存大量击穿,造成雪崩效应,这时候可以用布隆过滤器当缓存的索引,只有在布隆过滤器中,才去查询缓存,如果没查询到,则穿透到db。我们写的这些早有大牛帮我们实现,还造轮子,真是浪费时间,No,No,No,我们学习过程中是可以造轮子的,造轮子本身就是我们自己对设计实现的具体落地过程,不仅能提高我们的编程能力,在造轮子的过程中肯定会遇到很多我们没有思考过的问题,成长看的见~~(比如上图中的第 3 位)

通往IT大道的专栏 1865

布隆过滤器Bloom Filter)总结-java版

目录 为什么要有布隆过滤器 简介 基本原理 是否支持删除 误判率 哈希函数个数布隆过滤器长度 复杂度 空间 时间 优缺点 优点 缺点 BloomFilterBItMap的区别 应用 java实现 Hash工具类 BitSet类 BloomFilter 测试 为什么要有布隆过滤器 在日常生活中,包括在设计计算机软件时,我们经常要判断一个元素是否在一个集合...

今天吃了吗的博客 2647

Bloom Filter 布隆过滤器

介绍就是一个集合,检测元素是不是存在于集合中。速度超快,但是有一定的误识别率,同时删除困难Bloom Filter算法添加元素 一个m位的数组,数组都是0 新来一个输入,通过k个hash函数得到数组的k个索引 将k个索引都置为1 检查元素将被检查元素通过k个hash函数得到数组的k个索引,如果k个位置都是1则被检查元素在集合之中(有误报几率)误报率给定一个hash函数,一个特定位没有被设置为1的概率

长屌少女 524

布隆过滤器(Bloom Filter)原理分析及代码实现

布隆过滤器(Bloom Filter)原理分析及代码实现 直观的说,bloom算法类似一个hash set,用来判断某个元素(key)是否在某个集合中。 一般的hash set不同的是,这个算法无需存储key的值,对于每个key,只需要k个比特位,每个存储一个标志,用来判断key是否在集合中。 算法: 1. 首先需要k个hash函数,每个函数可以把key散列成为1个整数 2. 初始化时,需要一个长度为n比特的数组,每个比特位初始化为0 3. 某个key加入集合时,用k个hash函数计算出k个散列值,并

jenie的专栏 1302

布隆过滤器Bloom Filter

为啥布隆过滤器 当我们使用缓存或者其他场景的时候,有可能遇到一种情况,就是明明没有这条数据,但是他又在正常区间内,比如说访问id为700000的数据,实际上你的数据只有1w条。数据库中都没有,那缓存中也就没有。这时候如果必须每次都要去缓存数据库中查询,则会极大的浪费缓存数据库资源。 而布隆过滤器,提供一种机制,就是过滤掉大部分不合理的数据。如果布隆过滤器告诉你这个数据不存在,则一定不存在,也就不需要去做浪费资源的操作。 什么是布隆过滤器 本质上布隆过滤器是一种数据结构,比较巧妙的概率型数据结构(prob

vinter_he 3765

布隆过滤器Bloom Filter)以及相关衍生

布隆过滤器Bloom Filter) 简要介绍: 布隆过滤器Bloom Filter)是1970年由布隆提出的。它实际上是一个很长的二进制向量一系列随机映射函数。布隆过滤器可以用于检索一个元素是否在一个集合中。 算法 首先需要k个hash函数,每个函数可以把key散列成为1个整数 初始化时,需要一个长度为n比特的数组,每个比特位初始化为0 某个key加入集合时,用k个hash函数计算出k个散列值,并把数组中对应的比特位置为1 判断某个key是否在集合时,用k个hash函数计算出k个散列值,并查询数组

yingLGG的博客 619

布隆过滤器+缓存穿透问题+Counting Bloom Filter,原理+案例+代码实现

概述 什么是布隆过滤器 布隆过滤器Bloom Filter)是1970年由布隆提出的,它实际上是由一个很长的二进制向量一系列随意映射函数组成。 它是一种基于概率的数据结构,主要用来判断某个元素是否在集合内,它具有运行速度快(时间效率),占用内存小的优点(空间效率),但是有一定的误识别率删除困难的问题。它能够告诉你某个元素一定不在集合内或可能在集合内。 在计算机科学中,我们常常会碰到时间换空间或者空间换时间的情况,通常两者不可兼得,我们要在两者之间取舍...

helloxiaozhe的博客 2398

php bloom过滤器,Bloom-Filter布隆过滤器)

BloomFilter类classBloomFilter{protected$m; //bit数组的宽度(bit数)protected$k; //使用的hash函数的个数protected$n; //集合中元素的个数protected$bitset; //二进制数组//构造函数初始化publicfunction__construct($m,$k){$this->m...

weixin_30500365的博客 244

布隆过滤器Bloom Filter)原理以及应用

布隆过滤器Bloom Filter)是1970年由布隆提出的。它实际上是一个很长的二进制向量一系列随机映射函数。布隆过滤器可以用于检索一个元素是否在一个集合中。它的优点是空间效率查询时间都远远超过一般的算法,缺点是有一定的误识别率删除困难。 hash原理 Hash (哈希,或者散列)函数在计算机领域,尤其是数据快速查找领域,加密领域用的极广。 其作用是将一个大的数据集映射到一个小的数据...

yamaxifeng_132的专栏 354

Bloom Filter布隆过滤器

Bloom Filter是一种海量数据的查询过滤算法。若要判断一个集合是否包含某个元素,小数据量场景下可以简单的使用遍历比较;海量数据场景下,不考虑空间效率可以直接使用Bitmap来进行判断;若要考虑空间效率,Burton Bloom在1970年提出了Bloom Filter算法,其时间复杂度是O(1)Bloom Filter算法不能保证100%正确,所以不适合那些“零错误”的应用场合。

zpnuaa107的博客 551

布隆过滤器(Bloom Filter)详解

布隆过滤器[1](Bloom Filter)是由布隆(Burton Howard Bloom)在1970年提出的。它实际上是由一个很长的二进制向量一系列随机映射函数组成,布隆过滤器可以用于检索一个元素是否在一个集合中。它的优点是空间效率查询时间都远远超过一般的算法,缺点是有一定的误识别率(假正例False positives,即Bloom Filter报告某一元素存在于某集合中,但是...

张Q的专栏 798
上一篇: 计算机网络笔记
下一篇: C++虚函数实现机制及内存模型
JINGchenxue
博客等级 码龄9年 46粉丝 29原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

红包个数最小为10个

红包金额最低5元

当前余额3.43前往充值 >
需支付:10.00
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值