Python模拟登录实战,采集整站表格数据!

Python爬虫实战:手把手教你如何构建离线版 HTTP 错误码速查手册! 我长期专注 Python 爬虫工程化实战,主理专栏 👉 《Python爬虫实战》:从采集策略到反爬对抗,从数据清洗到分布式调度,持续输出可复用的方法论与可落地案例。内容主打一个“能跑、能用、能扩展”,让数据价值真正做到——抓得到、洗得净、用得上。 阅读详情

本节主要内容有:

  • 通过requests库模拟表单提交
  • 通过pandas库提取网页表格

上周五,大师兄发给我一个网址,哭哭啼啼地求我:“去!把这个网页上所有年所有县所有作物的数据全爬下来,存到Access里!”

我看他可怜,勉为其难地挥挥手说:“好嘞,马上就开始!”

目标分析

大师兄给我的网址是这个:https://www.ctic.org/crm?tdsourcetag=s_pctim_aiomsg

打开长这样:
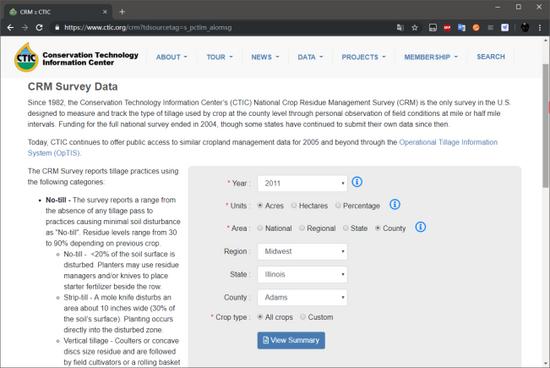
根据我学爬虫并不久的经验,通常只要把年月日之类的参数附加到url里面去,然后用requests.get拿到response解析html就完了,所以这次应该也差不多——除了要先想办法获得具体有哪些年份、地名、作物名称,其他部分拿以前的代码稍微改改就能用了,毫无挑战性工作,生活真是太无聊了

点击 View Summary 后出现目标网页长这样
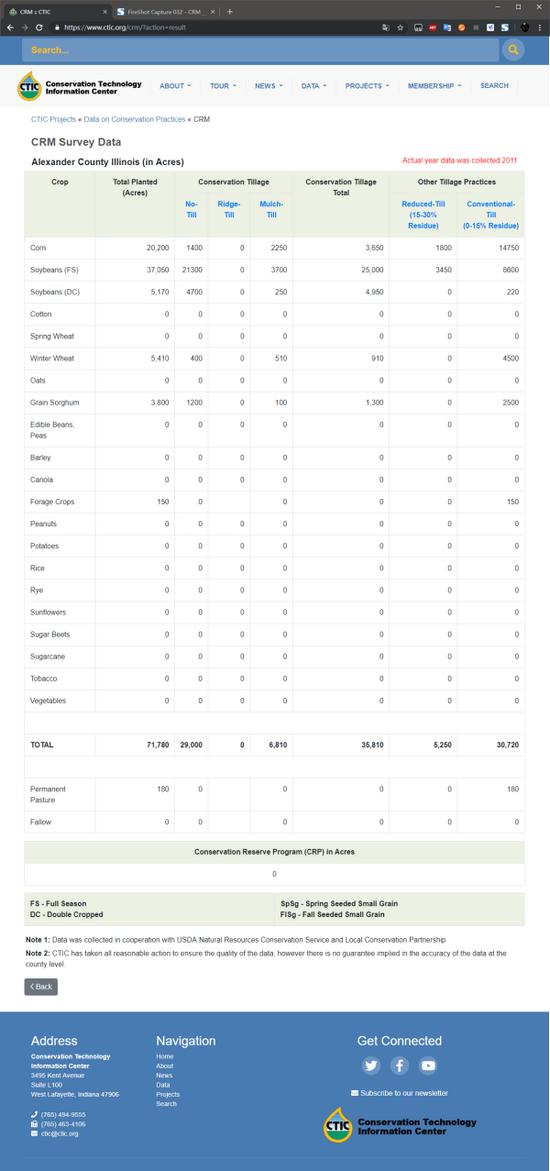
那个大表格的数据就是目标数据了,好像没什么了不起的——

有点不对劲

目标数据所在网页的网址是这样的:https://www.ctic.org/crm/?action=result ,刚刚选择的那些参数并没有作为url的参数啊!网址网页都变了,所以也不是ajax

这和我想象的情况有巨大差别啊

尝试获取目标页面

让我来康康点击View Summary这个按钮时到底发生了啥:右键View Summary检查是这样:
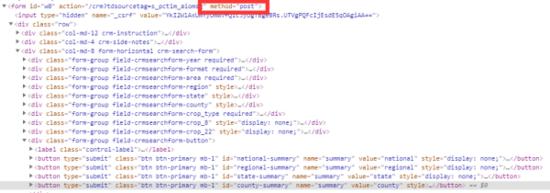
实话说,这是我第一次遇到要提交表单的活儿。以前可能是上天眷顾我,统统get就能搞定,今天终于让我碰上一个post了。

点击View Summary,到DevTools里找network第一条:
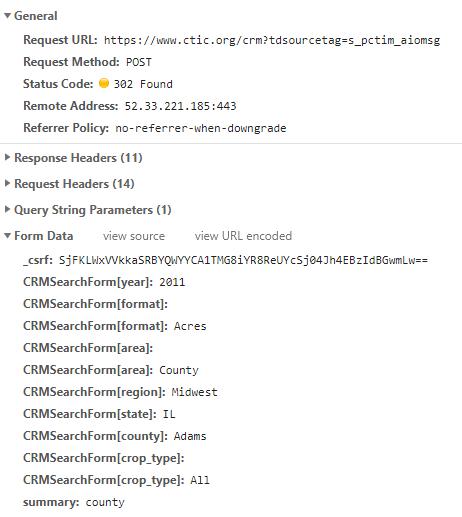
不管三七二十一,post一下试试看

import requests 
  
url = 'https://www.ctic.org/crm?tdsourcetag=s_pctim_aiomsg' 
headers = {'user-agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) ' 
           'AppleWebKit/537.36 (KHTML, like Gecko) ' 
           'Chrome/74.0.3729.131 Safari/537.36', 
           'Host': 'www.ctic.org'} 
data = {'_csrf': 'SjFKLWxVVkkaSRBYQWYYCA1TMG8iYR8ReUYcSj04Jh4EBzIdBGwmLw==', 
        'CRMSearchForm[year]': '2011', 
        'CRMSearchForm[format]': 'Acres', 
        'CRMSearchForm[area]': 'County', 
        'CRMSearchForm[region]': 'Midwest', 
        'CRMSearchForm[state]': 'IL', 
        'CRMSearchForm[county]': 'Adams', 
        'CRMSearchForm[crop_type]': 'All', 
        'summary': 'county'} 
response = requests.post(url, data=data, headers=headers) 
print(response.status_code) 

果不其然,输出400……我猜这就是传说中的cookies在搞鬼吗?《Python3网络爬虫实战》只看到第6章的我不禁有些心虚跃跃欲试呢!

首先,我搞不清cookies具体是啥,只知道它是用来维持会话的,应该来自于第一次get,搞出来看看先:

Python 爬虫项目 Scrapy 配置 Cookie 中间件保持会话状态 在网络数据采集场景中,大量资讯平台、科普站点、内容门户会基于会话状态实现权限校验、页面内容动态渲染、访问频次管控等逻辑。部分栏目内容、分页数据、隐藏资源仅在客户端保持有效会话的前提下才可正常访问,单次独立请求无法获取完整页面信息。Scrapy 框架默认的请求机制为无状态请求,每一次网络请求都会被服务器判定为全新客户端连接,无法延续上一次的访问会话,这也是复杂站点采集过程中常见的阻碍。 阅读详情

相关推荐

python爬虫时如何找到cookies值,并通过session方法自动获取cookie

使用requests库内的一个session方法,可以记录上一次使用过的cookie并在此次中使用 import requests from user_agent import headers def renren_login(): url = 'http://www.renren.com/880151247/profile' login_url = 'http://www.renren.com/PLogin.do' # requests中的session会帮我们得到cook

weixin_55579895的博客 3508

python利用session来模拟登录进行爬虫抓取

很多网站内容在抓取时需要进行登录,不登录则无法获取到内容,这时就需要session来模拟进行登录的过程,有人会问使用cookie不行吗,当然不行,cookie只能在本地环境下使用,也就是你浏览器登录之后抓取cookie写入,然后再在本地运行脚本才能使用,当你放到服务器之后这个cookie就相当于失效的。 session模拟登录 ...

南猫 759

python爬虫实例——session自动登录并爬取相关内容

1、理解下 session (会话) 所谓的会话,你可以理解成我们用浏览器上网,到关闭浏览器的这一过程。session是会话过程中,服务器用来记录特定用户会话的信息。 比如今天双11,你淘宝网浏览了哪些商品,购物出里放了多少件物品,这些记录都会被保存在session中。 session 和 cookies 有什么关系呢? session和cookies的关系还非常密切——cookies中存储着session的编码信息,session中又存储了cookies的信息。 当浏览器第一次访问购物网页时,服务器会返回

Fo*(Bi)的博客 1680

python数据采集

这次的爬虫是需要账户的所以h是使用的Request Headers中的数据keyword = input("请输入查询的职务")# 数据采集h = {q=0.01',q=0.9,en;login=true;A Brand";# 定义post方式参数'pn': num,# 向服务器发送请求# 下载数据# 解析数据# 建立链接# sql# 创建游标并执行try:except:# 设置时间延迟。

LMY~~的博客 7463

python采集需要登陆才能看到信息的网站。requests Session 保持会话

想要采集目标网站的信息,发现有些信息是要登陆后才能采集的。下面用python pycharm django来尝试采集。 # 登陆后采集信息 def Get_Session(URL,DATA,HEADERS): '''保存登录参数''' ROOM_SESSION = requests.Session() ROOM_SESSION.post(URL,data=DATA,h...

1005

为什么有些xpath绝对路径拿不到数据_Python模拟登录实战采集整站表格数据!...

本节主要内容有:通过requests库模拟表单提交通过pandas库提取网页表格上周五,大师兄发给我一个网址,哭哭啼啼地求我:“去!把这个网页上所有年所有县所有作物的数据全爬下来,存到Access里!”我看他可怜,勉为其难地挥挥手说:“好嘞,马上就开始!”目标分析大师兄给我的网址是这个:https://www.ctic.org/crm?tdsourcetag=s_pctim_aiomsg打开长这样...

weixin_34708601的博客 295

Python模拟登录实战采集整站表格数据

本节主要内容有: 通过requests库模拟表单提交 通过pandas库提取网页表格 上周五,大师兄发给我一个网址,哭哭啼啼地求我:“去!把这个网页上所有年所有县所有作物的数据全爬下来,存到Access里!” 私信小编001即可获取大量Python学习资料! 我看他可怜,勉为其难地挥挥手说:“好嘞,马上就开始!” 目标分析 大师兄给我的网址是这个:https://www.ctic.org/crm?tdsourcetag=s_pctim_aiomsg 打开长这样: 根据我学爬虫并不久的经验,通常

zihong522的博客 223

python 获取表格中的空数据_Python模拟登录实战采集整站表格数据

本节主要内容有:通过requests库模拟表单提交通过pandas库提取网页表格上周五,大师兄发给我一个网址,哭哭啼啼地求我:“去!把这个网页上所有年所有县所有作物的数据全爬下来,存到Access里!”私信小编001即可获取大量Python学习资料!我看他可怜,勉为其难地挥挥手说:“好嘞,马上就开始!”目标分析大师兄给我的网址是这个:https://www.ctic.org/crm?tdsourc...

weixin_32829077的博客 162

一套框架跑通五大平台:社交媒体数据采集的完整实战指南

做竞品调研的小周,曾为一组小红书笔记数据熬了三个通宵——手动复制、截图归档,第二天又冒出一批新内容。直到他换用 MediaCrawler-new 进行社交媒体数据采集,十分钟就把关键词下的帖子、评论和点赞数全部拿齐。 ## 它是谁:一个替你"真人逛平台"的开源框架 一句话说清楚:**MediaCrawler-new 是一个基于 Playwright 的社交媒体数据采集框架**,帮你从小红书、抖

gitblog_00073的博客 1029

firecrawl 实战网页一键转 Markdown,为 RAG 知识库提供干净数据

网页抓取与内容清洗是构建大模型知识库和 RAG 系统的关键前置环节。原始 HTML 中充斥着导航、广告和动态脚本,直接使用既浪费 token 又影响检索质量。firecrawl 作为一款开源的网页抓取与转换工具,将“抓取”和“清洗”封装为标准 API,支持完整的 JavaScript 渲染,可自动将网页转换为干净的 Markdown 格式。其核心能力覆盖单页抓取、整站爬取、站点地图探测和搜索抓取,能够为知识库构建、文档同步和内容监控提供统一的数据预处理方案。通过理解其工作原理、合理配置参数以及控制抓取成本,

cuibinmo3519的博客 418

python爬取天眼查存入excel表格_32个Python爬虫实战项目,满足你的项目慌(带源码)...

写在前面学习Python爬虫的小伙伴想成为爬虫行业的大牛么?你想在网页上爬取你想要的数据不费吹灰之力么?那么亲爱的小伙伴们肯定需要项目实战去磨练自己的技术,毕竟没有谁能随随便便成功!小编前段时间精心总结出了32个实用的爬虫项目,是目前主流爬虫的方向!小编将为大家提供这些项目的源码供大家参考练习!!致敬奋斗的你!!需要项目源码的小伙伴关注、转发文章,私信小编“666”即可获取这些项目的源码需要项目源...

weixin_39969298的博客 1220

Python 爬虫零基础入门:小白也能看懂的超详细实战教程》

Python 爬虫零基础入门:小白也能看懂的超详细实战教程》欢迎大家前来体验爬虫的乐趣~

1116

零基础学Python:从爬虫到数据分析的完整学习路线

Python作为一门语法简洁、生态丰富的编程语言,已成为数据采集与分析领域的主流工具。其核心价值在于通过爬虫技术将互联网上的公开数据系统化地抓取到本地,再利用Pandas等库完成清洗、聚合与可视化,形成从数据到结论的完整链路。在企业日常业务中,无论是自动化报表、市场调研还是用户行为分析,这套技能都能显著提升工作效率。对于零基础学习者而言,关键不在于碎片化地记忆语法,而在于建立“环境搭建→基础语法→爬虫专项→数据分析→综合实战”的递进式学习路径,并配合真实项目反复练习。本文正是基于这一思路,梳理了一套从Pyt

weixin_31292729的博客 299

Firecrawl:网页转Markdown的LLM数据预处理利器

在构建LLM应用时,网页内容往往无法直接喂给大模型——JavaScript动态渲染、导航噪音、广告脚本和复杂HTML结构都会干扰语义理解。传统requests加BeautifulSoup的方案需要自行处理渲染、清洗和格式转换,工程成本高且难以泛化。Firecrawl作为开源API服务,将单页抓取、整站批量爬取、搜索结果抓取和结构化提取统一封装,内置无头浏览器渲染与主内容识别,直接输出干净的Markdown或JSON,为RAG知识库、Agent工具链等场景提供标准化数据入口。它既支持云API快速接入,也可自托

weixin_33946605的博客 321

743个URL批量审计:免费浏览器自动化工具实战指南

在网站改版、SEO巡检或整站迁移时,批量验证URL的可用性是运维与开发人员的常见需求。传统的HTTP状态码检查只能确认服务器有响应,却无法识别单页应用白屏、路由跳转异常或跨浏览器渲染不一致等问题。浏览器自动化技术应运而生,通过无头浏览器真实执行JavaScript,获取渲染后的DOM、标题及控制台日志,从而以用户视角评估页面质量。其核心价值在于结合轻量级HTTP并发检测与多内核渲染校验,覆盖状态码、重定向、响应时间和内容完整性等多维度指标,广泛应用于爬虫质量监控、前端工程化验证及SEO效果追踪。实践中,利用

367
上一篇: Python爬取2万条相亲网站数据!看看中国单身男女都在挑什么!
下一篇: Python3.6自动群发邮件!这个脚本怎么样?
pythonlaodi
博客等级 码龄6年 286粉丝 244原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

红包个数最小为10个

红包金额最低5元

当前余额3.43前往充值 >
需支付:10.00
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值