


本文以通俗易懂的方式介绍了LangChain的核心概念,包括Model、Chain、Agent、Memory和Tool,并详细解释了它们各自的功能和适用场景。通过一个简单的文档问答示例,帮助读者理解如何编写可运行的LangChain流程。文章还提供了学习路线和常见陷阱的避坑指南,适合想要入门大模型学习的程序员和小白参考。
一上来就被术语砸懵了?很正常 😵
刚接触 LangChain 时,我脑子里大概是这样的:
“Chain 是链,Agent 是智能体,Memory 是记忆……每个英文单词我都认识,为什么放在一起就看不懂了?”
更让人困惑的是,网上的示例还可能来自不同版本。同一个“记住聊天记录”的需求,有人使用旧式 Memory 类,有人使用消息历史,还有人直接上 LangGraph。代码越搜越多,脉络反而越来越乱。
这篇文章不打算带你背 API。我们先做一件更重要的事:建立一张全局地图。读完后,你应该能回答三个问题:
-
Model、Chain、Agent、Memory、Tool 分别解决什么问题?
-
什么场景应该用固定 Chain,什么场景才需要 Agent?
-
如何写出第一条可以运行的 LangChain 文档问答流程?
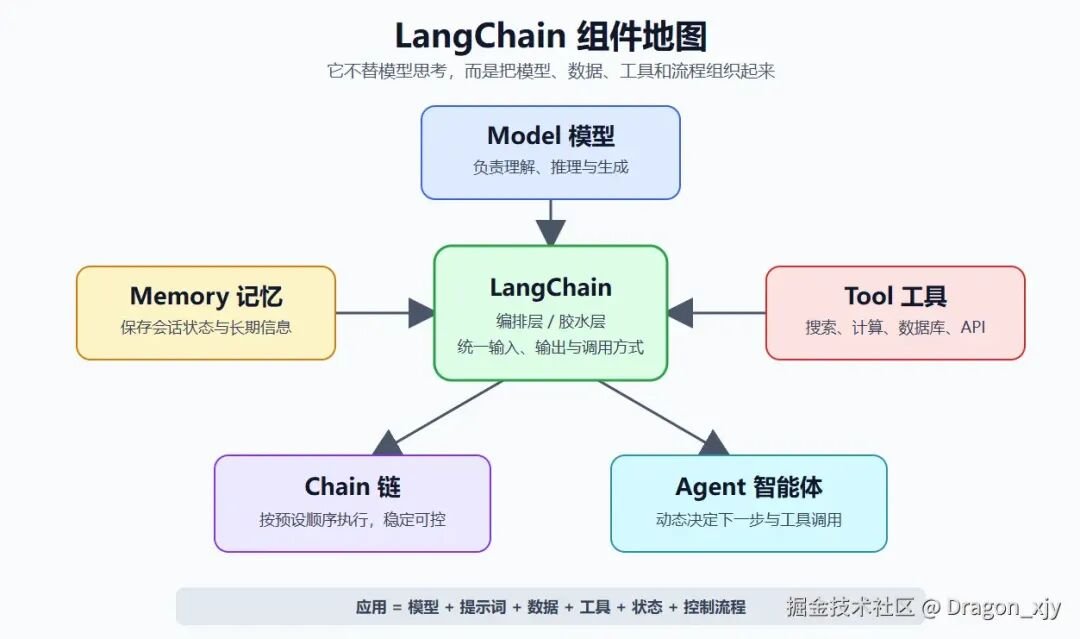
图 1:LangChain 负责“编排”,模型才负责理解与生成。
先给 LangChain 一句人话定义
假设你开了一家内容加工厂。用户送来一个问题,工厂需要查资料、整理提示词、请模型生成内容、检查输出格式,最后把结果交出去。
如果全靠手写代码,你当然也能完成。但步骤一多,模型一换,错误处理、状态保存、流式输出和监控都会变得麻烦。
LangChain 就是一套 LLM 应用编排工具:它把模型、提示词、数据、工具和状态接成可执行流程。
它不是新的大模型,也不会让模型凭空变聪明。它更像“胶水”和“流水线控制器”。LangChain 官方目前把它定位为构建 LLM 应用与 Agent 的开源框架;需要更底层、更可控的图式工作流时,则可以继续使用 LangGraph。
五个核心概念,一次翻译清楚
1. Model:负责思考的“大脑” 🧠
Model 就是应用调用的语言模型,例如 OpenAI、Anthropic 或 Google 提供的聊天模型。它负责理解输入并生成输出。
LangChain 在这里做的事情,是提供相对统一的调用接口。你可以把不同厂商的模型想成不同品牌的电器,而 LangChain 尽量给它们配上相似的插座。
from langchain.chat_models import init_chat_model model = init_chat_model(”openai:gpt-4.1-mini”) response = model.invoke(”用一句话解释什么是 LangChain”) print(response.content)
需要注意:统一接口不等于模型能力完全相同。上下文窗口、工具调用、结构化输出、价格和延迟仍然取决于具体模型。
2. Chain:固定路线的“工厂流水线” 🏭
Chain 把多个步骤按预定顺序串起来。上一站的输出,就是下一站的输入。
例如一条文档问答 Chain:
用户问题 读取或检索文档 拼接 Prompt 调用 Model 解析输出 返回答案
在现代 LangChain 中,很多 Chain 本质上是 Runnable 的组合。最直观的写法是用 | 连接:
chain = prompt | model | output_parser
读起来就像:“提示词交给模型,模型结果再交给解析器。”它的最大优点是顺序明确、容易测试、成本可预测。
3. Agent:自己决定路线的“现场主管” 🤖
Chain 的路线由开发者提前规定;Agent 则会根据目标,动态决定下一步做什么。
比如用户问:“北京现在的天气适合跑步吗?”Agent 可能会:
-
判断需要实时天气
-
调用天气工具;
-
读取温度、降水和空气质量;
-
再让模型给出建议;
-
信息不足时继续调用其他工具。
需要外部信息 信息足够 用户目标 Agent Model 判断下一步 调用 Tool 返回观察结果 最终回答
这相当于给“大脑”配上手和眼睛。不过,自主性越高,路径越不确定,调试和成本控制也越难。
能用 Chain 解决的问题,先不要上 Agent。 固定流程适合稳定业务;只有步骤确实需要模型动态选择时,Agent 才有价值。
LangChain v1 中,create_agent 是创建 Agent 的标准入口。它底层使用 LangGraph 提供循环执行、状态和持久化等能力。
4. Memory:不是“无限记忆”,而是可管理的状态 🗂️
模型 API 本身通常不会自动记住上一次请求。所谓 Memory,是应用把必要的历史或用户信息保存下来,并在后续调用时重新提供给模型。
现代 LangChain 把记忆分得更清楚:
- 短期记忆:属于当前会话线程,例如最近几轮聊天和本轮工具结果;Agent 可通过 checkpointer 保存状态。
- 长期记忆:跨会话保存,例如用户偏好、档案或长期事实;通常需要持久化存储。
from langchain.agents import create_agent from langgraph.checkpoint.memory import InMemorySaver agent = create_agent( model=”openai:gpt-4.1-mini”, tools=[], checkpointer=InMemorySaver(), # 仅适合本地演示 ) config = {”configurable”: {”thread_id”: ”demo-user-1”}}
Memory 不是把全部聊天记录永远塞进 Prompt。上下文越长,成本越高,旧信息还可能干扰模型。生产环境通常需要裁剪、摘要、检索和数据库持久化。
5. Tool:给模型接上的“外部能力” 🛠️
LLM 擅长理解和生成语言,但它不知道今天的实时库存,也不应该靠猜完成精确计算。Tool 就是一个带有名称、说明和参数结构的可调用函数。
                                                                                 from langchain.tools import tool             @tool      def query_inventory(product_id: str) -> int:          ”””查询指定商品的实时库存数量。”””
      # 真实项目中,这里会调用数据库或业务 API     return 42
函数说明非常重要,因为 Agent 会据此判断“什么时候该用这个工具”。工具可以查询搜索引擎、数据库和内部 API,也可以执行计算或触发业务动作。
但请记住:让 Agent 调用工具,等于授予它行动能力。涉及付款、删除、发信等高风险操作时,应增加权限校验、参数验证和人工确认。
Chain 和 Agent,到底怎么选?
| 对比项 | Chain | Agent |
|---|---|---|
| 执行路线 | 开发者预先规定 | 模型动态决定 |
| 可预测性 | 高 | 相对较低 |
| 调试难度 | 较低 | 较高,需要观察每一步 |
| 成本与延迟 | 容易估算 | 可能多轮调用 |
| 适合场景 | 摘要、分类、固定 RAG、结构化提取 | 多工具研究、开放式任务、动态排障 |
一个简单判断题:如果你能在画流程图时提前确定每一步,就优先使用 Chain;如果“下一步是什么”必须依赖模型刚刚看到的结果,再考虑 Agent。
最小可运行示例:做一条文档问答 Chain
我们先不引入向量数据库。目标很简单:把一小段内部文档和用户问题交给模型,并要求它只能依据文档回答。
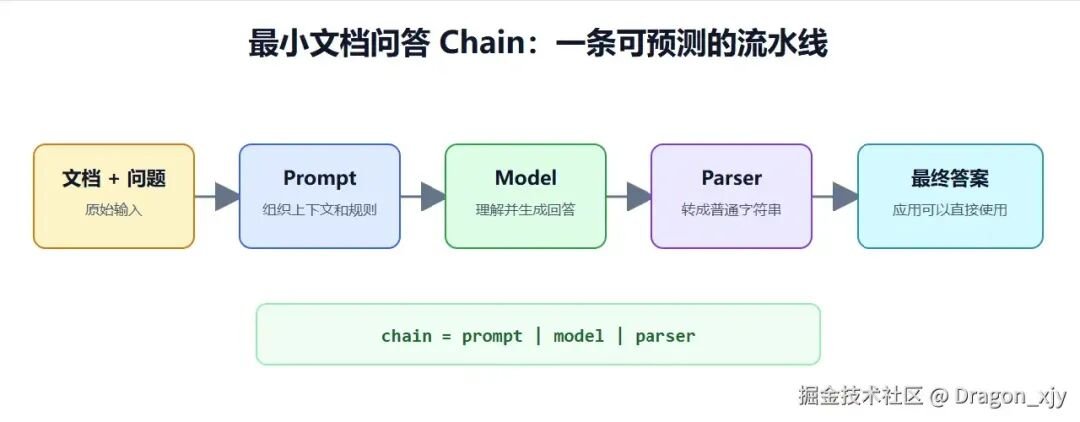
图 2:代码中的|就是这条流水线的传送带。
第一步:准备环境
LangChain 当前要求 Python 3.10 或更高版本。创建虚拟环境并安装核心包与 OpenAI 集成:
python -m venv .venv # macOS / Linux source .venv/bin/activate # Windows PowerShell # .venv/Scripts/Activate.ps1 python -m pip install -U langchain langchain-openai
设置 API Key。不要把密钥直接写进代码或提交到 Git:
# macOS / Linux export OPENAI_API_KEY=”你的 API Key” # Windows PowerShell # $env:OPENAI_API_KEY=”你的 API Key”
第二步:创建 app.py
import os from langchain.chat_models import init_chat_model from langchain_core.output_parsers import StrOutputParser from langchain_core.prompts import ChatPromptTemplate # 1. 提前检查环境,避免请求发出后才发现没有密钥 if not os.getenv(”OPENAI_API_KEY”): raise RuntimeError(”请先设置 OPENAI_API_KEY 环境变量”) # 2. 这就是我们的“小文档”;真实项目可替换为文件内容 document = ””” 《团队差旅手册》 1. 工作日出差的餐费补贴为每天 120 元。 2. 酒店费用上限为每晚 600 元;一线城市可上浮 20%。 3. 所有报销应在行程结束后的 30 天内提交。 ”””.strip() # 3. Prompt 负责定义规则,并为文档和问题预留插槽 prompt = ChatPromptTemplate.from_messages( [ ( ”system”, ”你是企业制度问答助手。只能依据给定文档回答;” ”若文档没有答案,请明确说‘文档中未说明’。/n/n” ”文档:/n{document}”, ), (”human”, ”问题:{question}”), ] ) # 4. Model 是流水线中的“大脑” # 如账号不可用该模型,可通过 LANGCHAIN_MODEL 替换为可用模型 model = init_chat_model( os.getenv(”LANGCHAIN_MODEL”, ”openai:gpt-4.1-mini”), temperature=0, ) # 5. Parser 把模型返回的消息对象转换成普通字符串 parser = StrOutputParser() # 6. 用 | 把三个 Runnable 串成一条 Chain chain = prompt | model | parser # 7. invoke 会让输入依次经过 Prompt、Model 和 Parser answer = chain.invoke( { ”document”: document, ”question”: ”上海出差时,每晚酒店费用最高可以报销多少元?”, } ) print(answer)
运行: python app.py
预期输出
模型措辞可能略有差异,但结果应接近:
上海属于一线城市,酒店费用上限可在 600 元基础上上浮 20%, 因此每晚最高可以报销 720 元。
这段代码到底发生了什么?
ChatPromptTemplate
把制度、限制和问题组织成消息;
init_chat_model
创建统一模型对象;
StrOutputParser
把模型消息转换成便于程序使用的字符串;
prompt | model | parser
生成一个 RunnableSequence;
- invoke()
触发整条流水线。
这还不是完整 RAG,因为文档被整体放进了 Prompt。文档很小时,这种做法最容易理解;当资料变多,再升级为:
文档加载 → 文本切分 → Embedding → 向量存储 → 检索相关片段 → 生成回答
不要一开始就把所有组件装满。先跑通最小闭环,再逐步替换其中一站。
新手最容易踩的 5 个坑
坑 1:照抄旧教程,导入路径全部报错
LangChain v1 精简了主包,旧式 Chain 等能力被移到 langchain-classic。学习时先看文章发布日期和目标版本,优先使用当前官方文档。
坑 2:什么需求都做成 Agent
Agent 看起来更“智能”,但多轮决策会增加延迟、费用和不确定性。分类、摘要、固定文档问答等任务通常用 Chain 更稳。
坑 3:把 Memory 当成无限聊天记录
上下文窗口有限,历史越长不一定越聪明。应根据业务做消息裁剪、摘要和长期信息检索,并用 thread_id 隔离不同会话。
坑 4:认为接入文档就不会胡说
Prompt 注入、不相关检索和文档冲突仍会导致错误。重要答案应显示来源,并建立测试问题集,而不是只看一次演示效果。
坑 5:只看最终答案,不看中间过程
Agent 出错时,问题可能来自模型决策、工具参数、工具结果或状态。使用 LangSmith 等追踪工具观察每一步,定位效率会高很多。
三阶段学习路线:从会调用到能交付
阶段一:入门——先把固定流程跑通
目标是理解 Model、Prompt、Parser 和 Runnable。
- 完成一个摘要 Chain、一个分类 Chain、一个文档问答 Chain;
- 练习
invoke、batch和stream; - 学会通过环境变量切换模型,不在代码里硬编码密钥;
- 能解释输入和输出在每一步是什么类型。
阶段二:进阶——让应用接触外部世界
目标是掌握 Retrieval、Tool、Agent 和 Memory。
- 用文本切分、Embedding 和向量存储完成 2-Step RAG;
- 写两个真实工具,例如天气查询和数据库只读查询;
- 使用
create_agent,观察模型如何选择工具; - 用 checkpointer 保存短期状态,并理解短期与长期记忆的边界。
阶段三:实战——从 Demo 走向可靠系统
目标不是“功能能跑”,而是“结果可控”。
- 为关键问题建立输入、期望答案和评判标准;
- 增加超时、重试、限流、权限校验与人工确认;
- 记录延迟、Token、工具调用和失败原因;
- 对高风险动作采用确定性代码,Agent 只负责建议或受控决策;
- 需要复杂循环、分支和人工介入时,再深入 LangGraph。
推荐学习资源
-
LangChain 官方文档:先看 Overview、Models、Tools、Agents 和 Memory。
-
LangChain Retrieval 指南:系统理解检索流程与 2-Step RAG、Agentic RAG 的区别。
-
LangChain Academy:官方课程,适合从基础 Agent 逐步过渡到 LangGraph 与 LangSmith。
-
LangChain 官方 GitHub:查看源码、版本说明和真实 Issue,遇到 API 差异时尤其有用。
-
DeepLearning.AI:LangChain for LLM Application Development:面向新手的短课程。课程中的部分 API 可能早于 v1,建议把它用于理解概念,并用官方迁移指南核对代码。
结语:LangChain 的价值,不在“Chain”这个名字
现在再看这五个概念:
- Model 提供理解和生成能力;
- Chain 执行预先规定的步骤;
- Tool 把外部世界接进来;
- Agent 动态选择下一步;
- Memory 保存并管理状态。
LangChain 真正的价值,是把它们编排成一个可替换、可观察、可演进的系统。它不是模型本身,而是模型与真实业务之间的“胶水”。
如果你刚入门,今天只做一件事:把上面的最小示例跑起来,然后亲手增加一个问题。等你能清楚解释每一步的输入和输出,再去接向量数据库、Agent 和长期记忆,会轻松很多。
最后留一个问题:你在学习 LangChain 时,最先被哪个概念或版本差异卡住了?欢迎在评论区分享你的坑,也许正好能帮到下一位读者。
最后
2026 年一晃已经过半,AI 大模型的热潮不仅没有降温,反而持续升温!
金融行业用大模型做风控、医疗依靠 AI 解析影像,电商、制造、教育各行各业,都在把 AI 融入日常业务。曾经热闹的 “百模大战”,早就告别单纯比拼模型参数,正式进入落地应用时代。
现在企业疯狂紧缺一类人才:懂业务、懂 AI、能做出可上线项目的大模型开发工程师,岗位缺口大,薪资待遇十分可观。

风口再好,不如手握高薪 offer 实在。行情火热,普通人、程序员该怎样从零入门大模型,抓住这波机会?
今天整理好【2026 最新版】AI 大模型全套免费学习资源,覆盖零基础入门、项目实战、理论知识、大厂面试,从基础一路进阶。所有资料分类归档,没有多余杂料,无套路免费分享给想要入局 AI 赛道的程序员与零基础小白!
👇👇扫码免费领取全部内容👇👇
1、大模型系统化完整学习路线
2、大模型经典书籍&文档

3、AI 大模型最新行业研究报告

4、企业级实战项目 + 完整配套源码
5、大厂大模型面试真题汇总
6、这些资料真的有用吗?
这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。
这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


