


本文探讨了客服助手需求中不同技术方案的适用场景,包括Prompt、结构化输出、RAG、工具调用、工作流和Agent等。文章通过分析用户问题的不同类型,提出了相应的技术解决方案,并强调了在引入复杂框架前应优先考虑最小可行的技术组合。此外,文章还提供了测试题和发布前的检查清单,帮助开发者更好地理解和应用大模型技术。
假设你接到一个很常见的需求。
客服团队希望做一个助手。它要能回答公司政策,查询订单状态,必要时创建工单。有人会立刻说,做个 Agent,接上搜索、数据库和工单工具不就行了?
这句话只对了一半。
如果用户问的是「把这段投诉改得更礼貌」,Agent 是多余的。如果用户问的是「我的订单在哪里」,模型也不应该自己编一个答案。如果用户要退款,系统更不能让模型不经校验直接执行。
这篇文章要解决的不是「怎样把 Agent 跑起来」,而是更靠前的问题,什么时候该用 Prompt、结构化输出、RAG、确定性工作流或 Agent。读完后,你应该能为一个新需求选出最小可行的技术组合,并知道为什么不该一开始就堆最复杂的框架。
先把同一个需求拆开
仍然是客服助手。把用户问题分成四类,技术选择就会清晰很多。
| 用户问题 | 真正缺少的能力 | 优先方案 | 不该做什么 |
|---|---|---|---|
| 把投诉改成正式邮件 | 文本生成 | Prompt | 接数据库和 Agent |
| 从邮件提取订单号和诉求 | 稳定字段 | 结构化输出 + 校验 | 用正则解析自由文本 |
| 退货政策是什么 | 可更新的领域知识 | RAG | 让模型靠训练记忆回答 |
| 查订单并决定是否创建工单 | 外部系统与路径判断 | 工具 + 工作流或 Agent | 让模型直接写库 |
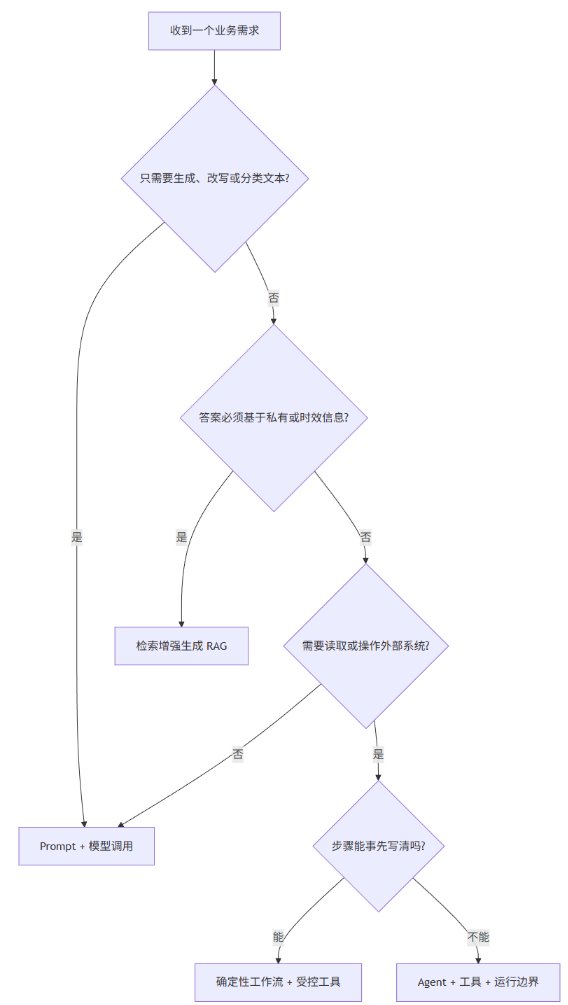
这不是从低级到高级的升级路线。它是一条复杂度阶梯。每往右走一步,系统能处理更多不确定性,同时也会增加测试、权限、成本和故障恢复的难度。
第一层, Prompt 解决表达,不解决事实
模型最擅长的,是根据上下文生成、改写、归纳或分类语言。把任务说清楚、给出必要约束、定义合格输出,往往就能完成大量工作。
例如,下面的任务是把用户来信分流。它没有任何外部动作,且结果可以人工抽查,没必要引入 Agent。
from pydantic import BaseModel, Fieldfrom langchain.chat_models import init_chat_modelclass TicketIntent(BaseModel): category: str = Field(description="退款、物流、产品咨询或其他") urgency: int = Field(ge=1, le=5) summary: strmodel = init_chat_model("openai:gpt-5.5", temperature=0)structured_model = model.with_structured_output(TicketIntent)result = structured_model.invoke( "包裹三天没有更新,我明天出差前必须收到,请尽快处理。")print(result.model_dump())
这里的关键不是 temperature=0,也不是 Prompt 写得多花哨。关键是应用先定义了自己真正要消费的数据结构。模型负责理解语言,Pydantic 负责拒绝不符合契约的结果。
Prompt 方案的边界
Prompt 不能让模型获得它并不知道的事实,也不能让它安全地操作订单系统。一个模型可以把「退款政策」讲得非常流畅,却不代表它说的是当前版本。把流畅当正确,是大模型应用里最危险的错觉之一。
第二层, RAG 解决依据,不替你判断业务规则
当答案必须来自公司制度、产品说明或经常变化的知识库时,RAG 才是正确的工具。它做的事情很朴素。

一个可靠的 RAG 流程至少有四个可检验环节。
-
文档是否完整、最新、权限正确。
-
文档如何切分,单段是否保留足够上下文。
-
检索结果是否真的召回了答案所在片段。
-
模型是否被要求只根据召回内容作答,并在证据不足时承认不知道。
读者常把注意力放在向量数据库,却忽略前两步。实际项目里,知识库混入过期政策、表格被错误解析、权限边界没有过滤,比「换一个更大的 Embedding 模型」更常导致错误答案。
RAG 的一个失败场景
假设知识库里同时存在去年的七天无理由退货政策和今天的特殊活动政策。检索返回了旧文档,模型完全可能写出一段条理清晰、语气坚定、但已经失效的答案。
解决办法不是「再强调一次不要幻觉」。需要给文档加版本和生效时间,检索时过滤过期内容,并在回答中保留来源。模型是最后一棒,不是可信度的唯一来源。
第三层, 工具调用解决行动,但行动必须有闸门
模型要查询订单、读取库存、创建工单,就必须通过工具访问外部系统。工具调用让模型拥有行动能力,也把安全和可恢复性问题带进了系统。
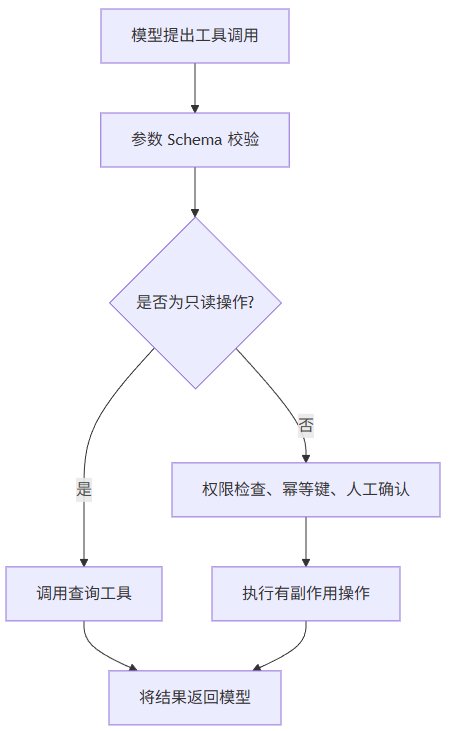
工具设计要像 API 设计一样严格。它应该有类型清晰的参数、最小权限、可审计日志和明确错误语义。
下面这个例子把查询和退款刻意拆开。查询工具可供模型直接使用,退款工具则只创建待审批请求,最终扣款由确定性业务服务完成。
from pydantic import BaseModel, Fieldclass RefundRequest(BaseModel): order_id: str reason: str = Field(min_length=5, max_length=300)def lookup_order(order_id: str) -> dict: """只读查询。真实实现应检查当前用户是否拥有该订单。""" return {"order_id": order_id, "status": "shipped"}def create_refund_review(request: RefundRequest) -> dict: """只创建待审批记录,不在此处直接退款。""" return {"review_id": "review_123", "status": "pending_approval"}
模型可以帮助收集信息、选择下一步和解释结果。但系统不能把「模型决定调用了工具」误解为「操作已经安全」。
第四层, 工作流和 Agent 的分界线
如果步骤固定,例如「校验订单号 → 查物流 → 生成回复 → 写入工单」,应把它写成确定性工作流。每个节点都可以单独测试,失败后知道从哪一步恢复。
如果目标固定、路径不固定,例如「根据用户描述判断是查订单、查政策还是转人工」,Agent 才有价值。它的职责是从有限工具集合中选择路径,不是取代所有业务逻辑。
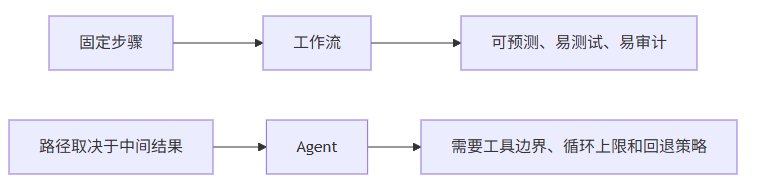
一个实用判断是,能否把流程画成一张没有菱形判断节点的图。如果能,通常先写工作流。只有当判断节点确实需要语言理解、开放式规划或动态工具选择时,才把那一小段交给 Agent。
用一套测试题决定要不要升级
在写框架前,先收集 20 到 50 个真实请求。不要只选容易成功的例子,要包括缺少信息、矛盾信息、超权限请求、过期知识和工具失败。
| 观察到的问题 | 优先补的能力 |
|---|---|
| 输出格式经常乱 | Schema、校验和修复流程 |
| 回答找不到依据 | RAG 与引用展示 |
| 答案需要系统数据 | 只读工具 |
| 固定流程容易漏步骤 | 确定性工作流 |
| 每次路径都不同 | 受限 Agent |
| 无法解释一次失败 | 追踪、日志与评测 |
这组测试题会成为以后换模型、改 Prompt、增加工具时的回归测试。没有它,系统每次看似变强,实际上可能只是换了一种失败方式。
发布到生产前,做这五个检查
- 输出是否有结构化契约和失败处理。
- 知识回答是否能展示依据,并拒绝无依据结论。
- 工具是否区分只读和有副作用操作。
- 有副作用操作是否有权限、幂等和人工确认。
- 是否能追踪一次请求调用了什么模型、什么工具、消耗多少时间和 token。
LangChain 的价值,不是让每个需求都变成 Agent。而是让模型、消息、检索、工具和运行时配置能够按需组合。先用最少的组件解决一个真实问题,才能知道下一层复杂度是否真的值得。
最后
2026 年一晃已经过半,AI 大模型的热潮不仅没有降温,反而持续升温!
金融行业用大模型做风控、医疗依靠 AI 解析影像,电商、制造、教育各行各业,都在把 AI 融入日常业务。曾经热闹的 “百模大战”,早就告别单纯比拼模型参数,正式进入落地应用时代。
现在企业疯狂紧缺一类人才:懂业务、懂 AI、能做出可上线项目的大模型开发工程师,岗位缺口大,薪资待遇十分可观。

风口再好,不如手握高薪 offer 实在。行情火热,普通人、程序员该怎样从零入门大模型,抓住这波机会?
今天整理好【2026 最新版】AI 大模型全套免费学习资源,覆盖零基础入门、项目实战、理论知识、大厂面试,从基础一路进阶。所有资料分类归档,没有多余杂料,无套路免费分享给想要入局 AI 赛道的程序员与零基础小白!
👇👇扫码免费领取全部内容👇👇
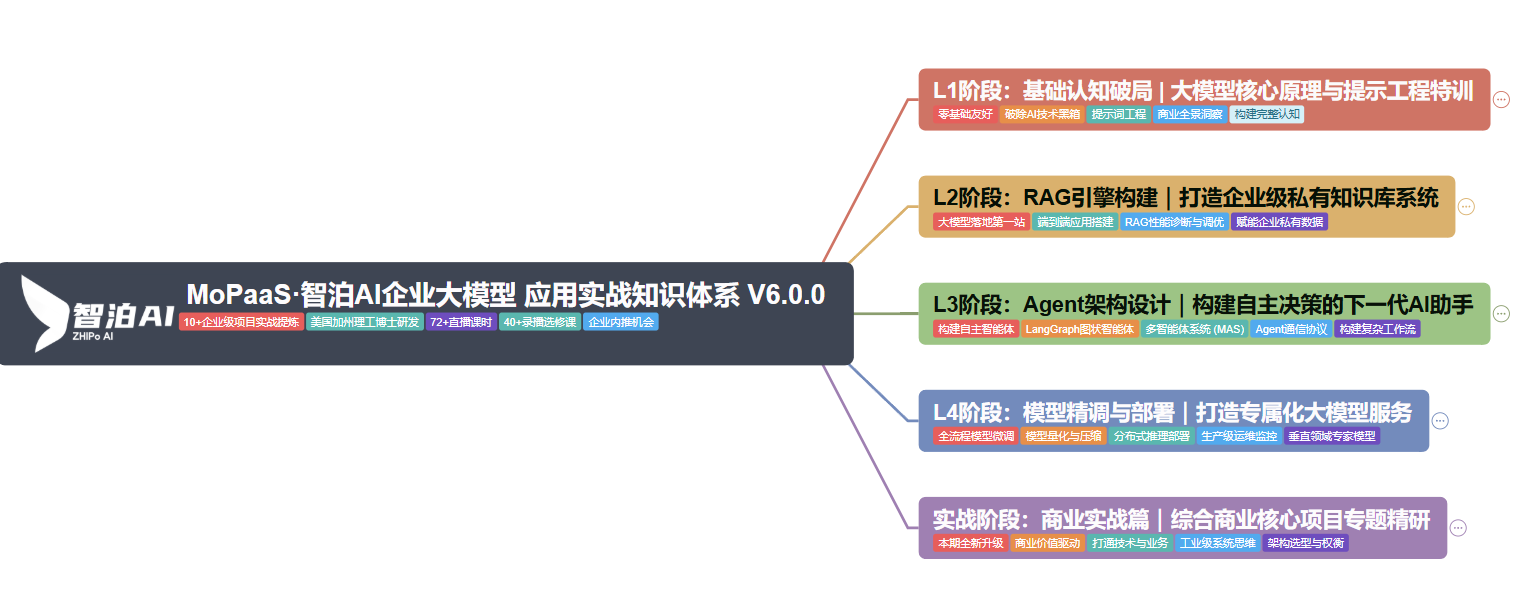
1、大模型系统化完整学习路线
2、大模型经典书籍&文档

3、AI 大模型最新行业研究报告

4、企业级实战项目 + 完整配套源码
5、大厂大模型面试真题汇总
6、这些资料真的有用吗?
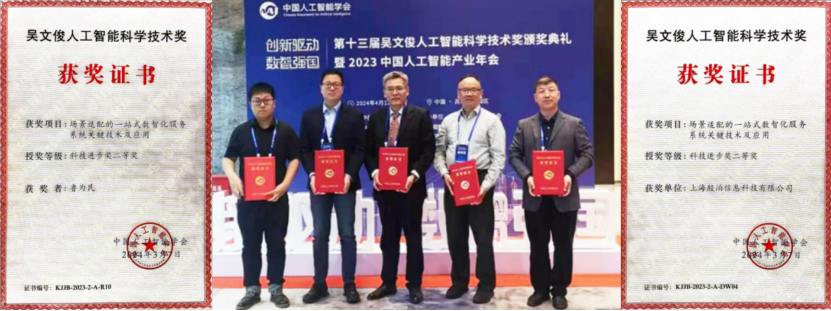
这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。
这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】


 扫一扫


 435

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


