深度学习 Transformer 的标签平滑(Label Smoothing)

标签平滑Label Smoothing)详解 标签平滑Label smoothing),像L1、L2和dropout一样,是机器学习领域的一种正则化方法,通常用于分类问题,目的是防止模型在训练时过于自信地预测标签,改善泛化能力差的问题。 阅读详情

01

引言

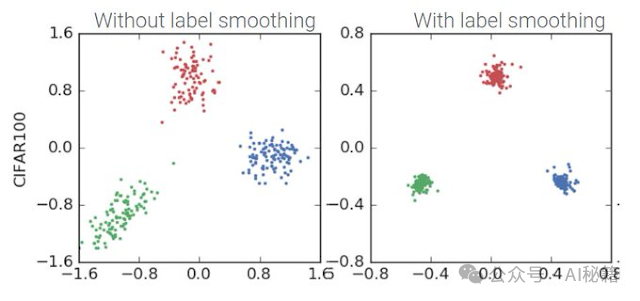
标签平滑(Label Smoothing)是一种正则化技术,用于深度学习中的分类任务,尤其是在Transformer模型中。它的目的是减少模型对于训练数据中硬标签(hard labels,即标准的one-hot编码)的过度自信,从而提高模型的泛化能力并减少过拟合。

在这里插入图片描述

02

理解

标签平滑的原理

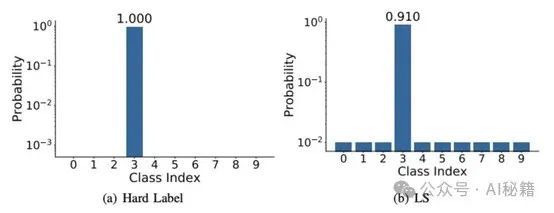
在传统的分类任务中,模型的输出通常通过softmax函数转换为概率分布,然后使用交叉熵损失函数与硬标签(one-hot编码)进行比较。硬标签意味着模型完全确定某个类别是正确的,其他所有类别都是错误的。这种方法可能会导致模型在训练数据上过拟合,因为它鼓励模型对正确类别的预测非常自信。

标签平滑通过将硬标签(hard labels)转换为软标签(soft labels)来解决这个问题。在软标签中,正确类别的概率不再是1,而是稍微小一些的值(例如,0.9),同时其他类别的概率也不再是0,而是分配了一个小的正数(例如,0.1 / 类别数)。

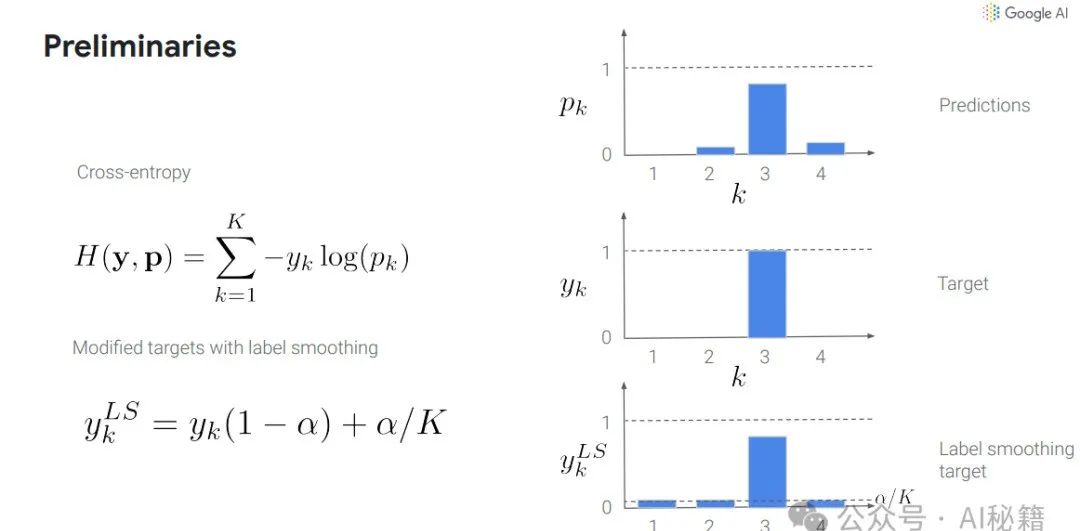
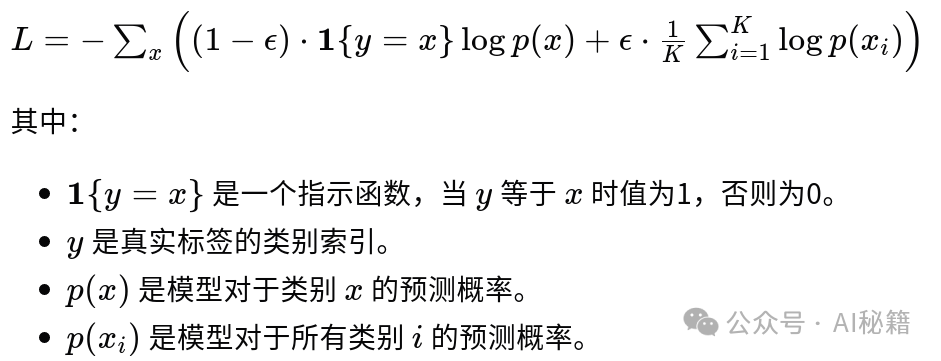
这意味着原本标签为1的位置会乘以一个小于1的因子(平滑系数),而原来为0的位置则会被赋予一个非零的值(平滑系数除以类别数K),这样就在标签中引入了一定的噪声。

标签平滑的公式

标签平滑的计算公式如下:

在这里插入图片描述

举例说明

假设我们有一个3分类问题,类别为A、B、C。在没有标签平滑的情况下,如果一个样本属于类别A,那么它的硬标签将是[1, 0, 0]。

在这里插入图片描述

标签平滑的优势在于

提升泛化能力:通过减少模型对硬标签的依赖,增加了模型在训练时的不确定性,使模型在面对未见过的数据时更加鲁棒。

降低过拟合风险:模型不会过分自信于任何一个类别,这有助于减轻过拟合现象。

改善模型校准:有助于提高模型预测值的置信度与实际准确度之间的一致性。

在这里插入图片描述

03

在Transformer中的应用

在Transformer模型中,标签平滑通常与交叉熵损失函数结合使用。这种结合的目的是在训练过程中提高模型的泛化能力,减少过拟合,并提高模型对不确定性的处理能力。下面详细解释这个结合是如何工作的:
交叉熵损失函数

在分类问题中,交叉熵损失函数(Cross-Entropy Loss)是衡量模型输出的概率分布与真实标签的概率分布之间差异的常用方法。对于多分类问题,交叉熵损失可以定义为:
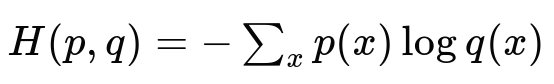
其中:

  • ( p ) 是真实标签的概率分布(在标签平滑的情况下,这是平滑后的软标签)。

  • ( q ) 是模型预测的概率分布。

标签平滑的应用

在标签平滑中,真实标签 ( p ) 不再是硬编码的one-hot向量,而是变成了软标签。例如,对于一个类别为 ( C ) 的正确标签,其one-hot表示为 ( [0, 0, …, 1, …, 0] ) (类别 ( C ) 位置为1),在标签平滑后,它会变成 ( [e/K, e/K, …, 1-e, …, e/K] ) ,其中 ( e ) 是一个小于1的平滑系数(如0.1),( K ) 是类别总数。

标签平滑与交叉熵损失的结合

当使用标签平滑的软标签与交叉熵损失结合时,模型的损失函数变为:
举例说明

假设我们有一个3分类问题,模型预测一个样本属于类别A的概率为0.8,属于类别B和C的概率各为0.1。如果未使用标签平滑,真实标签为[1, 0, 0]。使用标签平滑,假设平滑系数为0.1,则真实标签变为[0.9, 0.05, 0.05]。

交叉熵损失计算如下:
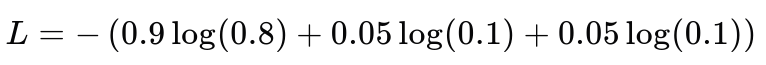
这种计算方式使得模型即使对于非常有信心的预测也不会过于自信,因为其他类别的非零概率增加了模型的不确定性,从而鼓励模型在训练过程中考虑到更多类别的可能性。

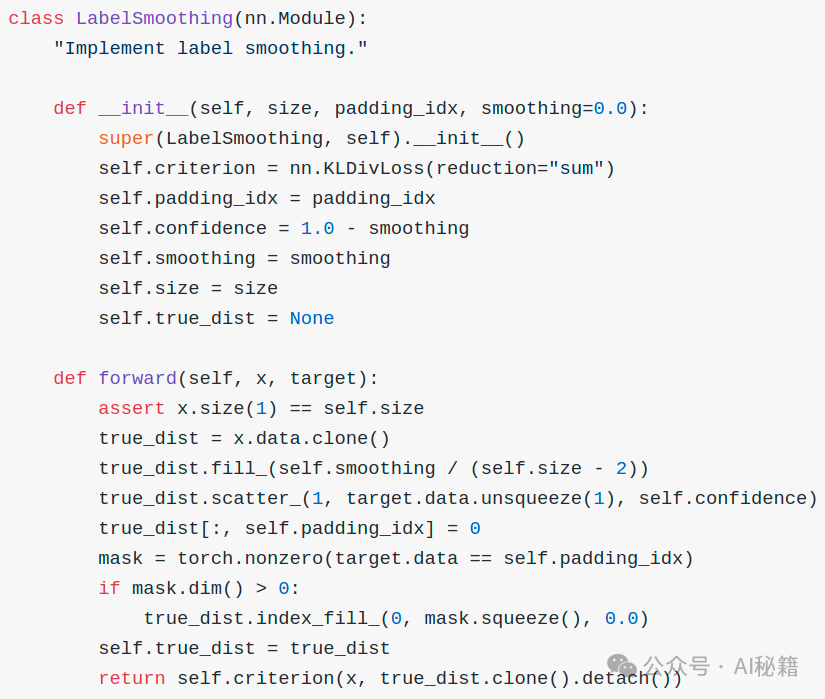
标签平滑与交叉熵损失的结合使用,通过引入软标签,提高了模型对于标签噪声的鲁棒性,减少了模型在训练数据上的过拟合,从而在实际应用中提高了模型的泛化能力。这种技术在Transformer模型中尤其有用,因为Transformer模型通常用于复杂的序列建模任务,如机器翻译、文本摘要等,这些任务中标签的不确定性较高。
04

小结

在Transformer模型中,标签平滑通常用于处理语言模型的输出。例如,在机器翻译任务中,模型需要预测下一个单词的概率分布。使用标签平滑可以防止模型对于任何单个预测过于自信,从而提高模型在面对新的、未见过的数据时的鲁棒性。

在Transformer模型中,标签平滑通常与交叉熵损失函数结合使用。通过对标签进行平滑处理,模型的输出不再是绝对的one-hot分布,而是更加平滑的概率分布,这有助于模型在训练过程中学习到更加合理的概率边界。

在实际应用中,标签平滑的平滑系数是一个超参数,需要根据具体任务和数据集进行调整。此外,标签平滑也可以与其他正则化技术(如Dropout、权重衰减等)结合使用,以达到更好的效果。

总之,标签平滑是一种简单而有效的技术,可以在不牺牲太多预测精度的情况下,提高模型的泛化能力和鲁棒性。

如何学习AI大模型?

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费

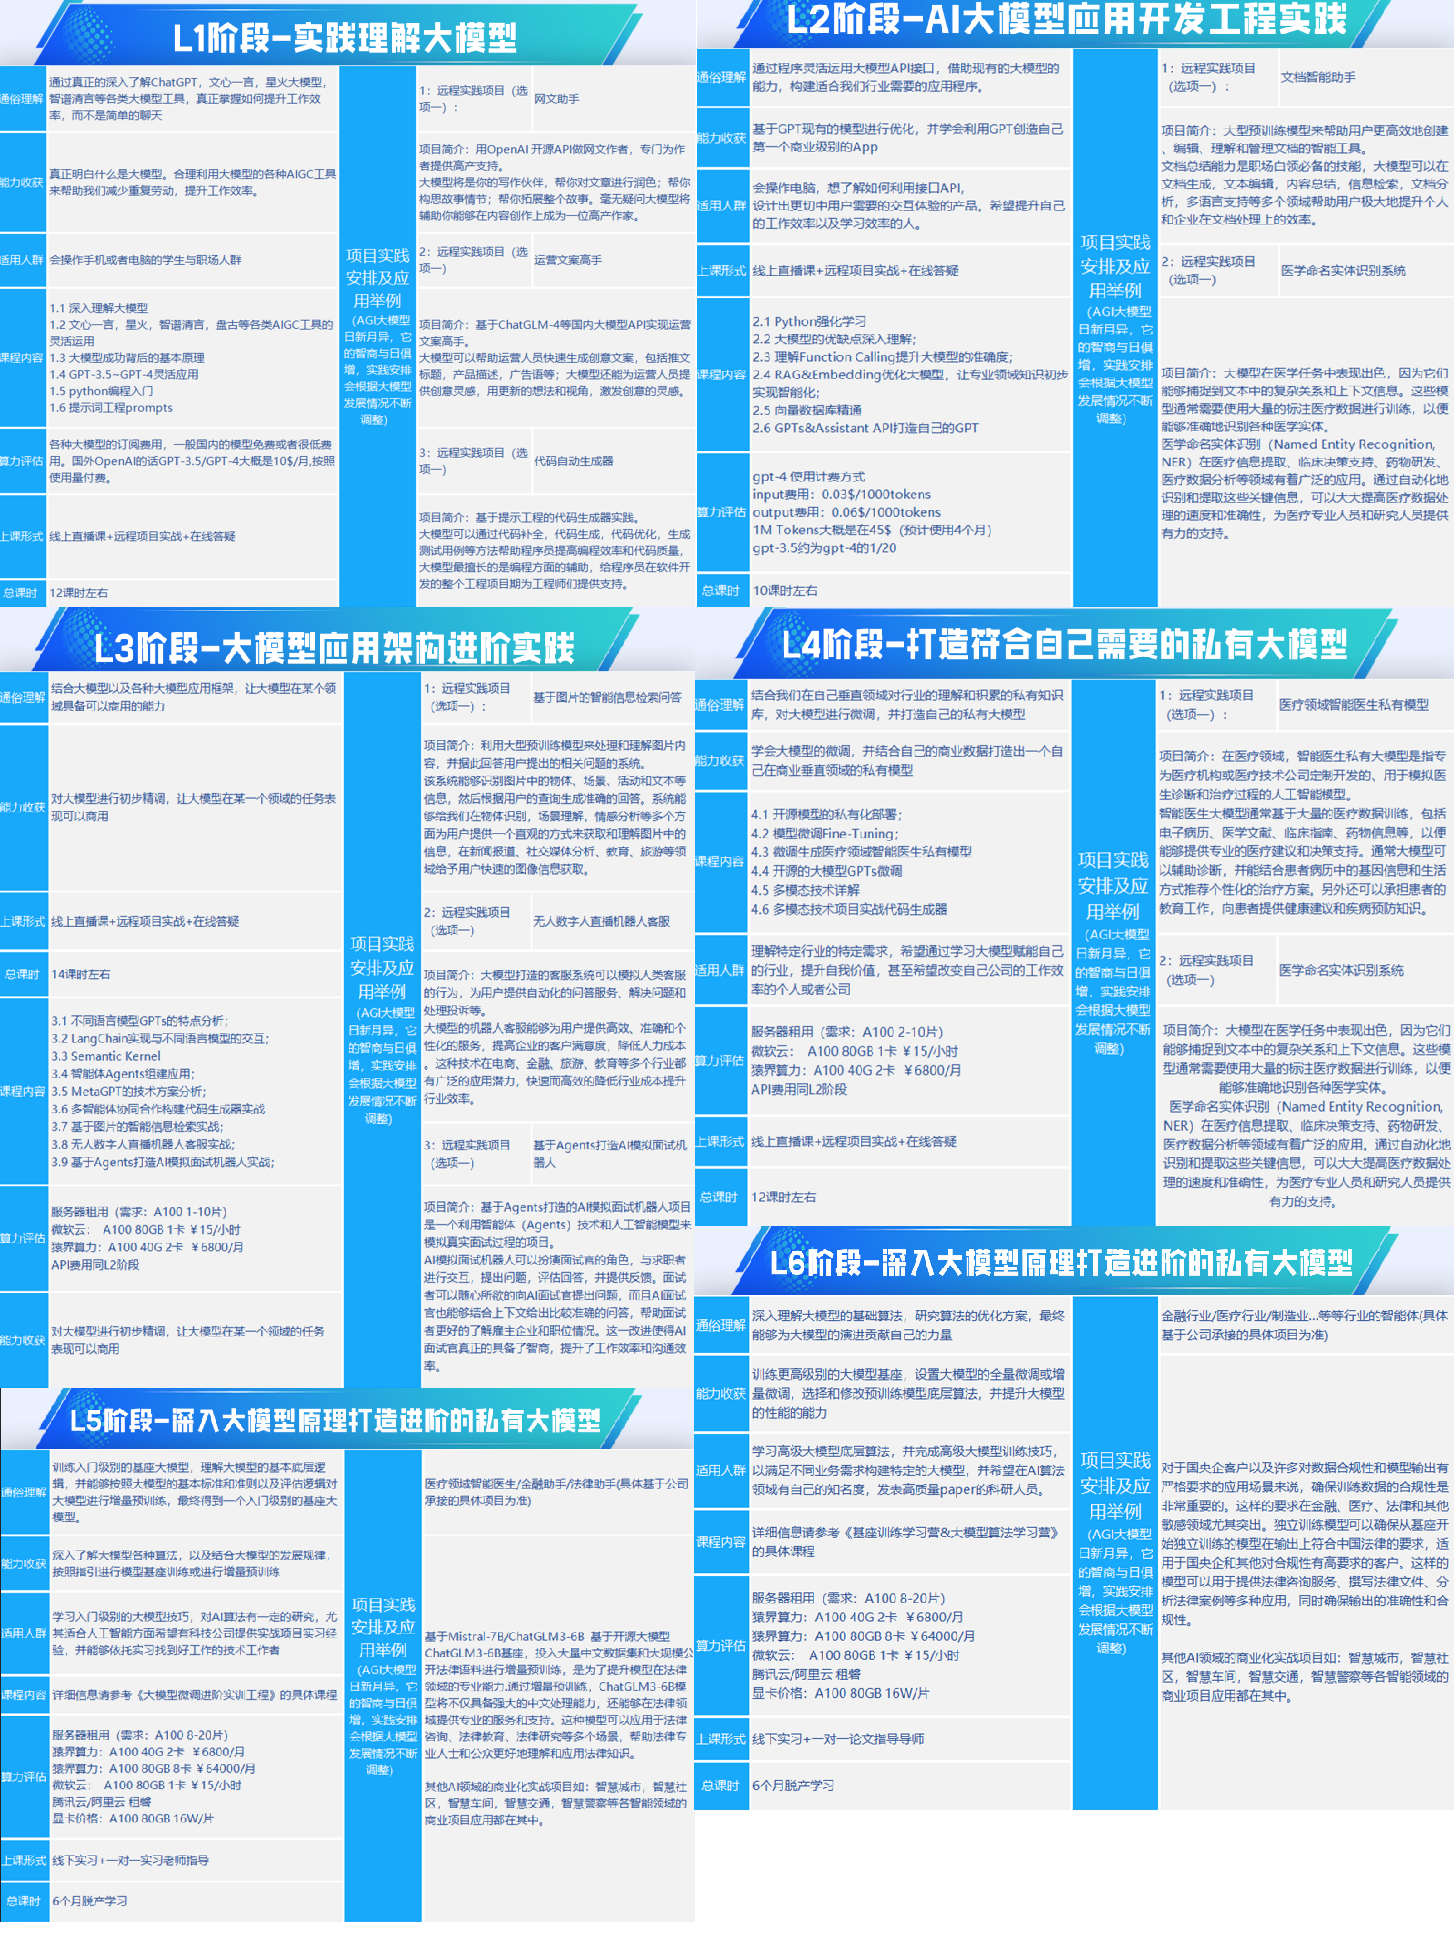
一、全套AGI大模型学习路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!
img

二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。
img

三、AI大模型经典PDF籍

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。
img

四、AI大模型商业化落地方案

img

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

【正则化】Label Smoothing详解 1. 概述        Label Smoothing标签平滑),像 L1、L2 和 Dropout 一样,是一种正则化方法,通常用于分类问题,目的是防止模型在训练时过于自信地预测标签,改善泛化能力差的问题(也是解决错误标注的一种方法)。 2. Label Smoothing 公式如下:        y’_i表示在原标签基础上修改后的标签值,y_i为原标签值。以 阅读详情

相关推荐

深度学习中的标签平滑正则化(Label Smoothing Regularization)方法原理详解

论文:https://arxiv.org/pdf/1512.00567.pdf ()、为什么有标签平滑正则化(Label Smoothing Regularization, LSR)的方法? 在深度学习样本训练的过程中,我们采用one-hot标签去进行计算交叉熵损失时,只考虑到训练样本中正确的标签位置(one-hot标签为1的位置)的损失,而忽略了错误标签位置(one-hot标签为0的位置)的损...

sinat_36618660的博客 1万+

标签平滑Label Smoothing

标签平滑 Label Smoothing

AZ_CHEN的博客 8064

Label Smoothing Cross Entropy(标签平滑交叉熵) 是什么

本文介绍了标签平滑Label Smoothing)技术。标准交叉熵损失使用硬标签(非0即1),容易导致模型过于自信、泛化能力下降。标签平滑通过将真实类别概率从1降至1−ϵ,其他类别从0提升至ϵ/(C−1),形成软标签,使模型保留对非真实类别的微小概率。这种方法能缓解过拟合、提高模型校准性和鲁棒性,被广泛应用于Vision Transformer、BERT等大模型中。

qq_57565004的博客 399

标签平滑label smoothing

标签平滑labelsmoothing)出自GoogleNetv3。

Billie使劲学的博客 2807

transformer模型详解之训练技巧:TensorFlow中的Label Smoothing

标签平滑通过软化one-hot标签,缓解模型过度自信问题,提升泛化与校准性。在Transformer大模型中尤为有效,TensorFlow仅需一行代码即可启用。结合官方Docker镜像,可快速搭建稳定高效的训练环境,助力模型性能稳步提升。

weixin_30218749的博客 404

Transformer Label-smoothing 标签平滑

Transformer Label-smoothing 标签平滑

qq_38878964的博客 714

最全指南:Transformer训练损失计算中的Label Smoothing技术

还在为Transformer模型过拟合、训练不稳定而烦恼吗?annotated-transformer项目中的Label Smoothing技术能帮你解决这些问题!本文将带你深入理解这一关键技术,让你掌握: - Label Smoothing的核心原理与优势 - annotated-transformer中的具体实现细节 - 实际应用中的最佳实践 - 如何避免常见陷阱 ## 什么是Label

gitblog_00779的博客 409

YOLO11训练中的标签平滑Label Smoothing)技术:标签平滑的原理、参数设置及其对模型泛化能力的提升

YOLO11目标检测模型中的标签平滑技术通过软化独热编码标签,将正确类别概率设为(1-ε),其他类别设为ε/(K-1),有效防止模型过度自信。该技术从信息论角度增加了标签分布的熵,在独热编码与均匀分布间取得平衡,提升了模型泛化能力。在YOLO11的多组件损失函数中,标签平滑主要作用于分类损失部分,通过调整交叉熵损失优化目标,使模型在分类、定位和置信度预测间取得更好平衡。标签平滑参数ε通常取值0.01-0.2,需根据具体任务调整,是提升目标检测性能的重要正则化手段。

本博客聚焦 YOLOv11 全流程落地,涵盖架构优化、数据集处理、训练技巧与多场景部署,兼及国产数据库、Java 开发与 AI 模型应用,内容兼顾理论与工程实践,为开发者提供系统干货,助力高效提升技术能力。 133

别再只用CrossEntropyLoss了!PyTorch实战Label Smoothing,让你的分类模型更稳一点

本文深入探讨了PyTorch中Label Smoothing标签平滑)技术的实现与应用,帮助开发者突破分类模型的准确率瓶颈。通过对比传统交叉熵损失函数,详细介绍了三种实现方式及超参数调优策略,并结合图像分类任务展示完整集成方法,有效提升模型泛化能力0.5%-2%。

weixin_30414305的博客 277

从“非黑即白”到“灰度认知”:Label Smoothing如何让AI模型告别过度自信?

本文探讨了Label Smoothing技术如何帮助AI模型克服过度自信问题,实现从“非黑即白”到“灰度认知”的转变。通过分析硬标签的局限性、标签平滑的实现原理及前沿改进方法,揭示了其在医疗诊断、模型蒸馏等场景中的多维价值,显著提升模型校准性和鲁棒性。

weixin_30274627的博客 370

别再只用CrossEntropyLoss了!PyTorch实战:用Label Smoothing提升你的分类模型泛化能力(附代码避坑)

本文深入探讨了PyTorch中Label Smoothing技术在分类模型中的应用,通过对比三种实现方式(手动平滑、封装损失、动态策略)和详细调参指南,帮助开发者有效提升模型泛化能力。文章结合CIFAR-10实战案例,展示了如何通过标签平滑技术减少过拟合,特别适合处理标注噪声和类别相似性高的场景。

weixin_30781433的博客 427

NLP损失函数实战指南:Cross-Entropy、Label Smoothing、Focal与Contrastive Loss深度解析

损失函数是深度学习模型优化的核心标尺,尤其在自然语言处理(NLP)中,它不仅衡量预测误差,更深刻影响语义建模、长尾泛化与标注鲁棒性。其原理源于概率分布匹配与梯度调控,技术价值在于将任务特性(如标签噪声、类别不平衡、序列依赖)编码为可微目标。典型应用场景涵盖文本分类、命名实体识别(NER)、机器翻译与句子嵌入——例如Cross-Entropy适用于标签明确的单标签任务,而Label Smoothing通过软化硬标签提升对人工标注不确定性的鲁棒性,Focal Loss则专为长尾NER设计以增强稀有实体召回。本文

weixin_30615767的博客 482

三招零代码过拟合防治法:Dropout剂量、标签平滑与早停策略

过拟合是深度学习模型泛化能力不足的核心表现,本质在于模型在高维空间中习得过于狭窄的决策边界,导致对数据扰动和分布偏移极度敏感。其技术原理涉及模型容量、训练噪声与优化动态的耦合失衡;通过引入结构化随机性(如Dropout)、语义不确定性建模(如Label Smoothing)和训练过程动态监控(如Early Stopping),可显著提升模型鲁棒性与部署稳定性。这三类正则化方法无需修改网络结构、不增加推理开销,已在工业级CV/NLP项目中验证为轻量高效的基础防护手段,广泛适用于小样本分类、噪声标注场景及边缘部

weixin_34302798的博客 298

Transformer 架构原理与结构详细讲解

摘要 本文系统性地讲解了 Transformer 架构的核心原理与实现细节,从自注意力机制、多头注意力等基础组件,到完整的编码器-解码器结构实现。通过 PyTorch 代码示例,详细展示了从核心模块到完整模型的构建过程,并介绍了学习率预热、标签平滑、梯度裁剪等关键训练优化技巧,帮助读者全面掌握这一革命性深度学习模型的设计精髓与实践应用。文章内容涵盖 Transformer 的整体架构、核心数学原理、代码实现以及训练优化方法,为读者提供了从理论到实践的完整学习路径。

2601_96632650的博客 484

transformer学习

代码 注意力机制中的mask是怎么回事?将注意力(QK)ij中不存在的项去掉。例如句子最大长度为10,其中一个句子的长度为5,那么j>5的项就不用算了。在机器翻译中,翻译到第i个词时,算自注意力时看不到j>i的K,因此这些j>i的项应该mask掉,注意力矩阵为下三角阵。 y_ = label_smoothing(tf.one_hot(y, depth=self.hp.vocab_size))的作用?加入后效果有少量提升。 lr = noam_scheme(self.hp.lr, glob

wxgaws的博客 219

Transformer机器翻译模型原理(The transformer model: A neural net

作者:禅与计算机程序设计艺术 1.简介 在过去几年中,深度学习技术取得了突破性的进步。Transformer模型就是其中一种成功的应用。它利用注意力机制解决序列到序列(Sequence to Sequence)任务中的标注学习问题,其性能与传统的循环神经网络(RNN)有很大的差距。本文将从背景、基本概念

AI天才研究院 1466

手写Transformer实战:从零实现PyTorch版Encoder-Decoder

Transformer是现代大语言模型的底层架构,其核心在于摒弃循环依赖、通过自注意力机制建模全局序列关系。理解其原理不能止于公式推导,而需深入张量运算细节——如QKV线性变换、多头拆分、掩码广播与位置编码融合。这些关键技术点直接决定模型能否稳定训练、高效并行,并支撑BERT、GPT等工业级应用。本文以PyTorch为工具,聚焦可调试、可打断点的手写实现,覆盖词嵌入padding对齐、causal mask维度适配、Cross-Attention双向张量流等高频工程陷阱,帮助开发者真正掌握Transform

dieyuqi2955的博客 335
上一篇: 揭秘大语言模型训练加速利器MindSpeed-LLM,让效率飙升
下一篇: 成为AI产品经理,应该具备哪些条件?
少喝冰美式
博客等级 码龄2年 6670粉丝 517原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

红包个数最小为10个

红包金额最低5元

当前余额3.43前往充值 >
需支付:10.00
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值