新手Python爬虫流程及教程详解

AI权益加码!Claude Code、Cursor等20+工具免费用! 购周边限时加赠Coding Plan Lite,畅享主流AI工具!学习进阶更高效! 阅读详情


前言

本文目的:根据本人的习惯与理解,用最简洁的表述,介绍爬虫的定义、组成部分、爬取流程,并讲解示例代码。

基础

爬虫的定义:定向抓取互联网内容(大部分为网页)、并进行自动化数据处理的程序。主要用于对松散的海量信息进行收集和结构化处理,为数据分析和挖掘提供原材料。

今日t条就是一只巨大的“爬虫”。

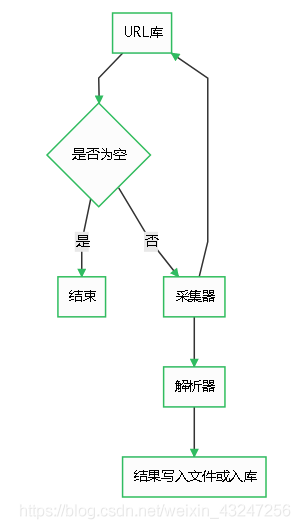
爬虫由URL库、采集器、解析器组成。

流程

如果待爬取的url库不为空,采集器会自动爬取相关内容,并将结果给到解析器,解析器提取目标内容后进行写入文件或入库等操作。
在这里插入图片描述

代码

第一步:写一个采集器

如下是一个比较简单的采集器函数。需要用到requests库。
首先,构造一个http的header,里面有浏览器和操作系统等信息。如果没有这个伪造的header,可能会被目标网站的WAF等防护设备识别为机器代码并干掉。

然后,用requests库的get方法获取url内容。如果http响应代码是200 ok,说明页面访问正常,将该函数返回值设置为文本形式的html代码内容。

如果响应代码不是200 ok,说明页面不能正常访问,将函数返回值设置为特殊字符串或代码。

import requests

def get\_page(url):
	headers = {'User-Agent': 'Mozilla/5.0 (Windows NT 6.1) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/75.0.3770.142 Safari/537.36'}
	response = requests.get(url, headers= headers)
	if response.status\_code == 200:
	  return response.text
	else:
		return 'GET HTML ERROR !'

第二步:解析器

解析器的作用是对采集器返回的html代码进行过滤筛选,提取需要的内容。
作为一个14年忠实用户,当然要用豆瓣举个栗子 _

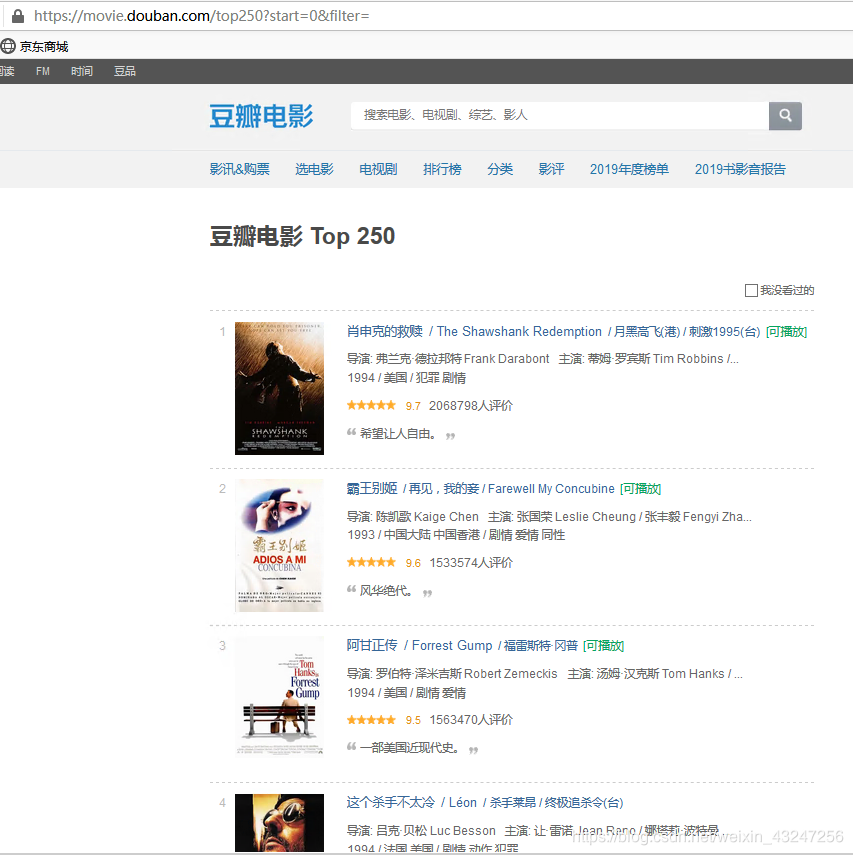
我们计划爬取豆瓣排名TOP250电影的8个参数:排名、电影url链接、电影名称、导演、上映年份、国家、影片类型、评分。整理成字典并写入文本文件。

待爬取的页面如下,每个页面包括25部电影,共计10个页面。
在这里插入图片描述

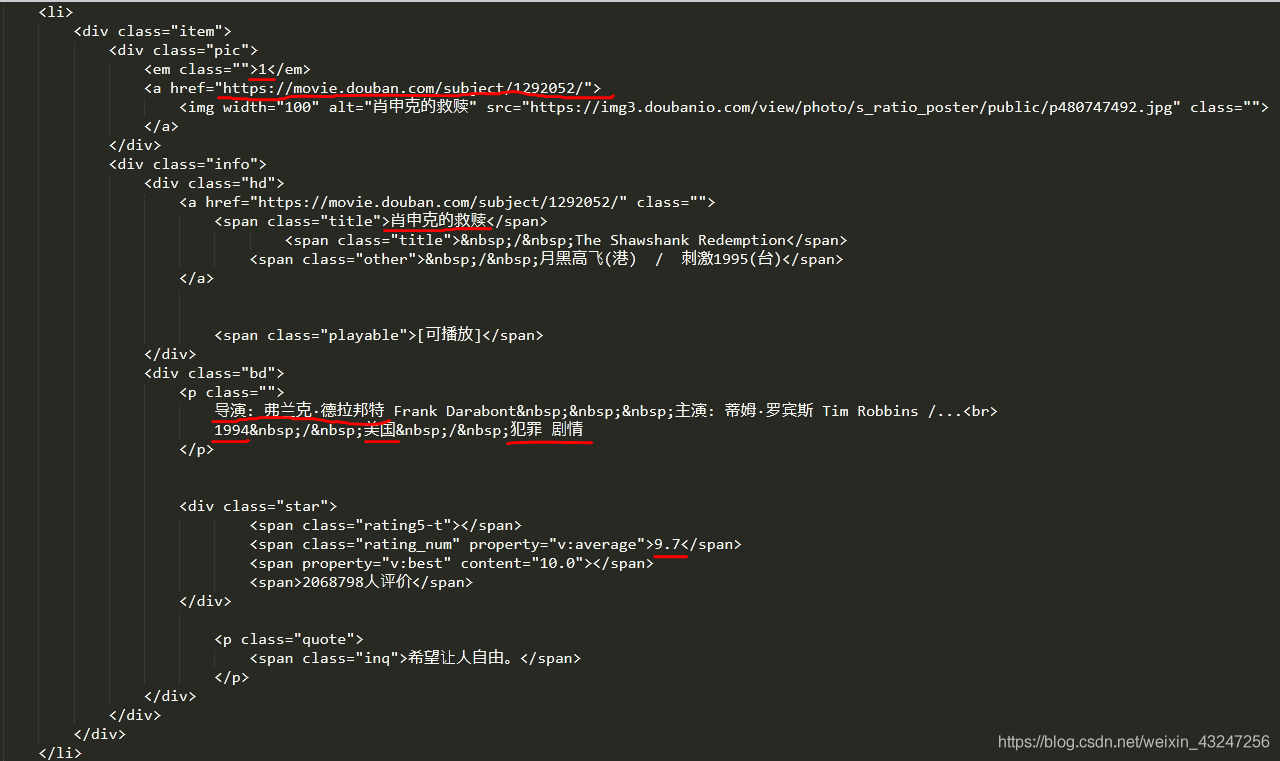
在这里,必须要表扬豆瓣的前端工程师们,html标签排版非常工整具有层次,非常便于信息提取。

下面是“肖申克的救赎”所对应的html代码:(需要提取的8个参数用红线标注)
在这里插入图片描述

根据上面的html编写解析器函数,提取8个字段。该函数返回值是一个可迭代的序列。
我个人喜欢用re(正则表达式)提取内容。8个(.*?)分别对应需要提取的字段。

import re

def parse\_page(html):
	pattern = re.compile('<em class="">(.\*?)</em>.\*?<a href="(.\*?)" rel="external nofollow" rel="external nofollow" >.\*?<span class="title">(.\*?)</span>.\*?<div class="bd">.\*?<p class="">(.\*?)&nbsp.\*?<br>(.\*?)&nbsp;/&nbsp;(.\*?)&nbsp;/&nbsp;(.\*?)</p>.\*?<span class="rating\_num".\*?"v:average">(.\*?)</span>' , re.S)
	items = re.findall(pattern , html)
	for item in items:
		yield {
		  'rank': item\[0\],
		  'href': item\[1\],
		  'name': item\[2\],
		  'director': item\[3\].strip()\[4:\],
		  'year': item\[4\].strip(),
		  'country': item\[5\].strip(),
		  'style': item\[6\].strip(),
		  'score': item\[7\].strip()
		}

提取后的内容如下:
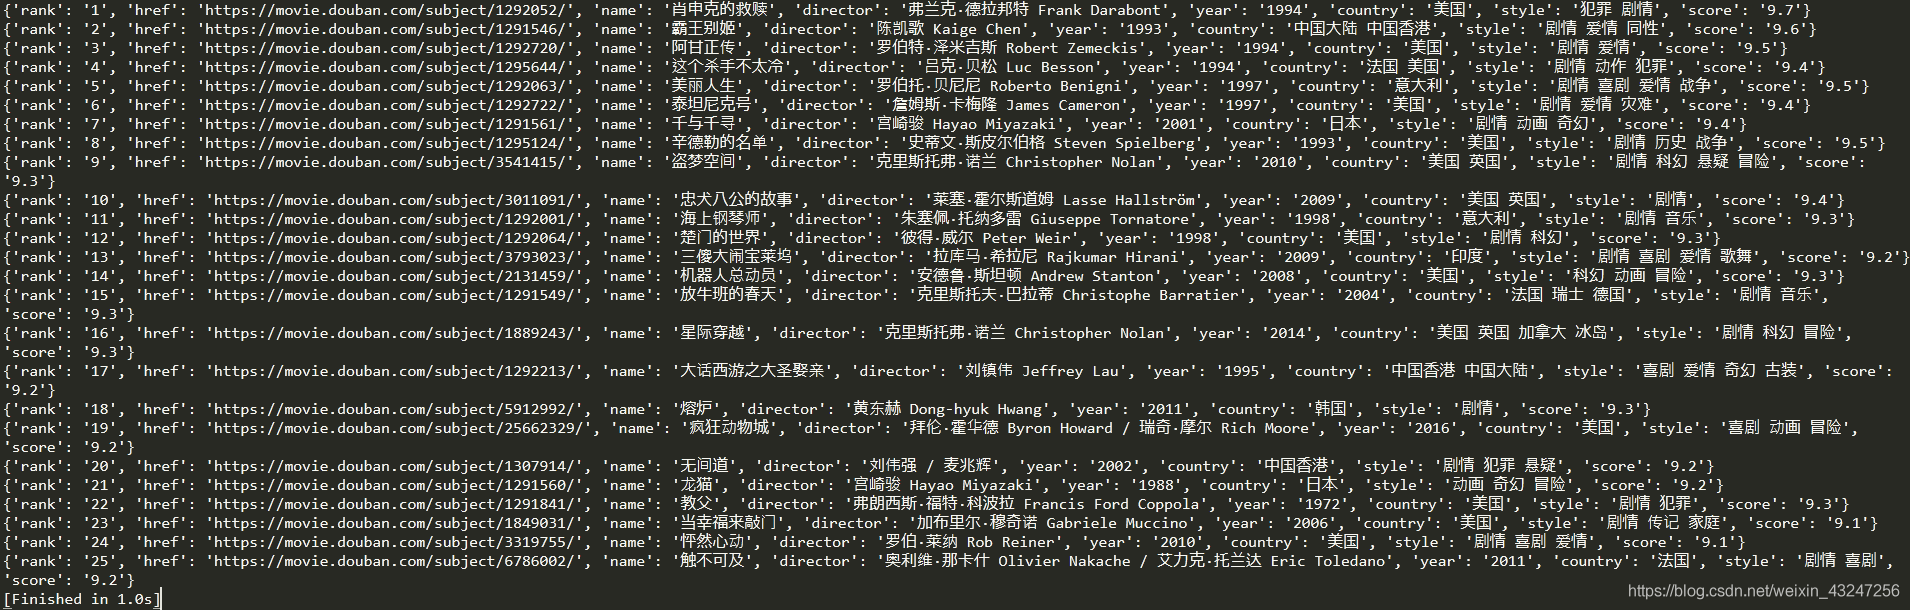
在这里插入图片描述

整理成完整的代码:(暂不考虑容错)

import requests
import re
import json

def get\_page(url):
	#采集器函数
	headers = {'User-Agent': 'Mozilla/5.0 (Windows NT 6.1) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/75.0.3770.142 Safari/537.36'}
	response = requests.get(url, headers= headers)
	if response.status\_code == 200:
	  return response.text
	else:
		return 'GET HTML ERROR ! '


def parse\_page(html):
	#解析器函数
	pattern = re.compile('<em class="">(.\*?)</em>.\*?<a href="(.\*?)" rel="external nofollow" rel="external nofollow" >.\*?<span class="title">(.\*?)</span>.\*?<div class="bd">.\*?<p class="">(.\*?)&nbsp.\*?<br>(.\*?)&nbsp;/&nbsp;(.\*?)&nbsp;/&nbsp;(.\*?)</p>.\*?<span class="rating\_num".\*?"v:average">(.\*?)</span>' , re.S)
	items = re.findall(pattern , html)
	for item in items:
		yield {
		  'rank': item\[0\],
		  'href': item\[1\],
		  'name': item\[2\],
		  'director': item\[3\].strip()\[4:\],
		  'year': item\[4\].strip(),
		  'country': item\[5\].strip(),
		  'style': item\[6\].strip(),
		  'score': item\[7\].strip()
		}


def write\_to\_file(content):
	#写入文件函数
	with open('result.txt' , 'a' , encoding = 'utf-8') as file:
		file.write(json.dumps(content , ensure\_ascii = False) + '\\n')


if \_\_name\_\_== "\_\_main\_\_":
	# 主程序
	for i in range(10):
		url= 'https://movie.douban.com/top250?start='+ str(i\*25)+ '&filter'
		for res in parse\_page(get\_page(url)):
			write\_to\_file(res)

非常简洁,非常符合python简单、高效的特点。

说明:

需要掌握待爬取url的规律,才能利用for循环等操作自动化处理。
前25部影片的url是https://movie.douban.com/top250?start=0&filter,第26-50部影片url是https://movie.douban.com/top250?start=25&filter。规律就在start参数,将start依次设置为0、25、50、75。。。225,就能获取所有页面的链接。parse_page函数的返回值是一个可迭代序列,可以理解为字典的集合。运行完成后,会在程序同目录生成result.txt文件。内容如下:
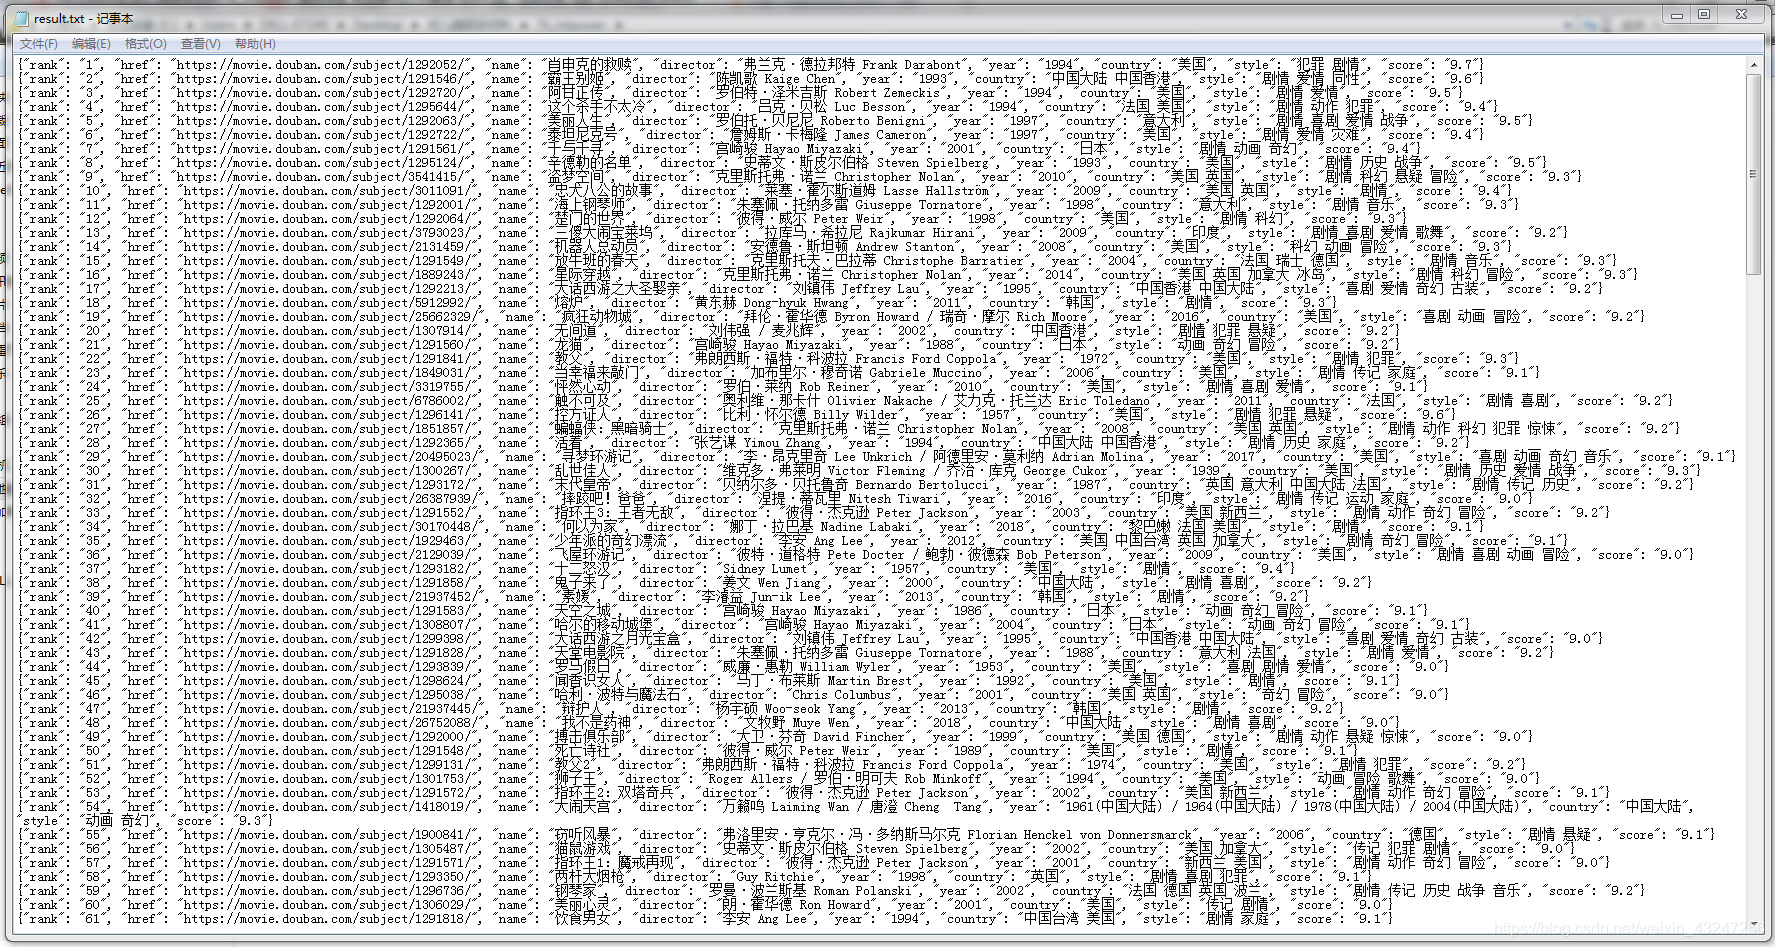
在这里插入图片描述


关于Python技术储备

学好 Python 不论是就业还是做副业赚钱都不错,但要学会 Python 还是要有一个学习规划。最后大家分享一份全套的 Python 学习资料,给那些想学习 Python 的小伙伴们一点帮助!

👉CSDN大礼包:《Python入门资料&实战源码&安装工具】免费领取安全链接,放心点击

一、Python所有方向的学习路线

Python所有方向的技术点做的整理,形成各个领域的知识点汇总,它的用处就在于,你可以按照上面的知识点去找对应的学习资源,保证自己学得较为全面。
在这里插入图片描述

二、Python基础学习视频

② 路线对应学习视频

还有很多适合0基础入门的学习视频,有了这些视频,轻轻松松上手Python~在这里插入图片描述
在这里插入图片描述

③练习题

每节视频课后,都有对应的练习题哦,可以检验学习成果哈哈!
在这里插入图片描述
因篇幅有限,仅展示部分资料

三、精品Python学习书籍

当我学到一定基础,有自己的理解能力的时候,会去阅读一些前辈整理的书籍或者手写的笔记资料,这些笔记详细记载了他们对一些技术点的理解,这些理解是比较独到,可以学到不一样的思路。
在这里插入图片描述

四、Python工具包+项目源码合集
①Python工具包

学习Python常用的开发软件都在这里了!每个都有详细的安装教程,保证你可以安装成功哦!
在这里插入图片描述

②Python实战案例

光学理论是没用的,要学会跟着一起敲代码,动手实操,才能将自己的所学运用到实际当中去,这时候可以搞点实战案例来学习。100+实战案例源码等你来拿!
在这里插入图片描述

③Python小游戏源码

如果觉得上面的实战案例有点枯燥,可以试试自己用Python编写小游戏,让你的学习过程中增添一点趣味!
在这里插入图片描述

五、面试资料

我们学习Python必然是为了找到高薪的工作,下面这些面试题是来自阿里、腾讯、字节等一线互联网大厂最新的面试资料,并且有阿里大佬给出了权威的解答,刷完这一套面试资料相信大家都能找到满意的工作。
在这里插入图片描述
在这里插入图片描述

六、Python兼职渠道

而且学会Python以后,还可以在各大兼职平台接单赚钱,各种兼职渠道+兼职注意事项+如何和客户沟通,我都整理成文档了。
在这里插入图片描述
在这里插入图片描述
这份完整版的Python全套学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费

如何快速建立一个网络爬虫(初学者指南) 作为一个采集新手,我搭建了一个网络爬虫,成功的从Amazon Career 网站中提取了20000条数据。如何建立一个网络爬虫并导出到数据库,最终可以将数据无成本地转变成你的财富?跟着我我往下看吧。 什么是网络爬虫? 网络爬虫是一种网络机器人,它将互联网上的网页内容进行索引,然后它会自动抓取目标信息和数据。最后,它将数据导出为结构化的格式(列表/表格/数据库)。 ... 阅读详情

相关推荐

《用Python写网络爬虫第2版》PDF中英文+代码分析

互联网包含了迄今为止最有用的数据集,并且大部分可以免费公开访问。但是,这些数据难以复用。它们被嵌入在网站的结构和样式当中,需要抽取出来才能使用。从网页中抽取数据的过程又称为网络爬虫,随着越来越多的信息被发布到网络上,网络爬虫也变得越 来越有用。 在理想状态下,网络爬虫并不是必需品,每个网站都应该提供API,以结构化的格式共享它们的数据。然而在现实情况中,虽然一...

1万+

零基础友好:用快马生成带详解的龙虾openclaw新手安装教程

它的优势在于提供了简单易用的API,即使没有太多编程经验也能快速上手。我最大的感受是,这种交互式的学习方式比单纯看文档效率高多了。虚拟环境是Python开发中非常重要的概念,它相当于一个独立的沙盒,可以避免不同项目之间的依赖冲突。,它生成的教程特别适合零基础用户,今天就结合我的实际体验,分享下如何用最简单的方式完成安装。来生成这类教程,它不仅能把每个步骤都解释得很清楚,还能直接运行代码验证结果,对新手特别友好。激活后,命令行前面会出现(venv)的提示,表示已经在虚拟环境中了。使用国内镜像源加速。

CrystalwaveStag的博客 47

Python爬虫入门教程:超级简单的Python爬虫教程

这是一篇详细介绍Python爬虫入门的教程,从实战出发,适合初学者。读者只需在阅读过程紧跟文章思路,理清相应的实现代码,30 分钟即可学会编写简单的 Python 爬虫。 这篇 Python 爬虫教程主要讲解以下 5 部分内容: 了解网页; 使用 requests 库抓取网站数据; 使用 Beautiful Soup 解析网页; 清洗和组织数据; 爬虫攻防战; 了解网页 以旅游网首页为例,抓取旅游网首页首条信息(标题和链接),数据以明文的形式出面在源码中。在中国旅游网首页,按快捷键【Ctr..

xunmi1996的博客 3355

python爬虫入门教程(一):开始爬虫前的准备工作

python爬虫(数据采集)入门教程

笔墨留年。 8万+

【论文投稿】Python 网络爬虫:探秘网页数据抓取的奇妙世界

在当今数字化信息呈爆炸式增长的时代,网络爬虫宛如一把神奇的钥匙,开启了通往海量数据宝藏的大门。无论是商业领域的市场情报搜集、科研工作中的资料聚合,还是个人兴趣驱动下的信息整合,网络爬虫都展现出了无与伦比的价值。今天,就让我们一同走进 Python 网络爬虫的精彩世界,探索其中的奥秘。Python 网络爬虫为我们打开了一扇通往无限数据世界的大门,在商业、科研、生活等各个领域释放出巨大能量。通过掌握requestsScrapy等核心工具和框架,我们能够披荆斩棘,克服重重挑战,从网页的海洋中挖掘出珍贵的数据宝藏。

来自想要赚大钱的小周同学 9449

如何自学Python爬虫新手小白入门教程

如何自学Python爬虫?在大家自学爬虫之前要解决两个常见的问题,一是爬虫到底是什么?二是问什么要用Python来做爬虫爬虫其实就是自动抓取页面信息的网络机器人,至于用Python爬虫的原因,当然还是为了方便。本文将为大家提供一份详细的新手入门教程,带大家从入门到精通Python爬虫技能。 一、爬虫是什么? 网络爬虫又被称为网页蜘蛛,网络机器人,在FOAF社区中间,更经常的称为网页追逐者。它是一种按照一定的规则,自动地抓取万维网信息的程序或者脚本。另外一些不常使用的名字还有蚂蚁、自动索引、模拟程序。其

5183

使用python编写网络爬虫

使用python编写网络爬虫前言1、为何使用爬虫2、编写爬虫的知识要求3、确定爬虫使用的工具库4、确定要获取的数据集4.1 分析Url地址变化4.2 获取目标数据集所在的HTML区域如何插入一段漂亮的代码片生成一个适合你的列表创建一个表格设定内容居中、居左、居右SmartyPants创建一个自定义列表如何创建一个注脚注释也是必不可少的KaTeX数学公式新的甘特图功能,丰富你的文章UML 图表FLowchart流程图导出与导入导出导入 前言 此篇文章是本人编写爬虫获取数据的心得体会,涉及到数据收集、数据预处理

qq_44092306的博客 7745

新手入门Python爬虫的全流程详解

网络爬虫(又被称为网页蜘蛛,网络机器人)就是模拟浏览器发送网络请求,接收请求响应,一种按照一定的规则,自动地抓取互联网信息的程序。 原则上,只要是浏览器(客户端)能做的事情,爬虫都能够做。

python03011的博客 2282

利用Python网络爬虫下载一本小说

本文详细介绍了如何使用Python网络爬虫下载一本小说,从准备工作到案例实现,再到注意事项与优化,旨在帮助新手朋友理解和掌握网络爬虫的基本技术和应用。通过本文的学习和实践,相信读者已经对网络爬虫有了更深入的了解,并能够根据自己的需求进行扩展和优化。​

Everly_的博客 2624

如何用Python网络爬虫爬取一本小说?

本文详细介绍了如何使用Python网络爬虫下载一本小说,从准备工作到案例实现,再到注意事项与优化,旨在帮助新手朋友理解和掌握网络爬虫的基本技术和应用。通过本文的学习和实践,相信读者已经对网络爬虫有了更深入的了解,并能够根据自己的需求进行扩展和优化。​如果你对Python感兴趣,想要学习python,这里给大家分享一份Python全套学习资料,都是我自己学习时整理的,希望可以帮到你,一起加油!😝有需要的小伙伴,可以V扫描下方二维码免费领取🆓。

AI大模型资料分享员 2452

Python网络爬虫相关基础概念,新手必看!

网络爬虫又称网络蜘蛛、网络机器人,它是一种按照一定的规则自动浏览、检索网页信息的程序或者脚本。网络爬虫能够自动请求网页,并将所需要的数据抓取下来。通过对抓取的数据进行处理,从而提取出有价值的信息。

Python_trys的博客 2058

由浅到深玩转Python爬虫(一)初识爬虫

由于自身对爬虫技术的热衷以及在爬虫领域多年经验积累,决定综合爬虫领域的技术及我个人的经历写成一系列由浅到深的爬虫技术文章,希望以最简单方式、最实用的方式为爬虫初学者带来学习上的帮助、对从事爬虫领域的工程师带来新的感官、其实最大的初衷则是为未来的自己留下曾经在这个领域待过的足迹!

吴秋霖的博客 1万+

小白学Python,网络爬虫篇(1)——requests库

网络爬虫通俗来讲就是使用代码将 HTML 网页的内容下载到本地的过程。爬取网页主要是为了获取网页中的关键信息,例如网页中的数据、图片、视频等。Python 语言中提供了多个具有爬虫功能的库,下面将具体介绍。urllib 库:是 Python 自带的标准库,无须下载、安装即可直接使用。urllib 库中包含大量的爬虫功能,但其代码编写略微复杂。requests 库:是 Python 的第三方库,需要下载、安装之后才能使用。

2201_75607087的博客 3243

Python写网络爬虫(一)

首先,在学习网络爬虫之前,需要先了解它是什么! 网络爬虫简介 网络爬虫:web crawler(又称为网页蜘蛛,网络机器人,在FOAF社区中间,更经常的称为网页追逐者),是一种按照一定的规则,自动地抓取万维网信息的程序或者脚本。另外一些不常使用的名字还有蚂蚁、自动索引、模拟程序或者蠕虫。 上面这些都是百度百科晦涩难懂的官话,用我们自己的话来说, 爬虫就是:通过我们自己编写的程序,模拟浏览器上网,然后让其去互联网抓取我们想要的数据的过程。 爬虫在使用场景中的分类..................

苍夜月明的博客 7518

Python网络爬虫步骤是什么?新手小白必看 !

python网络爬虫步骤:首先准备所需库,编写爬虫调度程序;然后编写url管理器,并编写网页下载器;接着编写网页解析器;最后编写网页输出器即可。本教程操作环境:windows7系统、python3.9版,DELL G3电脑。我们需要准备一款名为BeautifulSoup(网页解析)的开源库,用于对下载的网页进行解析,我们是用的是PyCharm编译环境所以可以直接下载该开源库。步骤如下:选择File->Settings。

wslejbb的博客 1666

Python爬虫Python网络爬虫步骤是什么?新手小白必看 !

python网络爬虫步骤:首先准备所需库,编写爬虫调度程序;然后编写url管理器,并编写网页下载器;接着编写网页解析器;最后编写网页输出器即可。本教程操作环境:windows7系统、python3.9版,DELL G3电脑。我们需要准备一款名为BeautifulSoup(网页解析)的开源库,用于对下载的网页进行解析,我们是用的是PyCharm编译环境所以可以直接下载该开源库。步骤如下:选择File->Settings。

xiaolinyui的博客 1412

基于Python的三种主流网络爬虫技术

简单介绍了目前基于Python的主流网络爬虫技术以及常见的反爬虫技术

weixin_62640246的博客 2784

Python——网络爬虫

此篇文章继续跟着小甲鱼的视频来初学网络爬虫,除了小甲鱼的网站上可下载视频,发现b站上也有全套的视频哦,会比下载来的更方便些。

xxue345678的博客 886

我的爬虫入门书 —— 《Python3网络爬虫开发实战(第二版)》

年前学习python基础知识之后,在好奇心的推动下,我开始接触了python网络爬虫,而在刚开始接触网络爬虫时,繁多的资料让我猝不及防,对于习惯于优先通过书籍进行自主学习的我来说,通过长期看视频学习反而不是很习惯,但是在网络上找到的许多爬虫相关资料,不是说的过于简略,就是部分内容有些“过时”。该跟谁走?该怎么走?这个问题那段时间一直困扰着我。所幸,在热心群友的推荐下(haha,真的很热心的一个老哥),我入手了崔大写的《Python3网络爬虫开发实战(第二版)》,找到了符合我状况的“引路书”。

weixin_68789096的博客 2140
上一篇: 1分钟快速理解Python语言基础
下一篇: 详解Python利用Pandas和 NumPy 库来进行数据清洗
一秋的编程笔记
博客等级 码龄4年 1575粉丝 319原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

红包个数最小为10个

红包金额最低5元

当前余额3.43前往充值 >
需支付:10.00
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值