nutch + solr —— 搭建初探

开发者福利!热门AI工具限时免费用 购周边即赠Coding Plan Lite,Claude Code、Cursor等20+工具畅享,效率翻倍! 阅读详情

一. 环境:

apache-nutch-1.8

solr-4.7.0


二. nutch配置提示:
1. 配置 nutch-site.xml

<property>
  <name>http.agent.name</name>
  <value>MySpider</value>
</property>
 
<property>
  <name>http.robots.agents</name>
  <value>MySpider,*</value>
</property>
http.agent.name 必填

http.robots.agents 选填,若不填,fetch开始时会提示,但不影响运行


2. 修改bin/nutch 权限

chmod +x bin/nutch


3. deploy 目录只有以部署二进制包的形式安装nutch,才会出现


4. regex-urlfilter.txt 分析

# skip file: ftp: and mailto: urls
-^(file|ftp|mailto):
- 表示过滤掉满足后面正则表达式的urls

^表示开头

file|ftp|mailto 表示要过滤掉开头是file,ftp,mailto的urls


三. solr配置提示:

  • cp ${NUTCH_RUNTIME_HOME}/conf/schema.xml ${APACHE_SOLR_HOME}/example/solr/conf/

  • vim ${APACHE_SOLR_HOME}/example/solr/conf/schema.xml
  • Copy exactly in 351 line: <field name="_version_" type="long" indexed="true" stored="true"/>    (collection1/conf 中已有此项)

  • restart Solr with the command “java -jar start.jar” under ${APACHE_SOLR_HOME}/example


master上配置好nutch及solr后,移植到其他slave上。

1. scp 两个文件夹过去

2. scp /etc/profile

3. source /etc/profile

4. 注意,若hadoop已经移植过去,那么若之后master上配置有改,记得同步到其他slave上。

5. 注意权限问题。具体要给那些加上权限...不太记得了。可能用到的都附上权限吧。。


四. 排错:

1. 运行nutch提示后退出:Generator: 0 records selected for fetching, exiting ...

bin/nutch readdb data/crawldb -stats

可以查看CrawlDB的信息
hadoop@master:~/apache-nutch-1.8$ bin/nutch readdb data/crawldb -stats
CrawlDb statistics start: data/crawldb
Statistics for CrawlDb: data/crawldb
TOTAL urls:	1
retry 1:	1
min score:	1.0
avg score:	1.0
max score:	1.0
status 1 (db_unfetched):	1
CrawlDb statistics: done

db_unfetched 为1,但是retry也为1,所以是抓取失败了。
我的办法是,把data删了,重新执行一遍,成功。


2. Job failed

command

bin/crawl urls/seed.txt data http://localhost:8983/solr/ 2

error

Indexer: java.io.IOException: Job failed!
	at org.apache.hadoop.mapred.JobClient.runJob(JobClient.java:1357)
	at org.apache.nutch.indexer.IndexingJob.index(IndexingJob.java:114)
	at org.apache.nutch.indexer.IndexingJob.run(IndexingJob.java:176)
	at org.apache.hadoop.util.ToolRunner.run(ToolRunner.java:65)
	at org.apache.nutch.indexer.IndexingJob.main(IndexingJob.java:186)

solr log

org.apache.solr.common.SolrException: ERROR: [doc=http://www.163.com/] unknown field 'host'


nutch log

org.apache.solr.common.SolrException: Bad Request

Bad Request

request: http://localhost:8080/solr/update?wt=javabin&version=2


解决

修改 ${APACHE_SOLR_HOME}/example/solr/collection1/conf/schema.xml

在<fields> 与 <fields> 中间增加

<field name="host" type="string" stored="false" indexed="true"/> 
<field name="digest" type="string" stored="true" indexed="false"/> 
<field name="segment" type="string" stored="true" indexed="false"/> 
<field name="boost" type="float" stored="true" indexed="false"/> 
<field name="tstamp" type="date" stored="true" indexed="false"/>

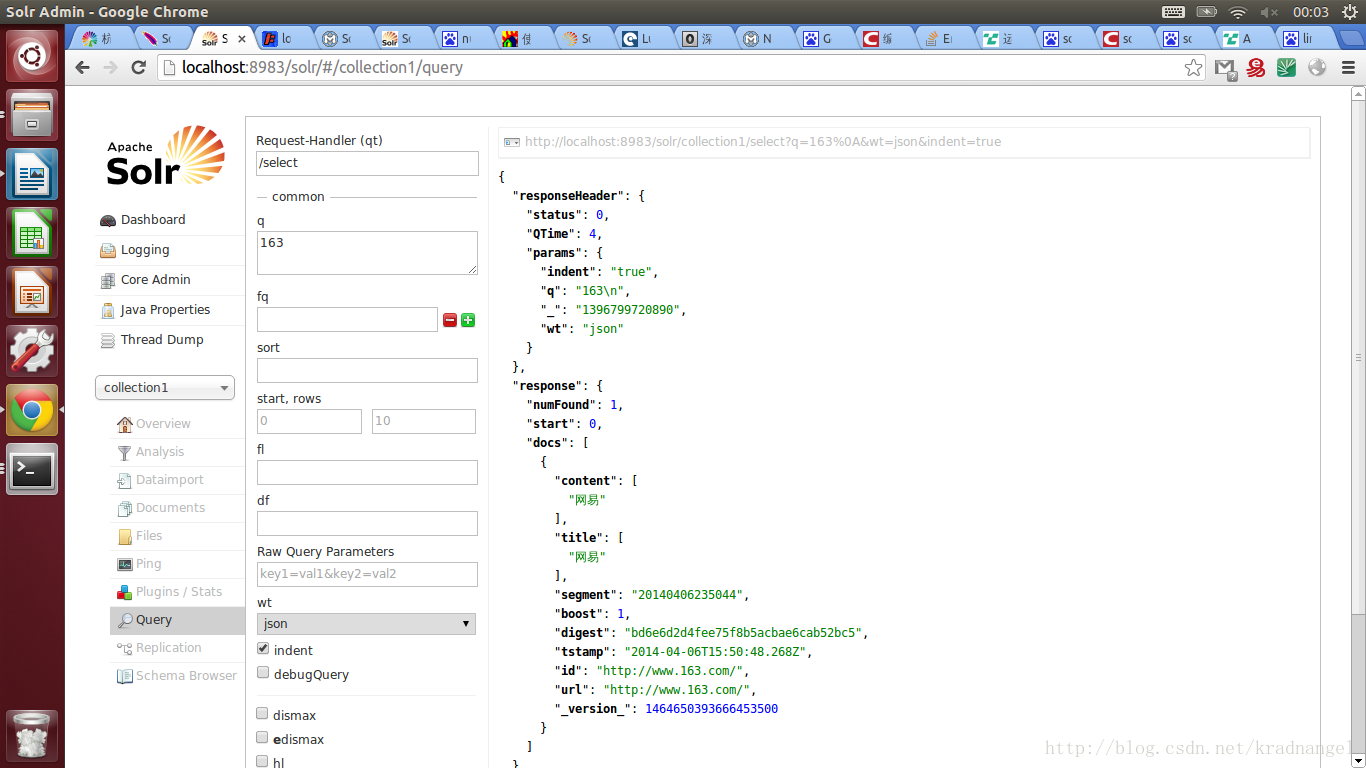
效果

检索抓取到的内容,用浏览器打开  http://localhost:8983/solr/#/collection1/query  


参考

http://stackoverflow.com/questions/13429481/error-while-indexing-in-solr-data-crawled-by-nutch

http://blog.csdn.net/panjunbiao/article/details/12171147


3. Warning: $HADOOP_HOME is deprecated.

在/etc/profile中加

export HADOOP_HOME_WARN_SUPPRESS=1

4. nutch在hadoop上跑时出错:

14/04/08 12:28:07 INFO mapred.JobClient:     Map output records=1
14/04/08 12:28:07 INFO crawl.Generator: Generator: finished at 2014-04-08 12:28:07, elapsed: 00:00:51
ls: 无法访问data/segments/: 没有那个文件或目录
Operating on segment : 
Fetching :

解决:见我另一篇博文:

nutch on hadoop 遇到 ls: 无法访问data/segments: 没有那个文件或目录


五. 待解决:

1. 压力测试

Solr集群Replication配置与实践

http://blog.csdn.net/shirdrn/article/details/7055355


2. anchor

org.apache.solr.common.SolrException: ERROR: [doc=http://baike.baidu.com/] unknown field 'anchor'

怀疑是中文分词之类的问题

http://www.163.com/ 没问题

http://www.baidu.com    http://www.renren.com  有问题

http://nutch.apache.org/   http://hadoop.apache.org/   http://lucene.apache.org/    没问题

3. Generator:0 records selected for fetching,

怀疑是url数量不够,增加url之后,问题解决。


六. 附录:

Nutch学习笔记二——抓取过程简析


Nutch+Hadoop集群搭建


Nutch-hadoop集群配置——Ubuntu10.04

观察nutchcrawl的每一步

国内首套免费的《Nutch相关框架视频教程》(1-16)

Solr配置文件:schema.xml

深入Solr实战

Lucene/ Solr开发经验

NutchTutorial

Hadoop Shell命令

DataNode节点上数据块的完整性——DataBlockScanner

h​a​d​o​o​p​ ​n​u​t​c​h​ ​s​o​l​r​ ​环​境​搭​建​手​册

Solr调研总结

Hadoopp的日志

Nutch的命令详解


提高nutch爬取效率

Nutch 插件系统浅析


网络爬虫调研报告


【爬虫】Nutch1.15 & Solr 8.2.0 配置 文章目录Nutch1.x vs 2.x环境安装过程JAVA_HOME下载nutch & solrNutch配置Solr配置Questions Nutch 1.x vs 2.x Nutch development has been focused mainly on 1.x for the last few years. 2.x was designed with Apache Gora,... 阅读详情

相关推荐

[Nutch]Nutch2.3+Hadoop+HBase+Solr在Ubuntu环境搭建

上一篇博文介绍了在Windows 10系统下用Cygwin搭建Nutch开发环境,本文将介绍在Ubuntu下Nutch2.3的开发环境的搭建。 1. 需要的软件及其版本 Ubuntu 15.04 hadoop 1.2.1 hbase 0.94.27 nutch 2.3 solr 4.9.1 2. 系统环境准备2.1 安装Ubuntu操作系统基本要求,网上也有很多,自行安装,有问题可

Kandy 4867

Nutch搜索引擎·Solr简介及安装(第2期)

1.1 Solr 简介 1.1.1 Solr 的特性 1.1.2 Solr 的目录结构 1.1.3 Solr 与Lucene 关系 1.2 Solr 安装 1.2.1 环境介绍 1.2.2 安装Solr 1.2.3 结合Nutch

[Nutch]Nutch+Eclipse+Tomcat+Solr+Cygwin搭建Windows开发环境

1、环境准备1.1 软件操作系统:Windows 10专业版 ANT版本:apache-ant-1.9.7-bin.zip JDK版本:jdk-8u65-windows-x64.exe Solr版本:solr-4.9.1.zip Nutch版本:apache-nutch-1.6-bin.tar.gz Tomcat版本:apache-tomcat-9.0.0.M8-windows-x64.z

Kandy 4334

nutchsolr建立搜索引擎基础(单机版)

nutchsolr建立搜索引擎基础(单机版) Nutch[1] 是一个开源Java实现的搜索引擎,它提供了我们运行自己的搜索引擎所需的全部工具,包括全文搜索和Web爬虫。 Solr[2]是一个基于Lucene的全文搜索服务器,它对外提供类似于Web-service的API查询接口,是一款非常优秀的全文搜索引擎。 为什么要整合nutchsolr? 简单地讲,nutch重在提供数据源采集(Web爬...

weixin_30734435的博客 476

Nutch-2.2.1学习之七NutchSolr的集成

sdfdg

skyWalker_ONLY 1万+

Apache nutch1.5 & Apache solr3.6

第1章引言 1.1nutchsolr Nutch 是一个开源的、Java 实现的搜索引擎。它提供了我们运行自己的搜索引擎所需的全部工具。 Solr 拥有像 web-services API 的独立的企业级搜索服务器。用 XML 通过 HTTP 向它添加文档(称为做索引),通过 HTTP 查询返回 XML 结果。 1.2研究nutch 的原因 可能有的朋友会有疑问,我们有g...

368

nutchsolr安装

vmware7+ubuntu12.04 1,下载文件nutch1.5http://mirror.bjtu.edu.cn/apache/nutch/1.5/                   solr3.6:http://mirror.bjtu.edu.cn/apache/lucene/solr/3.6.0/ 2,解压,bin/nutch需要添加可执行权限,执行后显示 Usage: nutc...

非RD非PM 253

NutchSolr的集成方案

<br /><br />本方案中,Solr作为处理搜索结果的源和入口,有效的减轻对Nutch的搜索负担,让Nutch负责她最擅长的工作:抓取(crawling)和提取(extracting)内容。使用Solr作为搜索后端,换句话说,就是允许使用所有Solr Server的高级特性,诸如:查询拼写检查(spell-check),搜索提醒(suggestion),数据复制(data-replication),查询缓存等等。<br /> <br />NutchSolr的安装<br /> <br />首先下载我们

dongpf的专栏 8804

Nutch+Solr学习笔记

最近学习搜索引擎,以下为整理学习笔记:

aixiaoxue520的专栏 1355

Nutch环境搭建+Solr的使用

想学习java语言下的搜索引擎,那就必须从Apa

以梦为马——书到今生读已迟 919

nutch的结果用solr搜索显示出来

通过前两天对nutchsolr,tomcat的搭建,三个都出乎意料的跑起来了,虽然中间都有失败,但是问题都解决了,剩下的问题就是要将爬行的结果用搜索引擎显示出来,这里有两个方法来搜索,第一个就是用nutch1.2自带的nutch1.2.war做webapp,另外一个方法就是用solr3.6做webapp,下面就分两种方法分别来搜索。 第一种方法:          首先用nu

devil27的专栏 1419

nutchsolr配置学习

NutchSolr是两个由Apache成员创建的实用工具,你可以使用Nutch抓取网页,使用Solr索引你得到的数据。 除了索引各类网站,这些工具还有很多其他功能,本文将不涉及这些,而是一篇针对如何使用Nutch抓取网页并使用Solr索引并搜索你抓取的数据的新手指南。 本文将不会讨论它们如何工作的大量细节,而会告诉你如何运行一个爬虫和建立索引,我将假设你已经搭建好了tomcat服

WitsMakeMen的专栏 2491

使用NutchSolr抓取并索引网页

NutchSolr是两个由Apache成员创建的实用工具,你可以使用Nutch抓取网页,使用Solr索引你得到的数据。 除了索引各类网站,这些工具还有很多其他功能,本文将不涉及这些,而是一篇针对如何使用Nutch抓取网页并使用Solr索引并搜索你抓取的数据的新手指南。 本文将不会讨论它们如何工作的大量细节,而会告诉你如何运行一个爬虫和建立索引,我将假设你已经搭建好了tomca

missingu1314的专栏 815

Luence Solr Nutch说明

Luence Solr Nutch说明                                             版本修订   版本 说明 作者 日期 0.1 初始版本 RockeyHoo 2013/09/06

RockeyHoo的专栏 1289

mysql nutch,搜索引擎环境搭建nutch2.2.1+solr4.2+mysql5.7(附PHP solr拓展安装)

如果jdk和ant已经搭建好可以跳过前面相应步骤。安装配置JDK2.解压tar包到 /usr/local/java下# mkdir /usr/local/java# tar -zxvf jdk-8xxx-linux-xxx.tar.gz /usr/local/java/3.进入/usr/local/java目录找到jdk安装脚本# ./jdk-8xxx-linux-xxx.bin4.配置jdk环境...

weixin_34862561的博客 207

Hadoop上部署nutchnutch相关

nutch启动入口,bin/crawl  调用 bin/nutchnutch系列学习笔记,详细解读nutch每个tool:http://blog.csdn.net/gobitan/article/category/284793

谷雨 2296

nutch mysql solr_Nutch2.1+mysql+solr3.6.1+中文网站抓取

1、mysql 数据库配置 linux mysql安装步骤省略。 创建数据库与表 [sql] view plaincopyprint? CREATE DATABASE nutch DEFAULT CHARACTER SET utf8 DEFAULT COLLATE utf8_general_ci; CREATE TABLE `webpage`( `id` varchar (767) CHARACT...

weixin_33773670的博客 195

Lucene、NutchSolr

首先,说一下三者之间的关系。     lucene是一个做搜索用的类库。      nutchsolr都是基于lucene的,二者都是可直接运行的应用程序。         solr是lucene的服务器化,内嵌了jetty,提供REST接口,  用户可以直接post数据给solr,然后由solr进行索引。  solr不包含下载系统,用户需要负责下载,转成solr所需要的格式。 

xiaoyu714543065的专栏 6334

集成NutchSolr

两年前集成NutchSolr这两个Apache Lucene项目组下的子项目实在是件困难的事情,需要打很多补丁(patches),为他们的联姻搜寻各种必需的组件(required components)。今非昔比,时下,在Solr4.0也即将浮出水面的时候,两者的结合变的相对容易。今年早些时候发布的Nutch1.0包含了"开盒即用"的原装的(out of the

风信子的专栏 8142
上一篇: Hadoop Error Log
下一篇: nutch on hadoop 遇到 ls: 无法访问data/segments: 没有那个文件或目录
kradnangel
博客等级 码龄14年 2粉丝 31原创
评论 3
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

红包个数最小为10个

红包金额最低5元

当前余额3.43前往充值 >
需支付:10.00
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值


