


Ollama部署
ollama是一个开源工具(
ollama.ai),允许用户在 本地设备(无需联网)运行 LLM。终端用户通过ollama低成本体验大模型能力
支持模型:
- llama2(7B/13B/70B 参数)
- mistral(7B 高效模型)
- codellama(代码生成专用)
- phi(微软轻量模型)
典型使用场景:
- 离线环境使用 LLM
- 数据敏感场景(避免云端传输)
- 开发者快速测试模型
Github下载
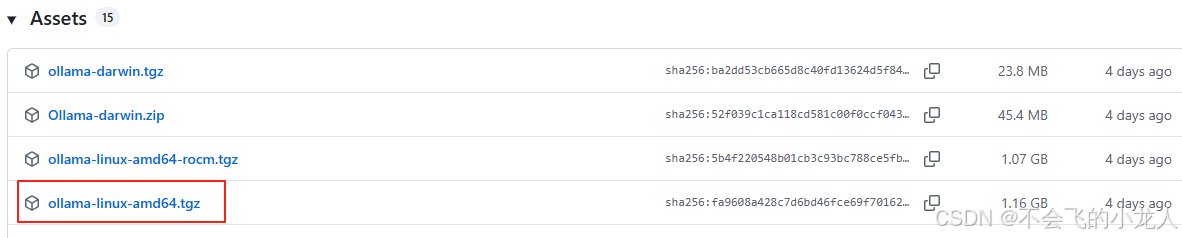
根据所需环境下载,本文在linux下采用二进制文件直接部署,因此下载ollama-linux-amd64.tgz版本,解压后直接可运行;
# 官方提供的安装脚本 # curl -fsSL https://ollama.com/install.sh | sh #下载后解压 tar -zxvf ollama-linux-amd64.tgz #移动并重命名 mv ollama-linux-amd64 ollama
启动Ollama服务
进入ollama本地bin目录下,通过命令ollama serve启动服务后。
设置ollama服务api其它主机可访问,默认为localhost只能本机访问api,设置OLLAMA_HOST环境变量:export OLLAMA_HOST=0.0.0.0,此为临时性环境变量配置(生产使用需配置到系统文件中)
执行结果
[root@centos72 bin]# export OLLAMA_HOST=0.0.0.0
[root@centos72 bin]# ./ollama serve
time=2025-08-25T20:11:28.551+08:00 level=INFO source=routes.go:1318 msg="server config" env="map[CUDA_VISIBLE_DEVICES: GPU_DEVICE_ORDINAL: HIP_VISIBLE_DEVICES: HSA_OVERRIDE_GFX_VERSION: HTTPS_PROXY: HTTP_PROXY: NO_PROXY: OLLAMA_CONTEXT_LENGTH:4096 OLLAMA_DEBUG:INFO OLLAMA_FLASH_ATTENTION:false OLLAMA_GPU_OVERHEAD:0 OLLAMA_HOST:http://0.0.0.0:11434 OLLAMA_INTEL_GPU:false OLLAMA_KEEP_ALIVE:5m0s OLLAMA_KV_CACHE_TYPE: OLLAMA_LLM_LIBRARY: OLLAMA_LOAD_TIMEOUT:5m0s OLLAMA_MAX_LOADED_MODELS:0 OLLAMA_MAX_QUEUE:512 OLLAMA_MODELS:/root/.ollama/models OLLAMA_MULTIUSER_CACHE:false OLLAMA_NEW_ENGINE:false OLLAMA_NEW_ESTIMATES:false OLLAMA_NOHISTORY:false OLLAMA_NOPRUNE:false OLLAMA_NUM_PARALLEL:1 OLLAMA_ORIGINS:[http://localhost https://localhost http://localhost:* https://localhost:* http://127.0.0.1 https://127.0.0.1 http://127.0.0.1:* https://127.0.0.1:* http://0.0.0.0 https://0.0.0.0 http://0.0.0.0:* https://0.0.0.0:* app://



 扫一扫


 345

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


