Spark集群Job,Task 的具体运行原理

AI权益加码!Claude Code、Cursor等20+工具免费用! 购周边限时加赠Coding Plan Lite,畅享主流AI工具!学习进阶更高效! 阅读详情

一:Spark集群部署
二:Job提交解密
三:Job生成和接受
四:Task的运行
五:再论shuffle

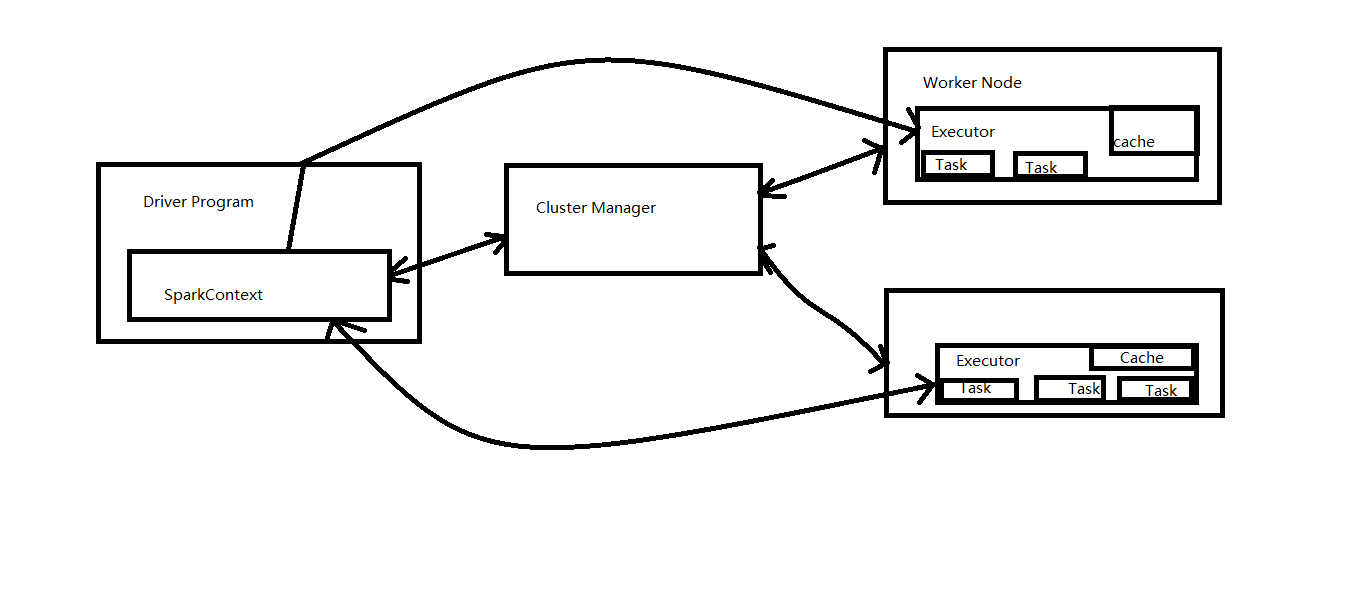
1,从spark Runtime 的角度讲来讲有5大核心对象:Master , Worker , Executor ,Driver , CoarseGrainedExecutorbacked ;

2,Spark 在做分布式集群系统的设计的时候,最大化功能的独立,模块化封装具体的独立的对象,强内聚低耦合   (耦合性也称块间联系,指软件系统结构中各模块间相互联系紧密程度的一种度量。模块之间联系越紧密,其耦合性就越强,模块的独立性则越差。模块间耦合高低取决于模块间接口的复杂性、调用的方式及传递的信息。内聚性又称块内联系。指模块的功能强度的度量,即一个模块内部各个元素彼此结合的紧密程度的度量。若一个模块内各元素(语名之间、程序段之间)联系的越紧密,则它的内聚性就越高。)
这里写图片描述

3,当Driver中的sparkContext 初始化的时候会提交程序给Master,Master如果接受该程序在spark中运行的话,就会为当前程序分配AppID ,同时分配计算资源,需要特备注意的是: Master是根据当前程序的配置信息来给集群中的Worker发指令来分配具体的计算资源。但是,Master发指令后并不关心具体的计算资源是否已经分配,转过来说,Master发出指令后就记录了分配的资源,以后客户端再次提交其他程序的话就不能使用该资源啦,其弊端是可能会导致其他要提交的程序无法分配到本来应该可以分配到的计算资源。最终优势在spark分布式系统功能弱耦合的基础上最快的运行系统(否则如果Master要等到计算资源最终分配成功后才通知Driver的话,会造成Driver的阻塞,不能够最大化的并行计算资源的利用率)  (低耦合 : 不关心指令发送成功还是失败)  (快是对Driver 而言)

补充说明的是: Spark默认程序是排队的,Spark默认的情况下由于集群中一般都只有一

Spark_Spark中 Stage, Job 划分依据 , Job, Stage, Task 高阶知识 Task内部有一个成员变量:preferredLocations表明了这个Task的位置偏好,这个变量的值是根据Task的数据的位置得到的,可以是一个hostName或者execotorId。例如,如果Task的数据是在192.168.5.101和192.168.5.102这两台机器上,那么:forExecutor是一个HashMap,key为executorId,value是preferredLocations为这个executor的所有tasktaskId。 阅读详情

相关推荐

Spark系列1】DAG中Stage和Task的划分全流程

上面已经介绍,在一个Stage中,RDD的依赖关系是窄依赖,所以最后一个RDD的分区数量取决于其依赖的RDD的分区数量,一直依赖到该阶段的开始的RDD的分区。

qq_33592535的博客 3154

Spark运作流程以及入门概念(taskjob、stage、application)

spark基础概念以及易混淆概念辨别、spark简单工作模式

m0_63290947的博客 795

Spark原理篇之工作原理

1 Spark背景       Spark是一个加州大学伯克利分校(UC Berkeley AMP)开发的一个分布式数据快速分析项目。它的核心技术是弹性分布式数据集(Resilient distributed datasets),提供了比Hadoop更加丰富的MapReduce模型,可以快速在内存中对数据集进行多次迭代,来支持复杂的数据挖...

huahuaxiaoshao的博客 5831

理解spark中的job、stage、task

什么是SparkSpark是处理大数据常用的计算引擎。Spark是一个用来实现快速而通用的集群计算的平台。扩展了广泛使用的MapReduce计算模型,而且高效地支持更多的计算模式,包括交互式查询和流处理。和MapReduce相比,spark支持内存计算,一般比MapReduce更高效。 一般我们在提交spark任务的时候,都会去其UI界面查看任务运行状况。其中就有job、stage、task的一些执行进度展示。今天,就详细说明一下这些名词术语的含义。 Job spark中的数据都是抽象为RDD的,它支持

学亮编程手记 2204

Sparkjob、stage、task的划分+源码执行过程分析

job、stage、task  Worker Node:物理节点,上面执行executor进程 Executor:Worker Node为某应用启动的一个进程,执行多个taskJobs:action 的触发会生成一个job, Job会提交给DAGScheduler,分解成Stage, Stage:DAGScheduler 根据shuffle将job划分为不同的stage,同一个sta

hjw199089的博客 1万+

sparkjob,stage,task之间的关系

转载https://blog.csdn.net/mys_35088/article/details/80864092?utm_medium=distribute.pc_relevant.none-task-blog-BlogCommendFromMachineLearnPai2-2.add_param_isCf&depth_1-utm_source=distribute.pc_relevant.none-task-blog-BlogCommendFromMachineLearnPai2-2.add.

zhuiqiuuuu的博客 3279

Spark运行原理【史上最详细】

Spark应用程序以进程集合为单位在分布式集群运行,通过driver程序的main方法创建的SparkContext对象与集群交互。 1、Spark通过SparkContext向Cluster manager(资源管理器)申请所需执行的资源(cpu、内存等) 2、Cluster manager分配应用程序执行需要的资源,在Worker节点上创建Executor 3、SparkContext...

Spark技术咖的博客 3万+

死磕spark中的job、stage、task

写在前面 台风夜的电话面试里被问到了spark运行任务的过程中stage的划分依据。一下子就给整懵了,支支吾吾答非所问。从事大数据的开发也有一年半光景,spark任务的运行原理依旧知之甚少。因此就参阅各种优秀的文章,再配上一个自己工作中的实际项目,特意整理出这篇笔记,以此警示自己的自大与无知。 测试环境 本地开发环境 idea 2019.1.2 maven 3.6 spark 2.4.3 sca...

wolf_333的博客 1725

2.3 Spark运行架构与原理

Spark运行架构主要由SparkContext、Cluster Manager和Worker组成,其中Cluster Manager负责整个集群的统一资源管理,Worker节点中的Executor是应用执行的主要进程,内部含有多个Task线程以及内存空间,通过下图深入了解Spark运行基本流程。Executor创建后,会向Cluster Manager进行资源及状态的反馈,便于Cluster Manager对Executor进行状态监控,如果监控到Executor失败,则会立刻重新创建。

qq_62590351的博客 1310

Spark大数据 Spark运行架构与原理

Spark大数据的运行架构与原理可以概括为以下几个方面:一、运行架构二、核心原理Spark的核心原理是将数据分散到多台计算机上并在这些计算机上并行执行计算任务,从而实现高效的数据处理和分析。

IT深耕十余载,大道之简 1970

Spark 架构原理介绍 以及 jobtask、stag 概念

Spark运行模式 一:Spark 运行架构介绍   相关术语概念详解:     Application:指的是用户编写的Spark应用程序,包含了一个Driver功能的代码和分布在集群中多节点上运行的Executor代码。     Driver:Spark中的Driver就是运行Application的main()函数,并且创建SparkContext。SparkContext为Spar...

weixin_33858249的博客 103

Spark-Job启动、Stage划分

1、线性解析程序中的代码,遇到Action算子调用SparkContext的runJob(),有几个Action算子就会产生几个Job2、转交给DAGScheduler提交Job3、DAGScheduler先为调用Action算子的RDD创建一个ResultStage。

lu070828的博客 1545

Spark源码分析之五:Task调度(一)

在前四篇博文中,我们分析了Job提交运行总流程的第一阶段Stage划分与提交,它又被细化为三个分阶段:         1、Job的调度模型与运行反馈;         2、Stage划分;         3、Stage提交:对应TaskSet的生成。         Stage划分与提交阶段主要是由DAGScheduler完成的,而DAGScheduler负责Job的逻辑调度,主要职责

辰辰爸的博客 5489

Spark 核心原理

文章目录1. Spark核心原理2. 消息通信原理2.1. Spark运行时消息通信 1. Spark核心原理 Application(应用程序):是指用户编写的spark应用程序,包含驱动程序(driver)和分布在集群中多个节点上运行的Executor代码,在执行过程中有一个或多个作业组成。 Driver(驱动程序):Spark中的Driver,即运行上述Application的main函数并且创建SparkContext,其中创建SparkContext的目的是为了准备Spark应用程序的运

初阳 2452

Spark运行原理

Spark运行原理 名词介绍 Worker节点 ecluter节点 Driver节点

qq_34082921的博客 1386

spark运行基本流程

一、基本流程 1.构建Spark Application的运行环境(启动SparkContext),SparkContext向资源管理器(可以是Standalone、Mesos或YARN)注册并申请运行Executor资源; 2.资源管理器分配Executor资源并启动StandaloneExecutorBackend,Executor运行情况将随着心跳发送到资源管理器上; 3.SparkCont...

qq_21705851的博客 4914

Spark Master\Worker、Driver\Executor、Job\Stage\Task等概念与关系

@Author : Spinach | GHB @Link : http://blog.csdn.net/bocai8058 文章目录前言 前言 https://blog.csdn.net/hongmofang10/article/details/84587262 https://blog.csdn.net/mys_35088/article/details/80864092?utm_medium=distribute.pc_relevant.none-task-blog-2%7Edefau

GSpinach的博客 2107

Spark 基本架构及运行原理

Spark运行架构包括集群资源管理器(Cluster Manager)、运行作业任务的工作节点(Worker Node)、每个应用的任务控制节点(Driver)和每个工作节点上负责具体任务的执行进程(Executor)。其中,集群资源管理器可以是Spark自带的资源管理器,也可以是YARN或Mesos等资源管理框架。 与Hadoop MapReduce计算框架相比,Spark所采用的Executor有两个优点:一是利用多线程来执行具体的任务(Hadoop MapReduce采用的是进程模型),减少任务的启动

5万+
下一篇: Task Sheduler 内部工作原理以及源码解密
二府村
博客等级 码龄12年 55粉丝 50原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

红包个数最小为10个

红包金额最低5元

当前余额3.43前往充值 >
需支付:10.00
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值