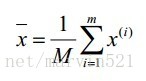机器学习理论与实战(十六)概率图模型04

限时加码!20+主流AI编程工具免费用 购周边加赠Coding Plan Lite,Claude Code、Cursor等即刻畅享,学习进阶更高效! 阅读详情

        04、概率图模型应用实例

        最近一篇文章《Deformable Model Fitting by Regularized Landmark Mean-Shift》中的人脸点检测算法在速度和精度折中上达到了一个相对不错的水平,这篇技术报告就来阐述下这个算法的工作原理以及相关的铺垫算法。再说这篇文章之前,先说下传统的基于CLM(Constrained local model)人脸点检测算法的不足之处,ASM也属于CLM的一种,CLM顾名思义就是有约束的局部模型,它通过初始化平均脸的位置,然后让每个平均脸上的特征点在其邻域位置上进行搜索匹配来完成人脸点检测。整个过程分两个阶段:模型构建阶段和点拟合阶段。模型构建阶段又可以细分两个不同模型的构建:形状模型构建和Patch模型构建,如(图一)所示。形状模型构建就是对人脸模型形状进行建模,说白了就是一个ASM的点分布函数(PDM),它描述了形状变化遵循的准则。而Patch模型则是对每个特征点周围邻域进行建模,也就说建立一个特征点匹配准则,怎么判断特征点是最佳匹配。
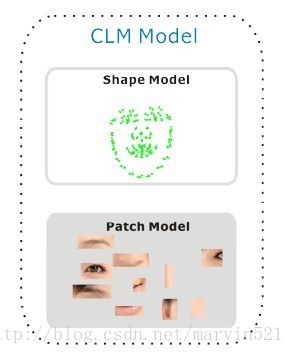

(图一) CLM模型:形状模型和Patch模型


      下面就来详细说下CLM算法流程:

      一、模型构建之形状模型构建(延续ASM的形状模型函数),如(公式一)所示:
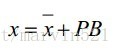
(公式一)


        (公式一)中X-bar表示平均脸,P是形状变化的主成分组成的矩阵,它是一个关键的参数,下面就来看看它是如何得到的。假设我们有M张图片,每张图片有N个特征点,      每个特征点的坐标假设为(xi,yi),一张图像上的N个特征点的坐标组成的向量用表示,所有图像的平均脸可用(公式二)求出:
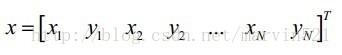
(公式二)

        然后每张脸组成的向量都减去这个平均脸向量,就得到一个均值为0的形状变化矩阵X,如下表示:
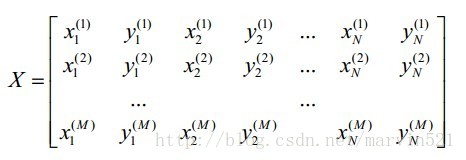
        一定要注意X此时是一个零均值的形状变化矩阵,因为每个行向量都减去了平均脸向量,也就是相对于平均脸的偏差,对XX’进行主成分分析,得到形状变化的决定性成分,即特征向量Pj以及相对应的特征值λj,选择前K个特征向量以列排放的方式组成形状变化矩阵P,这些特征向量其实就是所有样本变换的基,可以表述样本中的任意变化。有了形状变化矩阵P,(公式一)中的B就可以通过(公式三)得出:
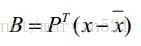
(公式三)

       (公式三)中求出的B其实是形状变化的权重向量,决定哪些特征点起着关键作用。到这里就完成模型构建,当给定一个权重B时,我们就可以用(公式一)重建出一个形状,这个权重B在以后点拟合阶段起着关键作用。


二、模型构建之Patch模型构建


       在构建好形状模型之后,我们就可以在检测到的人脸上初始化一个人脸形状模型,接下来的工作就是让每个点在其邻域范围内寻找最佳匹配点。传统的ASM模型就是沿着边缘的方向进行块匹配,点匹配等各种低级匹配,匹配高错误率导致ASM的性能不是很好。后续各种改进版本也就出来了,大部分做法都是对候选匹配特征点邻域内的块进行建模,我们统称他们为有约束的局部模型:CLM。这里先以基于SVM的匹配作为例子来说,因为这些都是铺垫知识,引出改进的算法。当我们初始化每个特征点后,用训练好的SVM对每个特征点周围进行打分,就像滤波器一样,得到一个打分响应图(response map),标识为R(X,Y),如(图二)所示:
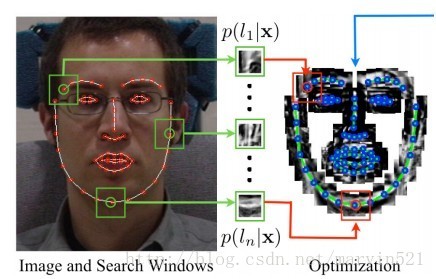
(图二)  特征点(左)其邻域响应图(右)

          接下来就是对响应图拟合一个二次函数,假设R(X,Y)是在邻域范围内(x0,y0)处得到最大值,我们对这个位置拟合一个函数,使得位置和最大值R(X,Y)一一对应。拟合函数如(公式四)所示:

(公式四) 拟合最大响应位置二次函数

      (公式四)中的a,b,c是我们要求的拟合二次函数的参数,求解方法就是使拟合函数r(x,y)和R(X,Y)之间的误差最小,即完成一个最小二乘法计算,如(公式五)所示:
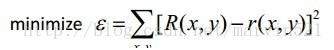
(公式五) 求取(公式四)的最小二乘法

        通过(公式五)完成最小二乘法运算后得到(公式四)的参数a,b,c,有了参数a,b,c,那么r(x,y)其实就是一个关于特征点位置的目标代价函数,然后再加上一个形变约束代价函数就构成了特征点查找的目标函数,每次优化这个目标函数得到一个新的特征点位置,然后在迭代更新,直到收敛到最大值,就完成了人脸点拟合。目标函数如(公式六)所示:

(公式六) 目标函数

       在(公式六)的目标函数中第二项就是形状约束,b是上面说的形变成分的权重,而lambda则是形变成分(主成分分析中的空间轴)对应的幅度(主成分分析的特征值)。对于整个目标函数,你可以这样理解,第一项是拟合位置作为新特征点位置的代价,而这个位置的代价再减去平均形状的变化,这样就形成了位置和形状两种约束的制约,如果一个在一个歧义的位置得到的r(x,y)分很高,但是离平均脸很远,那么f(x)值也会很小,那就不是最优值。我们比较关心的是目标函数中的两项约束是否是一一对应,等比例增长的。这点不用担心,如果把(公式六)展开用矩阵的形式写出来的话,可以变成(公式七)的样子:

(公式七) 目标函数展开

其中
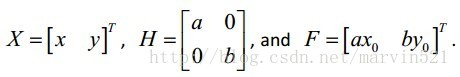
        可以看出(公式七)是个关于特征点位置X的二次凸函数,有全局最优解。每次求出最优解,然后再计算邻域响应图,在求解直到收敛时就完成了特征点的拟合查找工作。


        这个算法理论还是可以,但有几点不足:第一、从SVM里得到的响应图是否真实可靠?这点其实也正是要改进的地方。第二、每次迭代都要优化一个二次函数计算量也蛮大,这会拖慢速度,无法实时。第三、形变约束是否有争议,能否让你信服?而且形状模型根本没考虑到现实情况中的缩放,旋转和平移。


         带着这三个问题,我们进入文章一开头就提到的那篇文章的算法,我们简称它为DMF_ MeanShift, DMF_MeanShift使用的点分布模型(形状模型)如(公式八)所示:


(公式八)点分布模型

       (公式八)中的要求参数为 ,分别表示缩放,旋转,平移,主成分权重。而x-bar和fai则表示平均脸和形变主成分矩阵,和CLM中的一样。现在我们的目标仍然是优化一个有形变约束和匹配代价约束组成的目标函数,如(公式九)所示:
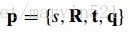
(公式九)

         这里要注意一下,R(P)表示形变约束,对应CLM(公式六)中的第二项,D表示匹配代价,对应CLM(公式六)中的第一项。这两项在DMF_MeanShift中都要发生变化,不再使用CLM中的约束规则,而使用概率分布的形式来表述,全部在概率图模型的框架中完成推理求解,下面来看看是如何把(公式九)中的两项约束转换成概率约束的。

        对于(公式九)中的求取形状模型参数的目标函数,在概率模型中可以描述成一个当所有特征点都匹配最优时模型参数的最大似然。意思就是说在训练样本中,给定所有样本点匹配最优时的最大似然估计。当给定图像块时,每个检测器之间是相互独立的(这个条件独立有争议,我现在还没有彻底推倒出来),那么这个似然函数可以写成(公式十)的形式:

(公式十)

        在(公式十)中,左边表示给定匹配点和图像块时,参数的似然函数,右边则是条件独立分解。其中 表示该特征点i是否是最优匹配点,1表示是,-1表示否。两边同时取自然对数后,乘法变加法,得到(公式十一):
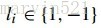
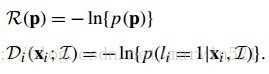
(公式十一)

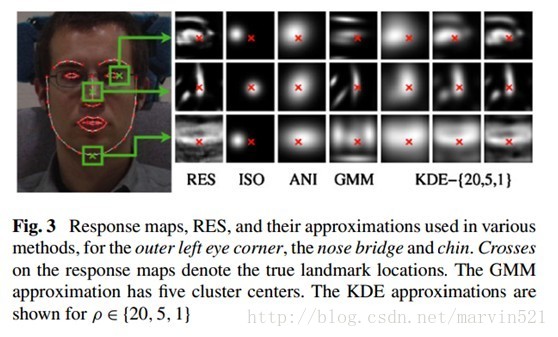
       (公式十一)中的两项就和CLM中的两项约束对应上了,而且转换到了概率空间,接下来的步骤就是对这两项的分布进行近似估计。估计的方法很多,而且很复杂,这里为了方便理解,先贴出几个估计方法的对比效果图,如(图三)所示:
(图三)

        在(图三)中RES表示真实响应图,而ISO,ANI,GMM和KDE分别表示各向同性高斯估计、各向异性高斯估计、混合高斯估计和核密度估计,从(图三)中可以看出基于核密度估计得逼近分布和真实响应图最接近。由于前三个近似逼近方法效果不好,而且推导过程复杂,这里就不再说了,只简单说下效果最好的KDE逼近方法。

由于在(公式一)中的形变矩阵P扔掉了一些很小的成分,因此重建的形状点并不是百分百正确,有一定的误差,我们可以这个误差看成观察噪声,它服从同方差各向同性高斯分布,如(公式十二)所示:

(公式十二)

         其中ρ表示噪声的协方差,可以通过(公式十三)求出(Moghaddam and Pentland1997):
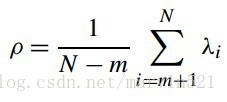
(公式十三)

        其实就是主成分分析中特征值的算术平均,通过(公式十二)我们也可以得到给定Xi时yi的条件概率,如(公式十四)所示:
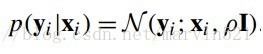
(公式十四)

      (公式十四)的推倒是通过混合高斯分布推倒出来的,这里也不再推倒。假设特征点候选区域为 ,把真实特征点的位置看成隐变量y,那么特征点匹配的似然函数可以通过积分掉隐变量y得到,如(公式十五)所示:
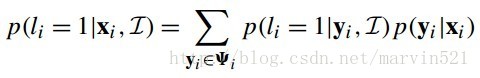
(公式十五)

        综合(公式十四)和(公式十五),我们得到一个非参形式的响应图近似估计,如(公式十六)所示:
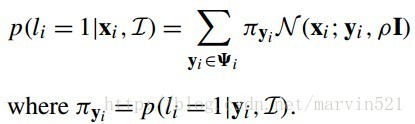
(公式十六)

        把(公式十六)这个匹配代价约束带入(公式十)中,我们得到最一个关于参数P的似然概率分布函数,如(公式十七)所示:
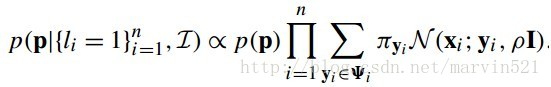
(公式十七)

         只要求解此最大似然函数就可以求出参数P,也就是求取使得关于参数P的边缘概率最大时对应的参数P,这是一个无向图模型,如果你不能抽象出图模型,可以参看(图四)所示:
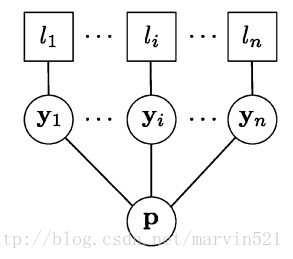
(图四)

       (图四)中Li表示观察,y表示隐藏变量,P表示参数。这个关于P的边缘概率可以通过概率图模型的中的BP算法求解,有兴趣的可以翻看参考文献[6]的Appendix。这里采用另外一种求解方法:EM算法。因为真实位置标签y我们不知道,是个隐变量,而且参数P也不知道,很自然的就想到了EM算法。EM算法的推倒也比较复杂,这里就直接贴图了,反正最后的结论才是我们想要的,如(图五)所示。
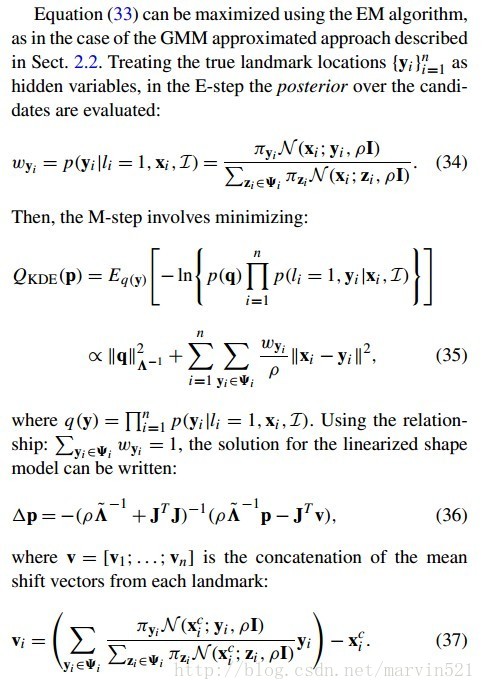
(图五)


      (图五)中的等式(33)对应本文的(公式十七)。最后得到的等式(36)就是我们想要的梯度,有了梯度就可以更新参数P,而且也可以通过(公式十八)来更新候选特征点匹配的位置:

(公式十八)

       (公式十八)的得出是在参考文献[6]的各向同性高斯逼近方法中推倒出来的,用的是泰勒展开方法,这里的推倒在后续有时间再补充。这样通过更新特征点匹配位置,有了新位置然后计算deltaP,然后更新参数P,重复上述过程直到参数P收敛为止,就完成了特征点匹配检测。整个过程有点像Mean-Shift算法,所以算法名中出现Mean-Shift。这个算法的好处就是融合进了各种形变参数,并且使得参数可以迭代更新,更新速度也挺快。

         本篇文章只能算是介绍下概率图图模型的一个应用,了解人脸特征点检测详细原理需要阅读参考文献[6],欢迎提供关于各向同性高斯估计、各向异性高斯估计、混合高斯估计和核密度估计的相关资料和讨论


转载请注明来源:http://blog.csdn.net/marvin521/article/details/11489453


参考文献:

[1] Gaussian mean-shift is an EM algo-rithm.Carreira-Perpinan, M. (2007)

[2] On the number of modes of a Gaussianmixture. Carreira-Perpinan, M., & Williams, C. (2003)

[3] Active shape models—‘smart snakes’.Cootes, T., & Taylor, C. (1992)

[4] Constrained Local Model for FaceAlignment. Xiaoguang Yan(2011)

[5] Face Alignment through SubspaceConstrained Mean-Shifts. Jason M. Saragih(2009)

[6] Deformable Model Fitting by RegularizedLandmark Mean-Shift. Jason M. Saragih(2011)

[7] Support vector tracking. Avidan, S.(2004)



概率图模型&概率模型 及其应用 概率图模型 有向 vs 无向 概率图模型用图刻画一组随机变量之间的相关关系. 有向(无环)图刻画的概率图模型称作 bayesian network, 无向图刻画的概率图模型称作 markov network. 有向图模型和无向图模型直观的区别在于“因果性”, 本质的区别在于两种模型建模了不同的独立关系.例如,从 independence map 的角度: 有向图模型无法表示无向环形关系, 无向图模型无法表示有向 V 形结构. 无向图模型 Pr⁡(s)=1Z∏CϕC(sC) \Pr(s) = \frac{1} 阅读详情

相关推荐

Supervised Descent Method 简单实现

前些天看了Supervised Descent Method and Its Applications to Face Alignment这篇文章,非常喜欢。这篇文章提出了一种基于机器学习来解决复杂最小二乘问题(least squares problem)的方法(简称SDM方法)。该方法思路很简洁,从训练数据中学习梯度下降的方向并建立相应的回归模型,然后利用得到的模型来进行梯度方向估计。 牛

无穷维动量空间 4600

Facial Landmark Detection(人脸特征检测)

dlib :https://github.com/davisking/dlib/tree/v18.18 评价:速度快,可商用,有些时候不太准确 2. CLM-framework: https://github.com/TadasBaltrusaitis/CLM-framework 评价:很准确,不可商用 3. Face Detection, Pose Estim

生如蚁,美如神 6万+

人脸人脸关键检测---ASM、CLM

ASM方法 论文:《Active Shape Models - Their Training and Application》 基于特征分布模型(PDM):人工标定、构建形状模型,搜索匹配 Step1---训练: 构建形状模型 搜索N个训练样本(N=400) 手动标记脸部特征,特征的标注顺序要一致,如右图 将训练集中特征坐标{(x1,y1),(x2,y2),...,...

weixin_41977337的博客 1457

概率图模型

      概率图模型广泛应用于自然语言处理各个领域,也是机器学习里面最难的一部分内容之一,应用包括贝叶斯,HMM,CRF等等,初学者很难理清楚之间的关系。本文算是一个总结吧,有不妥之处,欢迎指正。,下面这个图来自《自然语言处理》教程。                             可以看到贝叶斯网络都是有向的。马尔科夫网无向。贝叶斯适合为有单项依赖的数据建模,马尔科夫网适合实体之间相互...

meihao5的博客 950

[reading notes] Deformable Model Fitting by Regularized Landmark Mean-Shift

https://blog.csdn.net/marvin521/article/details/11489453

u014410989的专栏 542

KDNuggets 博客中文翻译(五十六

原文:www.kdnuggets.com/2022/09/aws-ai-ml-scholarship-program-overview.html着陆页截图启动人工智能、机器学习等职业生涯可能很困难。你通常认为你必须上大学学习计算机科学、统计学或数学。Baby AGI是一个使用OpenAI和PineconeAPI,以及LangChain框架的 Python 脚本,用于创建、组织、优先排序以及执行任务。Baby AGI 的过程是,它将使用基于前一个任务结果的预定义目标创建任务。

龙哥盟 1940

【信息科学工程学】信息科学工程领域 第三篇 信号系统~04 阵列信号AR/VR信号处理

相关函数数学定义物理意义适用场景自相关函数​信号自身在不同时刻的相似性信号周期检测、特征提取互相关函数​两信号在不同时延下的相似性时延估计、信号对齐循环相关​针对循环平稳信号通信信号处理高阶相关​捕捉非高斯、非线性特征非线性系统、高阶统计量分析AR/VR语音信号处理生成是一个快速发展的跨学科领域,涉及信号处理、机器学习、声学、心理学、人机交互等多个方面。全面理解:深入理解用户需求、技术可能性和限制平衡取舍:在音质、延迟、计算资源、功耗、成本间取得平衡迭代优化。

weixin_49199313的博客 830

【信息科学工程学】【审计学】第一篇 招投标领域审计算法02

给定人、事、时、地、物等实体集合V和证据事实集合F, 构建一个概率图模型, 计算任意两个实体/事实之间存在关联关系的概率。:构建一个深度贝叶斯网络, 其中顶层为待推断的心理特征P, 中间层为可观测的行为模式B, 底层为多模态证据E。:基于现场痕迹、行为模式、通讯内容等证据E, 推断嫌疑人的心理特征向量P(如反社会性、冲动性、策划能力)。:对高风险的案件, 自动检索关联当事人、律师涉及的其他历史案件, 形成关联视图。:定义如“当事人-律师-当事人”、“当事人-多案件”等路径, 捕捉隐蔽关联。

weixin_49199313的博客 387

【信息科学工程学】【审计学】第一篇 招投标领域审计算法01

在每个关键流程节(如文件上传、开标唱标、评标结束), 计算该环节所有电子文件的数字指纹(如SHA-256哈希值), 并将指纹和元数据(时间、操作人)上链存证。:从发票、合同中提取材料品名、规格、采购价、时间、地。:对每个供应商, 提取其在历史投标中的行为序列特征, 如:中标率、特定伙伴同时投标率、自身高报价次数、在伙伴中标项目中的“弃标”或“无效标”次数。:监控开标、评标现场音视频, 识别异常情绪(激烈争吵)、敏感关键词(“打”、“关照”)、异常物品传递、私下交流等违规行为。

weixin_49199313的博客 719

【信息科学工程学】计算机科学技术——第七十七篇 系统架构设计02

编号类型模型配方企业资本运作的方法/规则/条件/依据及所有的步骤(​风险处理/异常处理/危机应对关联知识法律法规和裁决依据​​由发起人(通常是知名投资人、投行或产业资本)先设立一个只有现金、无实际业务的特殊目的收购公司(SPAC),通过IPO募集资金并在交易所上市。然后在规定时间内(通常24个月)寻找一家非上市公司进行合并(De-SPAC),使目标公司迅速实现上市,规避传统IPO的复杂流程和不确定性。1.:在开曼或特拉华注册空壳公司,注入少量种子资金。2.

weixin_49199313的博客 222

人脸关键定位CLM框架的使用

CLM框架的使用也就是CLM函数的使用方法,所以下面我的代码是用来进行照片中人脸关键的定位,看完之后对这个流程应该会变得清晰起来。 #include "CLM_core.h" #include #include #include #include using namespace std; using namespace cv; vector get_arguments(int

wi162yyxq的博客 3250

Openface ()论文

OpenFace: an open source facial behavior analysis toolkit 1、Facial landmark detection and tracking:Conditional Local Neural Fields (CLNF) ,a general deformable shape registration approach [Constrained local neural fields for robust facial landmark detectio

weixin_41386168的博客 1810

人脸关键检测face_landmark

不经意间瞄了一眼日历,惊觉2020年已所剩无几,回望即将过去的一年,不禁感叹唏嘘。时光带走了很多的烦恼和美好,也带来了很多困惑和收获。怎样才能不被淹没在时间的洪流里呢,唯有在风浪中保持清醒和方向,而不断地学习和输出就是那支驾驭风浪的桨。 从系统设计一头扎进算法的漩涡,经过了一阵子的蒙圈,然后一摸索着理清思路和方向。在知识爆炸的时代,最好的积累就是把每一步记录下来,变成自己的脚印。 前些天调研了人脸检测算法,这几天在做人脸关键定位和人脸对齐。在网上找了一个开源的人脸对齐项目,本地做了适当适配后验证

牧羊女 1万+

人脸识别之PDM模型-Training Models of Shape from Sets of Examples

   这是我找到的最早关于人脸识别中PDM模型的论文。对该论文翻译并进行了深入的理解。1 分布模型    假设我们希望推导出一个表示印刷电路板上的电阻的模型,就像图1显示的那样。不同的电阻有不同的形状,所以刚性模型将是不适用的。图2显示了一些从各个电阻的背光图像获得的电阻边界的一些示例。我们的目标是使用图2的例子作为训练集建立一个描述典型形状和允许变化的模型。         1.1 标记训练集...

u013263891的博客 1465

推荐开源项目:Cambridge Face Tracker(CLM-framework)

推荐开源项目:Cambridge Face Tracker(CLM-framework) 去发现同类优质开源项目:https://gitcode.com/ 1、项目介绍 Cambridge Face Tracker(CLM-framework)是一个基于Constrained Local Model的面部追踪和地标检测算法框架。虽然该项目已被其下一代工具OpenFace取代,但CLM-framew...

gitblog_00065的博客 352

人工智能之概率图模型详解

例如,在信息传播分析中,我们可以构建一个有向图模型,其中节代表用户,箭头代表信息的传播方向,通过对这个模型进行训练和推断,可以得到一个信息传播模型,用于预测信息的传播路径和传播范围。例如,在文本分类任务中,我们可以构建一个有向图模型,其中节代表词汇,箭头代表词汇之间的条件概率依赖关系,通过对这个模型进行训练和推断,我们可以得到一个文本分类模型,用于对文本进行分类。无向图模型也是一种基于图形化方式表示随机变量间的依赖关系的方法,不同于有向图模型,无向图模型是建立在无向边上的。箭头表示了条件概率依赖关系。

记录 IT 领域经验与见解的博客 1604
上一篇: 使用mean-shift方法、隐马尔科夫模型的恋爱指南
下一篇: 成功应用机器学习的七个步骤
marvin521
博客等级 码龄18年 1163粉丝 41原创
评论 6
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

红包个数最小为10个

红包金额最低5元

当前余额3.43前往充值 >
需支付:10.00
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值