



while循环和until循环
1、当型和直到型循环语法
1.1、while循环语句
while循环语句的基本语法为:
while <条件表达式>
do
    指令...
done
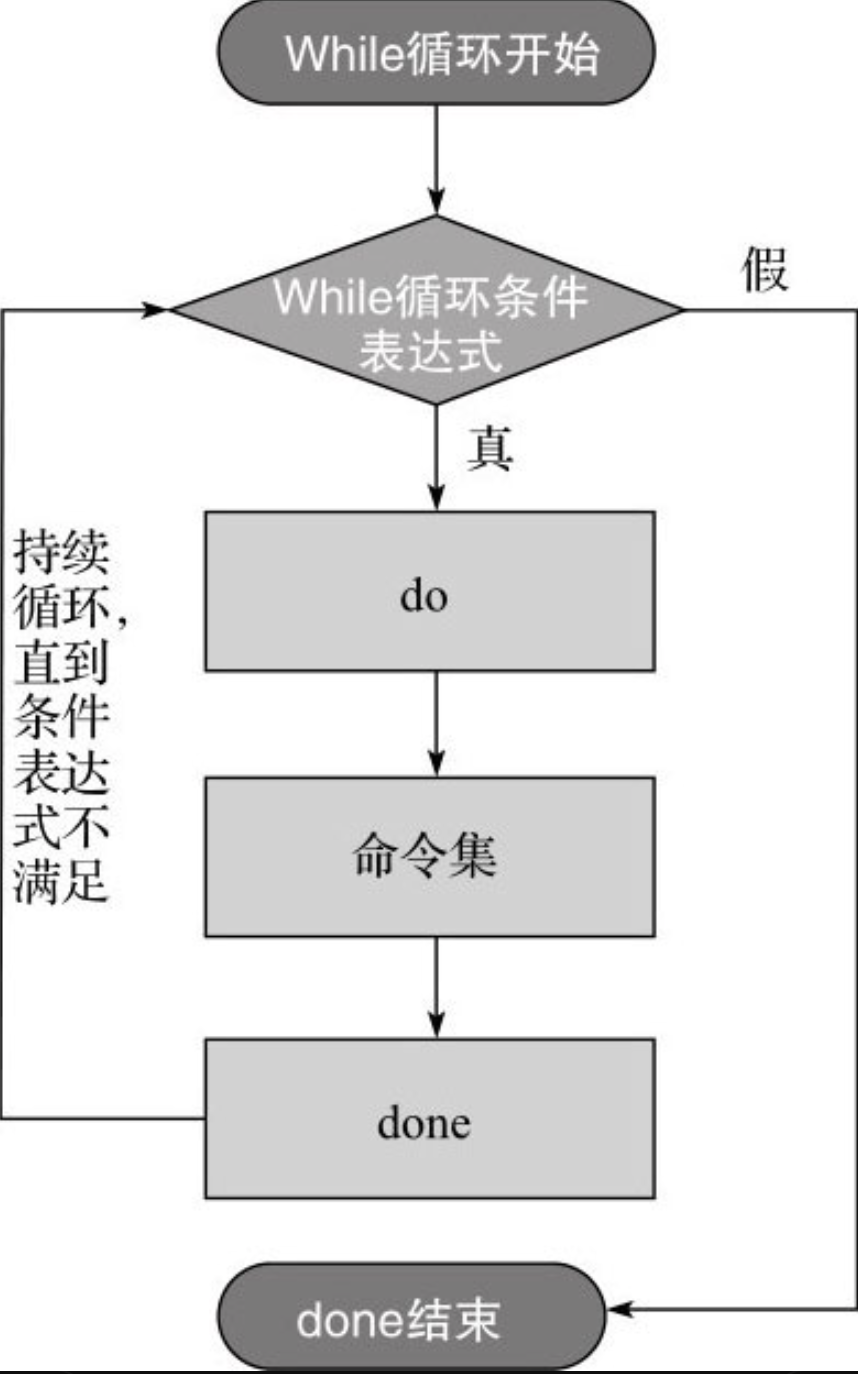
while循环语句会对紧跟在while命令后的条件表达式进行判断,如果该条件表达式成立,则执行while循环体里的命令或语句(即语法中do和done之间的指令),每一次执行到done时就会重新判断while条件表达式是否成立,直到条件表达式不成立时才会跳出while循环体。如果一开始条件表达式就不成立,那么程序就不会进入循环体(即语法中do和done之间的部分)中执行命令了。
while循环执行流程对应的逻辑图如图所示。
1.2、until循环语句
until循环语句的语法为:
until <条件表达式>
do
    指令...
done
until循环语句的用法与while循环语句的用法类似,区别是until会在条件表达式不成立时,进入循环执行指令;条件表达式成立时,终止循环。until的应用场景很罕见,读者了解下即可,本书不会深入探讨此循环语句。
2、当型和直到型循环的基本范例
首先来了解一下Shell中的两个休息命令:sleep 1表示休息1秒,usleep 1000000也表示休息1秒。
范例:每隔2秒输出一次系统负载(负载是系统性能的基础重要指标)情况。
参考答案1:每隔2秒在屏幕上输出一次负载值。
[root@oldboy scripts]# cat 10_1_1.sh
#! /bin/sh
while true         #<==提示:while  true  表示条件永远为真,因此会一直运行,像死循环一样,我们称之为守护进程。
do
    uptime
    sleep 2        #<==休息2秒后继续循环,在while  true循环中最好增加类似sleep的命令,目的是控制循环的频率,否则会消耗大量系统资源,那样就真成了名副其实的死循环了。
done
执行结果如下:
[root@oldboy scripts]# sh 10_1_1.sh
11:04:22 up 14:52,   1 user,   load average: 0.00, 0.00, 0.00
11:04:24 up 14:52,   1 user,   load average: 0.00, 0.00, 0.00
11:04:26 up 14:52,   1 user,   load average: 0.00, 0.00, 0.00
11:04:28 up 14:52,   1 user,   load average: 0.00, 0.00, 0.00
参考答案2:将负载值追加到log里,使用微秒单位。
[root@oldboy scripts]# cat 10_1_2.sh
#! /bin/sh
while [ 1 ]                    #==>这里的条件和上面的写法有区别,注意[]里面两端要有空格,true和1都表示条件永远成立。
do
    uptime >>/tmp/uptime.log  #==>将负载值输入到log文件里,注意,此处最好写绝对路径。
    usleep 2000000              #==>这里的单位是微秒,其实结果也是两秒。
done
通过在脚本的结尾使用&符号来在后台运行脚本:
[root@oldboy scripts]# sh 10_1_2.sh &
[1] 14318
[root@oldboy scripts]# tail -f /tmp/uptime.log     #==>使用tail命令实时观察输出结果。
11:08:35 up 14:57,   1 user,   load average: 0.00, 0.00, 0.00
11:08:37 up 14:57,   1 user,   load average: 0.00, 0.00, 0.00
11:08:39 up 14:57,   1 user,   load average: 0.00, 0.00, 0.00
11:08:41 up 14:57,   1 user,   load average: 0.00, 0.00, 0.00
在实际工作中,一般会通过客户端SSH连接服务器,因此可能就会有在脚本或命令执行期间不能中断的需求,若中断,则会前功尽弃,更要命的是会破坏系统数据。下面是防止脚本执行中断的几个可行方法:
- 使用sh /server/scripts/while_01.sh &命令,即使用&在后台运行脚本。
- 使用nohup /server/scripts/uptime.sh &命令,即使用nohup加&在后台运行脚本。
- 利用screen保持会话,然后再执行命令或脚本,即使用screen保持当前会话状态。
3、让Shell脚本在后台运行的知识
有关脚本运行的相关用法和说明见下表。
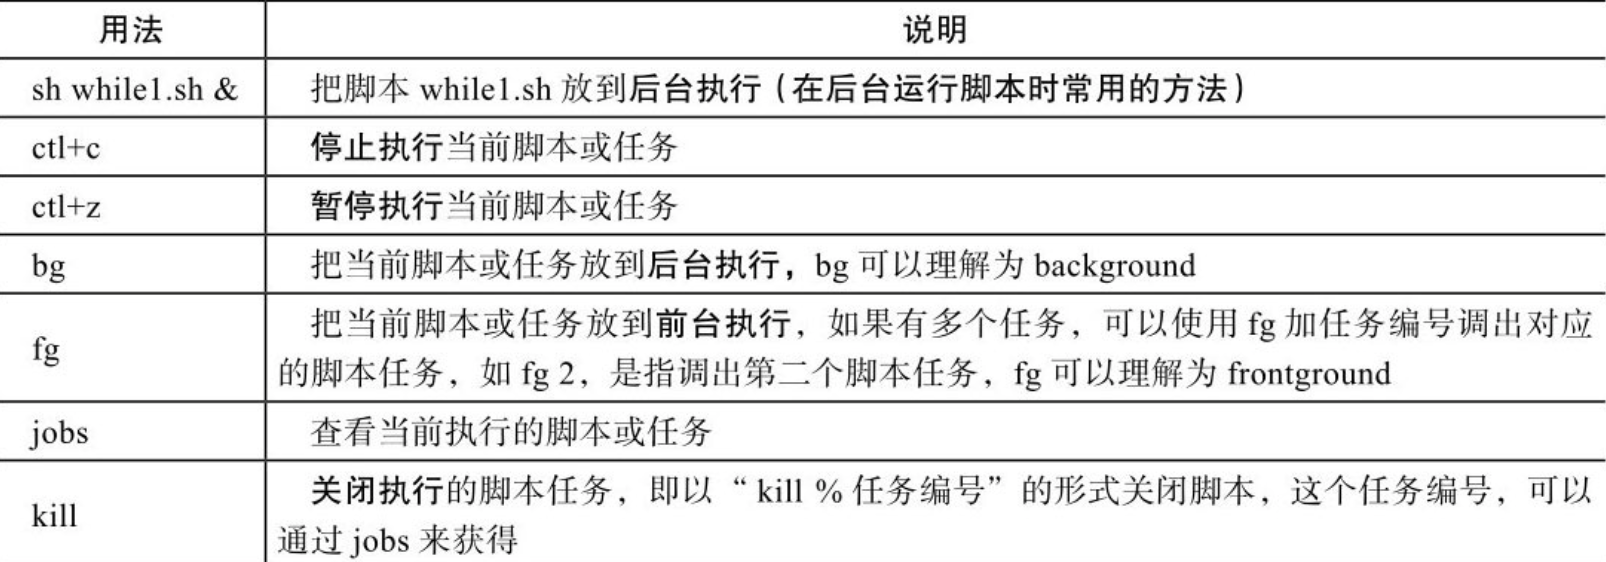
下面针对表中的知识进行实践演示,如下:
[root@oldboy scripts]# sh 10_1_2.sh &   #==>结尾使用&符号表示在后台运行脚本。
[1] 14318
[root@oldboy scripts]# fg             #==>执行fg命令将脚本放到前台执行, 如果有多个脚本任务,则可以使用fg加jobs输出中的任务编号调出对应编号的脚本到前台。
sh 10_1_2.sh
^Z                                    #==>执行Ctrl+z快捷键出现如下结果,临时暂停执行脚本。
[1]+   Stopped                      sh 10_1_2.sh
[root@oldboy scripts]# bg             #==>将当前执行的脚本放到后台运行。
[1]+ sh 10_1_2.sh &
[root@oldboy scripts]# jobs           #==>查看当前Shell下运行的脚本任务。
[1]+   Running                      sh 10_1_2.sh &
[root@oldboy scripts]# fg 1           #==>可以使用fg加jobs输出中的任务编号调出对应编号的脚本到前台来运行。
sh 10_1_2.sh
^C                                    #==>当脚本在前台运行时,可以执行Ctrl+c快捷键停止脚本运行。
[1]+   Stopped                      sh while-1-1.sh
以下是使用kill命令关闭jobs任务脚本的示例。
[root@oldboy ~]# jobs
[1]-   Running                      sh while1.sh &
[2]+   Running                      sh while1.sh &
[root@oldboy ~]# kill %2                            #<==注意任务编号的写法。
[root@oldboy ~]# jobs
[1]-   Running                      sh while1.sh &
[2]+   Terminated                   sh while1.sh     #<==脚本已关闭。
更多有关进程管理的Linux相关命令如下。
- kill、killall、pkill:杀掉进程。
- ps:查看进程。
- pstree:显示进程状态树。
- top:显示进程。
- renice:改变优先权。
- nohup:用户退出系统之后继续工作。
- pgrep:查找匹配条件的进程。
- strace:跟踪一个进程的系统调用情况。
- ltrace:跟踪进程调用库函数的情况。
范例:使用while循环竖向打印54321。
参考答案1:
[root@oldboy scripts]# cat 10_2_1.sh
#! /bin/sh
i=5                          #<==因为是从大到小打印,所以初始化i的值为5。
while ((i>0))               #<==双小括号条件表达式的用法,当i大于0不成立时就跳出循环。
do
    echo  "$i"               #<==打印变量i的值。
    ((i--))                  #<==i的值自减,每次自减1。
done
执行结果如下:
[root@oldboy scripts]# sh 10_2_1.sh
5
4
3
2
1
参考答案2:使用双中括号条件表达式。
#! /bin/sh
i=5
while [[ $i > 0 ]]                          #<==双中括号条件表达式的用法。
do
    echo $i
    ((i--))
done
参考答案3:使用脚本传参需要打印的数字。
i="$1"                                        #<==使用i接收脚本传参。
while [ $i -gt 0 ]                            #<==单中括号条件表达式的用法。
do
    echo $i
    ((i--))
done
执行结果如下:
[root@oldboy scripts]# sh 10_2_3.sh 5   #<==也可以传入其他数字
5
4
3
2
1
参考答案4:使用until命令。
[root@oldboy scripts]# cat 10_2_4.sh
#! /bin/sh
i=5
until [[ $i < 1 ]]                          #<==当条件表达式不成立时,进入循环执行命令,因为5<1不成立,因此进入循环执行命令。
do
   echo $i
   ((i--))
done
执行结果如下:
[root@oldboy scripts]# sh 10_2_4.sh
5
4
3
2
1
范例:计算从1加到100之和(请用1+2+3+…+100的方法)。
参考答案:
[root@oldboy scripts]# cat 10_3_1.sh
#! /bin/bash
# this script is created by oldboy.
i=1                 #<==i为自增的变量,从1到100,初始值为1。
sum=0               #<==总和变量初始值为0。
while ((i<=100))   #<==条件是i小于等于100,也就是从1加到100。
do
    ((sum=sum+i)) #<==把i的值和当前sum总和的值做加法并将结果重新赋值给sum。
    ((i++))         #<==i每次自增1。
done
[ "$sum" -ne 0 ] && printf "totalsum is: $sum\n" #<==打印总和。
执行结果如下:
[root@oldboy scripts]# sh 10_3_1.sh
totalsum is: 5050
下面是通过数学公式计算的结果:
[root@oldboy scripts]# cat 10_3_2.sh
#! /bin/sh
i=100
((sum=i*(i+1)/2))         #<==利用数学公式进行计算,效率很高。
echo $sum
[root@oldboy scripts]# sh 10_3_2.sh
5050
4、企业生产实战:while循环语句实践
范例:使用while守护进程的方式监控网站,每隔10秒确定一次网站是否正常。
[root@oldboy scripts]# cat 10_6_1.sh
#! /bin/sh
if [ $# -ne 1 ]; then               #<==判断,若传参的个数不为1,
    echo $"usage $0 url"            #<==则打印正确使用提示。
    exit 1                          #<==以返回值1退出脚本。
fi
while true                          #<==永远为真,进入while循环。
do
    if [ `curl -o /dev/null --connect-timeout 5 -s -w "%{http_code}"   $1|
egrep -w "200|301|302"|wc -l` -ne 1 ]
    #<==对传入的URL参数获取状态码,过滤200、301、302任意之一转为数字,如果不等于1,则表示状态信息不对。
      then
        echo "$1 is error."         #<==提示URL访问错误。
        #echo "$1 is error."|mail -s "$1 is error." 31333741--@qq.com
                                    #<==发送邮件报警。
    else
        echo "$1 is ok"             #<==否则,提示URL访问OK。
    fi
    sleep 10   #<==休息10秒继续执行while循环,注意,当while后面有true等永远为真的条件时,一般在循环里要有退出循环的条件或类似sleep休息的命令,否则会大量消耗系统资源。
done
执行结果如下:
[root@oldboy scripts]# sh 10_6_1.sh http://www.oldboyedu.com
http://www.oldboyedu.com is ok    #<==每隔10秒检查一次,提示正常。
http://www.oldboyedu.com is ok    #<==每隔10秒检查一次,提示正常。
[root@oldboy scripts]# sh 10_6_1.sh http://www.abcdefg.com #<==换个不存在的地址。
http://www.abcdefg.com is error. #<==每隔10秒检查一次,提示异常。
http://www.abcdefg.com is error. #<==每隔10秒检查一次,提示异常。
范例:使用while守护进程的方式监控网站,每隔10秒确定一次网站是否正常。
参考答案1:引入函数库并且采用模拟用户访问的方式。
[root@oldboy scripts]# cat 10_7_1.sh
#! /bin/sh
. /etc/init.d/functions           #<==这里和上一个脚本不同,引入了函数库。
if [ $# -ne 1 ]; then
   echo $"usage $0 url"
   exit 1
fi
while true
do
   if [ `curl -o /dev/null --connect-timeout 5 -s -w "%{http_code}"   $1|
egrep -w "200|301|302"|wc -l` -ne 1 ]
     then
       action "$1 is error." /bin/false  #<==这里和上一个脚本不同,输出显示更专业了。
       #echo "$1 is error."|mail -s "$1 is error." 31333741--@qq.com
   else
       action "$1 is ok" /bin/true     #<==这里和上一个脚本不同,输出显示更专业了。
   fi
   sleep 10
done
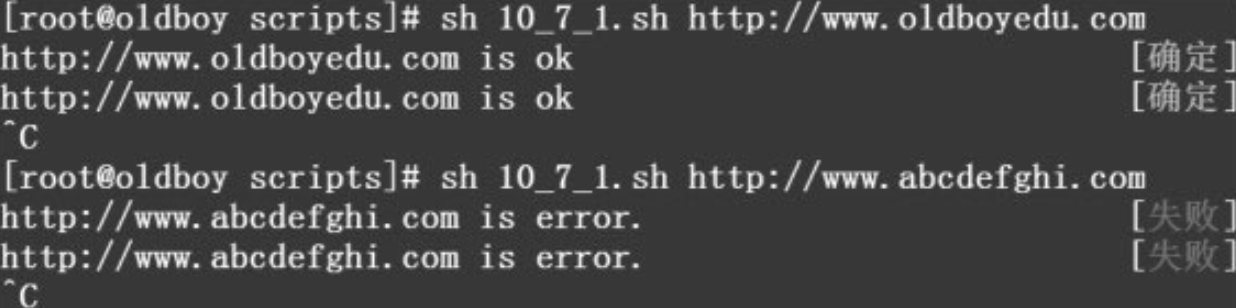
执行结果见下图。
参考答案2:采用Shell数组法,同时检测多个URL是否正常,并给出专业的展示效果,这是实际工作中所用的脚本。
[root@oldboy scripts]# cat 10_7_2.sh
#! /bin/bash
# this script is created by oldboy.
# e_mail:31333741@qq.com
# function:case example
# version:1.3
. /etc/init.d/functions
check_count=0
url_list=(                  #<==定义检测的URL数组,包含多个URL地址。
http://blog.oldboyedu.com
http://blog.etiantian.org
http://oldboy.blog.51cto.com
http://10.0.0.7
)
function wait()             #<==定义3,2,1倒计时函数。
{
    echo -n '3秒后,执行检查URL操作.';
    for ((i=0; i<3; i++))
    do
        echo -n "."; sleep 1
    done
    echo
}
function check_url()        #<==定义检测URL的函数。
{
    wait                    #<==执行倒计时函数。
    for ((i=0; i<`echo ${#url_list[*]}`; i++)) #<==循环数组元素。
    do
        wget -o /dev/null -T 3 --tries=1 --spider ${url_list[$i]} >/dev/null 2>&1
                                                       #<==检测是否可以访问数组元素的地址。
        if [ $? -eq 0 ]                                #<==如果返回值为0,则表示访问成功。
          then
            action "${url_list[$i]}" /bin/true #<==优雅地显示成功结果。
        else
            action "${url_list[$i]}" /bin/false #<==优雅地显示失败结果。
        fi
    done
    ((check_count++))                                  #<==检测次数加1。
}
main(){                                                #<==定义主函数。
    while true                                         #<==开启一个持续循环。
    do
        check_url                                      #<==加载检测url的函数。
        echo "-------check count:${check_count}---------"
        sleep 10                                       #<==间歇10秒。
    done
}
main                                                   #<==调用主函数运行程序。
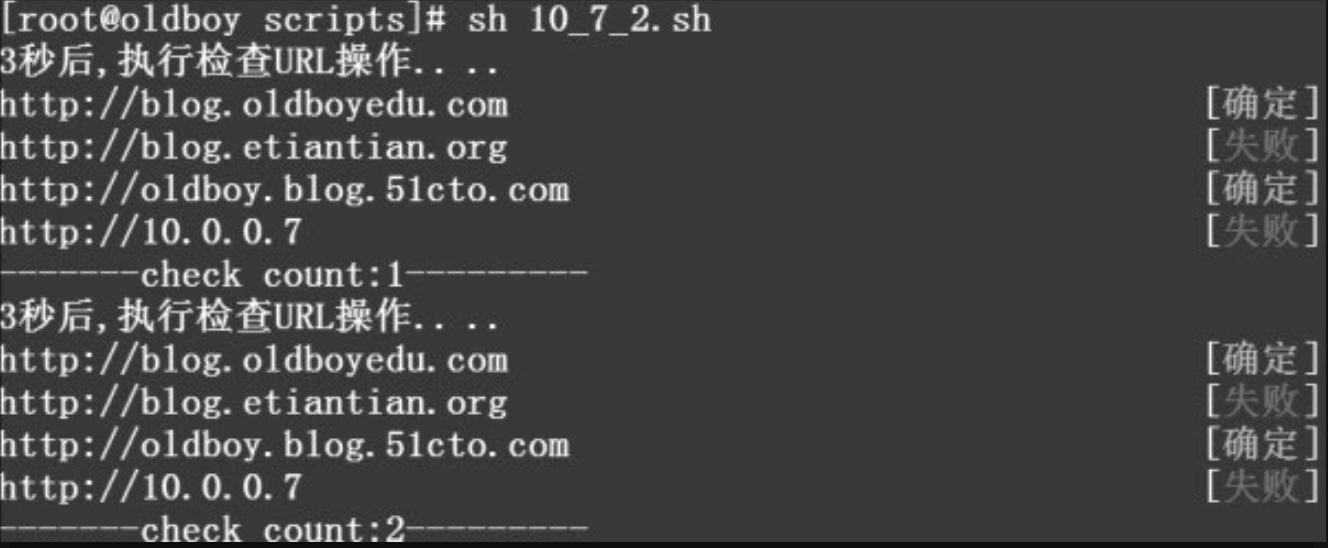
执行结果见下图。
5、while循环按行读文件的方式总结
方式1:采用exec读取文件,然后进入while循环处理。
exec <FILE
sum=0
while read line
do
    cmd
done
方式2:使用cat读取文件内容,然后通过管道进入while循环处理。
cat FILE_PATH|while read line
do
    cmd
done
方式3:在while循环结尾done处通过输入重定向指定读取的文件。
while read line
do
    cmd
done<FILE
范例:开发一个Shell脚本实现Linux系统命令cat读文件的基本功能。
[root@oldboy scripts]# cat 10_9_1.sh
while read line
do
   echo $line
done<$1
执行结果如下:
[root@oldboy scripts]# sh 10_9_1.sh /etc/hosts
127.0.0.1  localhost  localhost.localdomain  localhost4  localhost4.
localdomain4
::1 localhost localhost.localdomain localhost6 localhost6.localdomain6
6、企业级生产高级实战案例
范例:写一个Shell脚本解决类DDoS攻击的生产案例。请根据Web日志或系统网络连接数,监控某个IP的并发连接数,若短时内PV达到100,即调用防火墙命令封掉对应的IP。防火墙命令为:“iptables -I INPUT -s IP地址-j DROP”。
参考答案1:
先分析Web日志,可以每分钟或每小时分析一次,这里给出按小时处理的方法。可以将日志按小时进行分割,分成不同的文件,根据分析结果把PV数高的单IP封掉。例如,每小时单IP的PV数超过500,则即刻封掉,这里简单地把日志的每一行近似看作一个PV,实际工作中需要计算实际页面的数量,而不是请求页面元素的数量,另外,很多公司都是以NAT形式上网的,因此每小时单IP的PV数超过多少就会被封掉,还要根据具体的情况具体分析,本题仅给出一个实现的案例,读者使用时需要考虑自身网站的业务去使用。
解答如下:
[root@oldboy scripts]# cat 10_10_1.sh
file=$1                     #<==定义一个变量接收命令行传参,参数为日志文件类型。
while true
do
    awk '{print $1}' $1|grep -v "^$"|sort|uniq -c >/tmp/tmp.log
    #<==分析传入的日志文件,并在排序去重后追加到一个临时文件里。
    exec </tmp/tmp.log     #<==读取上述临时文件。
    while read line         #<==进入while循环处理。
    do
        ip=`echo $line|awk '{print $2}'`          #<==获取文件中的每一行的第二列。
        count=`echo $line|awk '{print $1}'`       #<==获取文件中的每一行的第一列。
        if [ $count -gt 500 ] && [ `iptables -L -n|grep "$ip"|wc -l` -lt 1 ]
        #<==如果PV数大于500,并且防火墙里没有封过此IP。
          then
            iptables -I INPUT -s $ip -j DROP      #<==则封掉PV数大于500的IP。
            echo "$line is dropped" >>/tmp/droplist_$(date +%F).log
                                                  #<==记录处理日志。
        fi
    done
    sleep 3600  #<==读者可以按分钟进行分析,不过日志的分割或过滤也得按分钟才行。
done
执行结果如下:
[root@oldboy scripts]# sh 10_10_1.sh access.log
单独打开窗口查看iptables的情况,结果如下:
[root@oldboy ~]# iptables -L -n
Chain INPUT (policy ACCEPT)
target       prot opt source                    destination
DROP         all  --  59.33.26.105           0.0.0.0/0      #<==这就是脚本封掉的IP。
DROP         all  --  124.115.4.18           0.0.0.0/0      #<==这就是脚本封掉的IP。

Chain FORWARD (policy ACCEPT)
target       prot opt source                    destination

Chain OUTPUT (policy ACCEPT)
target       prot opt source                    destination
参考答案2:
分析Linux系统的网络连接数,而不是分析Web日志。
设计思路:
首先要分析单IP占网络连接数的情况,即取当前网络连接状态为ESTABLISHED的行数,然后分析对应客户端列不同IP连接数量的排序,对排序比较高的IP进行封堵。
以下是待用的模拟数据:
 [root@oldboy scripts]# sed -n '20,30p' netstat.log
 tcp     0     0     115.29.49.213:80        120.237.97.10:54195       ESTABLISHED
 tcp     0     0     115.29.49.213:80        49.80.146.230:13453       FIN_WAIT2
 tcp     0     0     115.29.49.213:80        113.104.25.50:56714       FIN_WAIT2
 tcp     0     0     115.29.49.213:80        101.226.89.193:41639      ESTABLISHED
 tcp     0     0     115.29.49.213:80        119.147.225.185:58321     TIME_WAIT
 tcp     0     0     115.29.49.213:80        54.183.177.237:64129      TIME_WAIT
 tcp     0     0     115.29.49.213:80        120.198.202.48:41960      ESTABLISHED
 tcp     0     1     115.29.49.213:80        119.127.188.242:38843     FIN_WAIT1
 tcp     0     0     115.29.49.213:34081     223.4.9.70:80             TIME_WAIT
 tcp     0     0     115.29.49.213:80        58.223.4.14:46716         FIN_WAIT2
 tcp     0     0     115.29.49.213:80        122.90.74.255:12177       FIN_WAIT2
实现对应客户端列不同的IP连接数量排序的方法有:
[root@oldboy  scripts]#  grep  "ESTABLISHED"  netstat.log|awk  -F  "[  :]+"
'{print $(NF-3)}'|sort|uniq -c|sort -rn -k1|head -5
     4 118.242.18.177
     3 123.6.8.223
     3 114.250.252.127
     2 123.244.104.42
     2 121.204.108.160
[root@oldboy  scripts]#  grep  "ESTABLISHED"  netstat.log|awk  -F  "[  :]+"  '{
++S[$(NF-3)]}END {for(key in S) print S[key], key}'|sort -rn -k1|head -5
     4 118.242.18.177
     3 123.6.8.223
     3 114.250.252.127
     2 123.244.104.42
     2 121.204.108.160
在命令行中采用如下命令封掉IP:
iptables -I INPUT -s 121.204.108.160 -j DROP
让程序每3分钟执行一次,这里使用while守护进程的方式来实现。
参考答案1:
[root@oldboy scripts]# cat 10_10_2.sh
#! /bin/sh
file=$1             #<==定义一个变量以接收命令行传参,参数为日志文件类型。实际工作中可以先使用netstat命令将网络状态生成临时文件,然后再传参给$1。
if expr "$file" : ".*\.log" &>/dev/null #<==expr的用法,判断扩展名是否以.log结尾。
  then
    :                                #<==这个冒号表示什么都不做。
else
    echo $"usage:$0 xxx.log"         #<==对不符合扩展名类型的给出正确提示。
    exit 1                           #<==退出脚本。
fi

while true
do
    grep "ESTABLISHED" $1|awk -F "[ :]+" '{ ++S[$(NF-3)]}END {for(key in S)
print S[key], key}'|sort -rn -k1|head -5 >/tmp/tmp.log  #<==分析传入的网络状态日志,获取到客户端IP列的信息,并去重排序。
    while read line                              #<==读取去重后的/tmp/tmp.log文件。
    do
        ip=`echo $line|awk '{print $2}'`         #<==获取文件中的每一行的第二列。
        count=`echo $line|awk '{print $1}'` #<==获取文件中的每一行的第一列。
        if [ $count -gt 500 ] && [ `iptables -L -n|grep "$ip"|wc -l` -lt 1 ]
        #<==如果PV数大于500,并且防火墙里没有封过此IP,可通过设置小的值测试。
          then
            iptables -I INPUT -s $ip -j DROP  #<==则封掉PV数大于500的IP。
            echo "$line is dropped" >>/tmp/droplist_$(date +%F).log
        #<==记录处理日志。
        fi
    done</tmp/tmp.log     #<==读入临时日志文件,即使是放在结尾,也是在进入循环的时候就读入了。
    sleep 180
done
参考答案2:更专业的脚本(分模块实现)
[root@oldboy scripts]# cat 10_10_3.sh
#! /bin/sh
file=$1
JudgeExt(){                  #<==定义判断扩展名的函数,可以传入日志文件。
    if expr "$1" : ".*\.log" &>/dev/null
      then
        :
    else
        echo $"usage:$0 xxx.log"
        exit 1
    fi
}
IpCount(){                   #<==分析日志,对访问的IP去重排序。
grep  "ESTABLISHED"  $1|awk  -F  "[  :]+"  '{  ++S[$(NF-3)]}END  {for(key  in  S)
print S[key], key}'|sort -rn -k1|head -5 >/tmp/tmp.log
}
ipt(){                       #<==防火墙封堵函数。
    local ip=$1
    if [ `iptables -L -n|grep "$ip"|wc -l` -lt 1 ]
      then
        iptables -I INPUT -s $ip -j DROP
        echo "$line is dropped" >>/tmp/droplist_$(date +%F).log
    fi
}
main(){                              #<==主函数main。
    JudgeExt $file                   #<==传入日志判断扩展名。
    while true
    do
        IpCount $file                #<==对传入日志文件排序去重。
        while read line
        do
            ip=`echo $line|awk '{print $2}'`
            count=`echo $line|awk '{print $1}'`
            if [ $count -gt 3 ]      #<==去重后检测,若某IP超过3次,则封堵,实际工作中可以调整成你需要的阈值。
              then
                ipt $ip              #<==封掉对应的IP。
            fi
        done</tmp/tmp.log
        sleep 180
    done
}
main
7、小结
- (1)While循环结构及相关语句综合实践小结
- while循环的特长是执行守护进程,以及实现我们希望循环持续执行不退出的应用,适合用于频率小于1分钟的循环处理,其他的while循环几乎都可以被后面即将要讲到的for循环及定时任务crond功能所替代。
- case语句可以用if语句来替换,而在系统启动脚本时传入少量固定规则字符串的情况下,多用case语句,其他普通判断多用if语句。
- 一句话场景下,if语句、for语句最常用,其次是while(守护进程)、case(服务启动脚本)。
- (2)Shell脚本中各个语句的使用场景
- 条件表达式,用于简短的条件判断及输出(文件是否存在,字符串是否为空等)
- if取值判断,多用于不同值数量较少的情况。
- for最常用于正常的循环处理中。
- while多用于守护进程、无限循环(要加sleep和usleep控制频率)场景。
- case多用于服务启动脚本中,打印菜单可用select语句,不过很少见,一般用cat的here文档方法来替代。


 扫一扫


 161

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


