



分片
什么是分片?
顾名思义,就是把文档切分成多个片段。
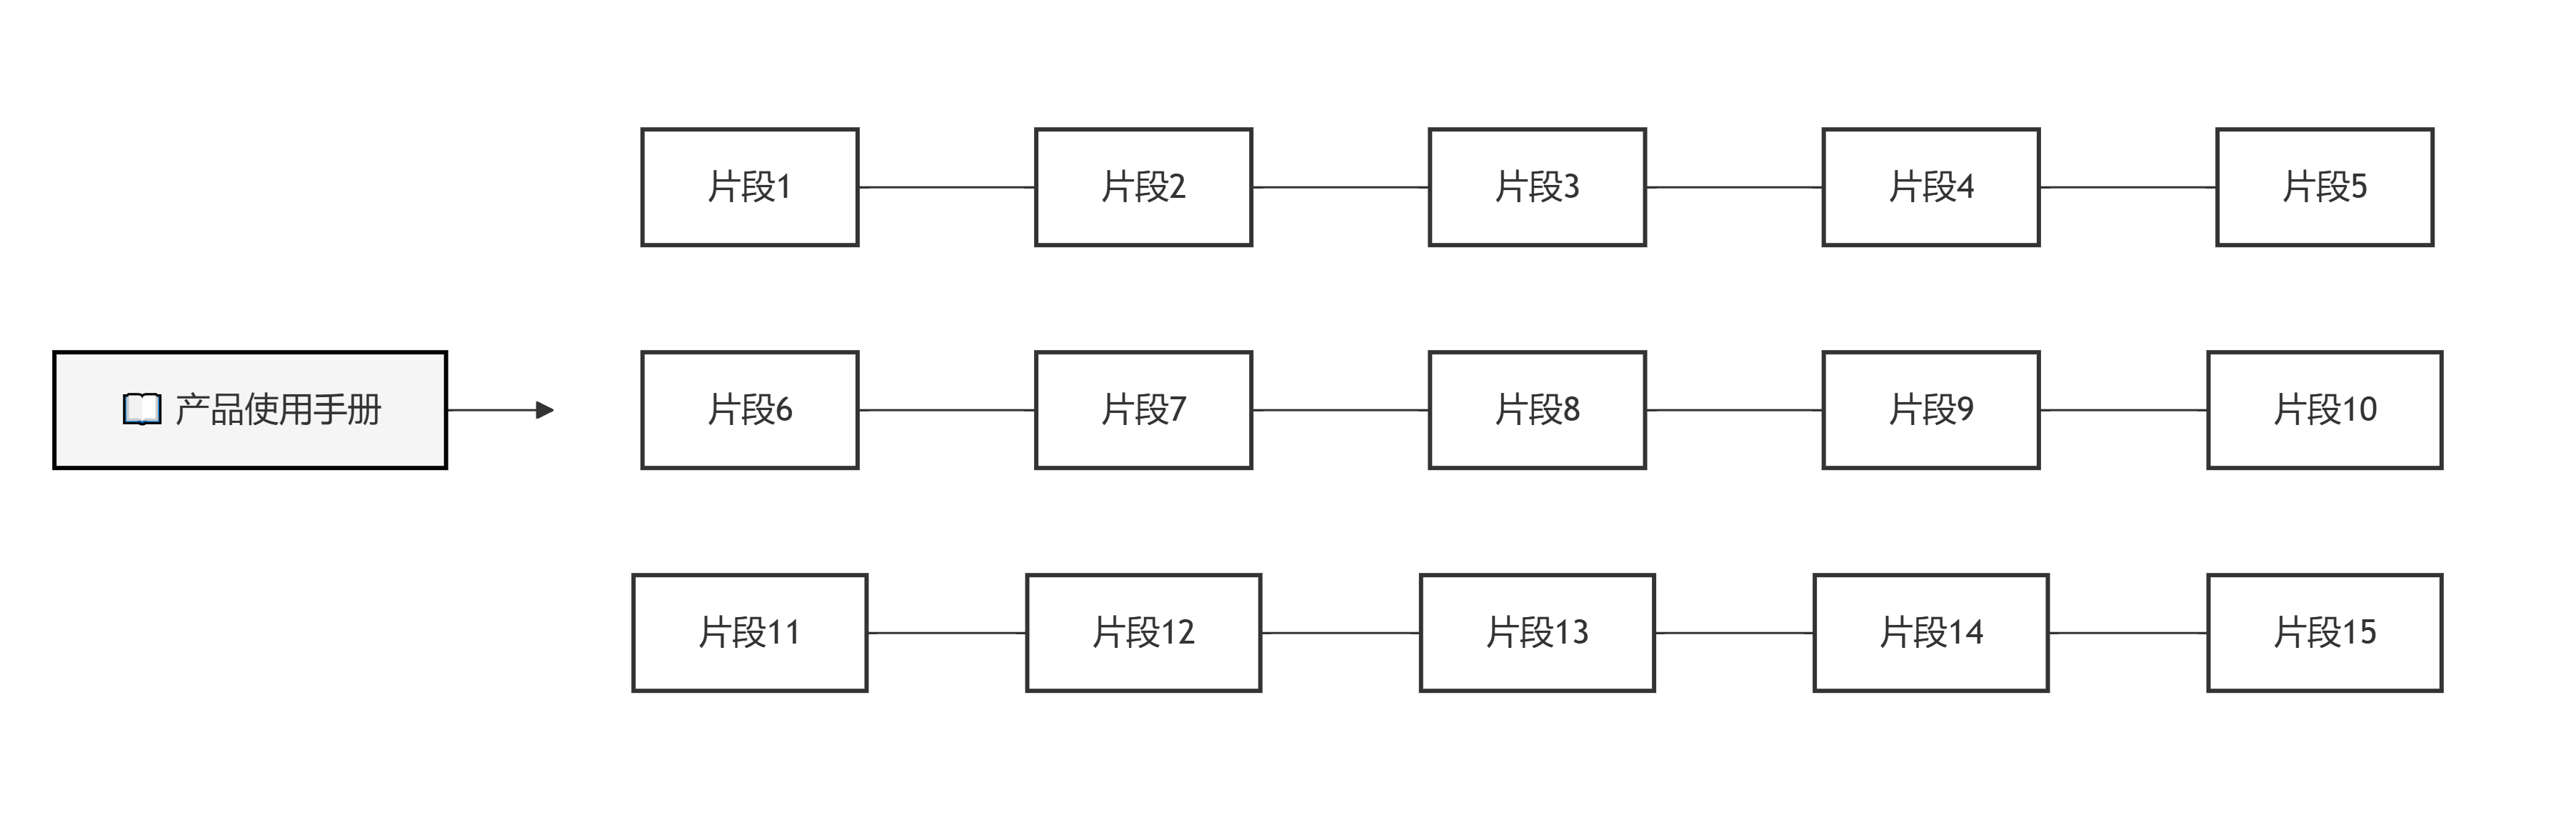
分片的方式
- 按照字数
- 按照段落
- 按照章节
- 按照页码
- …
目的就是把一个文档分成多份,存入向量数据库。
索引
通过Embedding将片段文本转换为向量
向量:有大小和方向的量
一维向量:[1.2]、[3.3]
二维向量:[1.59,2.25]、[2.2,3.9]
三维向量:[1.529,21.21,3.1]、[2.21,3.39,8.8]
…
Embedding就是将文本转为向量的过程,Embedding是由模型完成的。
将片段文本和片段向量存入向量数据库
向量数据库:用于存储和查询向量的数据库,一般存储向量和原始文本
| 向量 | 文本 |
|---|---|
| [1.59,2.25,1.1,2,1,5…9.9,8.8] | 中国人 |
| [8.5,6,8.6,9.57,5.8,…96,5.5,9] | 这是一篇博客 |
召回
什么是召回?
搜索与用户问题相关片段的一个过程。

向量数据库怎么查询的?
通过向量相似度,大体流程如下,先把用户问题转为向量,
| 用户问题向量 | 用户问题文本 |
|---|---|
| [1.59,2.25,1.1,2,1,5…9.9,8.8] | 步行街怎么走 |
目前向量数据库中片段向量
| 片段向量 | 片段文本 |
|---|---|
| [1.59,2.25,1.1,2,1,5…9.9,8.8] | 步行街坐20路可以到 |
| [8.5,6,8.6,9.57,5.8,…96,5.5,9] | 步行街坐出租可以到 |
| [5.5,6.6,9.5,…,5.6,89,99] | 步行街今天下雨 |
然后通过一个公式:similarity(用户向量,片段向量),用户向量不变,片段向量依次填入,计算出向量相似度,然后排序,取最前面的n个
| 向量相似度 |
|---|
| 1.2 |
| 3.5 |
| 9.9 |
向量相似度的计算方法
余弦相似度
欧式距离
点积
重排
什么是重排
重排就是重新排序。召回是从所有的向量相似度中挑选最与用户问题相关n个返回,重排就是在这个n个中再次排序,挑选前几个返回。
为什么不在召回直接返回前几个,省去重排步骤呢?
重排和召回的区别
| / | 召回 | 重排 |
|---|---|---|
| 方法 | 向量相似度 | cross-encoder |
| 特点 | 成本低、耗时短、准确率底 | 成本高、耗时长、准确率高 |
| 适用场景 | 初步筛选 | 精挑细选 |
类似于简历的筛选:召回≈简历初筛,重排≈面试
生成
大模型根据用户问题和片段,生成用户的答案
整体流程



 扫一扫


 1360

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


