




 超级会员免费看
文章核心总结与创新点
主要内容
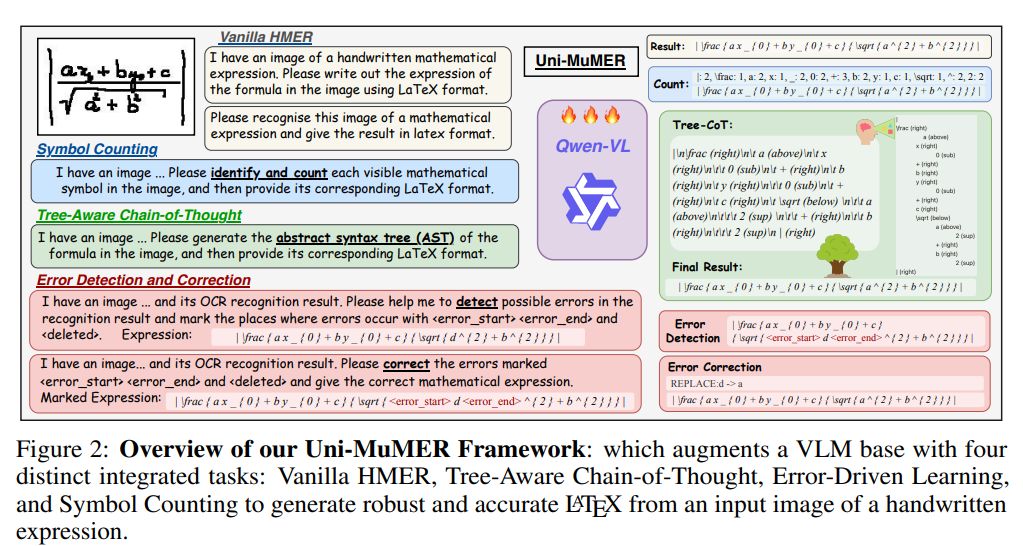
文章针对手写数学表达式识别(HMER)的符号布局自由、手写风格多变等挑战,提出了统一多任务微调框架Uni-MuMER。该框架基于预训练视觉语言模型(VLM),不修改模型架构,通过融入领域知识实现性能突破。框架整合了四个任务:基础HMER任务、树感知思维链(Tree-CoT)、误差驱动学习(EDL)和符号计数(SC),在CROHME、HME100K等多个数据集上进行验证,最终取得超越现有SOTA模型的性能,同时具备高效推理能力。
创新点
- 提出统一范式:摒弃传统孤立的架构修改思路,通过数据驱动的多任务微调,将领域知识注入通用VLM,实现性能累积提升。
- 设计三大核心任务:Tree-CoT解决2D结构推理问题,EDL减少视觉相似符号混淆,SC提升长表达式识别一致性,系统应对HMER核心挑战。
- 跨数据集泛化能力:融合多源数据集(CROHME、HME100K、MathWriting等),增强模型在不同场景(手写、印刷)下的适应性,且推理速度优于传统专用模型。
英文原文翻译(Markdown格式)
Abstract
手写数学表达式识别(HMER)由于符

 订阅专栏 解锁全文



 扫一扫


 231

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


