Python爬虫| 爬虫框架Scrapy的构架、工作原理及工作流程是怎样的?

python爬虫scrapy框架基础 我使用的软件是pychram最近几周也一直在学习scrapy,发现知识点比较混乱,今天来总结一下。我是按照《精通python网络爬虫核心技术框架与项目实战》这本书来写的。讲的比较简洁,想要详细了解的可以看看书或者视频。scrapy框架运行的原理首先scrapy引擎会将蜘蛛爬虫(spider)中设置的起始网址传递到调度器中第一步:过程(1)是调度器(Scheduler)将要爬取的网址传递到scrapy引擎中,调度器是一个优先队列,根据优先级按顺序传递到scrapy引擎中 第二步:过程(2)是scrapy收到调 阅读详情

在这里插入图片描述

**1、**Scrapy框架的介绍

Scrapy是一个基于Python的开源网络爬虫框架,是一个快速、高层次的屏幕抓取和web抓取框架,用于抓取web站点并从页面中提取结构化的数据。它可以帮助开发者快速、高效地从网站上获取数据。

Scrapy用途广泛,可以用于数据挖掘、监测和自动化测试。

Scrapy吸引人的地方在于它是一个框架,任何人都可以根据需求方便的修改。它也提供了多种类型爬虫的基类,如BaseSpider、sitemap爬虫等。

尽管Scrapy原本是设计用来屏幕抓取(更精确的说,是网络抓取),但它也可以用来访问API来提取数据。

2、Scrapy框架的基本原理

Scrapy框架的基本原理是通过发送HTTP请求获取网页内容,然后使用Xpath或CSS选择器等工具解析网页内容,最后新数据存储到数据库或文件中。

3、爬虫框架scrapy架构

scrapy框架的核心组件由五大组件引擎、调度器、下载器、爬虫、管道和中间件组成。

五大组件是调度器(Scheduler),下载器(Downloader),爬虫(Spider),实体管道(Item Pipeline),Scrapy引擎(Scrapy Fngine)。

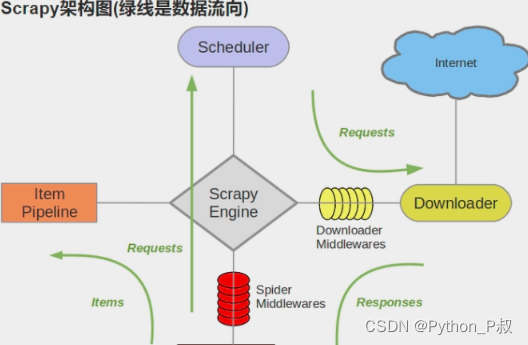
3.1 Scrapy架构图
在这里插入图片描述

3.2 Scrapy五大组件及中间件

**(1)Scrapy Engine(引擎):**是整个框架的核心,它负责控制整个爬虫的流程,包括Spider、ItemPipeline、Downloader、Scheduler中间的通讯,信号、数据传递等。

**(2)Scheduler(调度器):**负责管理待爬取的URL队列,它负责接受引擎发送过来的Request请求,并按照一定的方式进行整理排列,入队,当引擎需要时,交还给引擎。

**(3)Downloader(下载器):**下载器负责发送HTTP请求并获取网页内容,负责下载Scrapy Engine(引擎)发送的所有Requests请求,并将其获取到的Responses交还给Scrapy Engine(引擎),由引擎交给Spider来处理。

**(4)Spider(爬虫):**负责解析网页内容并提取数据,它负责处理所有Responses,从中分析提取数据,获取Item字段需要的数据,并将需要跟进的URL提交给引擎,再次进入Scheduler(调度器)。

**(5)Item Pipeline(管道):**负责将爬取到的数据存储到数据库或文件中,处理Spider中获取到的Item,并进行进行后期处理(详细分析、过滤、存储等)的地方。

**(6)Downloader Middlewares(下载中间件):**一个可以自定义扩展下载功能的组件。

**(7)Spider Middlewares(Spider中间件):**一个可以自定扩展和操作引擎和Spider中间通信的功能组件。

3.3 Scrapy工作流程

(1)spider中的url被封装成请求对象交给引擎(每一个对应一个请求对象)。

(2)引擎拿到请求对象之后,将全部交给调度器。

(3)调度器拿到所有请求对象后,通过内部的过滤器过滤掉重复的url,最后将去重后的所有url对应的请求对象压入到队列中,随后调度器调度出其中一个请求对象,并将其交给引擎。

(4)引擎将调度器调度出的请求对象交给下载器。

(5)下载器拿到该请求对象去互联网中下载数据。

(6)数据下载成功后会被封装到response中,随后response会被交给下载器。

(7)下载器将response交给引擎。

(8)引擎将response交给spiders。

(9)spiders拿到response后调用回调方法进行数据解析,解析成功后生成item,随后spiders将item交给引擎。

(10)引擎将item交给管道,管道拿到item后进行数据的持久化存储。

3.4 Scrapy框架的优点

Scrapy框架的优点在于它具有高度的可扩展性和灵活性。开发者可以根据自己的需求自定义爬虫、管道和中间件等组件,以满足不同的爬虫需求。此外,Scrapy框架还支持异步IO和分布式爬虫等功能,可能提高爬虫的效率和稳定性。

---------------------------END---------------------------

感兴趣的小伙伴,赠送全套Python学习资料,包含面试题、简历资料等具体看下方。

👉CSDN大礼包🎁:全网最全《Python学习资料》免费赠送🆓!(安全链接,放心点击)

一、Python所有方向的学习路线

Python所有方向的技术点做的整理,形成各个领域的知识点汇总,它的用处就在于,你可以按照下面的知识点去找对应的学习资源,保证自己学得较为全面。img
img

二、Python必备开发工具

工具都帮大家整理好了,安装就可直接上手!img

三、最新Python学习笔记

当我学到一定基础,有自己的理解能力的时候,会去阅读一些前辈整理的书籍或者手写的笔记资料,这些笔记详细记载了他们对一些技术点的理解,这些理解是比较独到,可以学到不一样的思路。

img

四、Python视频合集

观看全面零基础学习视频,看视频学习是最快捷也是最有效果的方式,跟着视频中老师的思路,从基础到深入,还是很容易入门的。

img
五、实战案例

纸上得来终觉浅,要学会跟着视频一起敲,要动手实操,才能将自己的所学运用到实际当中去,这时候可以搞点实战案例来学习。img

六、面试宝典

在这里插入图片描述
在这里插入图片描述

简历模板在这里插入图片描述
Python Scrapy】详细介绍Scrapy的基本结构、组件和工作原理 Scrapy是一个功能强大的Python爬虫框架,提供了完备的爬取任务的工具集,同时也允许在需要的时候实现自定义组件,极大地提高了开发和维护的效率。掌握Scrapy并使用其组件进行爬虫开发,对于爬虫开发人员,是一门必不可少的技能。无论是对于爬虫性能的优化,还是对于数据的处理与管理,在Scrapy的丰富组件库中,都有非常成熟和专业的解决方案可以采用。 阅读详情

相关推荐

2024 高级爬虫笔记(六)scrapy框架基础知识

Scrapy是一个为了爬取网站数据,提取结构性数据而编写的应用框架,我们只需要实现少量的代码,就能够快速的抓取。Scrapy 使用了Twisted异步网络框架,可以加快我们的下载速度。

小陈工的博客 2887

超详细的Scrapy框架的基本使用教程

scrapy框架Python爬虫

什么时候才不是菜鸟.... 1万+

【愚公系列】《Python网络爬虫从入门到精通》049-了解Scrapy爬虫框架

大家好,欢迎来到《Python网络爬虫从入门到精通》系列教程的第48篇文章。经过前面几十篇的学习,我们已经掌握了使用 requests、BeautifulSoup、Selenium 等工具进行数据抓取的基本方法。然而,随着项目的复杂度提升,这些工具在面对大型、高并发、高可维护性的爬虫任务时,往往力不从心。这时候,专业的爬虫框架——Scrapy,就该登场了。Scrapy 是一个由 Python 编写的、功能强大的异步爬虫框架,它具备高性能、模块化、易扩展等诸多优点,被广泛应用于各种数据采集任务中。

愚公智库 10万+

Scrapy----Scrapy架构及工作流程

本文主要介绍了scrapy的架构和工作流程

redrose2100的博客 1294

爬虫框架 Scrapy 详解

Scrapy是适用于Python的一个快速、高层次的屏幕抓取和web抓取框架,用于抓取web站点并从页面中提取结构化的数据。Scrapy用途广泛,可以用于数据挖掘、监测和自动化测试。Scrapy是一个框架,可以根据需求进行定制。它也提供了多种类型爬虫的基类,如BaseSpider、sitemap爬虫等,最新版本又提供了web2.0爬虫的支持。...

m0_67403076的博客 1万+

Scrapy框架(高效的网络爬虫

介绍scrapy框架的使用,并给出案例

FFNCL的博客 3187

【论文投稿】Python 网络爬虫:探秘网页数据抓取的奇妙世界

在当今数字化信息呈爆炸式增长的时代,网络爬虫宛如一把神奇的钥匙,开启了通往海量数据宝藏的大门。无论是商业领域的市场情报搜集、科研工作中的资料聚合,还是个人兴趣驱动下的信息整合,网络爬虫都展现出了无与伦比的价值。今天,就让我们一同走进 Python 网络爬虫的精彩世界,探索其中的奥秘。Python 网络爬虫为我们打开了一扇通往无限数据世界的大门,在商业、科研、生活等各个领域释放出巨大能量。通过掌握requestsScrapy等核心工具和框架,我们能够披荆斩棘,克服重重挑战,从网页的海洋中挖掘出珍贵的数据宝藏。

来自想要赚大钱的小周同学 9449

Python开发从入门到精通:网络爬虫高级应用与Scrapy框架

本文介绍了Python网络爬虫的高级应用与Scrapy框架的核心内容。首先概述了网络爬虫的基本概念和工作流程,然后重点讲解了Scrapy框架的安装、项目创建和爬虫编写方法。针对动态网页爬取,介绍了Selenium的使用及其与Scrapy的结合。在反爬虫策略方面,详细说明了代理IP、User-Agent旋转和Cookies池等技术的实现。最后,通过Scrapy-Redis实现了分布式爬虫,并以豆瓣电影Top250为案例进行了实战演示。文章涵盖了网络爬虫开发的核心技术要点,包括框架使用、反反爬措施和分布式处理等

编程世界如山海,探索不止。 2万+

网络爬虫框架Scrapy

Scrapy是一个用Python编写的网络爬虫框架,它提供了许多工具和功能,使得开发者可以轻松地构建强大的网络爬虫

2302_80048824的博客 2454

Python 网络爬虫入门与实战

网络爬虫(Web Crawler)是自动访问网络并提取信息的程序。它可以模拟人类用户在浏览器中的行为,访问网页、抓取数据并存储到本地或数据库中。网络爬虫在信息检索、数据挖掘、搜索引擎等领域有广泛应用。Scrapy 是一个强大的爬虫框架,支持异步处理和数据存储。它适合大型爬虫项目,可以高效抓取和解析数据。yield item通过本文的学习,您应该对 Python 网络爬虫有了全面的了解。从基础的 Requests 库到高级的 Scrapy 框架,再到实战案例,涵盖了网络爬虫的方方面面。

985工科博士毕业,专攻定位、导航和滤波等算法研究。从业10年,主要使用MATLAB 2175

基于Scrapy框架实现网络爬虫-Python

网络爬虫原理 互联网上大量的信息以网页形式提供给用户,用户通过浏览器从服务器获得网页数据并经过浏览器解析后,进行网页阅读、内容复制、链接单击等操作。用户与网页服务器的通信是通过HTTP或者HTTPS实现的,网络浏览器是用户向服务器发送请求数据、接收服务器回应数据、解析并呈现服务器回应数据的客户端软件。 用户不通过浏览器而是通过程序自动获取网页内容,有两种办法:一是当服务器提供API方法时,可以调用API获取网页数据;二是当服务器没有提供API方法时,需要使用爬虫程序从服务器获取网页数据并从中过滤提取所需数据

weixin_43845524的博客 6327

Python网络爬虫Scrapy框架的全面解析

Scrapy是一个功能强大且灵活的开源网络爬虫框架,它提供了一种高效的方式来爬取网站并提取所需的数据。本文将深入探讨Scrapy框架的核心概念、使用方法以及高级技巧,帮助你更好地理解和应用Scrapy进行网络爬虫的开发。

4.0啊的博客 2838

网络爬虫Scrapy爬虫框架

介绍了Scrapy爬虫框架的原理和基本使用方式

Jingmin Wei's Blog 2987

精通 Python 网络爬虫:核心技术、框架与项目实战

内容简介 本书从技术、工具与实战3个维度讲解了 Python 网络爬虫: 技术维度:详细讲解了 Python 网络爬虫实现的核心技术,包括网络爬虫工作原理、如何用 urllib 库编写网络爬虫爬虫的异常处理、正则表达式、爬虫中 Cookie 的使用、爬虫的浏览器伪装技术、定向爬取技术、反爬虫技术,以及如何自己动手编写网络爬虫; 工具维度:以流行的 Python 网络爬虫框架 Scrapy 为...

GitChat 7480

ScrapyPython中强大的网络爬虫框架

Scrapy是一个开源的网络爬虫框架,由Python编写而成。它提供了一套强大的工具和API,用于处理网页的下载、解析、数据提取和存储。Scrapy的设计目标是高效、可扩展和易于使用,使开发者能够快速构建复杂的网络爬虫应用程序。Scrapy是一款功能强大的Python网络爬虫框架,为开发者提供了一种高效、灵活和可扩展的方式来构建网络爬虫应用程序。它具有强大的爬取能力、灵活的数据提取、自动化的流程控制、分布式和去重机制,以及扩展性和插件支持等特性。

爱编程的鱼的博客 2776

python网络爬虫知识---Scrapy框架

什么是ScrapyScrapy是用来干嘛的?怎么使用Scrapy?这篇让我们一起来认识。

x702604121的博客 2447

基于Scrapy框架下的Python网络爬虫的实现

基于Scrapy项目的目录结构以及相关功能的介绍 Scrapy的基本命令 图片类爬虫项目的实现

jinglong_mydog的博客 8202

Python Scrapy爬虫框架详解

Scrapy 是一个基于 Twisted 实现的异步处理爬虫框架,该框架使用纯 Python 语言编写。Scrapy 框架应用广泛,常用于数据采集、网络监测,以及自动化测试等。提示:Twisted 是一个基于事件驱动的网络引擎框架,同样采用 Python 实现。

ze_mingmingge123的博客 2274
上一篇: P叔带你详解Python模块NumPy
下一篇: Python爬取暑期票房排行
Python_P叔
博客等级 码龄3年 5373粉丝 827原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

红包个数最小为10个

红包金额最低5元

当前余额3.43前往充值 >
需支付:10.00
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值