


 本文详细阐述了Doris存储引擎如何通过优化MemTable的写入、并行下刷机制,以及引入单副本导入功能来提升数据导入性能,特别是针对多副本导入场景,性能提升可达2-8倍。
目录
一、概述
为提供快速的数据写入支持,Doris存储引擎采用了类LSM Tree结构。在进行数据导入时,数据会先写入Tablet对应的MemTable中,MemTable采用SkipList的数据结构,当MemTable写满之后,会将其中的数据刷写(Flush)到磁盘。数据从MemTable刷写到磁盘的过程中分为两个阶段,第一个阶段将MemTable中的行存结构在内存中转换成列存结构,并为每一列生成对应的索引结构;第二阶段是将转换后的列存结构写入磁盘,生成Segment文件。
具体而言,Doris在导入流程中会把BE模块分为上游和下游,上游BE对数据的处理分为Scan和Sink两个步骤:首先Scan过程对原始数据进行解析,然后Sink过程将数据组织并通过RPC分发给下游BE。当下游BE接受数据后,首先在内存结构MemTable中进行数据攒批,对数据进行排序、聚合、并最终下刷成数据文件(也称作Segment文件)到磁盘上来进行持久化存储。
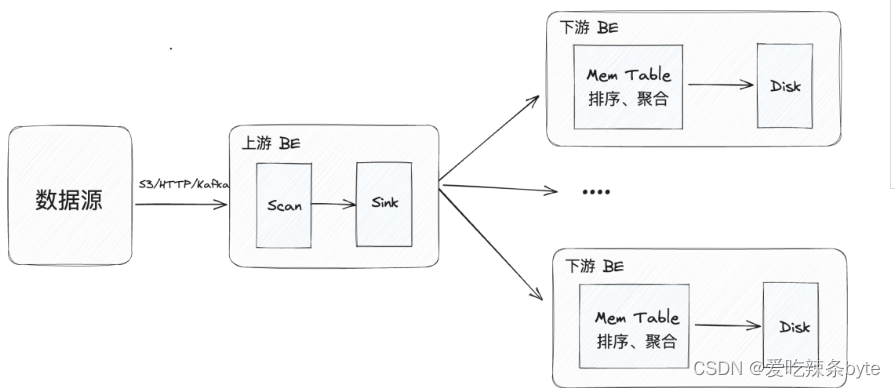
在实际的数据导入过程中,可能会出现以下问题:
- 因上游 BE 跟下游 BE 之间的 RPC 采用 Ping-Pong 的模式,即下游 BE 一个请求处理完成并回复到上游 BE 后,上游 BE 才会发送下一个请求。如果下游 BE 在 MemTable 的处理过程中消耗了较长的时间,那么上游 BE 将会等待 RPC 返回的时间也会变长,这就会影响到数据传输的效率。
-
当对多副本的表导入数据时,需要在每个Tablet副本上重复执行MemTable的处理过程。然而,这种方式使每个Tablet副本所在节点都会消耗一定的内存和 CPU 资源,不仅如此,冗长的处理流程也会影响执行效率。
为解决以上问题,为进一步提高数据导入性能,Doris-2.0版本对导入过程中MemTable的攒批、排序和落盘等流程进行优化,来提高上下游之间数据传输的效率。此外还提供了“单副本导入”的数据分发模式,面对Tablet多副本数据导入时,无需在多个BE上重复进行MemTable工作,有效提升集群计算和内存资源的利用率,进行提升导入的




 扫一扫


 1172

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


