百亿级数据处理优化

Hive JSON解析函数源码真相:银弹还是性能陷阱?百亿嵌套数据处理指南 倔强青铜:无脑,跑批时祈祷不要OOM永恒钻石json_tuple+预处理,查询如德芙般丝滑超凡大师:源码魔改,让JSON解析快到服务器怀疑人生最强王者:切Spark+预处理,直接掀桌换赛道。 阅读详情

最近在做大数据处理时,遇到两个大表 join 导致数据处理太慢(甚至算不出来)的问题。我们的数仓基于阿里的 ODPS,它与 Hive 类似,所以这篇文章也适用于使用 Hive 优化。处理优化问题,一般是先指定一些常用的优化参数,但是当设置参数仍然不奏效的时候,我们就要结合具体的业务,在 SQL 上做优化了。为了不增加大家的阅读负担,我会简化这篇文章的业务描述。

问题

这是一个离线数据处理的问题。在这个业务中有两张表,表结构及说明如下:

user_article_tb 表:
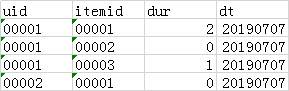
字段解释:
uid: 用户标识,itemid:文章id,dur: 阅读文章时长,如果大于 0 代表阅读了文章,等于 0 代表没有点击文章 
dt:天分区,每天 55 亿条记录

user_profile_tb 表:
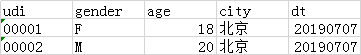
字段解释:
uid:用户标识,gender:性别,F 代表女,M 代表男,age:年龄,city:城市
dt:天分区字段,这是一张总表,每天存储全量用户画像属性,最新数据十亿级别

需求是这样的:计算 7 天中,女性用户在每篇文章上的 ctr (最终会按照降序进行截断)。直接写 SQL 很容易,如下:

select 
  itemid
  , count(if(dur > 0, 1, null)) / count(1) ctr
from
  (
      select uid, itemid, dur
      from u
日均百亿日志处理:微博基于Flink的实时计算平台建设 本文作者简介 吕永卫,微博广告资深数据开发工程师,实时数据项目组负责人。 黄鹏,微博广告实时数据开发工程师,负责法拉第实验平台数据开发、实时数据关联平台、实时算法特征数据计算、实时数据仓库、实时数据清洗组件开发工作。 林发明,微博广告资深数据开发工程师,负责算法实时特征数据计算、实时数据关联平台、实时数据仓库、FlinkStream组件开发工作。 崔泽峰,微博广告资深数据开发工程师,负责实... 阅读详情

相关推荐

零基础入门Neo4j:大数据工程师30天通关指南,从安装到百亿数据查询(附学习路线图)

作为原生图数据库的标杆产品,Neo4j凭借“处理复杂关系数据”的核心能力,已成为金融风控、推荐系统、社交网络等领域的“数据引擎”。但对习惯了关系型数据库(MySQL、PostgreSQL)的大数据工程师而言,从“表-行-列”思维转向“节点-关系-属性”的图思维,再到处理百亿数据的性能优化,是一道不小的门槛。本文是专为大数据工程师设计的30天通关指南:从0开始讲解Neo4j的安装、基础操作、Cypher语法,再到图数据建模、百亿查询优化,最后通过电商推荐系统的实战项目,帮你掌握Neo4j的全流程能力。

小白菜的博客 1932

用户画像:用户画像表

用户画像表 ADM层 每天汇总出的用户画像表仅包含当天的数据,因此还需要和之前汇总好的用户画像表进行新的合并操作后,才算真正的最新数据的用户画像表 用户画像宽表 ADM层 adm.itcast_adm_personas(时间分区) 用户画像宽表 ADM层 = 用户基本属性表 GDM层 gdm.itcast_gdm_user_basic(时间分区)(第 1 张表) + 客户消费模型表 GDM层 gdm.itcast_gdm_user

u013250861的博客 1063

两张上亿的表join,spark sql如何优化

4、调整spark.sql.inMemoryColumnarStorage.compressed参数,以便更好地判断是否应该使用压缩列存储。7、调整spark.sql.statistics.histogram.enabled参数,以便更好地判断是否应该使用直方图统计。3、调整spark.sql.join.preferSortMergeJoin参数,以便更好地判断是否应该使用排序合并连接。6、调整spark.sql.cbo.enabled参数,以便更好地判断是否应该使用代价优化

abxzq19870214的博客 2124

用户画像基础之应用落地和案例展示

赵宏田 老师的 用户画像·方法论与工程化解决方案 一书读后笔记 主要记录的是该书中 用户画像之基础 一章的内容

yang_shibiao的博客 1699

用户画像

导读:在互联网步入大数据时代后,用户行为给企业的产品和服务带来了一系列的改变和重塑,其中最大的变化在于,用户的一切行为在企业面前是可“追溯”“分析”的。企业内保存了大量的原始数据和各种业务数据,这是企业经营活动的真实记录,如何更加有效地利用这些数据进行分析和评估,成为企业基于更大数据量背景的问题所在。随着大数据技术的深入研究与应用,企业的关注点日益聚焦在如何利用大数据来为精细化运营和精准营销服务,而要做精细化运营,首先要建立本企业的用户画像。 画像简介 用户画像,即用户信息标签化,通过收集用户的社会属性

mudan97的博客 959

Hive优化总结

一、SQL本身的优化 1、只select需要的列,避免select * 2、where条件写在子查询中,先过滤再关联 3、关联条件写在on中,而不是where中 4、数据量大时,用group by代替count distinct 5、数据量小时,用in代替join 6、避免笛卡尔积 7、join时大表放后面,使用相同的连接键 7、严格格式 Hive.mapred.mode,分 nonstrict,strict,默认是nonstrict, 如果设置为strict,对三种情况限制: (1)分区表必须加分区。

GodxvA 9050

sql优化核心思想 pdf_数据库运维:百亿数据处理优化

百亿数据处理优化最近在做大数据处理时,遇到两个大表 join 导致数据处理太慢(甚至算不出来)的问题。我们的数仓基于阿里的 ODPS,它与 Hive 类似,所以这篇文章也适用于使用 Hive 优化。处理优化问题,一般是先指定一些常用的优化参数,但是当设置参数仍然不奏效的时候,我们就要结合具体的业务,在 SQL 上做优化了。为了不增加大家的阅读负担,我会简化这篇文章的业务描述。问题这是一个离线数据...

weixin_39941859的博客 617

sql优化核心思想 pdf_百亿数据处理优化

最近在做大数据处理时,遇到两个大表 join 导致数据处理太慢(甚至算不出来)的问题。我们的数仓基于阿里的 ODPS,它与 Hive 类似,所以这篇文章也适用于使用 Hive 优化。处理优化问题,一般是先指定一些常用的优化参数,但是当设置参数仍然不奏效的时候,我们就要结合具体的业务,在 SQL 上做优化了。为了不增加大家的阅读负担,我会简化这篇文章的业务描述。问题这是一个离线数据处理的问题。在这个...

weixin_39947501的博客 1108

azure sql data warehouse join 优化_数据库运维:百亿数据处理优化

百亿数据处理优化最近在做大数据处理时,遇到两个大表 join 导致数据处理太慢(甚至算不出来)的问题。我们的数仓基于阿里的 ODPS,它与 Hive 类似,所以这篇文章也适用于使用 Hive 优化。处理优化问题,一般是先指定一些常用的优化参数,但是当设置参数仍然不奏效的时候,我们就要结合具体的业务,在 SQL 上做优化了。为了不增加大家的阅读负担,我会简化这篇文章的业务描述。问题这是一个离线数据...

weixin_39795065的博客 126

Photon-ML 实战教程:构建百亿参数的推荐系统模型

Photon-ML 是基于 Apache Spark 的可扩展机器学习库,专为处理大规模数据和构建高性能推荐系统而设计。本教程将带你了解如何利用 Photon-ML 的核心功能,从零开始构建一个支持百亿参数的推荐系统模型,即使是新手也能快速上手。 ## 🌟 为什么选择 Photon-ML 构建推荐系统? Photon-ML 与 Spark ML 接口高度兼容,可直接导入使用,同时提供了更强

gitblog_01124的博客 948

Java落地方案学习路线图(真实工业界场景应用)

Java落地方案学习路线图(真实工业界场景应用)

youfanedu的博客 801

一例万写入并发,百亿数据,毫秒返回架构分享

一例万写入并发,百亿数据,毫秒返回架构分享

qq_41490913的博客 331

【免费下载】 使用Higgsfield进行大规模语言模型训练的完整指南

在当今人工智能领域,大规模语言模型(LLM)的训练已成为研究热点。然而,训练这些包含数十亿甚至数百亿参数的模型面临着巨大的技术挑战,特别是在分布式训练、内存优化和训练稳定性方面。本文将深入介绍如何使用Higgsfield这一专业工具来高效训练大规模语言模型。 ## 分布式模型基础 Higgsfield为分布式模型训练提供了简洁易用的接口。让我们从最基本的模型初始化开始: ```python

gitblog_01046的博客 1619

ElasticSearch理解线索

ElasticSearch理解线索 百亿数据全文检索工具,ElasticSearch鼻祖Lucene:详细分析Lucene的索引结构; 系统学习ElasticSearch:详细介绍了各种查询方式,match、match_phrase、term、range等; ElasticSearch详解:ES简介,数据库架构的演化,基础概念及简单性能测试(存疑,分词一般400条/秒左右,索引是怎么做到12000文档/秒的?因为文本长度的差异?); 图解ElasticSearch原理:按Node→Shard

fenss的博客 248

Resume Matcher 如何用 Application Tracker 看板管理求职申请流程?

简历改好、投递出去之后,最难的是跟踪每条申请的进展。Resume Matcher 的 Application Tracker(前端路由 `/tracker`)提供了一个七列看板来管理整个求职管道:把一份简历针对某个职位 tailor(定向优化)并确认后,会**自动**在看板上生成一张 `applied` 卡片;已经在外网投递的岗位,也可以粘贴职位描述(JD)手动建卡。卡片支持拖拽排序、跨列移动、批

gitblog_00940的博客 644

大模型训练新纪元:Llama-Factory支持全参数微调与QLoRA高效训练

Llama-Factory支持全参数微调与QLoRA技术,使消费GPU也能高效微调百亿参数大模型。通过4-bit量化、低秩适配和模块化架构,降低大模型定制门槛,实现数据到部署的全流程闭环,推动大模型技术民主化。

weixin_36311421的博客 564

封神榜大模型:构建中文认知智能基础设施的完整解决方案

Fengshenbang-LM(封神榜大模型)是IDEA研究院认知计算与自然语言研究中心主导的中文大模型开源体系,致力于成为中文AIGC和认知智能的基础设施。该项目不仅提供了从亿百亿参数规模的预训练模型,还构建了完整的训练框架和部署方案,实现了从模型研发到产业落地的全链路覆盖。 ## 技术定位与核心价值:中文大模型生态的完整解决方案 封神榜项目针对中文NLP领域长期面临的资源匮乏和技术滞

gitblog_01199的博客 465

【场景面试题】二、超大规模人群与数据处理(11~18)

面试中不要只讲 Flink,要讲口径治理与可重现性(比如有一个有效时长的指标,当天的是实时通过flink统计,因为当天的还会不断累计,而过往日期的每天都用离线快照存起来了,因为以往日期的数据不会变了)。分片维护 local top 1000(相当于用1024个分片,每个分片维护前1000名的榜单,用户上榜时进入某一个分片榜单进行排序,这样1024个分片可抗住50万/s的峰值请求),Global Merger 每秒合并 1024 个小榜得到全局 top 100(又是Top K归并排序)。

YouMing_Li的博客 309
上一篇: 半年技术输出的总结,继续前行
下一篇: 程序员修炼之道-注重实效
渡码
博客等级 码龄14年 31粉丝 22原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

红包个数最小为10个

红包金额最低5元

当前余额3.43前往充值 >
需支付:10.00
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值