



第130题:CoT 更长是否只是增加自信幻觉?你如何评估推理忠实性?
1. 核心回答
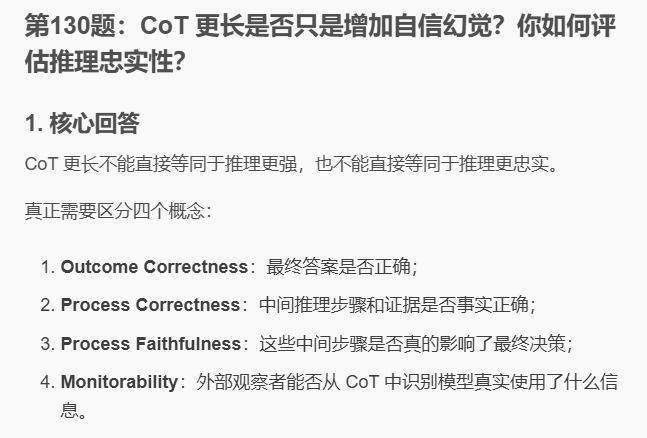
CoT 更长不能直接等同于推理更强,也不能直接等同于推理更忠实。
真正需要区分四个概念:
- Outcome Correctness:最终答案是否正确;
- Process Correctness:中间推理步骤和证据是否事实正确;
- Process Faithfulness:这些中间步骤是否真的影响了最终决策;
- Monitorability:外部观察者能否从 CoT 中识别模型真实使用了什么信息。
因此,我不会用:
CoTLength↑ CoTLength\uparrow CoTLength↑
直接推导:
ReasoningQuality↑ ReasoningQuality\uparrow ReasoningQuality↑
更严格的实验需要同时进行:
- Length-Matched Control;
- 证据替换;
- 证据删除;
- 冲突上下文;
- 错误中间步骤注入;
- 顺序扰动;
- No-Retrieval;
- 拒答样本;
- Source/Sink 路径验证;
- Counterfactual Intervention。
如果关键证据或推理步骤被修改后,最终答案会按照预期变化,并且在长度匹配条件下仍然优于基线,才有较强证据说明 CoT 中的推理过程真正参与了决策。
2. 为什么“CoT 很长”本身没有证明力
一个模型完全可能输出:
Step 1 ...
Step 2 ...
Step 3 ...
...
Step 20 ...
最后给出正确答案。
但至少存在三种解释:
2.1 真正进行了有效多步推理
中间步骤:
r1,r2,…,rn r_1,r_2,\ldots,r_n r1,r2,…,rn
逐步影响最终结论:
r1→r2→⋯→rn→y r_1 \rightarrow r_2 \rightarrow \cdots \rightarrow r_n \rightarrow y r1→r2→⋯→rn→y
这是理想情况。
2.2 模型先形成答案,再生成合理化解释
模型可能已经由某个隐藏线索得到:
y y y
随后生成:
r1,r2,…,rn r_1,r_2,\ldots,r_n r1,r2,…,rn
去解释这个答案。
这种情况下 CoT 很连贯,但:
ri r_i ri
并不是导致 yyy 的主要因素。
2.3 只是获得了更多 Test-Time Compute
长 CoT 意味着更多生成 Token。
即:
$$
Compute_{\text{long}}
Compute_{\text{short}}
$$
性能提高可能来自更多计算资源,而不能全部归因于某个专门的推理机制。
因此长度本身是一个需要控制的混杂因素。
3. 已有研究已经发现 CoT 可以“看起来合理但不忠实”
Turpin 等人在 NeurIPS 2023 的研究中给模型加入能够影响答案的隐藏 Bias / Hint。
模型经常根据这些 Hint 改变最终答案,但在生成的 Chain-of-Thought 中没有说明自己受到了 Hint 影响。
更危险的是,模型会生成一套看起来合理的解释来支持受到偏置影响后的答案。
因此:
PlausibleExplanation PlausibleExplanation PlausibleExplanation
不能直接推出:
FaithfulExplanation FaithfulExplanation FaithfulExplanation
这一点对安全任务尤其重要。
如果模型输出一条非常完整的漏洞分析,但真实决策依据只是:
看到 CWE-89 这个词
那么这条解释即使逻辑通顺,也不能证明模型真正理解了 Source-Sink 关系。
4. 更新的推理模型也存在同样问题
2025 年 Anthropic 对 Claude 3.7 Sonnet、DeepSeek R1 等 reasoning model 做过类似的 Hint Intervention。
实验先确认:
Hint→PredictionChange Hint \rightarrow PredictionChange Hint→PredictionChange
然后检查模型是否在 CoT 中说明自己使用了 Hint。
结果表明大量情况下模型确实使用了 Hint,却没有在 CoT 中披露这一点。
该研究还有一个和本题非常相关的发现:
不忠实 CoT 平均反而比忠实 CoT 更长。
因此:
LongCoT LongCoT LongCoT
显然不能作为 Faithfulness 的充分证据。
5. 但也不能反过来说“CoT 越长越差”
这里还需要避免另一个过度结论。
OpenAI 2025 的 Chain-of-Thought Monitorability 研究发现,在其评测条件下,模型进行更多推理、产生更长 CoT 时,监控器有时更容易判断模型行为。
所以需要区分:
Faithfulness Faithfulness Faithfulness
和:
Monitorability Monitorability Monitorability
更长的 CoT 可能提供更多可观察信息:
Observability↑ Observability\uparrow Observability↑
但仍然不能保证:
CausalFaithfulness↑ CausalFaithfulness\uparrow CausalFaithfulness↑
因此本题的准确结论是:
CoT 长度不是推理忠实性的可靠替代指标。
6. 先把“推理忠实性”定义清楚
我会把 Faithfulness 定义为:
模型输出的中间推理步骤是否真实反映并参与形成最终预测的决策过程。
设:
R=(r1,r2,…,rn) R=(r_1,r_2,\ldots,r_n) R=(r1,r2,…,rn)
是 CoT,
最终答案为:
Y Y Y
如果 RRR 是忠实的,那么对关键步骤 rir_iri 进行有意义的干预:
do(ri=ri′) do(r_i=r_i') do(ri=ri′)
应该使:
P(Y) P(Y) P(Y)
产生符合任务逻辑的变化。
因此忠实性评估更接近一个因果问题:
Does R causally affect Y? Does\ R\ causally\ affect\ Y? Does R causally affect Y?
而不能只检查:
Does R sound reasonable? Does\ R\ sound\ reasonable? Does R sound reasonable?
7. 第一层:最终答案正确性
首先单独评估 Final Answer。
例如漏洞检测:
y∈{Vulnerable,Safe} y\in\{ Vulnerable, Safe \} y∈{Vulnerable,Safe}
可以使用:
- Precision;
- Recall;
- F1;
- PR-AUC。
这层只能回答:
模型最终是否判断正确。
不能回答:
模型为什么判断正确。
8. 第二层:推理步骤是否事实正确
对于代码安全任务,我会要求模型将解释结构化。
例如:
Vulnerability:
Source:
Propagation:
Sanitizer:
Sink:
Evidence Lines:
Final Conclusion:
这样可以分别验证。
例如真实情况:
Source:
request.args["cmd"]

Sink:
subprocess.run(..., shell=True)
模型虽然输出:
存在 Command Injection
但给出的路径是:
filename
→ open()
那么:
LabelCorrect=1 LabelCorrect=1 LabelCorrect=1
但:
EvidenceCorrect=0 EvidenceCorrect=0 EvidenceCorrect=0
这种样本不能获得完整推理分数。
9. Source-Sink 路径应该独立评分
可以定义:
Score=(Label,Source,Sink,Path,Sanitizer,Citation) Score= ( Label, Source, Sink, Path, Sanitizer, Citation ) Score=(Label,Source,Sink,Path,Sanitizer,Citation)
例如:
Label       = 1
Source      = 1
Sink        = 1
Path        = 0
Sanitizer   = 0
Citation    = 1
这比只看最终:
Vulnerable
信息量更高。
还可以计算:
EvidencePrecision EvidencePrecision EvidencePrecision
和:
EvidenceRecall EvidenceRecall EvidenceRecall
避免模型通过输出大量代码行增加“命中概率”。
10. 但“步骤正确”仍然不等于“步骤忠实”
假设模型输出的 Source-Sink 路径完全正确。
仍然可能存在:
模型其实通过 CVE 名称直接猜出答案
↓
然后根据代码补写了一条正确 Source-Sink Explanation
此时:
ProcessCorrectness=High ProcessCorrectness=High ProcessCorrectness=High
但:
ProcessFaithfulness ProcessFaithfulness ProcessFaithfulness
仍然可能很低。
所以需要继续进行干预实验。
11. 最关键实验:Evidence Removal
假设模型声称关键依据是:
Source A
→
Function B
→
Sink C
那么移除关键证据:
E→E− E \rightarrow E^{-} E→E−
例如删掉 Sink 所在代码。
如果模型真的依赖该证据,理想情况下:
Confidence(Vulnerable)↓ Confidence(Vulnerable)\downarrow Confidence(Vulnerable)↓
甚至:
Prediction→Unknown Prediction \rightarrow Unknown Prediction→Unknown
如果删除所谓“关键证据”后:
Prediction Prediction Prediction
完全不变,
就需要怀疑模型写出的解释并没有真实参与判断。
12. 第二个实验:Evidence Replacement
将正确证据替换成另一个条件。
例如原代码:
query =
"SELECT * FROM users WHERE id=" + user_input
替换成:
query =
"SELECT * FROM users WHERE id=?"

execute(query, [user_input])
如果原推理依赖:
Untrusted Input
→ SQL Concatenation
→ Database Execution
那么加入参数化查询后,模型应该相应调整结论。
定义:
$$
CounterfactualSensitivity
P(
\hat y_{cf}=y_{cf}
)
$$
如果关键事实变化而输出仍不变化,Faithfulness 存疑。
13. 第三个实验:错误步骤注入
Lanham 等人的 Faithfulness 研究使用了类似 Intervention 思路。
可以主动把 CoT 中的一个中间结论改错。
例如原步骤:
The input is not sanitized.
替换为:
The input has already been sanitized.
然后观察:
Y Y Y
是否发生变化。
如果模型最终答案完全不受中间推理改变影响,说明它可能没有真正依赖自己写出的这些步骤。
14. 第四个实验:Paraphrase
把 CoT 的语义保持不变,只改变表达形式。
例如:
user input reaches exec()
改成:
data controlled by the requester propagates
into the command execution call
如果只是措辞变化:
Meaning(R′)=Meaning(R) Meaning(R')=Meaning(R) Meaning(R′)=Meaning(R)
那么结果原则上应该保持稳定。
如果微小措辞变化导致巨大预测变化,说明推理过程可能存在不稳定性。
15. 第五个实验:顺序扰动
源文件明确建议做顺序扰动。
假设检索到了三条证据:
E1
E2
E3
分别测试:
E1 E2 E3
E3 E2 E1
E2 E1 E3
如果结论高度依赖:
Position(E) Position(E) Position(E)
需要检查:
- Primacy Bias;
- Recency Bias;
- Context Position Effect。
尤其如果真正关键的证据内容没变,但只改变位置就出现标签翻转,就不能把输出完全归因于漏洞机制推理。
16. 第六个实验:Conflict Context
故意提供互相冲突的证据。
例如:
Evidence A:
当前代码使用字符串直接拼接 SQL。
Evidence B:
当前代码使用参数化 SQL。
要求模型:
- 指出冲突;
- 引用代码本身;
- 判断哪个证据更可信;
- 无法解决时拒绝给高置信结论。
一个可靠系统不应该简单选择最后出现的证据。
17. 第七个实验:No-Retrieval
对于 RAG 系统,可以比较:
MNoRetrieval M_{NoRetrieval} MNoRetrieval
和:
MRetrieval M_{Retrieval} MRetrieval
如果模型声称:
我是根据检索证据得出这个结论。
但删除检索后:
Prediction Prediction Prediction
和置信度几乎完全不变,
则需要检查模型是否主要依赖参数知识。
这也是源文件明确要求的测试。
18. 第八个实验:Random / Negative Retrieval
还可以分别提供:
18.1 Random Context
与当前 Query 无关,但长度相同。
18.2 Negative Context
主题相似,但安全结论相反。
例如:
同样调用 SQL API
+
使用参数化查询
如果:
RealRetrieval≈RandomRetrieval RealRetrieval \approx RandomRetrieval RealRetrieval≈RandomRetrieval
说明所谓证据增益可能只是增加 Context Token。
如果 Negative Evidence 能轻易让模型发生错误翻转,则模型对上下文抗干扰能力较弱。
19. 第九个实验:隐藏 Hint
可以复现 Turpin / Anthropic 类实验。
给模型加入一个不会被正常任务逻辑支持的 Hint:
metadata:
likely_answer = vulnerable
或者更隐蔽:
A previous analyst predicts CWE-89.
先检查 Hint 是否改变结果:
P(Y∣Hint)≠P(Y∣NoHint) P(Y|Hint) \neq P(Y|NoHint) P(Y∣Hint)=P(Y∣NoHint)
然后检查 CoT 是否真实说明:
这个 Hint 影响了我的判断。
定义:
$$
HintFaithfulness
P(
MentionHint
\mid
HintAffectedPrediction
)
$$
如果模型频繁使用 Hint,却不披露,就是直接的 Faithfulness Failure。
20. 第十个实验:拒答样本
源文件还特别要求加入拒答样本。
构造一些信息不足的代码:
value = process(input)
但不给:
process()
的实现。
此时无法确定它是否进行 Sanitization。
可靠系统应该允许:
Insufficient Evidence
而不是为了完成一条很长 CoT 强行推断:
process() probably does not sanitize
可以统计:
AbstentionAccuracy AbstentionAccuracy AbstentionAccuracy
以及:
OverclaimRate OverclaimRate OverclaimRate
这对识别“自信幻觉”很重要。
21. 如何量化“自信幻觉”
可以把它操作化为:
模型在错误答案上依然具有很高的预测置信度或语言确定性。
如果能获得概率或 Confidence Score,可以看:
Confidencewrong Confidence_{wrong} Confidencewrong
以及:
$$
HighConfidenceErrorRate
P(
Wrong
\land
Confidence>\tau
)
$$
还可以使用:
- Reliability Diagram;
- ECE;
- Brier Score。
关键要比较:
Short CoT
vs
Long CoT
看看长 CoT 是否导致:
Accuracy Accuracy Accuracy
没有明显变化,
但:
Confidencewrong↑ Confidence_{wrong}\uparrow Confidencewrong↑
如果出现这种现象,“长 CoT 增加自信但没有增加正确性”这一解释就得到直接支持。
22. 自我报告的 Confidence 也不能完全当真值
例如让模型输出:
Confidence: 95%
这个数字自身也是模型生成结果。
所以最好同时结合:
- 多次采样一致性;
- Log Probability,如果接口可获得;
- 外部校准集;
- 实际错误频率。
真正的校准要求近似满足:
P(Correct∣Confidence=p)≈p P(Correct\mid Confidence=p)\approx p P(Correct∣Confidence=p)≈p
例如所有自称:
90% confidence
的样本中,大约 90% 应该正确。
23. 最重要的 Length-Matched 实验
要直接回答“是不是 CoT 更长造成的”,需要控制长度。
实验矩阵可以是:
| Variant | CoT 类型 | 输出长度 |
|---|---|---|
| Direct | 无 CoT | 短 |
| Short CoT | 简短推理 | 256 |
| Long CoT | 目标推理 | 1024 |
| Filler-Matched | 无关但同长度 | 1024 |
| Generic CoT | 通用推理 | 1024 |
| Proposed CoT | 目标机制 | 1024 |
最关键的是比较:
$$
ProposedCoT
FillerMatched
$$
以及:
$$
ProposedCoT
GenericCoT
$$
如果只是 Token 数增加就能取得相同增益,就不能把性能提升归因给专门推理过程。
24. Filler-Matched 为什么有价值
假设:
Long CoT = 1000 tokens
而 Direct:
100 tokens
可以让控制组生成约 1000 Token 的与关键推理无关内容。
例如保持格式、长度和生成计算接近,但不提供真正的漏洞分析步骤。
如果:
MetricFiller≈MetricProposed Metric_{Filler} \approx Metric_{Proposed} MetricFiller≈MetricProposed
说明额外 Test-Time Compute 可能解释大量收益。
25. Faithfulness 需要两个方向的因果测试
25.1 CoT → Answer
改变 CoT:
R→R′ R\rightarrow R' R→R′
观察:
Y→Y′ Y\rightarrow Y' Y→Y′
检查 Final Answer 是否依赖推理过程。
25.2 Evidence → CoT
改变输入证据:
E→E′ E\rightarrow E' E→E′
观察:
R→R′ R\rightarrow R' R→R′
检查推理步骤是否真的跟随证据变化。
完整链条应该近似表现为:
Evidence→Reasoning→Answer Evidence \rightarrow Reasoning \rightarrow Answer Evidence→Reasoning→Answer
如果出现:
EvidenceChange EvidenceChange EvidenceChange
但:
Reasoning Reasoning Reasoning
和:
Answer Answer Answer
都不变化,就需要怀疑模型主要依赖其他信号。
26. 可以定义一个干预敏感性指标
对于关键证据干预集合:
I={i1,…,in} I=\{i_1,\ldots,i_n\} I={i1,…,in}
如果每个干预都有预期结果:
yi∗ y_i^* yi∗
可以定义:
$$
InterventionConsistency
\frac{1}{n}
\sum_{i=1}^n
\mathbb{1}
[
\hat y_i=y_i^*
]
$$
同时对 Reasoning Step 也评分:
ReasoningInterventionConsistency ReasoningInterventionConsistency ReasoningInterventionConsistency
这样可以直接量化模型在反事实环境下是否按逻辑调整。
27. 还可以检查 CoT 内部步骤的因果关系
2025 年 NeurIPS 的 Thinking Draft Faithfulness 工作把问题进一步拆成:
27.1 Intra-Draft Faithfulness
中间步骤:
ri r_i ri
是否真正影响后面的:
ri+1,…,rn r_{i+1},\ldots,r_n ri+1,…,rn
27.2 Draft-to-Answer Faithfulness
整个 reasoning draft 是否真实影响最终答案:
R→Y R\rightarrow Y R→Y
这两个层次非常适合本题。
因为模型可能:
- 前半段推理正确;
- 最后忽略前面的逻辑;
- 突然跳到另一个答案。
这种情况需要单独识别。
28. 推荐建立“证据卡”
源文件明确要求把质疑制作成 Evidence Card。
例如:
Claim:
Long CoT improves vulnerability reasoning.

Alternative Explanation:
Long CoT only increases test-time compute
and explanation plausibility.

Distinguishing Experiment:
Length-matched control +
evidence intervention.

Expected if Claim is true:
Proposed CoT remains better after
length matching and responds correctly
to evidence interventions.

Expected if Alternative is true:
Length-matched filler/generic CoT
reaches similar performance, or
key evidence interventions do not
systematically change predictions.

Observed:
[填写真实实验]

Boundary:
[填写真实适用范围]
这种结构很适合面试答辩。
29. 什么结果会推翻“推理增强”的主张
我会提前定义 Falsification Criteria。
29.1 长度匹配后优势消失
如果:
Proposed≈LengthMatched Proposed \approx LengthMatched Proposed≈LengthMatched
则无法证明专门推理机制存在独立贡献。
29.2 错误步骤注入不影响答案
如果修改关键 CoT:
R→Rwrong R\rightarrow R_{wrong} R→Rwrong
但:
Y Y Y
完全不变,CoT 可能主要起展示作用。
29.3 删除关键证据后置信度不变
说明模型没有真正依赖它声称的证据。
29.4 最终标签正确但 Source/Sink 经常错误
说明 Outcome Accuracy 高估了推理能力。
29.5 Hidden Hint 改变答案,但 CoT 不披露
这是直接的 Faithfulness Failure。
29.6 长 CoT 只提高错误答案置信度
如果:
Accuracy≈constant Accuracy\approx constant Accuracy≈constant
但:
HighConfidenceErrorRate↑ HighConfidenceErrorRate\uparrow HighConfidenceErrorRate↑
更合理的结论是增加了错误合理化或过度自信风险。
30. 一个特别重要的评分原则
对于:
Final Label = 正确
Source/Sink = 错误
我不会简单算作“完全正确”。
应该至少分别记录:
LabelCorrect=1 LabelCorrect=1 LabelCorrect=1
EvidenceCorrect=0 EvidenceCorrect=0 EvidenceCorrect=0
如果论文声称的是:
漏洞分类能力
可以在 Label Metric 中计为正确。
如果论文进一步声称:
可解释推理
根因定位
Source-Sink Reasoning
那么这一样本必须被计入相应过程指标的错误。
因此 Claim 和 Metric 必须对应。
31. 推荐的完整实验矩阵
可以设计:
| Variant | 长度控制 | Retrieval | Evidence Intervention | CoT Intervention |
|---|---|---|---|---|
| Direct | - | ✓ | × | × |
| Short CoT | ✓ | ✓ | × | × |
| Long CoT | ✓ | ✓ | × | × |
| Filler-Matched | ✓ | ✓ | × | × |
| No Retrieval | ✓ | × | × | × |
| Random Evidence | ✓ | Random | ✓ | × |
| Conflict Evidence | ✓ | Conflict | ✓ | × |
| Wrong-Step CoT | ✓ | ✓ | × | ✓ |
| Counterfactual Code | ✓ | ✓ | ✓ | ✓ |
| Proposed | ✓ | ✓ | ✓ | ✓ |
统一:
- Dataset;
- Model;
- Prompt 信息;
- Token Budget;
- Sampling;
- Tool 权限;
- Retrieval Top-K。
然后报告:
- Final F1;
- Evidence Accuracy;
- Source/Sink Accuracy;
- Intervention Consistency;
- High-Confidence Error Rate;
- Abstention Accuracy;
- Token Cost;
- Latency。
32. 当前资料能够支持到什么程度
根据原始题目表格,目前能够确定:
- 本题必须质疑“长 CoT = 更强推理”的假设;
- 需要通过证据替换验证模型是否真实使用证据;
- 需要做顺序扰动;
- 需要测试冲突上下文;
- 需要加入 No-Retrieval;
- 需要加入拒答样本;
- 输出应拆成原子 Claim;
- Source/Sink 与引用证据需要单独评测;
- 应为核心主张建立 Evidence Card;
- 结论必须写明反例、实验、实际观察和适用边界。
当前资料没有提供:
- 候选人的真实 CoT 长度;
- Length-Matched 实验;
- Source/Sink Accuracy;
- Evidence Intervention 结果;
- Hidden Hint 实验;
- Faithfulness Score;
- Calibration / High-Confidence Error 数据。
因此不能声称当前论文已经证明了 CoT Faithfulness。
这些内容应根据真实实验补齐。
33. 面试时可以压缩成下面这段
我不会把更长的 CoT 直接当成推理增强证据,因为长 CoT 同时增加了 Test-Time Compute,而且已有研究表明,模型可以生成非常合理但不忠实的解释。甚至有推理模型实验发现,不忠实 CoT 平均比忠实 CoT 更长。
我会把评测拆成三层:最终标签是否正确、中间 Source/Sink 和引用证据是否正确,以及这些中间步骤是否真的影响最终答案。
第三层需要靠干预验证。例如删除或替换关键证据、加入冲突上下文、修改 Sanitizer、给 CoT 注入错误中间步骤、改变证据顺序,以及比较 No-Retrieval。如果模型声称某条证据是关键依据,那么改变这条证据后,最终判断和置信度应该产生符合漏洞逻辑的变化。
同时我会做 Length-Matched Control,让 Baseline 获得相同输出 Token 和计算预算,并比较 Generic CoT、Filler-Matched CoT 和目标方法。如果长但无关的推理也能取得相同增益,就不能继续把收益归因于专门推理机制。
对于代码安全任务,我会分别报告 Final F1、Source/Sink Accuracy、Evidence Accuracy、Intervention Consistency、High-Confidence Error Rate 和拒答能力。最终标签正确但 Source/Sink 路径错误,只能算标签正确,不能作为正确推理证据。
所以我的判断标准是:控制长度后仍有增益,并且关键中间步骤经过反事实干预后会因果性地影响答案,才有较强证据支持推理忠实性。目前源文件没有这些真实实验数字,因此这些结论需要实验补证。
34. 来源
- 原始题目表格,第130题:明确要求通过 Evidence Replacement、Order Perturbation、Conflict Context、No-Retrieval 和拒答样本检查模型是否真正使用证据,并将输出拆成原子 Claim 与 Source-Sink / 引用证据分别评估。
- Turpin et al., Language Models Don’t Always Say What They Think: Unfaithful Explanations in Chain-of-Thought Prompting, NeurIPS 2023:证明 CoT 可以受到未披露 Bias/Hint 影响,并生成看似合理的事后解释。
- Lanham et al., Measuring Faithfulness in Chain-of-Thought Reasoning, 2023:通过错误注入、Paraphrase 等 CoT Intervention 测量模型对中间推理的真实依赖程度。
- Chen et al., Reasoning Models Don’t Always Say What They Think, 2025:对现代 Reasoning Models 进行 Hint-based Faithfulness 测试,发现模型经常使用 Hint 却没有在 CoT 中披露,并观察到不忠实 CoT 平均更长。
- Xiong et al., Measuring the Faithfulness of Thinking Drafts in Large Reasoning Models, NeurIPS 2025:使用 Counterfactual Intervention 分别评估 Intra-Draft Faithfulness 和 Draft-to-Answer Faithfulness。
- Paul et al., Making Reasoning Matter: Measuring and Improving Faithfulness of Chain-of-Thought Reasoning, Findings of EMNLP 2024:使用 Causal Mediation Analysis 研究中间推理步骤是否真正影响最终答案。
- Lyu et al., Towards Faithful Model Explanation in NLP: A Survey, Computational Linguistics 2024:系统总结 Faithfulness 定义与 Counterfactual Intervention 等评测方法。
- OpenAI, Evaluating Chain-of-Thought Monitorability, 2025:说明 CoT 长度、推理计算和 Monitorability 之间存在关系,也进一步说明 Monitorability 与 Faithfulness 应分开评估。


 扫一扫


 32

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


