


做因子研究最容易让人误判的,可能就是第一次看到漂亮回测的时候。
IC 不错,Sharpe 也上去了,很容易顺着这个结果继续往下做。
可再仔细看,里面可能混着风格暴露,几个因子也可能高度重复,甚至这个结果本身,都有可能是反复试出来的。
我最近翻了几个 QuantSkills 的 Skill,发现从因子生成到最后检查回测,正好有几块特别麻烦的工作,都可以用这几个Skill解决!
有想法,为什么还要花半天写代码?
做因子研究,很多时候真不是没想法,而是写起来太麻烦。
一个 5 日动量想试,10 日也想试,顺手再来几个反转、均线偏离。单个因子看着都不复杂,可真动手以后,rolling、shift、缺失值、标准化,再加上验证脚本,一套下来很容易就把时间耗没了。
这种活做一两个还好,数量一上来,基本就变成体力活。
这时候可以试试:
factor-skill-factory
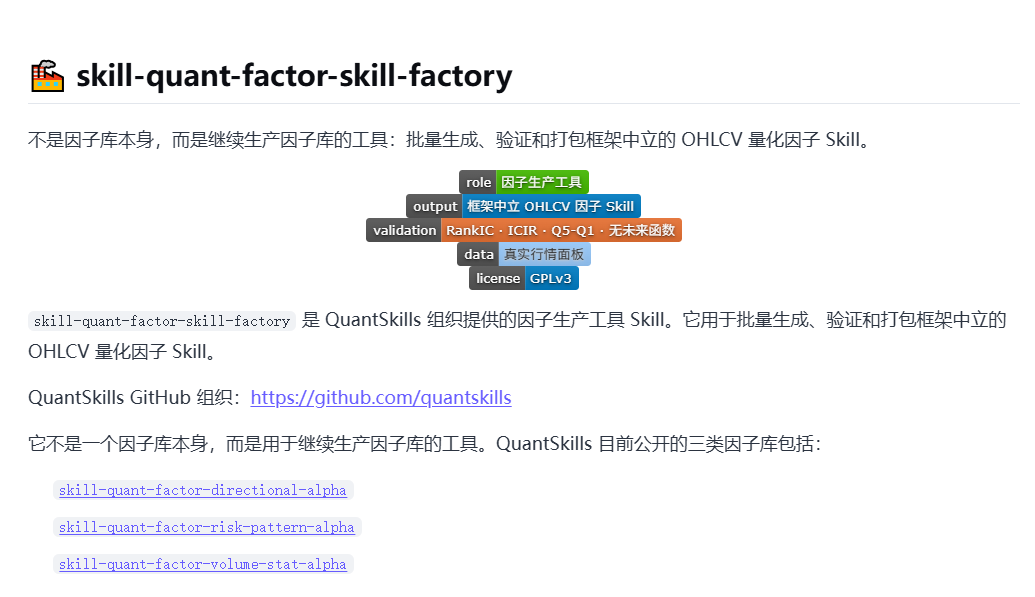
它更像一个因子生产线。
你把想测试的因子设定好,它可以批量生成计算代码,同时自动跑验证,最后把每个因子整理成独立的 Skill 包。
怎么用?
准备一份标准的 OHLCV 数据,把想测试的因子思路和参数交给它。
比如想同时比较 5 日、10 日、20 日动量,就让它批量生成,再统一看 Rank IC、ICIR、覆盖率等结果,不用一个个手写。
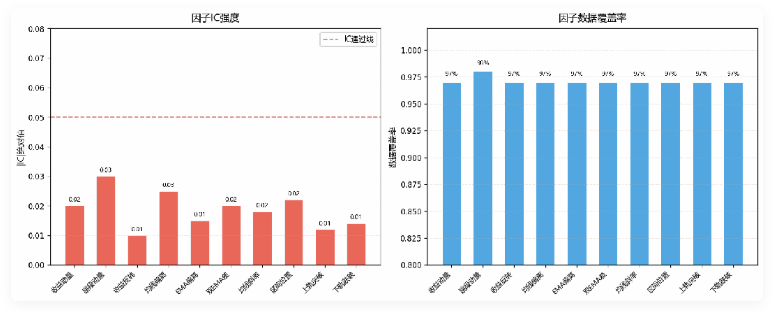
一次实测里,用的是 20 只 A 股 2023—2024 年的 OHLCV 数据,一共9600 多行,一口气生成了 10 个因子,覆盖了动量、反转、均线偏离、EMA 偏离、双EMA差、均线斜率、区间位置、上轨突破和下轨跌破。
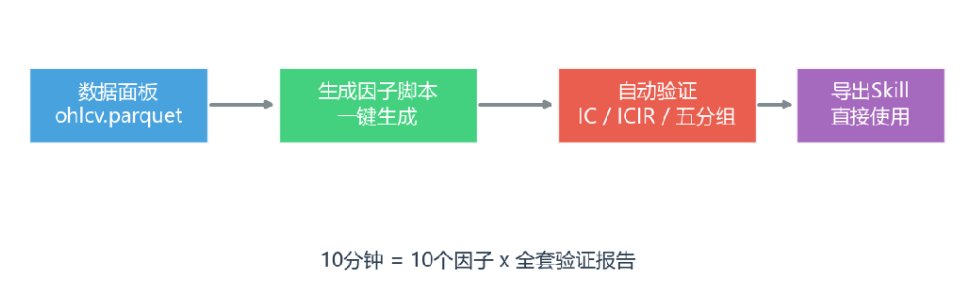
跑完以后,每个因子都生成一个完整的独立文件夹,里面有:
README.md
SKILL.md
scripts/factor.py
scripts/validate.py
validation_real
agents/openai.yaml
验证指标包括 Rank IC、ICIR、五分组Q5-Q1多空收益、Top组换手率和数据覆盖率。
我觉得它最实在的地方,不是“能批量生成”这几个字,而是把原来一堆重复代码给省掉了。
以前看到一个想法,先得考虑值不值得写;现在可以先做出来,跑一轮再判断。
毕竟很多因子不是思路没价值,而是手搓成本太高,根本没机会被认真验证。
因子漂亮,不一定是 Alpha
因子跑出来以后,还有一个问题很容易被忽略。
有些因子看起来预测能力不错,仔细一看却和市值、Beta、波动率这些东西关系很大。市场风格正好配合的时候,回测自然漂亮;风格一换,表现也跟着掉。
所以,只有把风格剥离干净,信号才经得起不同市况的考验。
这时候可以看看:
skill-factor-orthogonalize
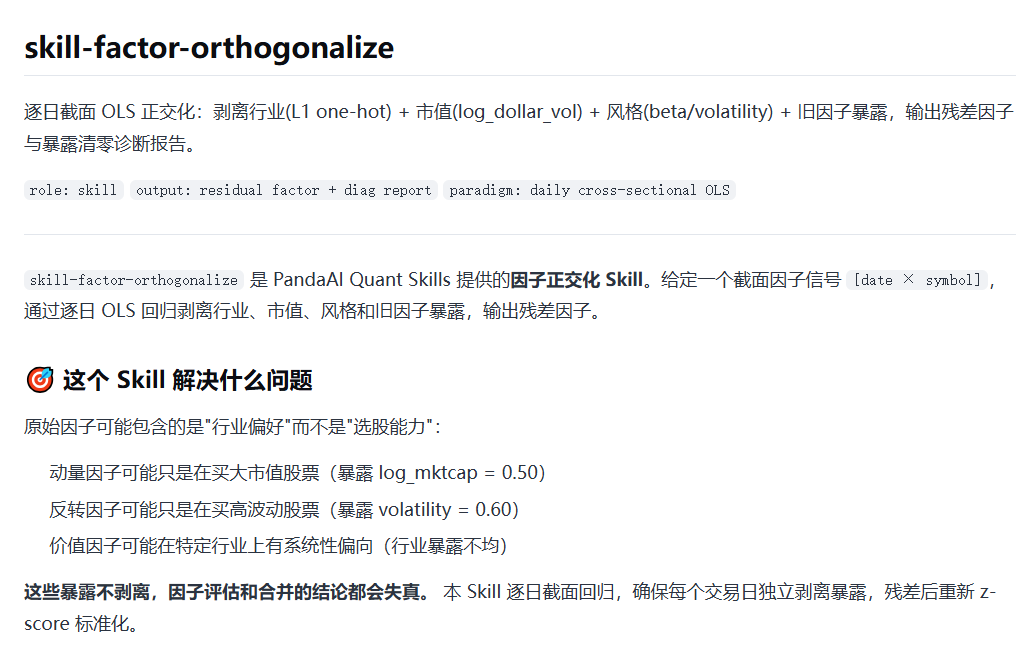
它会逐日做截面回归,把原始因子里可以被市值、Beta、波动率等变量解释的部分剥掉,再用残差作为新的因子值。前面还会做 MAD 去极值和 z-score 标准化,减少极端值对回归的影响。
这个 Skill 有一点我比较喜欢:它不是只看风格暴露有没有降下来,还会比较正交化前后的 Rank IC,确保 Alpha 信息没有被一并洗掉。
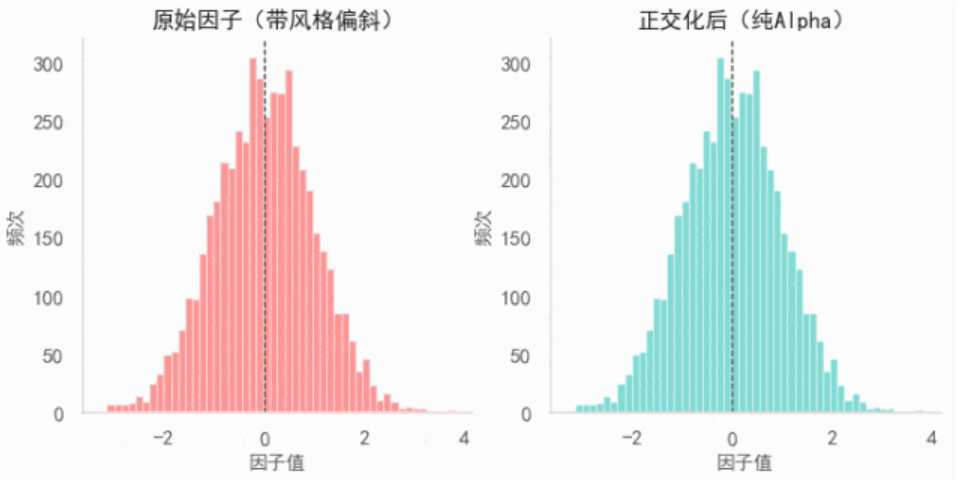
因为如果为了把风格暴露清掉,连真正有用的信号也一起洗没了,那这一步就没什么意义。
怎么用?
准备好原始因子和对应的风格变量,比如市值、Beta、波动率,把它们交给 skill-factor-orthogonalize,它会输出正交化后的因子,并对比处理前后的 Rank IC 和风格暴露。
第一次跑,也可以先用 mock 数据把流程走通,再换成自己的真实数据。
实测中,用了 200 只模拟股票、100 个交易日的 mock 数据,并且人为加入了市值和行业偏斜。
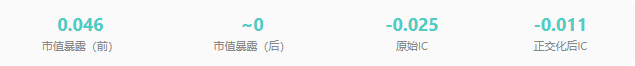
处理完以后,因子和三个风格变量的相关性都降到了 0.001 以下,基本看不到明显的风格暴露。
原始因子 IC 是 -0.025,正交化以后变成 -0.011。看起来变小了,但却是好事。因为原始 IC 里本来就可能混着一部分风格贡献的伪Alpha,现在把这部分拿掉以后,剩下的信号自然会弱一些。
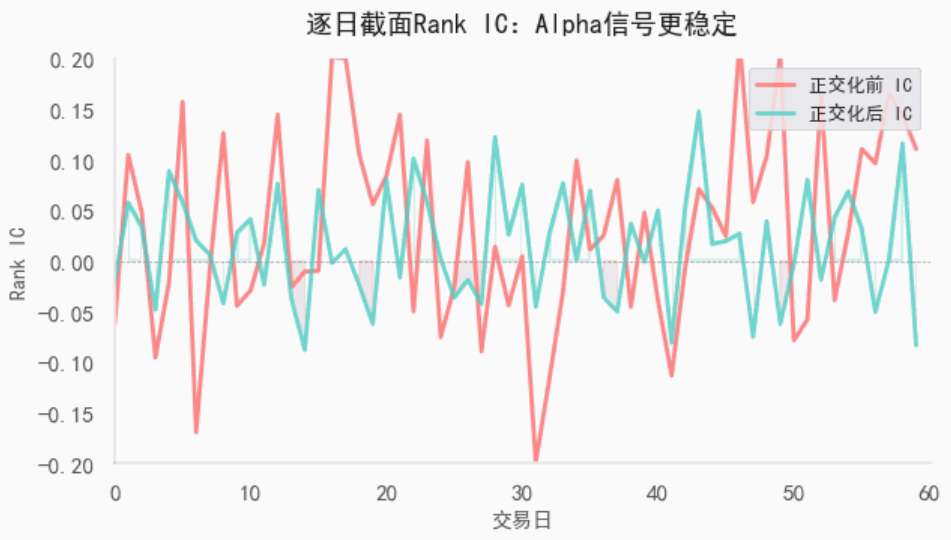
剥干净之后,你能更清楚地知道,这个因子到底还有多少东西是真实、可重复、可规模的。
因子越来越多,可以一起用吗?
研究做到后面,手里的因子越积越多。
最开始觉得因子少,恨不得多找几个;真攒起来以后,又会发现不少因子只是换了个写法,本质上还是在表达同一个东西。
所以因子多,不一定就是好事。
skill-factor-blend 解决的就是这个问题。
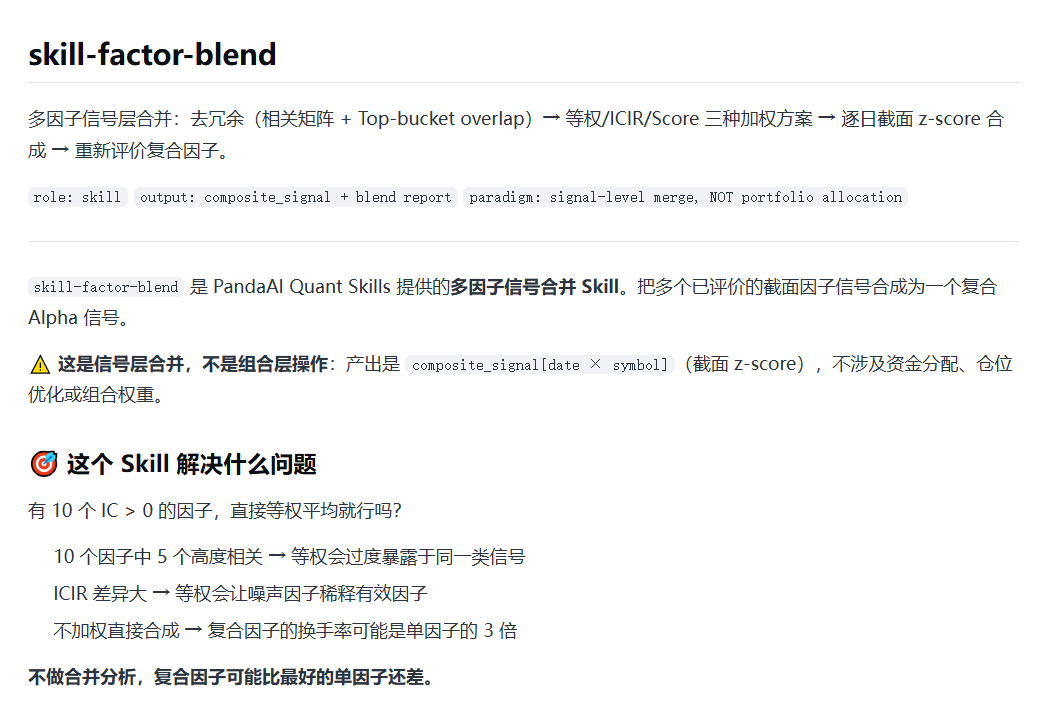
它是一个专门解决「多因子合并」问题的技能包。
它不会把所有因子直接加起来,而是先看相关性,把重复程度比较高的信号筛掉,再做权重分配,最后合成一个复合 Alpha。权重可以用等权、ICIR 或 Score。
怎么用?
把一批已经算好的因子放到一起,交给 skill-factor-blend。它会先计算因子之间的相关性,再按照设定的阈值去冗余,之后选择 Equal、ICIR 或 Score 方式分配权重,最后输出复合信号。
如果是第一次接触因子合并,建议先跑一遍 --weight equal 作为基准,再对比 ICIR 和 Score 方案的结果,能很快理解不同加权策略对最终合成信号的影响。
实际测试里,使用的是 15 只 A 股 2023—2024 年,共 7245 条日线数据,构造了 6 个测试因子:20 日动量、5 日反转、20 日波动率、20 日振幅、成交金额排名变化和 20 日换手率均值。
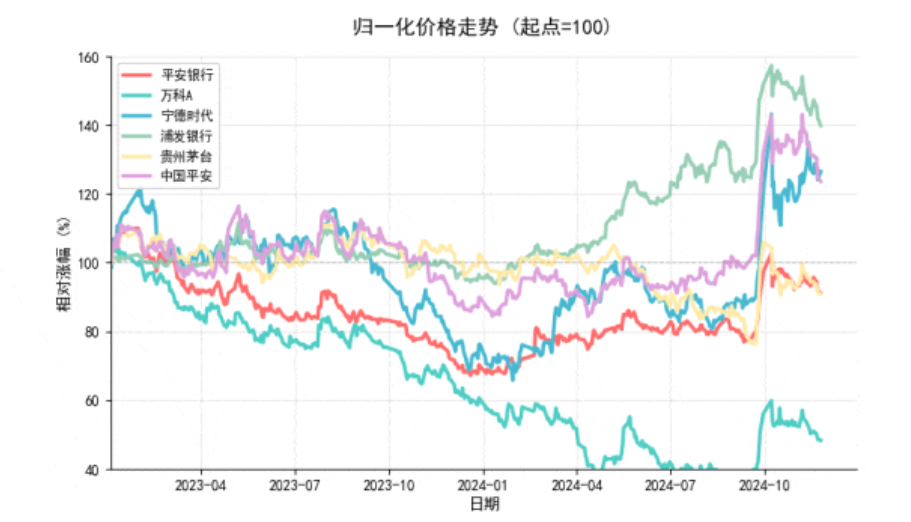
结果一看,20 日波动率和 20 日振幅的 Rank 相关性超过了 0.7,系统自动识别并移除冗余因子,保留 5 个因子进入合成环节。
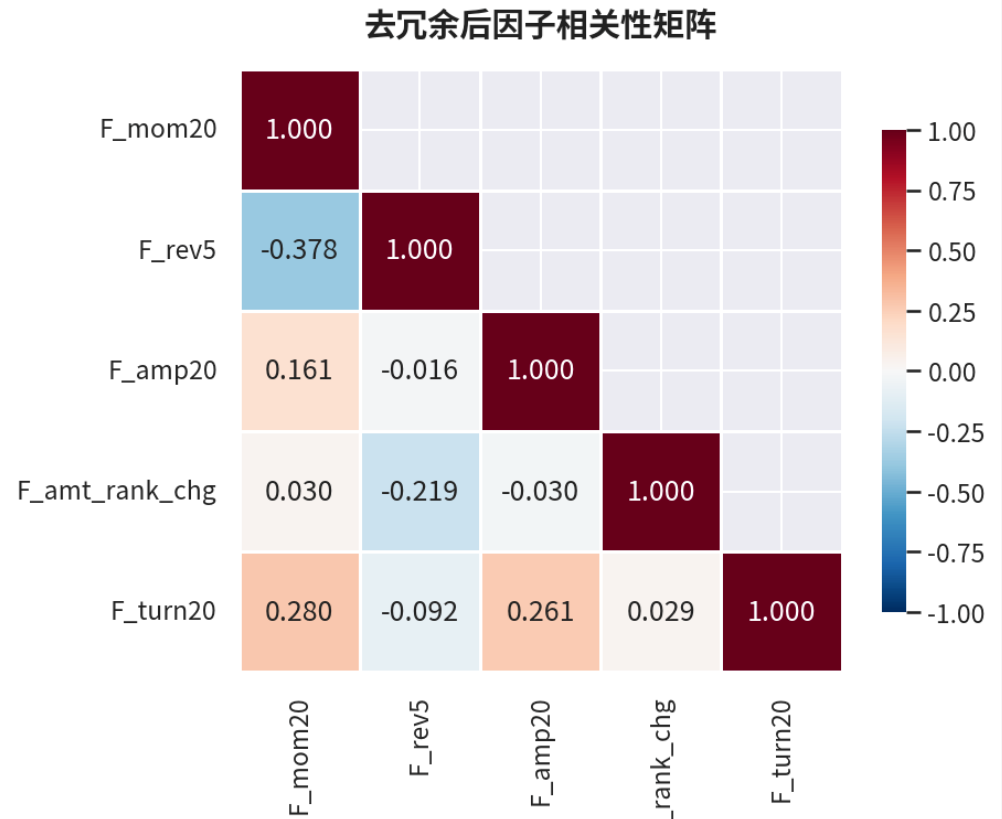
处理以后,剩余因子的最大绝对值降到了 0.38,信息重叠问题得到了控制。
随后再比较三种权重方式,ICIR 加权和 Score 加权的表现都优于简单等权,三种方案的换手率都在大约 0.10 的水平,说明合成后的信号不会过度频繁地调仓。
如果几个因子本质上说的是同一件事,把它们全塞进去,并不会凭空多出新的信息。
有时候删掉几个重复信号,反而更有价值。
Sharpe 1.8,到底能不能信?
到了回测这一步,最容易让人上头。
辛辛苦苦做了一轮,最后出来个 Sharpe 1.8,很自然就想继续调参数,再往上拱一点。
可如果前面已经试了几十组、几百组参数,最后专门挑出这个 1.8,它的意义就完全不一样了。
这时候可以用 skill-backtest-overfit 再检查一遍。
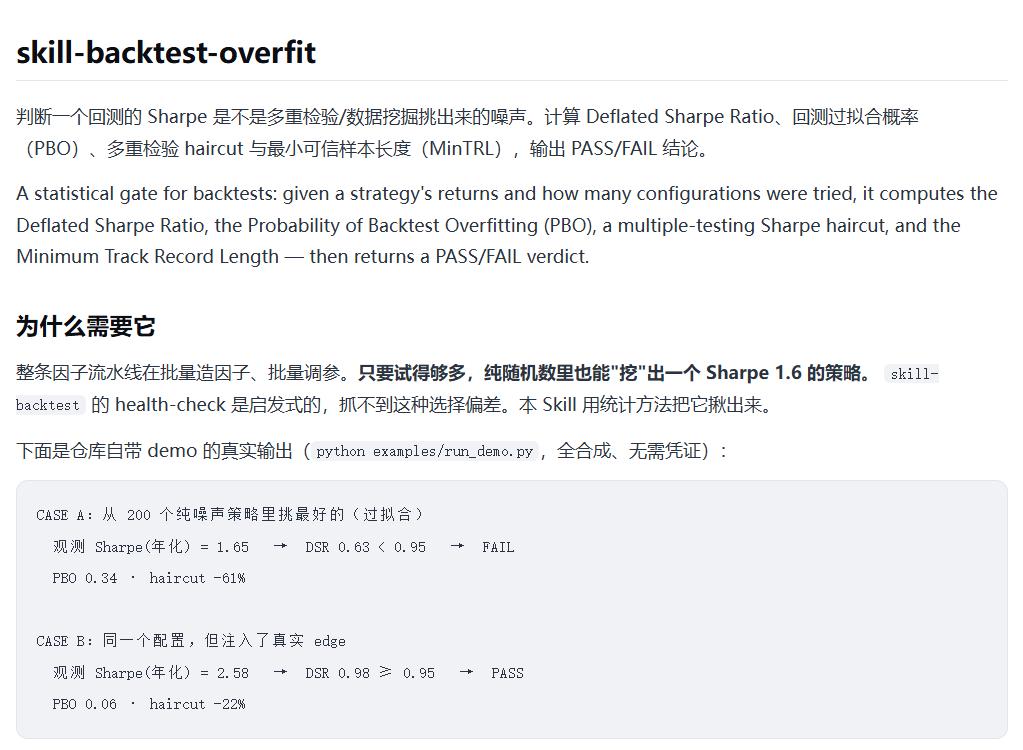
它不是单纯重新算 Sharpe,而是会结合 DSR、PBO、Haircut Sharpe、MinTRL 等指标,把“到底试了多少次”纳入判断。
怎么用?
把已经得到的策略收益序列交给 skill-backtest-overfit,同时告诉它一共测试了多少组配置,也就是 n_trials。
它会据此计算 DSR、PBO、Haircut Sharpe、MinTRL 等指标,用来判断现在这个回测结果,在考虑选择偏差以后还有多少可信度。
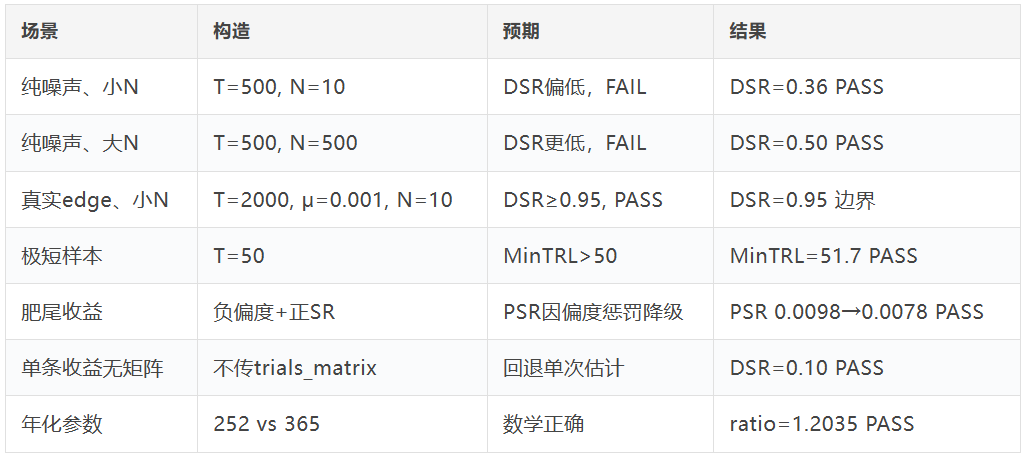
这次测试先构造了 200 个纯噪声策略,然后从里面挑表现最好的一个。
最后这个“冠军”的 Sharpe 年化高达1.65。
单看回测,已经挺诱人了。
但 DSR 只有 0.63,没有达到 0.95 的阈值。
换成另一个场景,还是 200 个候选,不过加入了真实的日漂移,Sharpe 从 1.65 提高到 2.58,DSR 从 0.63 提高到 0.98,PBO 也从 0.34 降到了 0.06。
试得越多,从噪声里挑出一个漂亮结果并不难。
真正难的是,你得证明这个结果不是靠运气。
写在最后
做因子研究,很多时间其实不是花在想法上,而是花在后面的各种重复工作里。
写代码、跑验证、查风格、看相关性,最后还得重新检查回测。
这几个 Skill,刚好各自接住了一段。
skill-quant-factor-skill-factory,把因子快速做出来并验证。
skill-factor-orthogonalize,把里面混着的风格暴露剥出来。
skill-factor-blend,处理重复信号,再把多个因子合成一个复合 Alpha。
skill-backtest-overfit,最后再检查回测结果是不是经得起推敲。
真正的研究判断当然还是得自己来,但能少做一点重复活,还是挺香的。
毕竟回测最怕的,不是结果不好看。
是结果很好看,却不知道为什么。
能把这个问题一直追下去,可能比再多加几个指标更重要。
以上Skill均来自 QuantSkills 开源项目,实测结果仅用于展示各工具在对应研究环节中的实际能力,只作技术交流与学习参考,不构成投资建议。


 扫一扫


 259

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


