


前言❤️❤️
hello hello💕,这里是洋不写bug~😄,欢迎大家点赞👍👍,关注😍😍,收藏🌹🌹
上篇博客中解析了集合类Map和Set的使用方法,Map的实现类有TreeMap和HashMap,Set的实现类有TreeSet和HashSet,TreeMap和TreeSet的的底层实现就是二叉搜索树,这篇博客就会解析二叉搜索树和概念,以及如何实现二叉搜素树
二叉搜索树属于是一种特殊的二叉树,严格来说是要放到二叉树部分的,之所以放到Map&Set部分来解析,是因为在数据结构基础中,只有Map和Set的底层实现这里会用到二叉搜索树🐵(欢迎想复习二叉树的铁汁来访问该专栏前面的二叉树博客)
这个专栏的数据结构是代码都是用Java来写的,JavaSE专栏现在已经全部更新完成,铁汁们复习基础知识时非常推荐使用,可以试一下💪💪💪
🎇个人主页:洋不写bug的博客
🎇所属专栏:数据结构专栏
🎇复习Java基础知识:Java学习之旅,从入门到进阶
🎇铁汁们对于数据结构基础的各种核心知识(不太常用的也有😆),都可以在上面的数据结构专栏学习,专栏正在持续更新中🐵🐵,有问题可以写在评论区或者私信我哦~
1,二叉搜索树简介
二叉搜索树的英文是binarySearchTree,每个首字母的简写就是BST
最大度为2的树就是二叉树,二叉搜索树在这个的基础上,还有两个要求
- 如果左子树不为空,那么左子树的所有的key都应小于根节点的key
- 如果右子树不为空,那么右子树的所有的key都应大于根节点的key
二叉搜索树跟堆都是特殊的二叉树,也都有“大小关系”的要求:
- 二叉搜索树存在左右关系的要求:左 < 根 < 右
- 堆存在上下关系的要求:父节点 < 子节点
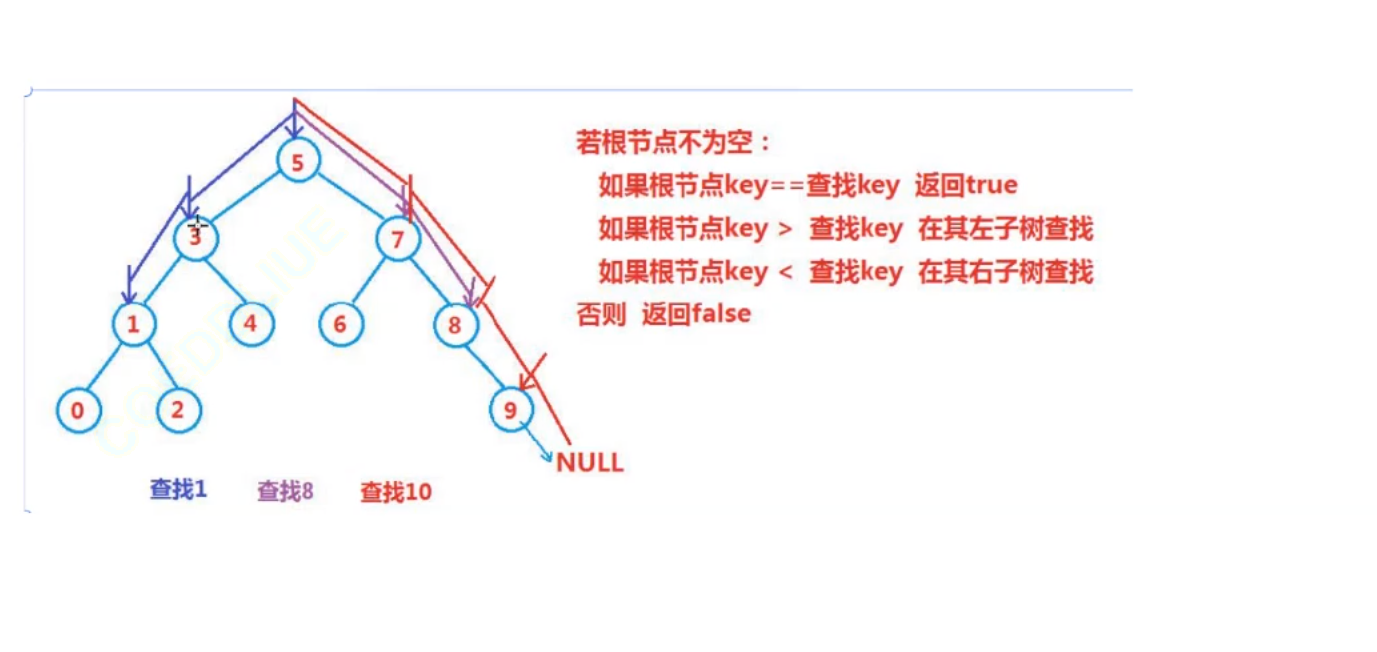
在二叉搜索树中对数据的查找,其实是类似于二分查找的
如下图,例如查找1,先判断要查找的元素比根节点小还是大;如果比根节点小,到左子树查找,再比较与左子树的根节点3的大小,仍然比3小,就到3的左子树去找,然后就找到了。
二叉搜索树中插入数据也是类似的道理拿一个数据,跟根结点比大小,如果比根结点大就往左子树中插入,比根结点小就往左子树中插入,比根结点大就往右子树中插入,接着再和左子树的根结点或者右子树的根结点比较大小,依次类推
因此,左子树中的元素都小于根结点,右子树中的所有元素都大于根结点,标准定义的二叉搜索树中默认不允许重复值
在数组的二分查找中,分出来的两个部分,都是均匀的,但是对于二叉搜索树来说,就不一定了,比较的次数是跟树的高度相关的。
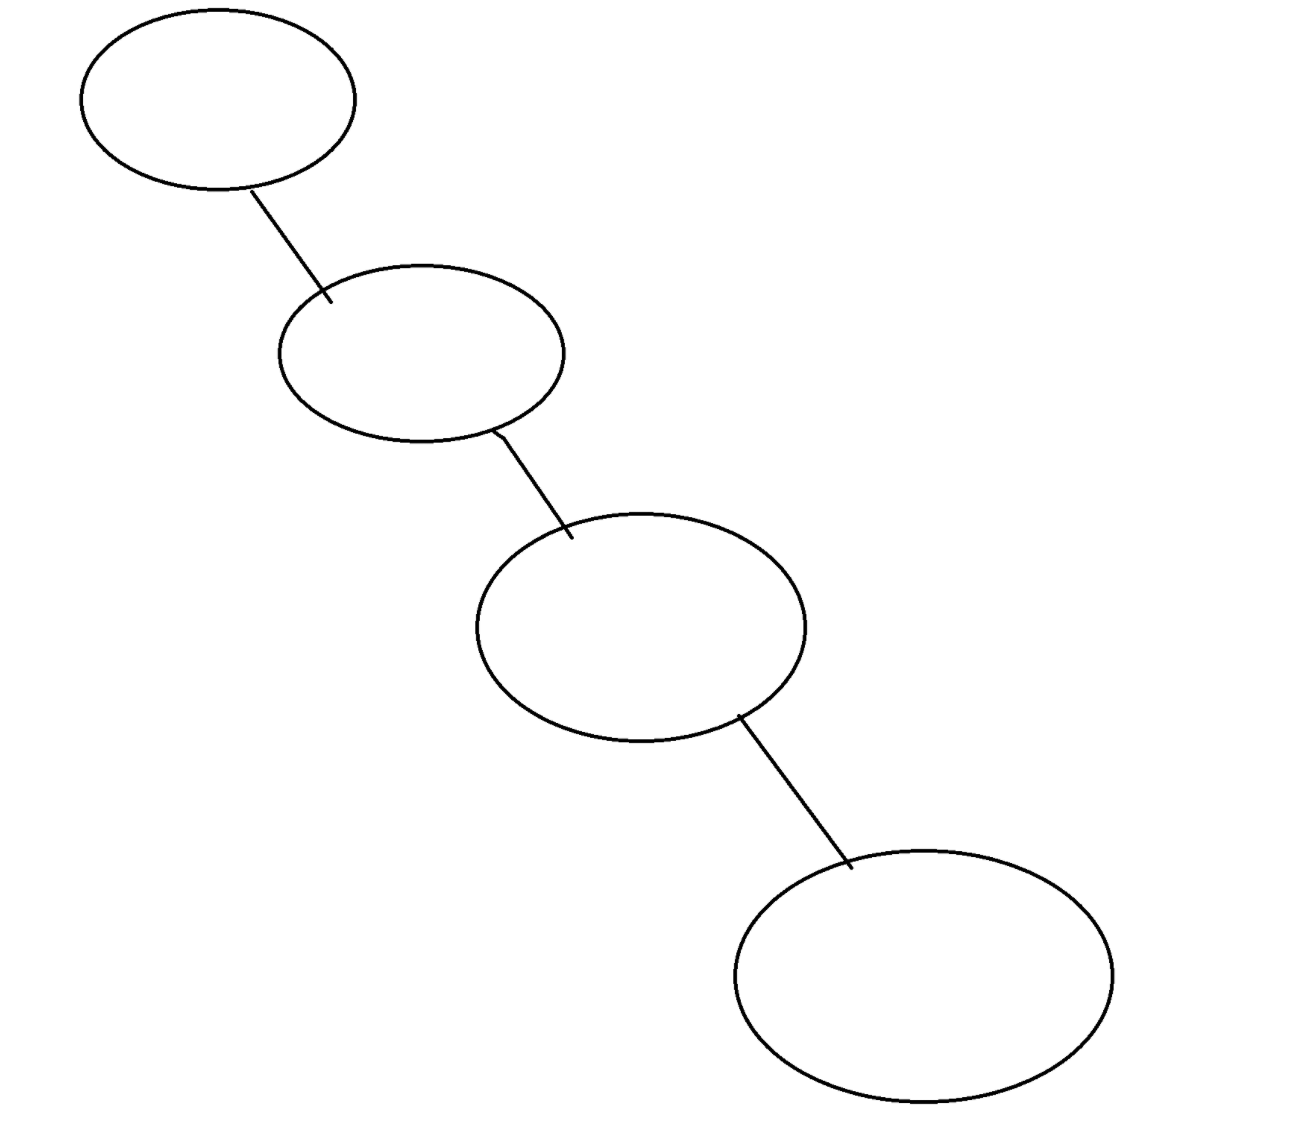
一个二叉树有N个节点,如果左右高度比较均衡,那么高度就是logN,如果出现极端的情况,比如单枝树的情况,那么高度就变成N了,那么这时候的查找,就跟普通链表的遍历差不多,时间复杂度就是O(N)了。
二叉搜索树的时间复杂度
最坏:O(N)
理想:O(logN)
针对平衡的二叉搜索树来说,时间复杂度就是O(logN)
还有两种平衡度比较强的二叉搜索树,就是AVL树和红黑树
-
AVL树要求严格的平衡,代码并不是特别复杂,但是这种树的实用性很低,虽然查找的时候时间复杂度会比较理想,但是一旦删除插入元素,这个树的平衡就会被打破,就需要调整,频繁的调整,也是会影响效率的。
-
红黑树的实用价值比较高,它的要求比较均衡,但是代码实现特复杂,即使是简单的删除,也要考虑5种不同的情况。
这两种树属于数据结构部分进阶的内容,在面试还有工作中的实用是没有数据结构基础部分性价比高,但是肯定也是有用的,JavaSE、数据结构基础
、JavaEE、数据库等都学习完的铁汁,有时间可以学习下这些进阶数据结构,后面博主大概会出个进阶数据结构的专栏🐵🐵🐵
2,元素删除分析
删除元素,是二叉搜索树中比较复杂的一件事情了,首先需要找到要删除节点所在的位置,同时也要记录该节点的父节点的位置,也需要考虑各种各样的情况,需要铁汁们细品,这里就先来单独解析下元素删除操作
为什么要额外记录父节点的位置呢?
因为在学校或者面试中普遍使用的是孩子表示法,就是可以通过一个节点找出它的子节点,但是没法找出它的父节点,因此这里要额外的去记录父节点的位置。
把要删除的元素称为cur,cur的父节点称为parent,那cur的位置有四种情况:
- cur没有左右子树
- cur只有左子树
- cur只有右子树
- cur左右子树都有
接下来会结合代码来解析这四种情况分别要怎么处理:
①:cur没有子树:
这是最简单的一种情况,因为cur没有子树,直接删除掉cur即可,修改cur的父节点parent的left或者right的指向,这时候没有引用指向cur,cur就会被自动删除
 //1,cur没有子树
        if(cur.right == null && cur.left == null){
            //1.1,如果cur就是root,就需要对root进行调整
            if(cur == root){
                //这时候整个树只有一个root节点,把root删除后,相当于树就成了空树
                root = null;
                return;
            }

            //1.2  cur不是root,同时cur是parent的左子树
             if(cur == parent.left){
                 //这时候直接删除cur即可
                parent.left = null;
                return;
            }

             //1.3 cur不是root,同时是parent的右子树
            if(cur == parent.right){
                parent.right = null;
                return;
            }
            //这里我们最后还是加个return,虽然理论上来说是不会走到这里的,但是为了稳妥还是加个。
            return;
        }
②:cur只有左子树,没有右子树
这里同样也分三种情况:
- cur是根节点,要删除cur,那么cur的左子树的第一个节点就变成了根节点(这个比较好理解,就不画图了)
- cur是parent的左子树,要删除cur,让parent.left等于cur.left即可,如图一,要删除这个元素4,那么把5的左子树连上2就可以了
- cur是parent的右子树,要删除cur,把parent.right改为cur.left即可,如图2,要删除7,把5的右子树连上6即可
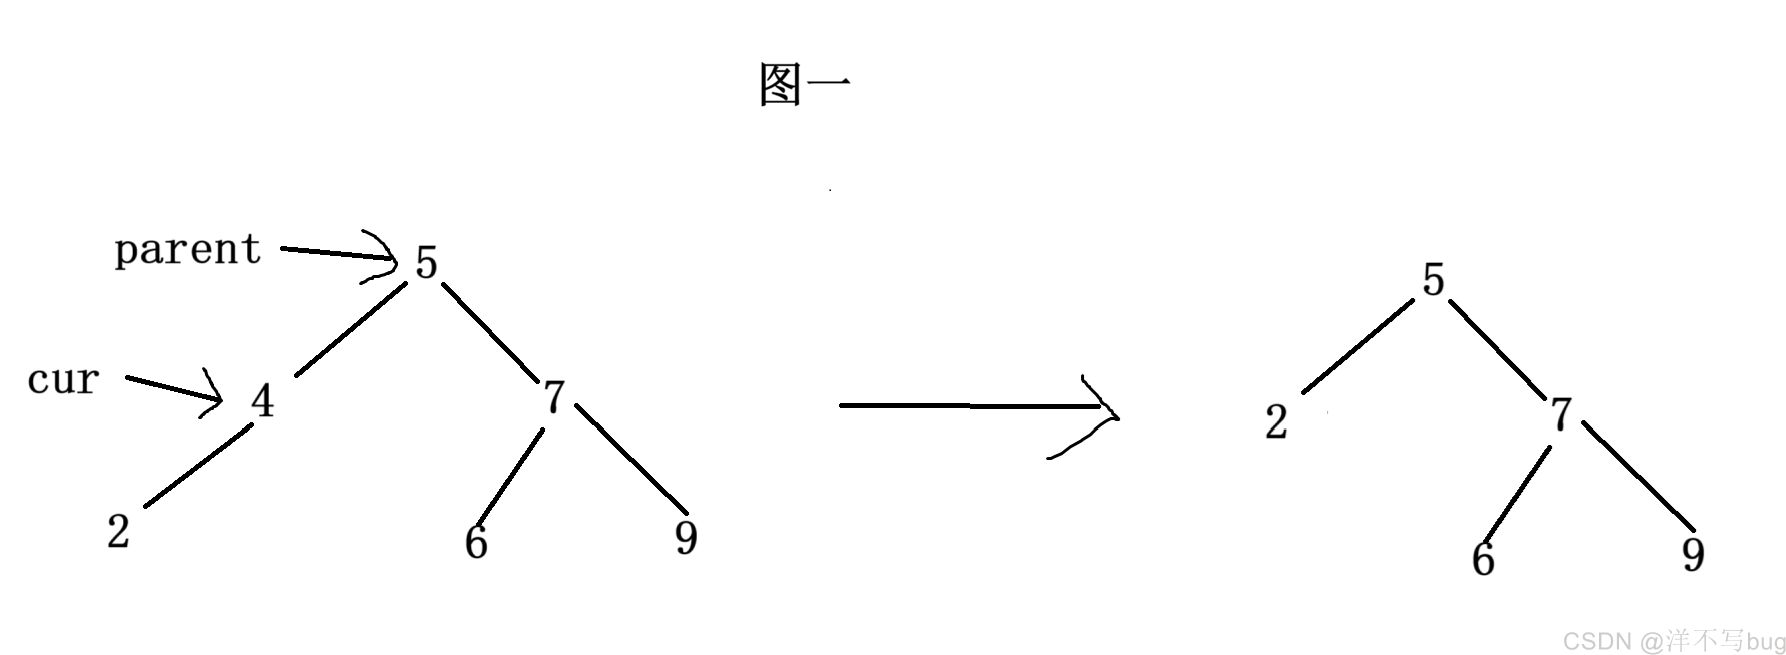
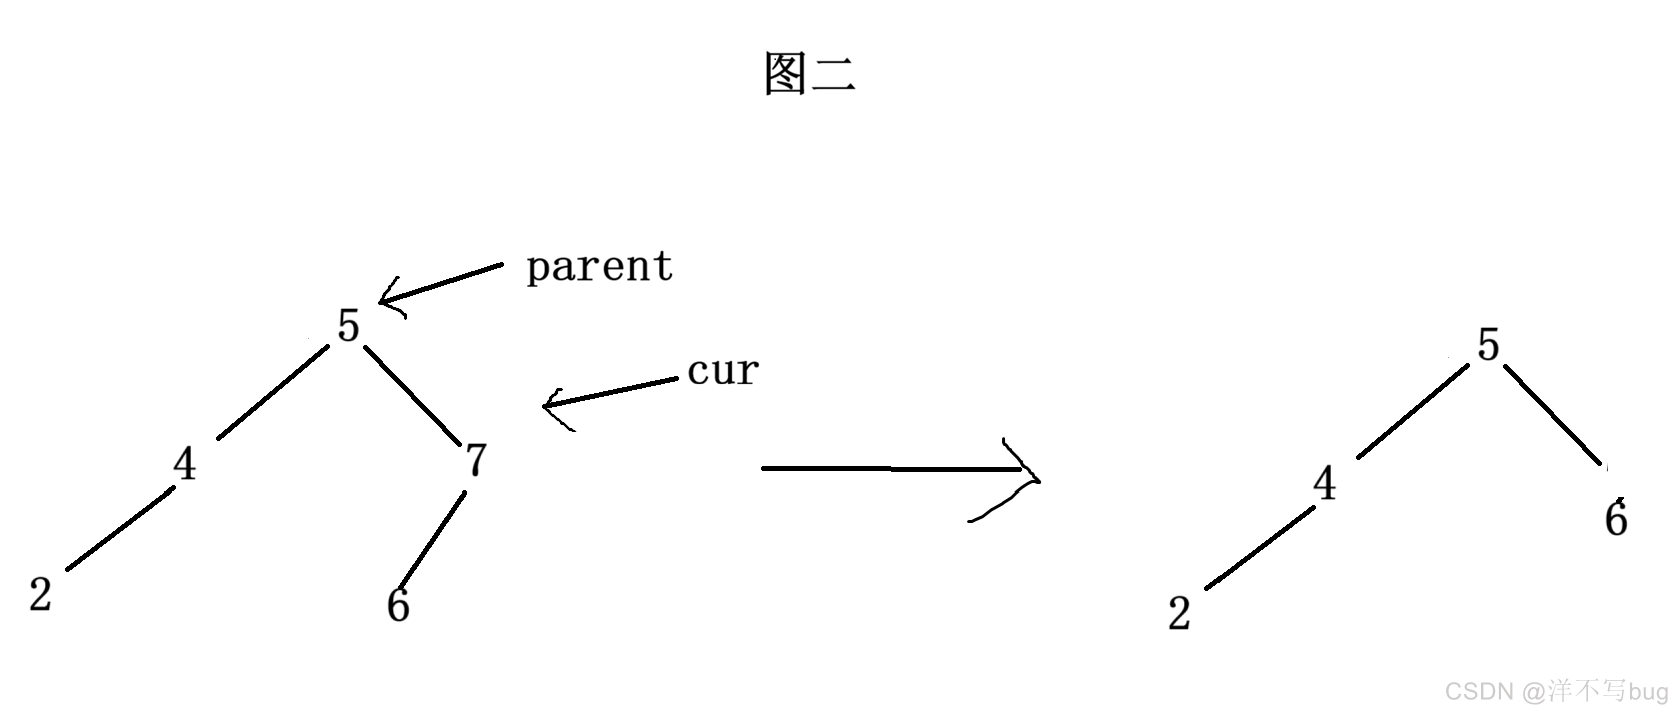
代码如下:
        //2.cur只有左子树
        if(cur.left != null && cur.right == null){
            //2.1 cur为root
            if(cur == root){
                //cur的左子树的第一个节点就变成了根节点了
                root = cur.left;
                return;
            }

            //2.2  cur不是root,同时cur是parent的左子树
            if(cur == parent.left){
                parent.left = cur.left;
                return;
            }

            //2.3  cur不是root,同时cur是parent的右子树
            if(cur == parent.right){
                parent.right = cur.left;
                return;
            }
            return;
        }
③:cur只有右子树
还是分三种情况:
- cur是根节点,让他的右子树的第一个节点变成根节点即可
- cur是parent的左子树,parent.left = cur.right,如图一,要删除
- cur是parent的右子树,parent.left = cur.right,如图二 ,要删除8,让7的右子树连上10即可
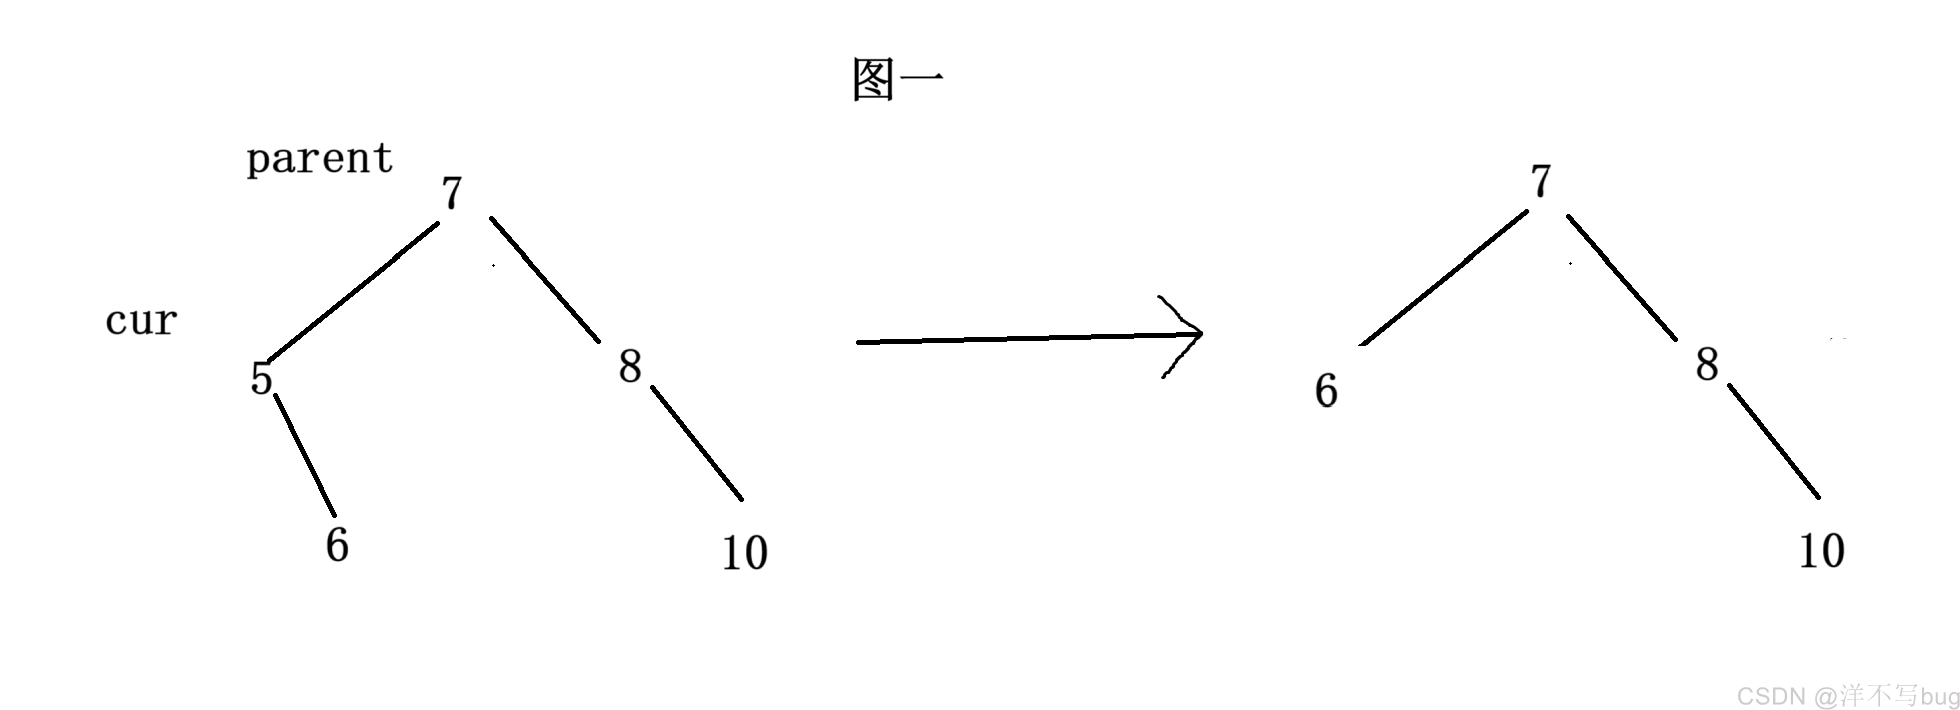
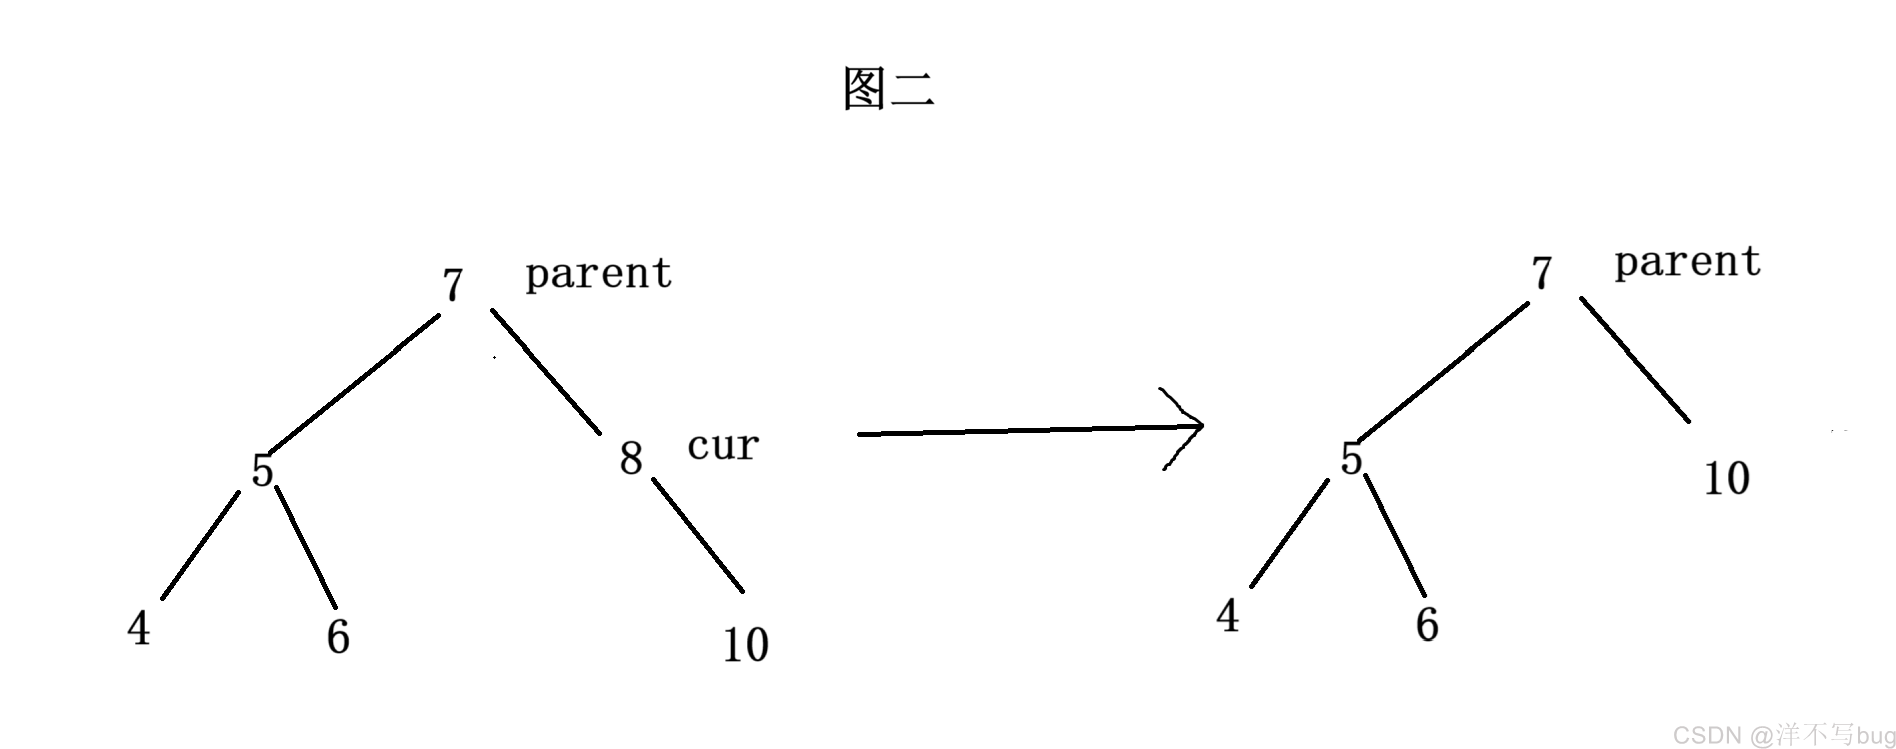
代码如下:
if(cur.right != null && cur.left == null){

            //3.1 cur是根节点
            if(cur == root){
                root = cur.right;
                return;
            }

            //3.2 cur不是根节点,且cur是parent的左子树
            if(cur == parent.left){
                parent.left = cur.right;
                return;
            }

            //3.3 cur不是根节点,且cur是parent的右子树
            if(cur == parent.right){
                parent.right = cur.right;
                return;
            }
            return;
        }
④:cur左右子树都有
前面3种比较简单,第4种就稍微有点复杂了
如下图,要删除5这个结点,但是5左右子树都有,那么显然就没有办法直接删除了,就可以使用 “替罪羊法”,那就是把cur(要删除的结点)的左子树的最右侧元素 或者 右子树的最左侧元素当作替罪羊,把cur的值改为替罪羊元素的值,接着把替罪羊元素删除即可
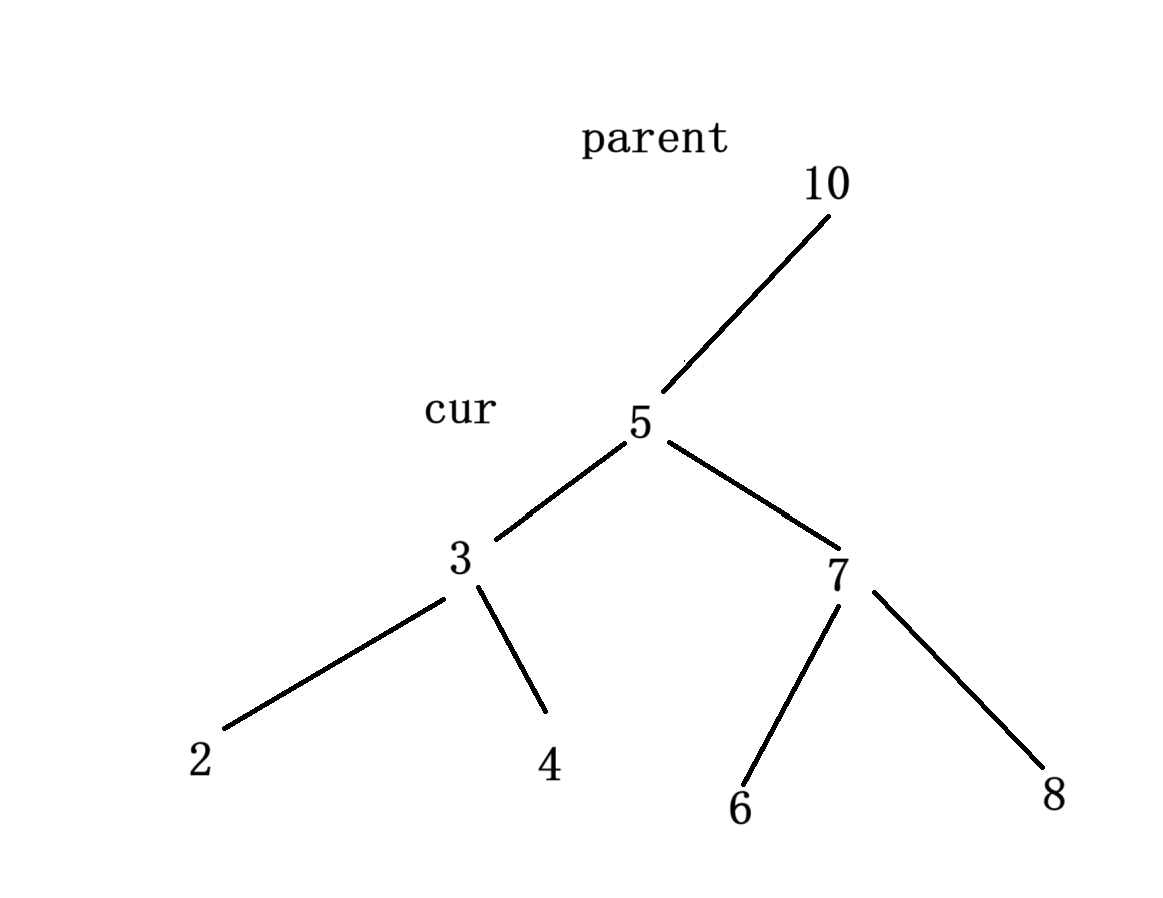
用左子树的最大值(最右侧元素)或者右子树中的最小值(最左侧元素)来当替罪羊都可以,如下图,用右子树的最左侧元素6来当替罪羊,右子树的最左侧结点的值是6,把这个结点的值赋值给cur,再删除这个替罪羊结点即可,步骤如下图
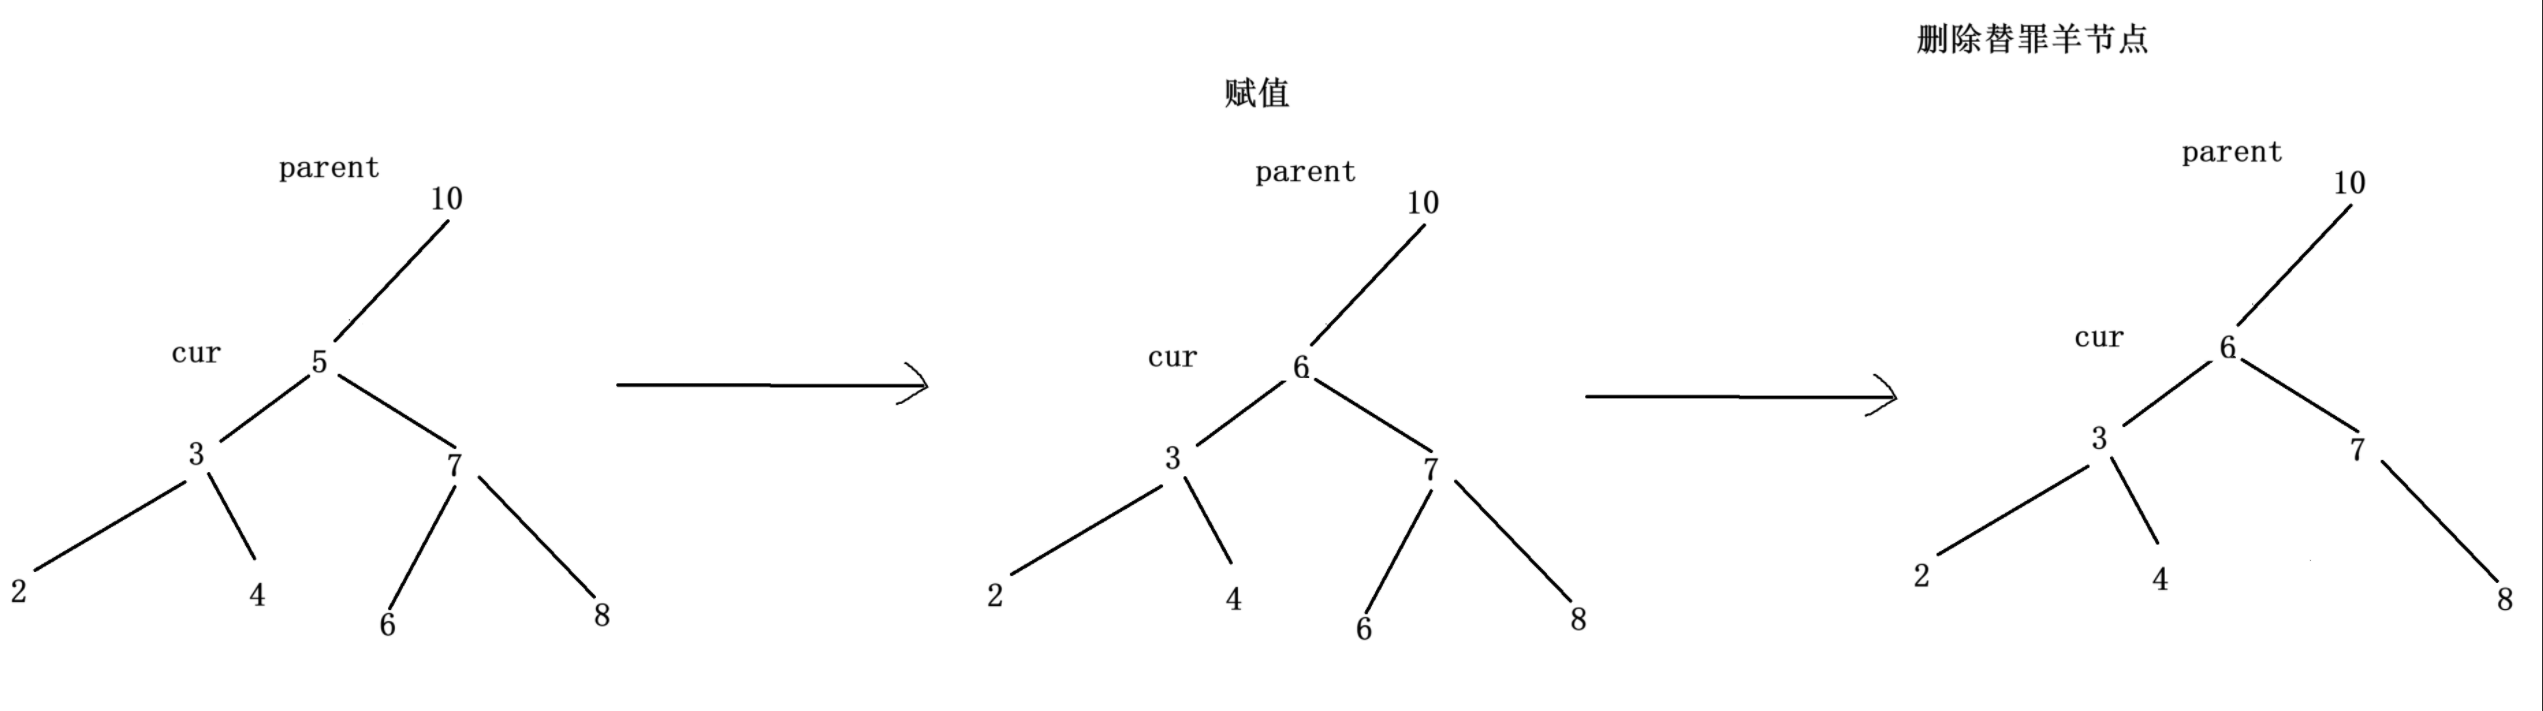
因为左子树的所有元素都是小于根结点的,右子树的所有元素都是大于根结点的,把左子树的最大值或者右子树的最小值换到根结点上,仍然是满足二叉搜索树的性质的
分析清楚后,代码逻辑就分为以下三步(这里用右子树的最小值当作替罪羊结点):
- 利用while循环找到替罪羊;
- 进行移花接木,把cur的值换成替罪羊的值
- 删除替罪羊结点,替罪羊结点要不就是左右都为null,要不就是只有右子树(不可能有左子树,因为已经跳出了while循环,那么就直接goatParent.left = goat.right;即可)
        // 4.cur有两个子树
        if(cur.left != null && cur.right != null){
            //第一步,先找到替罪羊
            Node goat = cur.right;
            Node goatParent = cur;
            while(goat.left != null){
                goatParent = goat;
                goat = goat.left;
            }
            //这个while循环结束之后,goat指向的就是cur的右子树的最左侧节点

            //第二步,移花接木,把替罪羊的值,赋值到cur节点中
            cur.key = goat.key;

            //第三步,删除goat节点(goat是没有左子树的,让goatParent直接连上goat的右子树即可)
            //即使goat的右子树是空的,也不影响
            goatParent.left = goat.right;
        }
第三步删除替罪羊结点其实漏掉了一种情况,铁汁们可以细品一下,看能不能品出来🐵
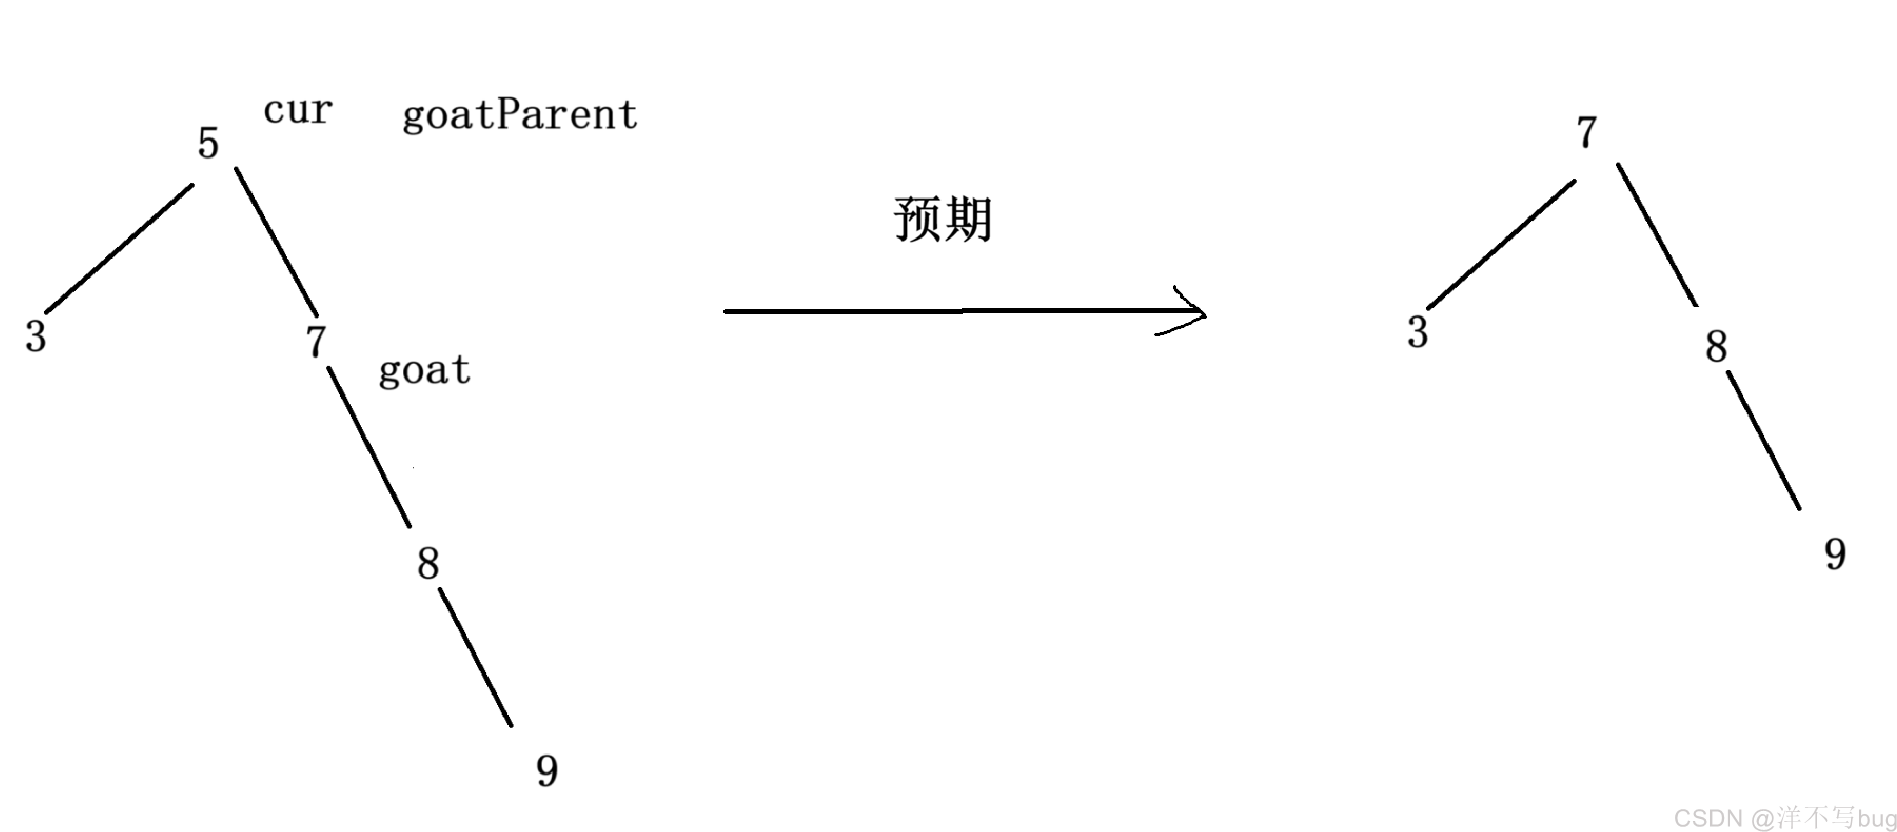
如下图,这种情况下,右子树没有左侧元素分支,这时候根本就不会进入while循环,我们预期是这样的:
但是按照代码的操作,goatParent.left = goat.right,操作后就变成了下图这样,这时候该删除的goat结点没有删除,也把左子树上的数据给覆盖掉了😅
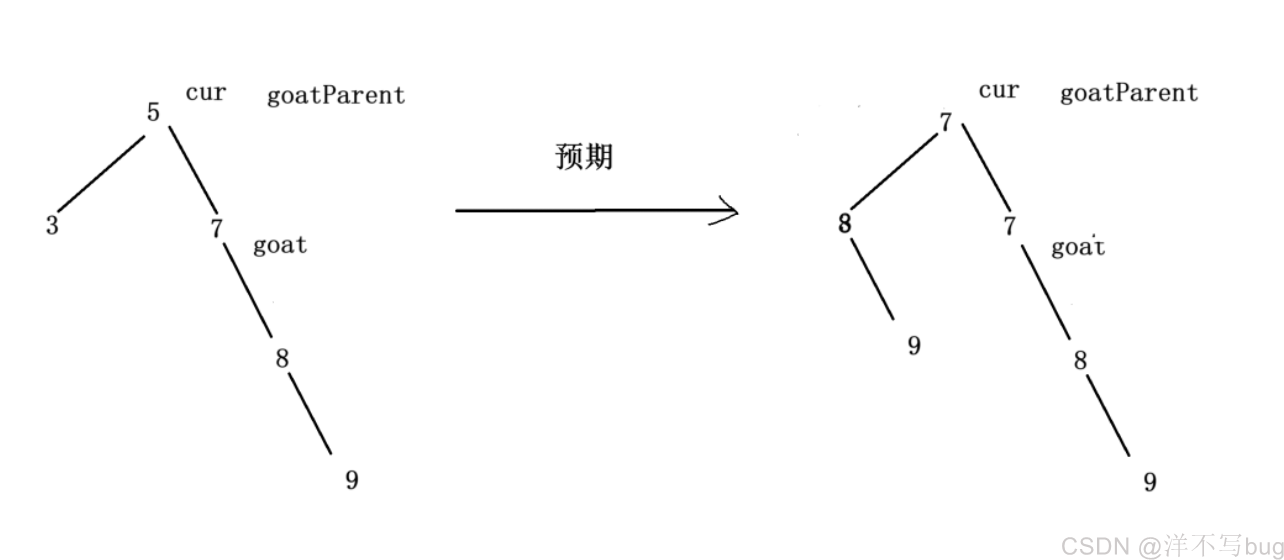
因此,第三步还要再加上一个判断,判断goat是否等于goatParent.left,来判断goatParent有没有在while循环中移动;如果移动了,就按正常流程来,如果没移动,就说明右子树没有左侧元素分支,就goatParent.right = goat.right;
     //第三步,删除goat节点(goat是没有左子树的,让goatParent直接连上goat的右子树即可)
            //即使goat的右子树是空的,也不影响
            //这里还有一个坑,那就是没有触发while这段代码,那么goat就是goatParent的右子树
            goatParent.left = goat.right;
            if(goat == goatParent.left){
                goatParent.left = goat.right;
            }else{
                goatParent.right = goat.right;
            }
        }
3,代码实现
1,插入操作
元素删除操作搞懂了,二叉搜索树代码就比较好写了,首先写个Node类,left和right引用默认为null
public class Node {
    public int key;
    Node left = null;
    Node right = null;

    public Node(int key) {
        this.key = key;
    }
}
接着创建BinarySearchTree类,里面写个插入方法,前序遍历方法,中序遍历方法,再写个print方法,来打印遍历的结果
insert方法逻辑如下:
- 传入元素key,创建结点,判断当前二叉树是否为空,如果为空,root = newHead
- 如果当前二叉树不为空,那就创建个cur和parent,cur初始时在root的位置,比较cur.key和key的大小关系,如果key < cur.key,cur就往左子树走,如果key > cur.key,cur就往右子树走,用parent计算cur的上一步位置,一直在while循环中重复该过程,直到cur的值为null
- 出while循环后,parent就是newNode的父结点,要判断key和parent.key的大小关系,确定newNode是加到parent的左边还是右边
public class BinarySearchTree {
    //表示当前树的根节点
    private Node root = null;

    //把新的元素插入到树中
    public void insert(int key){
        Node newNode = new Node(key);
        //如果当前树是空树的话,就直接用root指向新节点即可
        if(root == null){
            root = newNode;
            return;
        }
        //如果是普通的树的话,就需要找到要插入的位置,再进行插入,
        //cur用来找待插入元素的位置
        //parent 记录 cur 的父元素
        Node cur = root;
        Node parent = null;
        while(cur != null){
            if(key < cur.key){
                //比根节点的元素小,就往左找
                parent = cur;
                cur = cur.left;

            }else if(key > cur.key){
                //比根节点的元素大,就往右找
                parent = cur;
                cur = cur.right;
            }else{
                //对于相同的情况,其实是存在许多不同的处理方式
                //我们这里是不允许重复的key出现的,这里就直接return即可
                return;
            }
        }

        //这个while循环走完以后,我们就得到了cur为null的情况,此时parent就是要插入元素的父节点
        //这就需要把newNode插入到parent的子节点上
        //这时候还要再判断一次新节点是插到parent的左子树,还是右子树上
        if(key < parent.key){
            parent.left = newNode;
        }else{
            parent.right = newNode;
        }
    }

    public void preOrder(Node root){
        if(root == null){
            return;
        }
        System.out.print(root.key + " ");
        preOrder(root.left);
        preOrder(root.right);
    }

    public void inOrder(Node root){
        if(root == null){
            return;
        }
        inOrder(root.left);
        System.out.print(root.key + " ");
        inOrder(root.right);
    }

    public void print(){
        System.out.println("前序遍历:");
        preOrder(root);
        System.out.println();
        System.out.println("中序遍历:");
        inOrder(root);
    }
}
2,特征分析
在main方法中测试下,中序遍历的结果是从小到大排序的,因为中序遍历的顺序是左—中—右,在二叉搜索树中,左边的元素小于根节点元素,而右边的元素是大于根节点元素的。
public class Test {
    public static void main(String[] args) {
        int [] arr = {1,3,2,6,5,7,8,9,10,0};

        BinarySearchTree tree = new BinarySearchTree();
        for(int key : arr){
            tree.insert(key);
        }
        tree.print();
    }
}
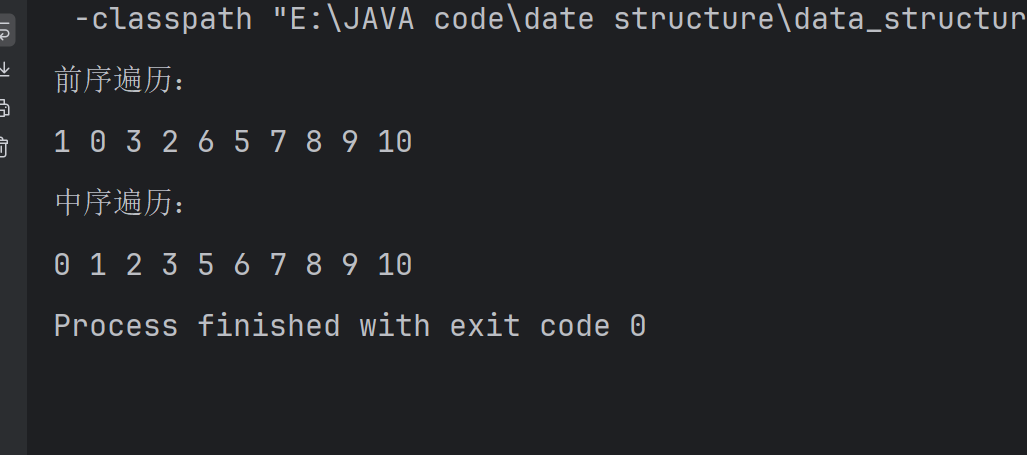
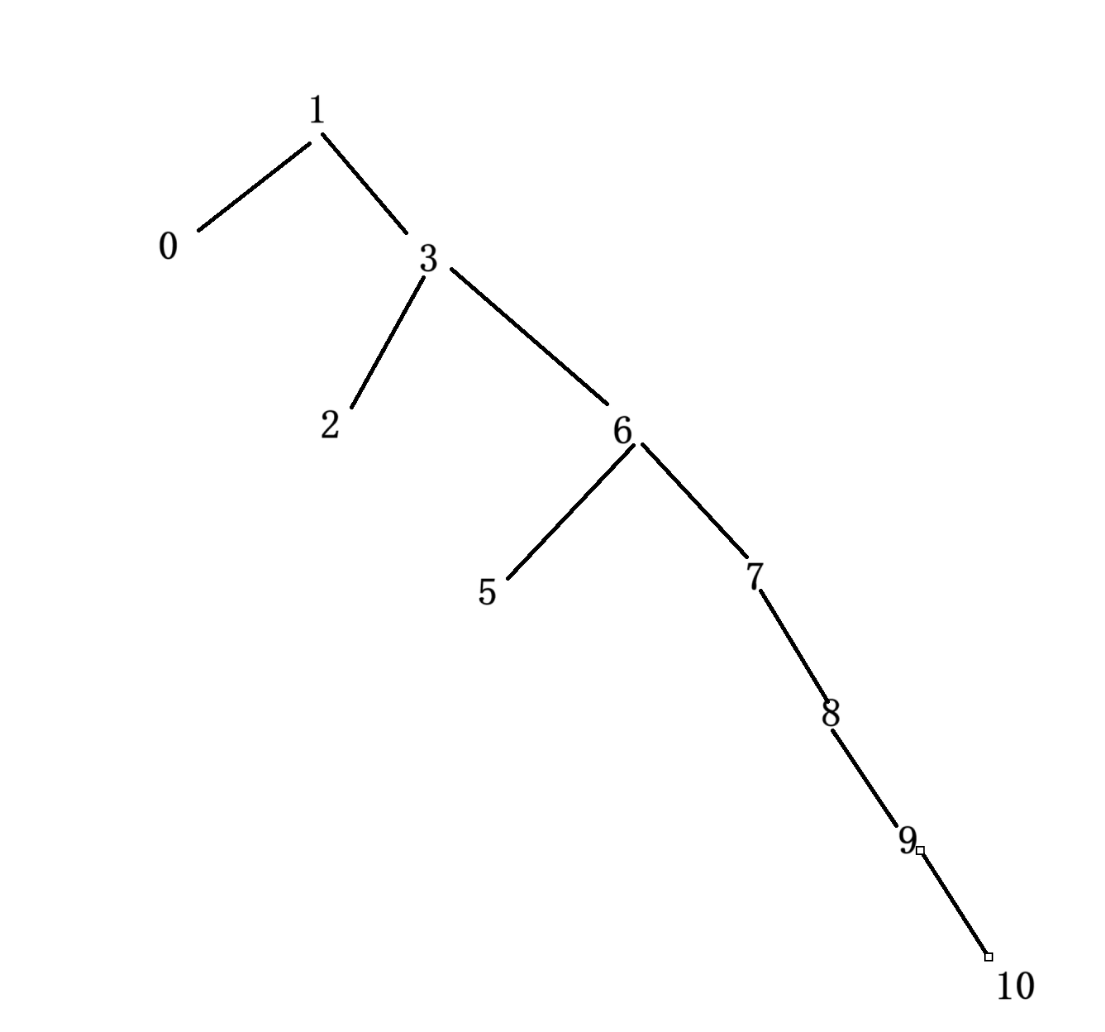
通过先序和中序遍历来画出二叉搜索树的样子,如下图(前面的二叉树(一)博客中解析了通过序列还原出二叉树的技巧,链接放在下面了,感兴趣的铁汁可以复习一下)
二叉树(一)
在IDEA中调试下,在main方法的tree.print()这里打上一个断点,执行到这里停下来时二叉搜索树就已经构建好了
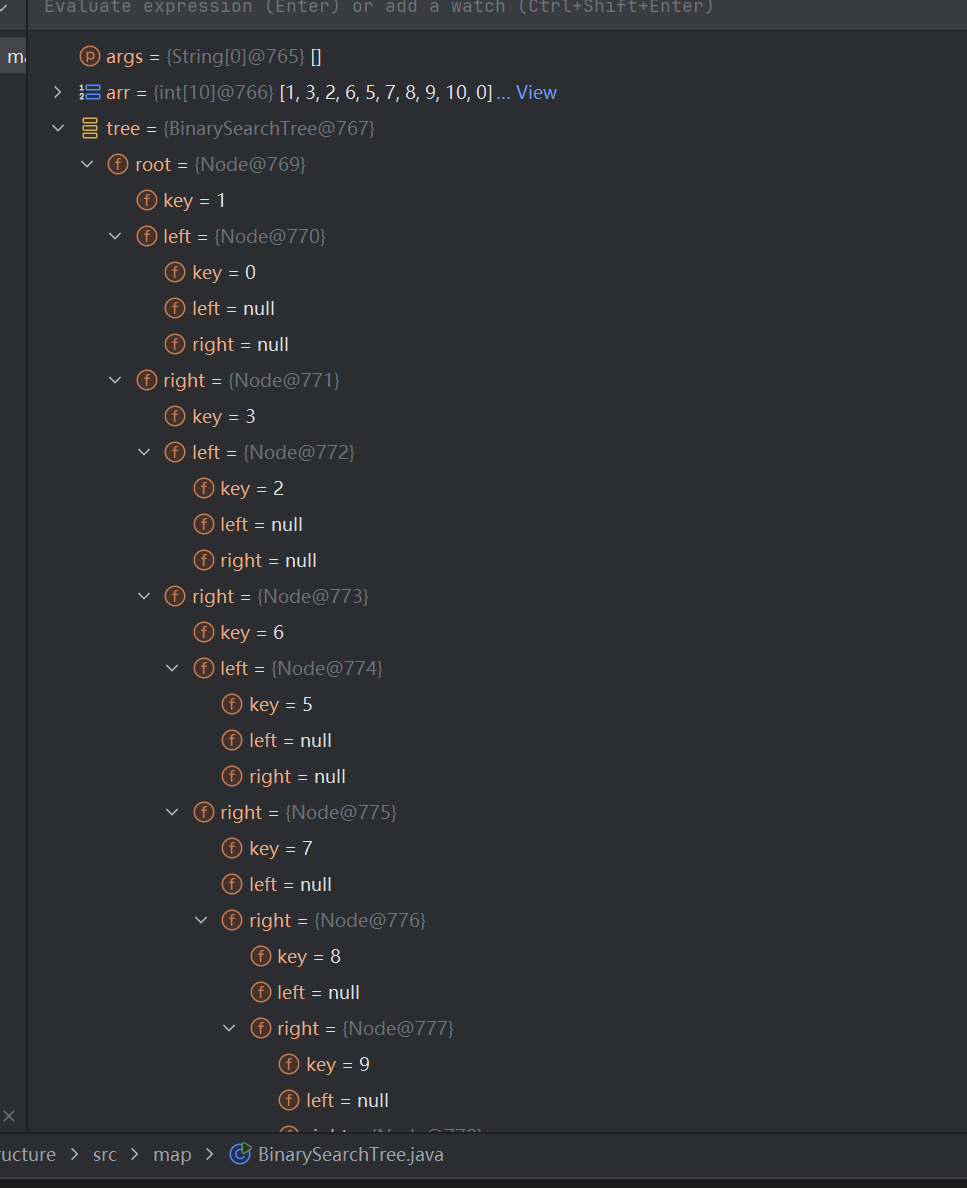
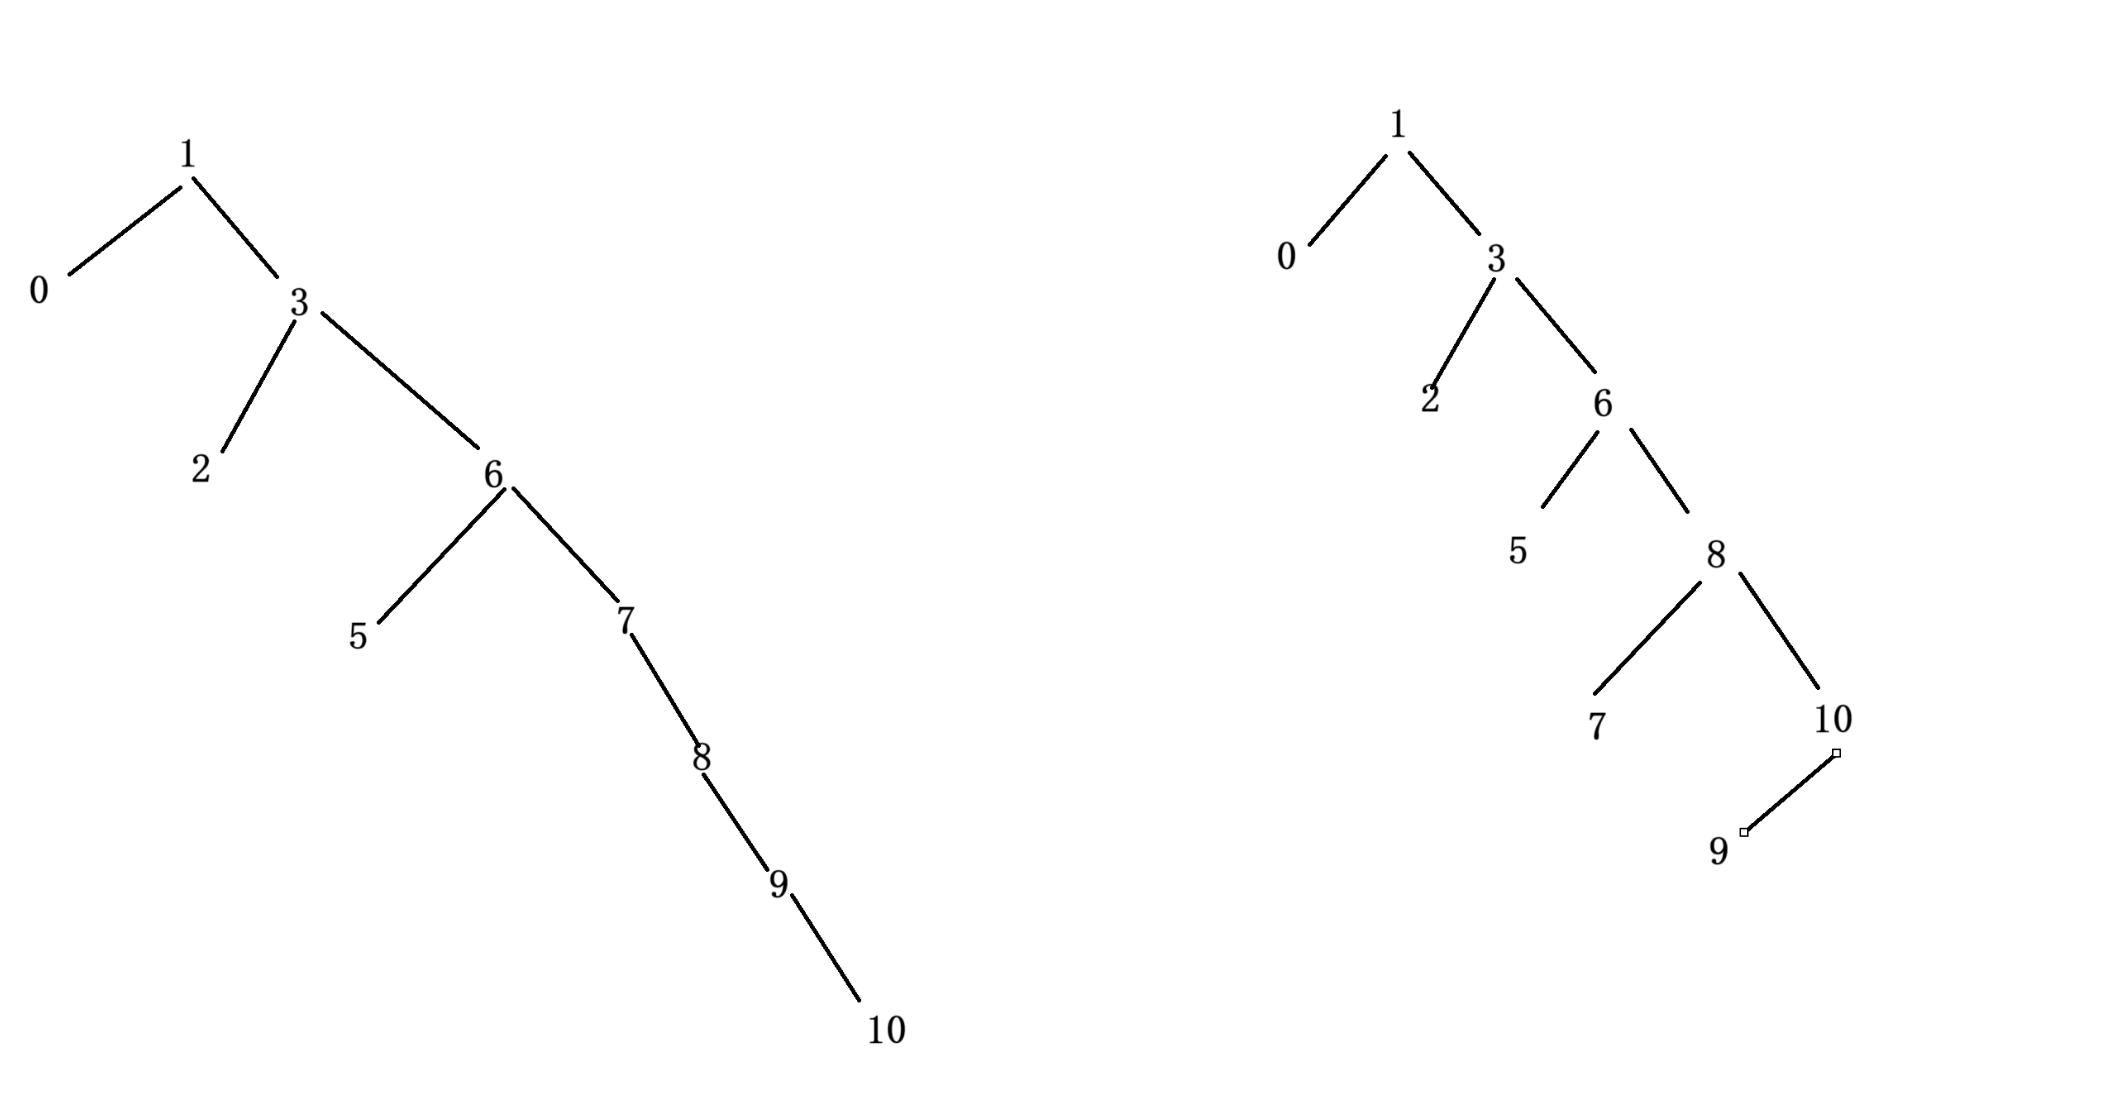
如果还是这些元素,插入的顺序不同,构建的二叉搜索树就也是不同的,测试如下:
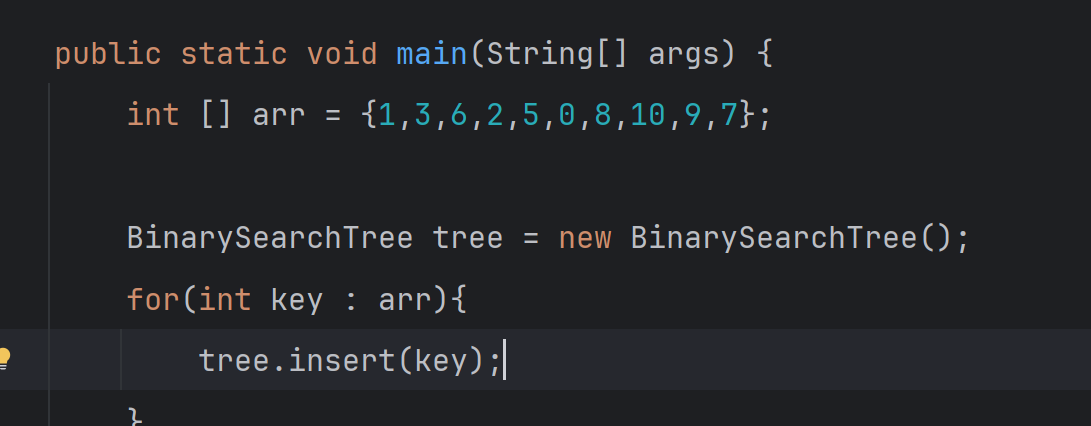
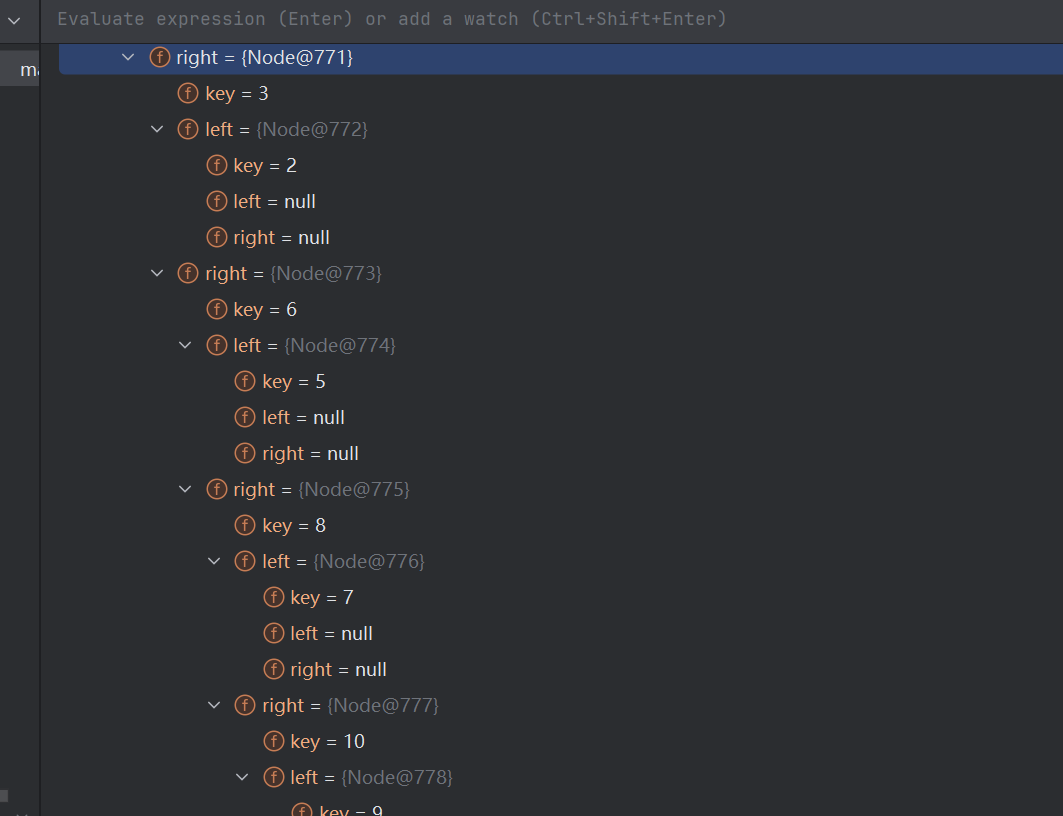
如下图,左边是第一次构造的,右面是第二次构造的,因此,二叉搜索树的是不稳定的。
3,查找操作
查找操作也不复杂,搞个cur,从root开始,判断要查找的值key和cur.key的大小关系,如果key大于cur.key,cur就往右子树上移动;如果key大于cur.key,cur就往左子树上移动,如果key小于cur.key,cur就往右子树上移动,key等于cur.key,就直接返回cur
如果二叉搜索树为空或者没有匹配到,就返回null
    public Node find(int key){
        if(root == null){
            return null;
        }
        Node cur = root;
        while(cur != null){
            if(key < cur.key){
                cur = cur.left;
            }else if(key > cur.key){
                cur = cur.right;
            }else{
                //相等,找到了
                return cur;
            }
        }
        //如果while循环完都没有找到,那么就没有查找到,说明不存在
        return null;
    }
要在main方法中测试,还要在Node类中重写一下toString()方法,清楚的打印出是哪个节点
public class Node {
    public int key;
    Node left = null;
    Node right = null;

    public Node(int key) {
        this.key = key;
    }

    @Override
    public String toString() {
        return "Node{" +
                "key=" + key +
                ", left=" + left +
                ", right=" + right +
                '}';
    }
}
public class Test {
    public static void main(String[] args) {
        int [] arr = {1,3,6,2,5,0,8,10,9,7};

        BinarySearchTree tree = new BinarySearchTree();
        for(int key : arr){
            tree.insert(key);
        }
        System.out.println(tree.find(0));
    }
}
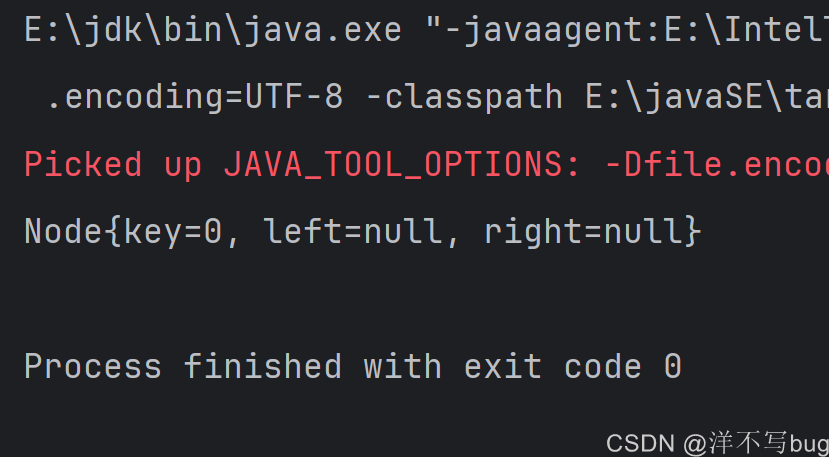
4,删除操作
删除操作还是比较复杂的,前面第2部分已经解析过了,这里就写下代码,这里分为两个方法来实现,在remove方法中传入key,在while循环中进行匹配,找到要删除的元素cur和该元素的父结点parent
    public void remove(int key){
        if(root == null){
            return;
        }
        Node cur = root;
        Node parent = null;
        while(cur != null){
            if(key > cur.key){
                //比根节点的值大,就去根节点的右面找
                parent = cur;//更新父节点的位置
                cur = cur.right;
            }else if(key < cur.key){
                parent = cur;
                cur = cur.left;
            }else{
                //相等,直接进行删除操作即可
                removeNode(parent,cur);
                return;
            }
        }
    }
在remove方法中找到待删除元素cur和其父结点parent后,就调用removeNode方法,传入cur和parent,在2.元素删除分析中已经分析过逻辑了,这部代码要考虑的情况分支是非常多的,需要铁汁们细品代码如下:
 public void removeNode(Node parent,Node cur){
        //共分为4大种情况
        //1,cur没有子树
        if(cur.right == null && cur.left == null){
            //1.1,如果cur就是root,就需要对root进行调整
            if(cur == root){
                //这时候整个树只有一个root节点,把root删除后,相当于树就成了空树
                root = null;
                return;
            }

            //1.2  cur不是root,同时cur是parent的左子树
             if(cur == parent.left){
                 //这时候直接删除cur即可
                parent.left = null;
                return;
            }

             //1.3 cur不是root,同时是parent的右子树
            if(cur == parent.right){
                parent.right = null;
                return;
            }
            //这里我们最后还是加个return,虽然理论上来说是不会走到这里的,但是为了稳妥还是加个。
            return;
        }

        //2.cur只有左子树
        if(cur.left != null && cur.right == null){
            //2.1 cur为root
            if(cur == root){
                //cur的左子树的第一个节点就变成了根节点了
                root = cur.left;
                return;
            }

            //2.2  cur不是root,同时cur是parent的左子树
            if(cur == parent.left){
                parent.left = cur.left;
                return;
            }

            //2.3  cur不是root,同时cur是parent的右子树
            if(cur == parent.right){
                parent.right = cur.left;
                return;
            }
            return;
        }

        //3.cur只有右子树
        if(cur.right != null && cur.left == null){

            //3.1 cur是根节点
            if(cur == root){
                root = cur.right;
                return;
            }

            //3.2 cur不是根节点,且cur是parent的左子树
            if(cur == parent.left){
                parent.left = cur.right;
                return;
            }

            //3.3 cur不是根节点,且cur是parent的右子树
            if(cur == parent.right){
                parent.right = cur.left;
                return;
            }
            return;
        }

        // 4.cur有两个子树
        if(cur.left != null && cur.right != null){
            //这时候就无需考虑cur是不是根节点的情况了,因为这里并没有真正删除cur指向的节点,即使cur是root.
            //也无需修改root的指向,因为实际找寻的是“替罪羊节点”
            //首先要找到右子树中的最小值,=> 替罪羊
            //后续删除替罪羊,同时把替罪羊的父节点记录一下

            //第一步,先找到替罪羊
            Node goat = cur.right;
            Node goatParent = cur;
            while(goat.left != null){
                goatParent = goat;
                goat = goat.left;
            }
            //这个while循环结束之后,goat指向的就是cur的右子树的最左侧节点

            //第二步,移花接木,把替罪羊的值,赋值到cur节点中
            cur.key = goat.key;

            //第三步,删除goat节点(goat是没有左子树的,让goatParent直接连上goat的右子树即可)
            //即使goat的右子树是空的,也不影响
            //这里还有一个坑,那就是没有触发while这段代码,那么goat就是goatParent的右子树
            if(goat == goatParent.left){
                goatParent.left = goat.right;
            }else{
                goatParent.right = goat.right;
            }
        }
    }
结语
- 二叉搜索树实现这里也没有用到复杂的递归,主要是删除操作比较复杂,需要分多种情况讨论,写这个删除操作是非常考验代码能力的
- TreeSet和TreeMap的底层是红黑树,也就是改进版本的二叉搜索树,能够保证增删查的时间复杂度为O(logN),当需要元素/key有序时,就用TreeSet/TreeMap
.以上就是今天的所有内容啦~完结撒花~🥳🎉🎉


 扫一扫


 354

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


