


本文整理于 HOW 2026 演讲内容,演讲者:崔鹏,PostgreSQL ACE,计算机博士,10 年 以上数据库经验,ORACLE OCM + PostgreSQL ACE 双认证,海能达通信 DBA 总监,公众号“CP 的 PostgreSQL 厨房”主理人。
本次分享主要分四个部分:第一,智能查询优化技术背景;第二,基于排序学习的查询计划选择算法;第三,基于 Tree Transformer 的查询计划表征算法;第四,原型系统设计与实现。
一、研究背景:传统查询优化器的三大痛点
随着大数据时代的到来,数据规模呈爆炸式增长,数据库管理系统在处理复杂查询和高效数据检索方面面临前所未有的挑战。
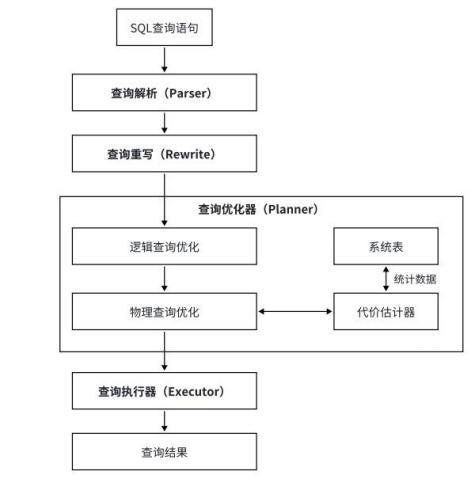
传统查询优化器的核心任务是制定出最佳的执行计划——同一个 SQL 查询可以有多种执行方式,它们产生相同的结果集,但执行效率可能天差地别。查询优化器需要对所有可能的执行计划进行评估,选出预计执行时间最短的那个。
然而,传统方法存在三个明显的局限性:
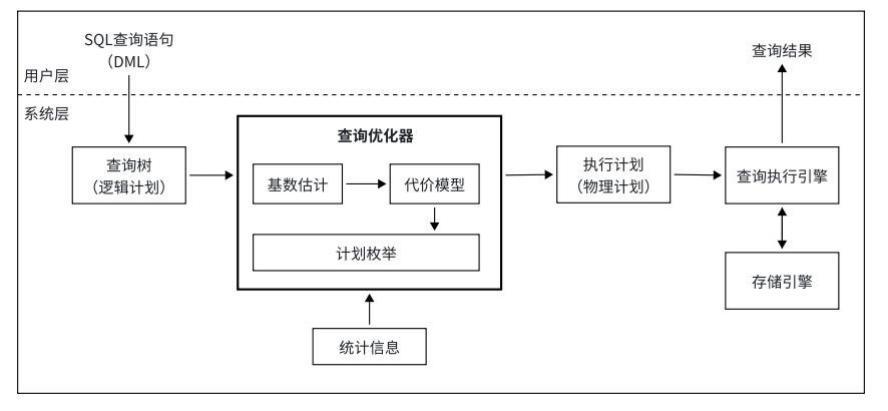
第一个是基数估计问题。 基数估计方法主要分为基于摘要和基于采样两类,但都存在不足。基于摘要的方法难以捕捉数据之间的相关性;基于采样的方法性能依赖采样策略,还需要额外的存储开销。统计信息分析不准,直接导致中间结果大小估计出现偏差。
第二个是代价模型缺陷。 传统代价模型依赖预设常数,其准确性受基数估计质量影响很大。而且,查询计划代价估计与实际执行时间之间不一定呈线性关系,可能导致选择出的执行计划质量不佳。
第三个是计划枚举限制。 计划枚举策略旨在寻找最优连接顺序,但这个问题本身是 NP 难题。传统方法如动态规划、记忆化搜索和遗传算法,都受限于基数估计和代价模型的误差,面对多表连接时能力明显不足。
AI 技术的到来,为数据库查询优化带来了新的机遇。 利用机器学习改进查询优化器的研究日益活跃,在基数估计、代价模型改进和计划枚举等方面都取得了积极进展。
二、现有智能优化技术的探索与局限
先简单回顾一下机器学习领域与查询优化相关的基础算法。
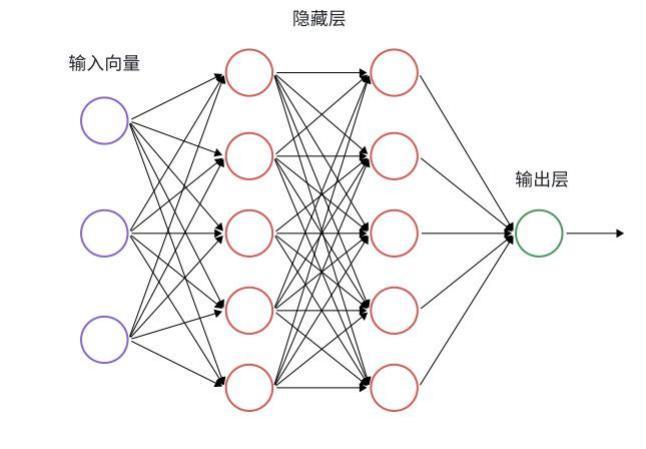
全连接神经网络(FCN) 将输入嵌入成向量矩阵,经过多个隐藏层提取特征,最终由输出层输出结果。但全连接带来的问题是参数量过大,计算性能受影响。
卷积神经网络(CNN) 通过卷积核(如 3×3、5×5)在原始特征矩阵上滑动做矩阵乘法,极大减少了特征提取的参数量,在图像等网格结构数据上表现优异。
长短期记忆网络(LSTM) 专门为解决标准循环网络处理长期依赖问题而设计,通过遗忘门、输入门、输出门的门控机制,有效避免了长期依赖问题。
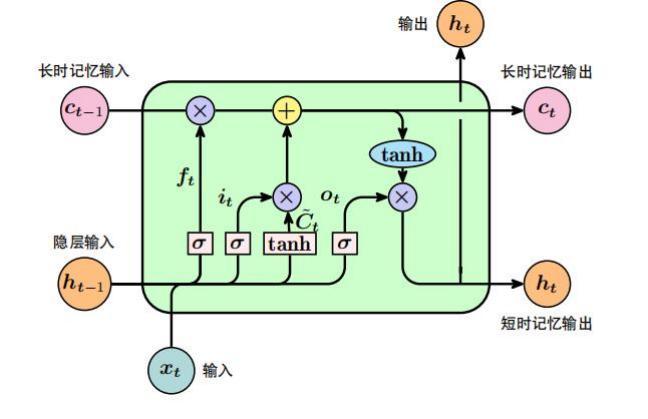
Tree LSTM则是将 LSTM 推广到树形结构,更适合处理查询计划树这种具有层次结构的数据。
在智能优化的进展方面,研究者们做了大量探索:
- 基数估计:分为查询驱动(有监督)和数据驱动(无监督)两类方法
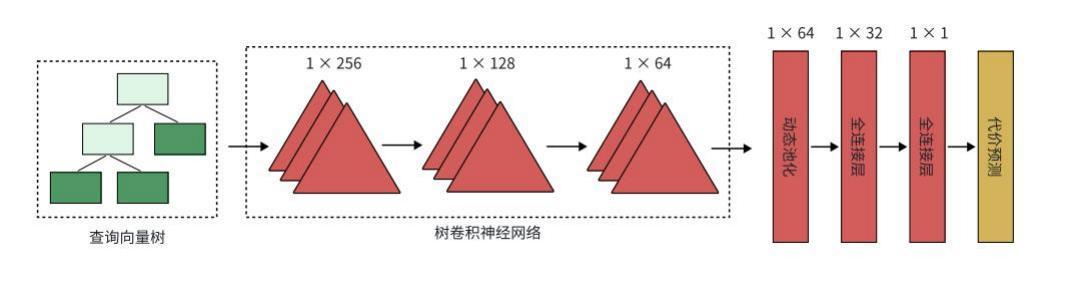
- 代价模型改进:用 Tree LSTM、Tree CNN 等模型替代或增强传统代价估计
- 计划枚举创新:引入深度强化学习,如 ReJoin 和 RTOS
- 端到端优化:如 Neo 和 Bao,通过价值网络和可学习搜索策略优化查询执行
但现有技术仍面临两大挑战:
第一,表征性能问题。 当前主要采用 CNN、RNN 及其衍生模型(如 Tree CNN、Tree LSTM),但在处理查询计划树形结构时存在局限性——难以捕捉长距离依赖关系。
第二,选择方法局限。 采用回归方法进行查询计划选择,需要精确预测每个查询计划的代价,这可能导致模型性能不稳定,也忽视了快速查询计划的存在。查询优化的本质是排序问题,而不是回归问题。
三、基于 Tree Transformer 的查询计划表征算法(QPR)
基于上述分析,我们提出了基于 Tree Transformer 的查询计划表征算法——QPR。
为什么选 Transformer?
Tree Transformer 以其出色的深层结构处理能力、跨层级依赖捕捉效率和优异的并行计算能力,成为查询计划表征场景下的首选模型。
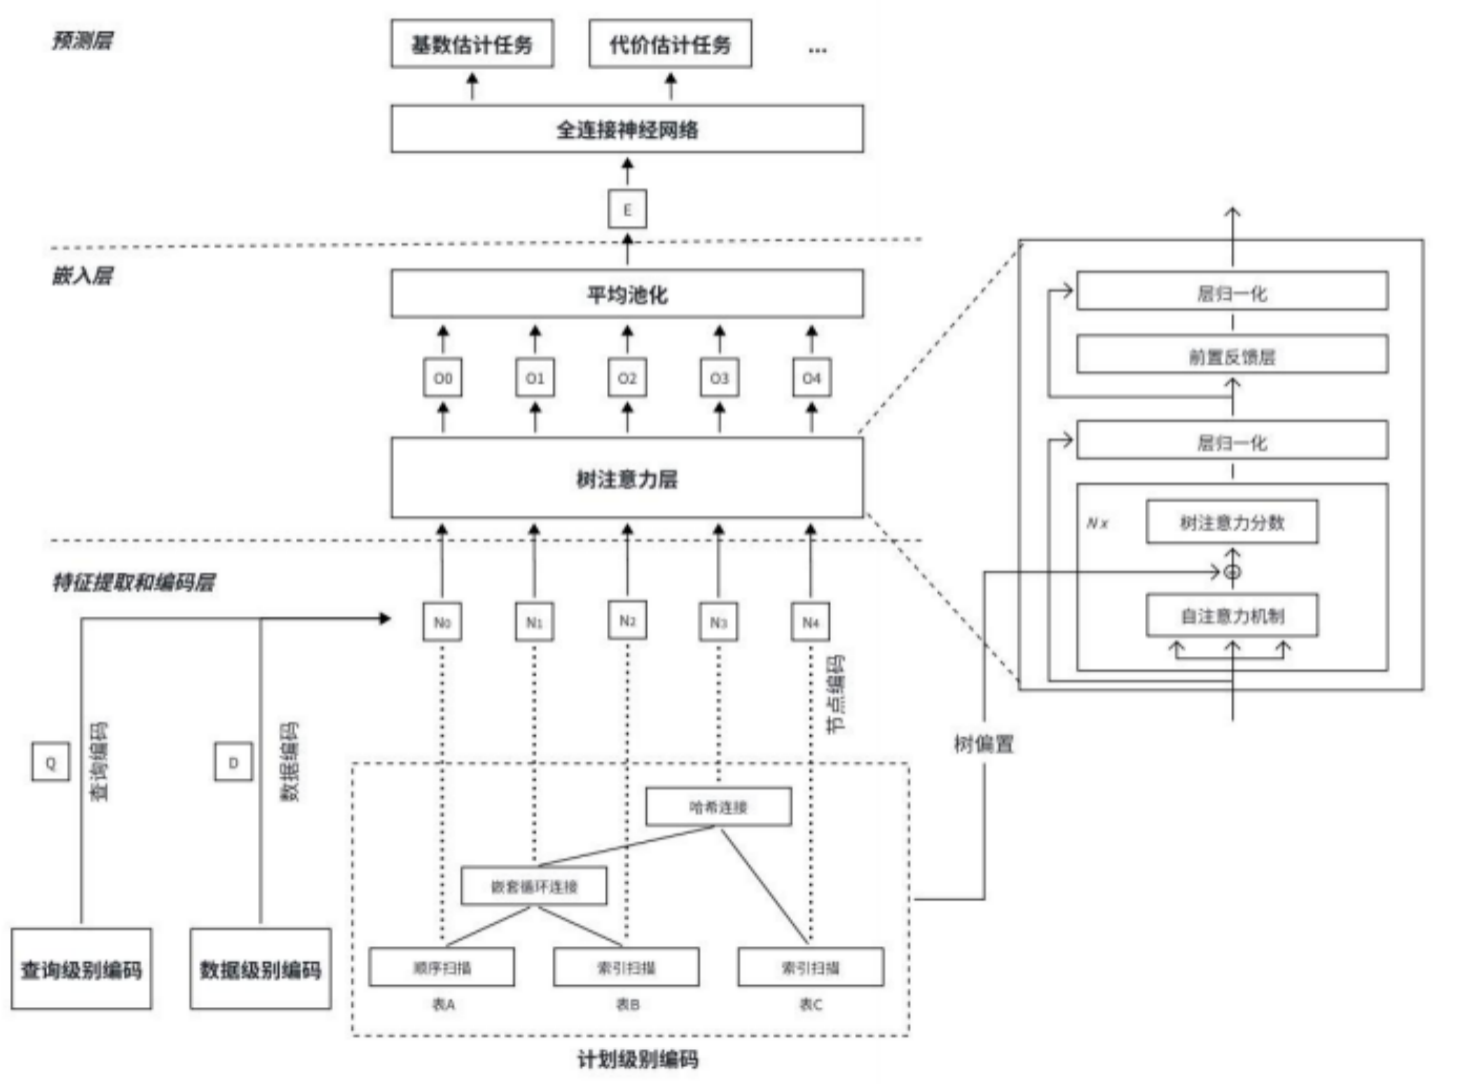
我们的创新点在于:引入树注意力机制和树高度编码机制,替代传统 Transformer 中的自注意力机制和位置编码机制,使 Transformer 能够高效处理树形结构数据。
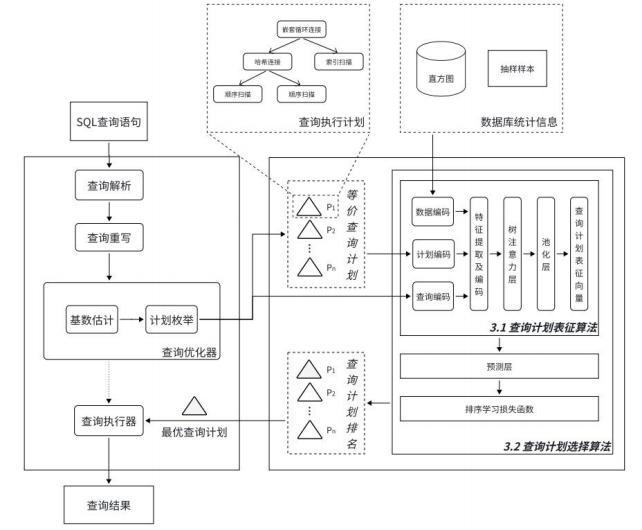
多维度的特征提取与编码
QPR 从三个维度提取特征并编码:
1. 查询级别特征
- 连接模式:通过编码连接关系图的邻接矩阵,顶点表示数据库中的表,边表示表间的连接关系
- 属性编码:使用 One-hot 编码处理查询中的过滤条件涉及的属性
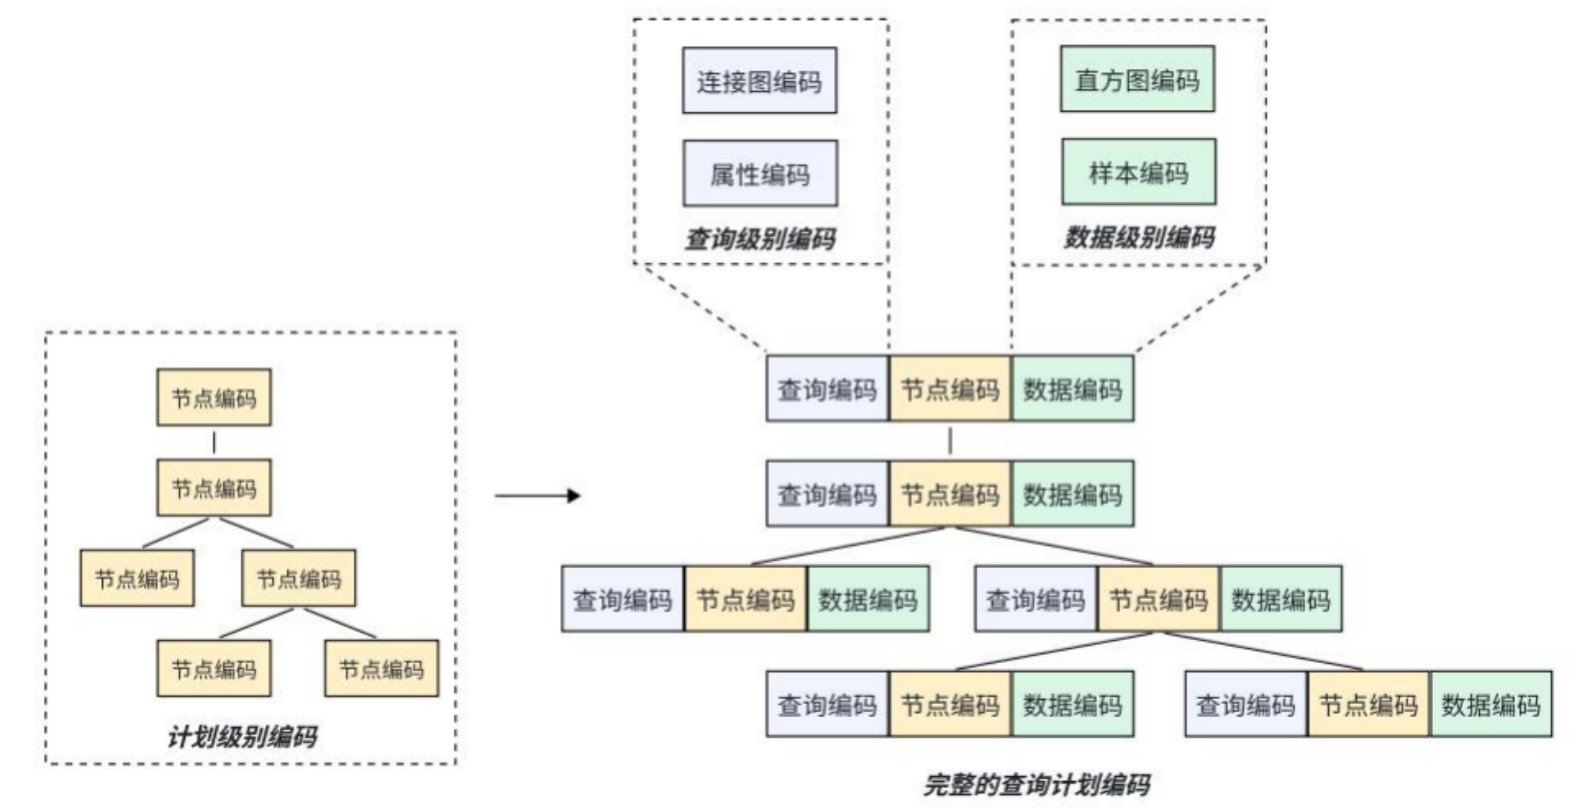
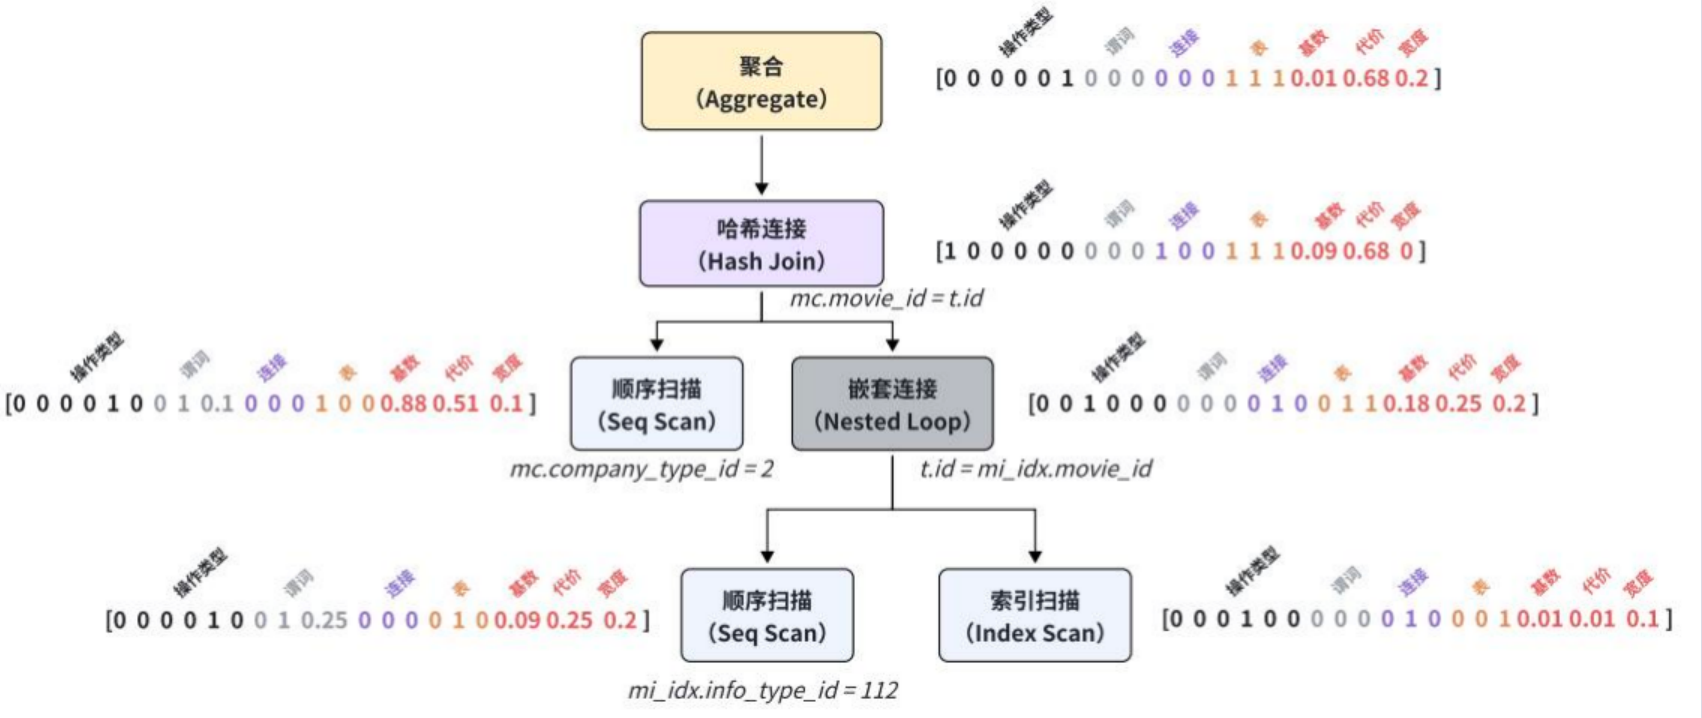
2. 计划级别特征
- 从查询执行计划树的每个节点提取:操作类型、谓词、连接表、基数估计值、代价估计值、宽度等
- 完整保留树形结构信息
3. 数据级别特征
- 通过直方图和采样样本提供数据分布信息
- 将直方图编码融入机器学习模型,提高对数据分布的理解能力
模型架构
整个模型自下而上分为:
- 特征提取与编码层:融合查询级别、计划级别、数据级别三类编码
- Tree Transformer 层:通过树注意力机制提取结构信息和语义依赖关系
- 平均池化层:减少神经元,防止过拟合
- 预测层:输出基数估计和代价估计结果
四、基于排序学习的查询计划选择算法(QPSLR)
核心理念:排序,而非回归
查询优化本质上是一个排序问题,而不是回归问题。受推荐系统中排序学习技术的启发,我们将查询优化问题建模为排序问题,目标是让模型学会区分候选查询计划的相对优劣,而非精确预测每个计划的绝对代价。
查询计划选择算法的整体流程
QPSLR 分为三个阶段:
- 计划枚举:设计基于基数估计的计划枚举策略,通过缩放子查询的基数估计值,引导传统优化器生成多样化且高质量的候选计划集合
- 查询计划表征:利用 QPR 算法提取每个候选计划的表征向量
- 排序学习:采用成对式(Pairwise)和列表式(Listwise)排序学习方法,学习候选计划的排序
排序学习方法
- 成对式(Pairwise) :将完整排序转化为成对比较,通过最大化联合边际对数似然来估计模型参数
- 列表式(Listwise) :基于负对数似然函数定义损失函数,使模型学习到的排序趋向于最优排序
通过最小化排序学习损失函数,扩大候选查询计划排名分数之间的差异,使算法能够有效区分最佳查询计划与其他候选计划,适应未知的查询场景。
五、原型系统设计与实验验证
系统架构
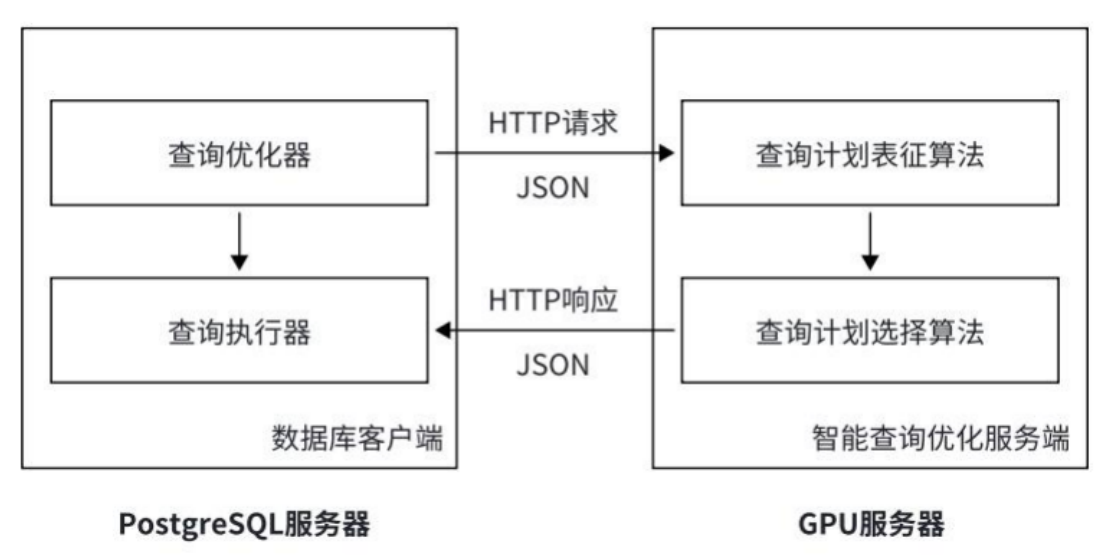
我们基于 PostgreSQL 设计并实现了原型系统,采用无侵入式部署架构:
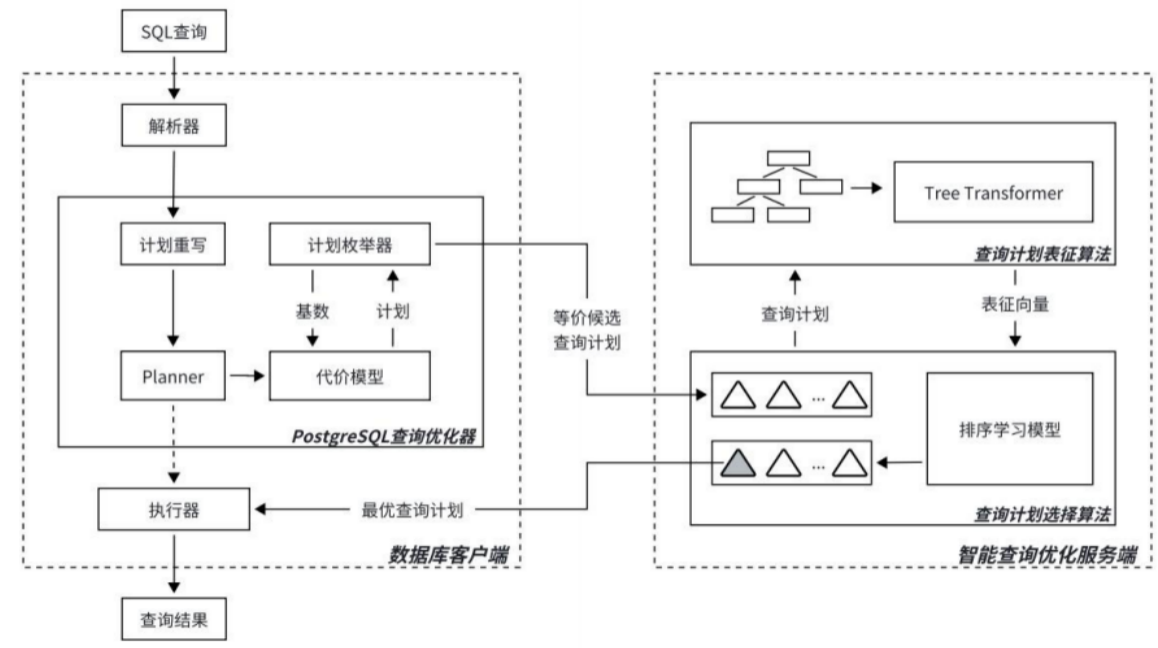
- 数据库客户端:部署在 PostgreSQL 服务器上,负责接收 SQL 查询、生成候选查询计划
- 智能查询优化服务端:部署在 GPU 服务器上,依托 QPR 和 QPSLR 模型进行计划评估和选择
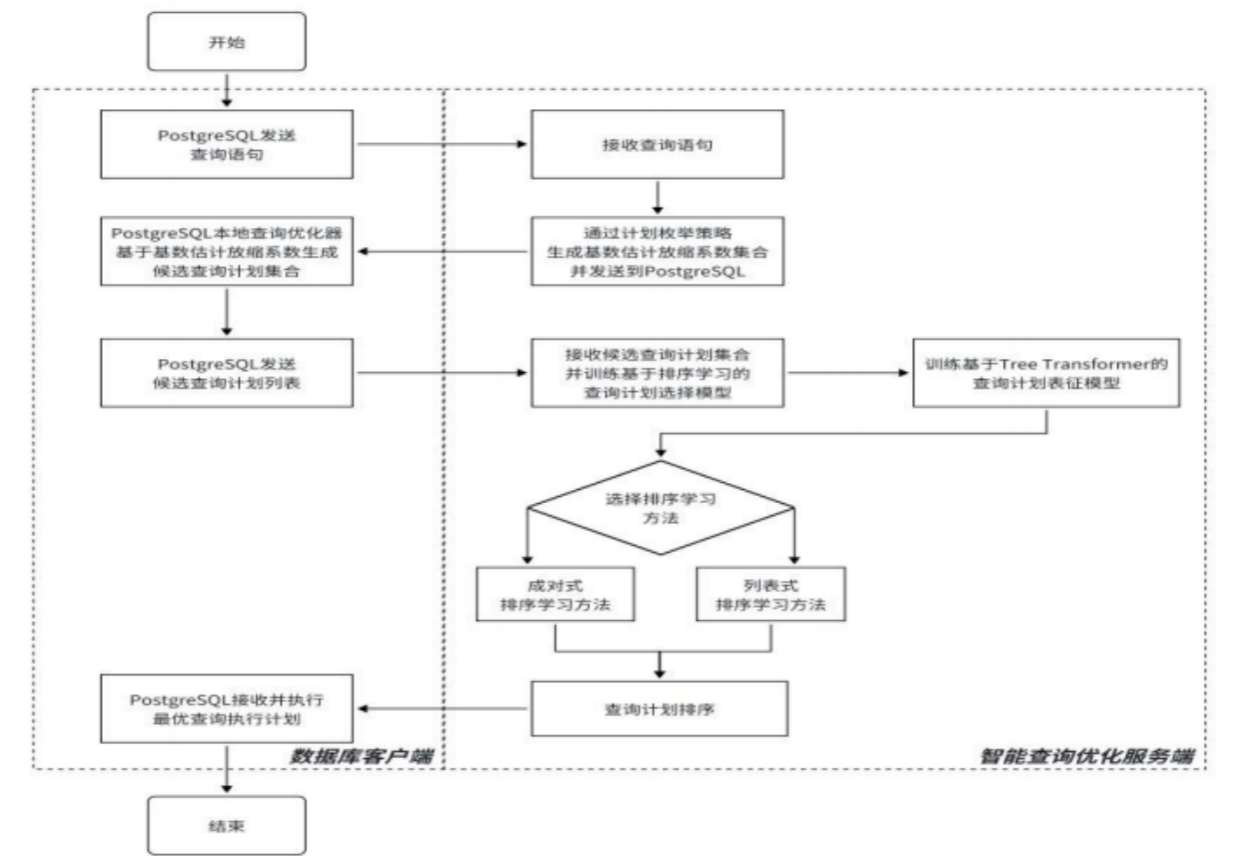
用户提交 SQL 查询后,系统询问是否启用智能查询优化算法。若启用,客户端生成候选计划发送给服务端,服务端选择最优计划返回给客户端执行。
实验环境
- 硬件:CPU、GPU、内存和硬盘
- 软件:操作系统、PostgreSQL、Python、PyTorch
- 数据集:
- IMDB 数据集:6 张表、20 个属性、62,118,470 条记录,使用 JOB-light 和 Synthetic 两种查询工作负载
- STATS 数据集:8 张表、43 个属性、1,029,842 条记录
实验结果
QPR 算法测试:在基数估计和代价估计任务上,以 Q-Error 和 Pearson 相关系数作为评估指标。QPR 在两项工作负载上的表现均优于 PostgreSQL 原生方法、MSCN、Neo(Tree CNN)和 E2E(Tree LSTM)等对比算法。模型在前 20 轮训练后即呈现明显的收敛趋势。
QPSLR 算法测试:以端到端查询执行时间为评估指标。在静态工作负载场景下,QPSLR-pairwise 和 QPSLR-listwise 模型相比于 PostgreSQL 自带优化器,在 IMDB 和 STATS 数据集上均显著减少了查询执行时间。在动态工作负载场景下,QPSLR 能更有效地适应查询变化,累计查询执行时间明显少于 PostgreSQL 原生方法。
总体效果:在真实数据集上,估计误差显著降低,查询执行效率提升了19%~49%。
六、总结与展望
本次分享提出了两个核心创新:
- QPR(Tree Transformer 表征) :多维度提取查询级别、计划级别和数据级别特征,通过树注意力机制高效捕捉查询计划树的结构依赖
- QPSLR(排序学习选择) :突破传统回归范式,将查询优化建模为排序问题,精准捕捉计划树之间的相对优劣
我们基于 PostgreSQL 实现了原型系统,实验结果验证了算法的有效性和实用性。
未来研究方向包括:
- 整合数据库运行状态信息(如缓存数据、并发查询情况)到表征编码中
- 探索更加先进的计划枚举策略,为选择模型提供更广泛且有效的候选计划集
- 推进将智能优化算法从外部服务集成到数据库内核的工程化工作


 扫一扫


 388

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


