



在代谢组学研究中,质谱能够从复杂生物样本中捕捉到大量小分子信号,但检测到信号只是第一步,真正困难的是确定它们对应什么分子。目前,可用于比对的实验参考谱库覆盖的已知化合物不足 1%,因此在典型复杂生物样本中,超过 80% 的代谢物通常仍无法被鉴定。与此同时,小分子的结构空间远比 DNA 和蛋白质复杂,同一个分子式可能对应大量不同结构,仅靠不断扩充标准品和参考谱库,很难覆盖如此庞大的化学空间。
针对这一问题,康奈尔大学的研究团队开发了 AI Molecule Explorer(AIMe),一个用于小分子质谱解析的多智能体神经符号 AI 框架。其核心模型 DeepMS²Reasoner 将化学规则、碎裂路径推理与神经网络学习结合起来,从分子结构出发模拟化学键断裂、氢转移等碎裂过程,并预测对应的 MS² 谱。AIMe 由此可以跳出传统「实验质谱—参考谱库」的直接匹配,将未知质谱放到更大的分子结构空间中寻找相关候选。
为了将这种能力扩展到已知小分子空间,研究团队进一步构建了 MS²KOSMOS,为 PubChem 中超过 1 亿种小分子生成 8 亿多张预测 MS² 谱,使可搜索的质谱空间较现有实验谱库扩大约 3 个数量级。对于一张未知质谱,AIMe 不仅可以返回候选分子,还能给出相应的碎裂路径,并将具体质谱峰关联到可能的碎片分子式和结构。研究团队随后通过小鼠肠道微生物相关代谢物和 GNPS 大规模质谱数据,对其未知小分子解析与数据库级注释能力进行了验证。
相关研究成果以「Charting the small-molecule universe from mass spectra with neuro-symbolic AI」为题,已发表于预印本平台 bioRXiv。
查看论文:
https://www.biorxiv.org/content/10.64898/2026.08.05.743095v1
从实验质谱到亿级小分子空间
AIMe 涉及的数据主要承担 3 项任务:训练质谱预测模型、构建可检索的小分子空间,以及检验真实样本中的解析能力。
DeepMS²Reasoner 的训练数据来自 NIST 2020 串联质谱数据库。研究团队保留质子化离子 [M+H]⁺ 和去质子化离子 [M−H]⁻ 的 MS² 谱,剔除含金属化合物以及结构信息不完整的样本,并统一处理质谱峰和分子结构。数据按照完整 InChIKey 划分为 80% 训练集、10% 验证集和 10% 测试集。为减少结构重复带来的影响,最终评估时还排除了与训练分子 Morgan 指纹 Tanimoto 相似度为 1.0 的测试分子。
模型的外部泛化能力则通过 CASMI 2022 和 MassSpecGym 两个独立数据集检验,两者均未参与训练。结构检索实验进一步增加了难度:对于每条实验质谱,除真实结构外,还加入最多 49 个质量接近且结构相似的 PubChem 分子作为干扰项。针对 CASMI,研究又设计了更严格的全异构体测试,将具有相同分子式的全部 PubChem 异构体纳入候选,总计涉及近 250 万张候选质谱。
完成模型训练后,研究范围被扩展至 PubChem 中的已知小分子。对于 m/z < 1000 的超过 1.05 亿种有机化合物,AIMe 分别在正、负离子模式以及 4 种碰撞能量下预测 MS² 谱,生成超过 8 亿张预测质谱,并将其组织为 MS²KOSMOS,为后续未知质谱检索提供基础。
真实应用主要涉及两组数据。一组来自无菌(GF)小鼠和具有完整肠道微生物群的无特定病原体(SPF)小鼠粪便代谢组,研究从中选取 111 个丰度较高、但无法通过现有标准品和谱库鉴定的微生物群依赖型信号。另一组来自 GNPS 公共质谱数据库,经过电荷状态和分子质量等条件过滤后,共有 7,144,480 张共识 MS² 谱进入大规模检索。
让模型学习分子「如何碎裂」
AIMe 由 3 个相互衔接的模块构成:DeepMS²Reasoner 负责从分子结构预测 MS² 谱和碎裂路径;MS²KOSMOSGenerator 调用这一模型,对大规模化学结构进行预测,并构建可搜索的 MS²KOSMOS;MS²KOSMOSMapper 则负责处理实验中的未知质谱,从 MS²KOSMOS 中寻找可能相关的分子和结构邻域。大规模预测提前完成后,实际查询时只需对筛选出的候选结构进行更精细的计算。
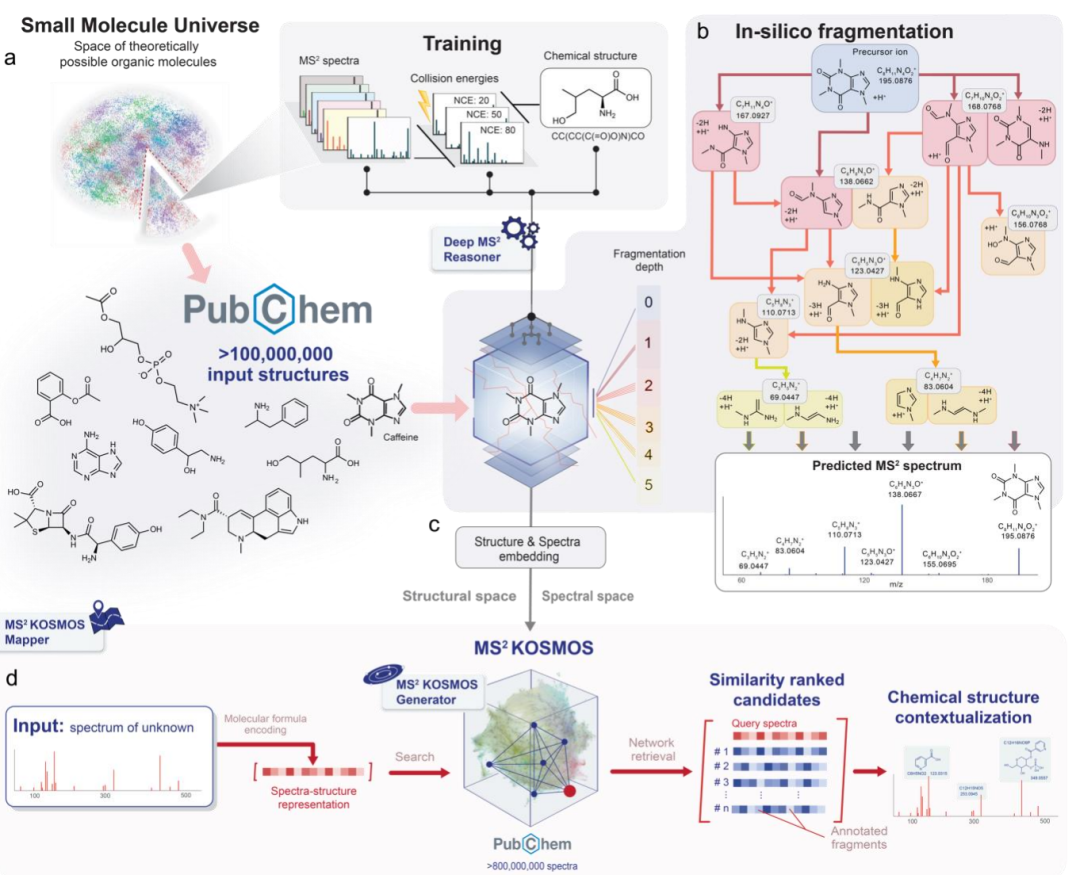
AIMe 整体框架
其中,DeepMS²Reasoner 决定了整个系统的质谱预测能力。它并不直接学习「一个分子对应哪些峰、峰有多强」,而是从前体分子开始,一步步模拟碎裂过程,并动态构建一张有向无环图(DAG)。图中的节点代表不同碎片,边则对应具体的碎裂动作。模型考虑线性键断裂、环键断裂和切除 3 类机制,同时记录电荷变化和氢转移,而且不预先限定碎裂深度,因此能够表示需要多步断键、开环或重排才能形成的复杂碎片。
碎裂路径如何选择,由神经网络组件 ALEA(Action Likelihood Estimator Advisor)负责判断。ALEA 采用 Graphormer 架构,根据当前碎片的原子、化学键、环结构和氢状态,以及碰撞能量、仪器、加合离子等实验条件,为不同碎裂动作和「停止碎裂」分配概率。DeepMS²Reasoner 再沿碎裂路径传播这些概率,由各碎片最终累积的停止概率得到对应的质谱峰强度。
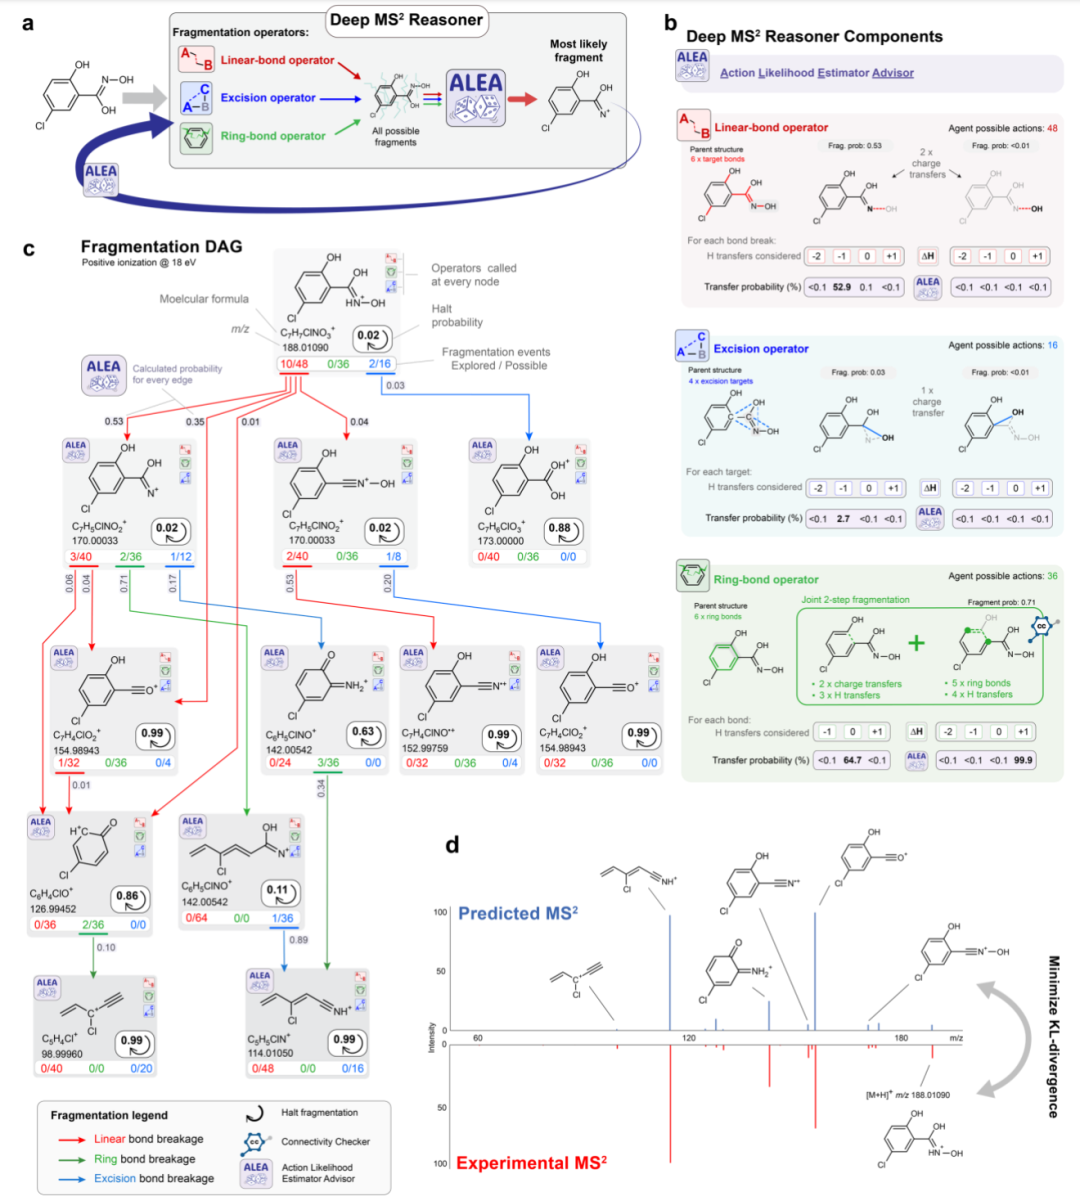
图 2:DeepMS²Reasoner 的碎裂路径生成与 MS² 谱预测过程
神经网络负责判断哪条路径更可能发生,化学规则则负责限制哪些路径可以发生。每一步碎裂之后,系统都会检查分子连接关系、氢平衡等化学约束,不合理的碎裂不会进入后续计算;相同结构和化学状态的碎片会被合并,减少重复搜索。对于概率很低的分支,模型也不会继续展开,从而避免穷举随分子复杂度快速增长的全部碎裂路径。
训练过程中,需要学习参数的主要是 ALEA,其余碎裂操作和化学可行性判断均由确定性规则完成。模型使用 KL 散度衡量预测质谱与实验质谱的差异,同时加入正则化约束,在多种机制都能解释同一质谱峰时,适当优先较简单的线性断键。训练还采用课程学习,从较小、碎裂路径较简单的分子开始,再逐步加入更大、更复杂的化合物,使模型先掌握可迁移的局部碎裂规律。
DeepMS²Reasoner 解决的是「从结构预测质谱」,MS²KOSMOS 则进一步解决「如何在亿级分子中搜索」。MS²KOSMOSGenerator 将每张预测谱表示为由碎片分子式构成的稀疏向量,并建立倒排索引。面对未知质谱时,系统无需逐一比较上亿种分子,而是先找到与查询谱共享碎片分子式的候选,再由 MS²KOSMOSMapper 按照实际碰撞能量等实验条件重新预测候选质谱并排序,同时返回对应的碎裂 DAG。
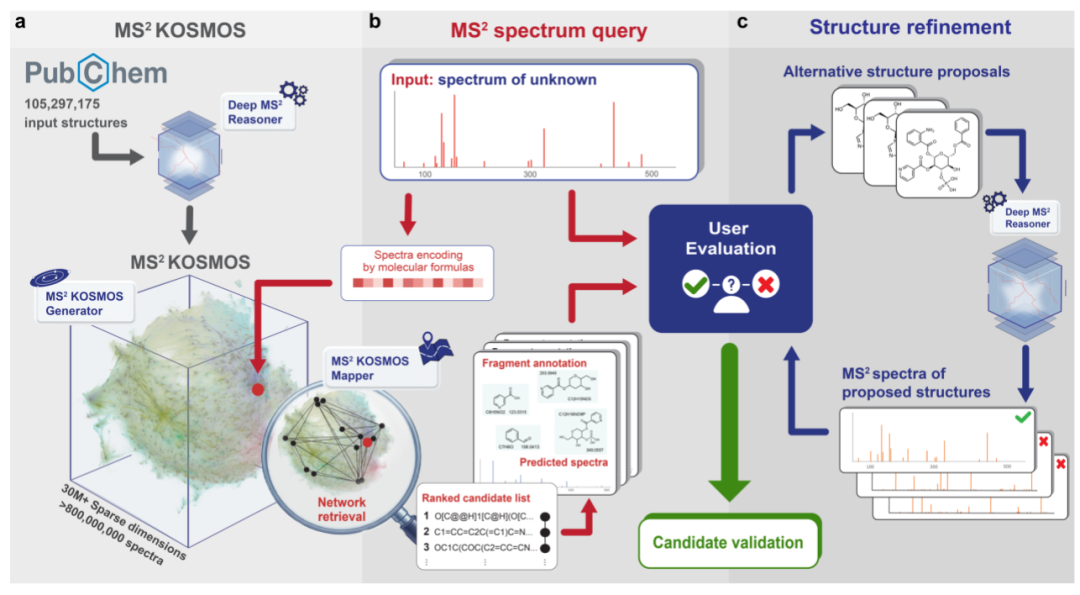
未知质谱在 MS²KOSMOS 中的检索流程
从预测质谱到解析未知分子
研究先从最基础的质谱预测任务检验 DeepMS²Reasoner。在 NIST 2020 独立测试集上,预测谱与实验谱的平均余弦相似度达到 0.83,中位数为 0.89;其他对比模型的平均值则在 0.61—0.75 之间。在完全独立的 CASMI 2022 和 MassSpecGym 数据集上,DeepMS²Reasoner 的平均余弦相似度分别达到 0.67 和 0.59,均为参评模型最高。以 CASMI 为例,超过 40% 的样本中,DeepMS²Reasoner 给出了所有对比模型里最接近实验结果的预测谱。
相比单纯预测质谱,更困难的任务是反过来根据实验谱寻找正确分子。研究将真实结构与大量质量接近、结构相似的候选分子放在一起进行检索。在 CASMI 全异构体测试中,DeepMS²Reasoner 的 Top-1、Top-10 和 Top-50 准确率分别为 35.6%、64.4% 和 79.8%,其中 Top-1 和 Top-10 均比排名第二的 FraGNNet 高出 10 个百分点以上。
模型对多步碎裂的处理能力也通过具体分子进行了验证。以生物素为例,DeepMS²Reasoner 的预测谱与实验谱余弦相似度达到 0.88。部分主要碎片无法通过一次断键形成,而需要经历基团脱除、开环和进一步碎裂等连续过程。模型能够给出这些碎片对应的多步路径,并根据碰撞能量变化预测不同程度的碎裂
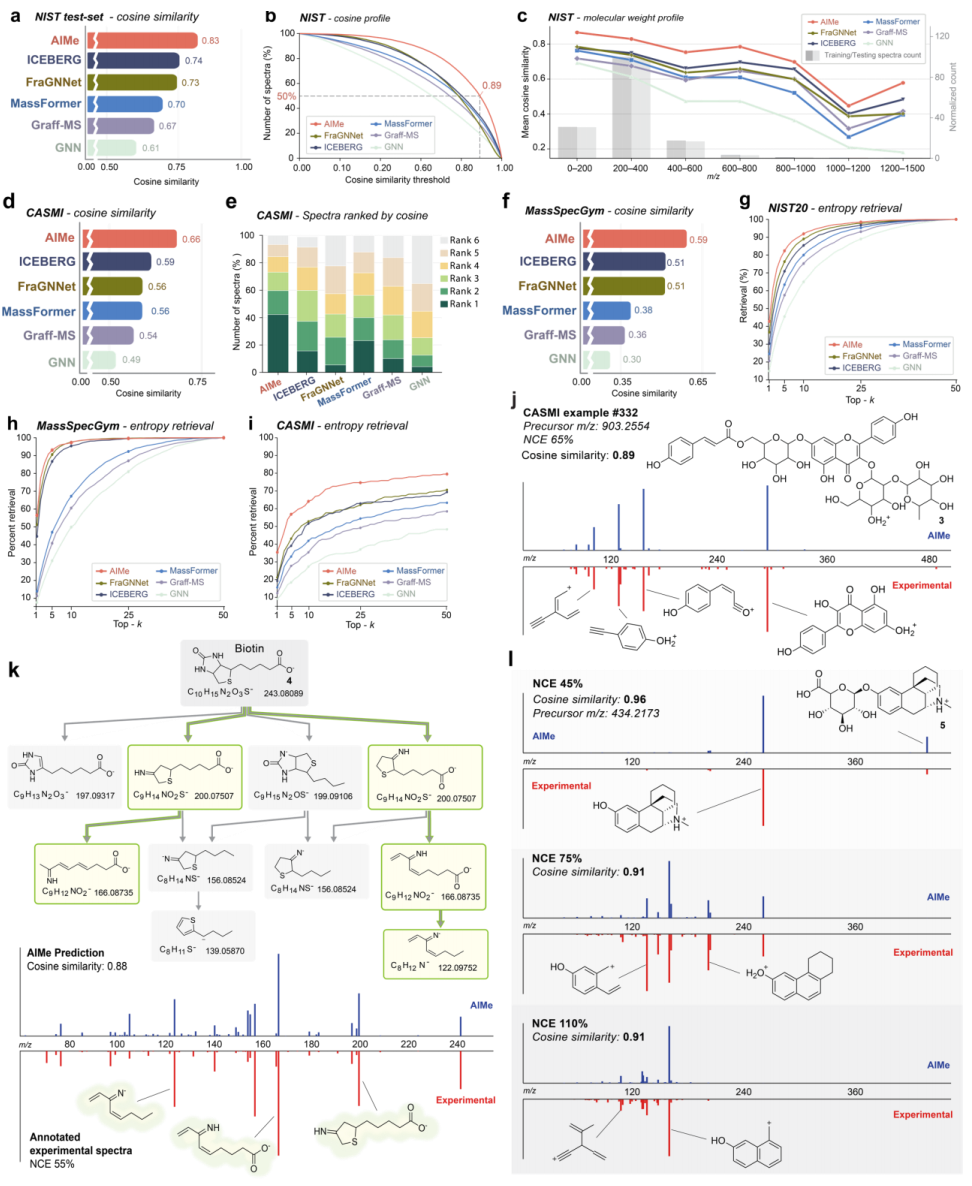
DeepMS²Reasoner 的质谱预测性能
在此之后,研究将 AIMe 用于真正的未知代谢物解析。针对小鼠代谢组中的 111 个未鉴定微生物群依赖型信号,约三分之一能够在 MS²KOSMOS 中找到与已知化合物高度相似的匹配,其余则更可能对应尚未描述的结构。
研究人员进一步选择两个未知物进行结构解析。根据 AIMe 给出的碎片结构,他们分别组合出多种候选分子,再预测这些候选的 MS² 谱并与实验结果比较。其中一个未知物的最佳初始候选余弦相似度已经达到 0.79,但仍缺少几个实验中的关键碎片。研究团队因此继续考虑环化结构,并锁定了一种罕见的大环精胺衍生物。通过化学合成并比较保留时间和 MS² 谱,两种候选结构最终均得到验证,其中还包括此前未在小鼠或人类中报道的多胺结构。进一步检索表明,多种相关代谢物也存在于人源样本中。
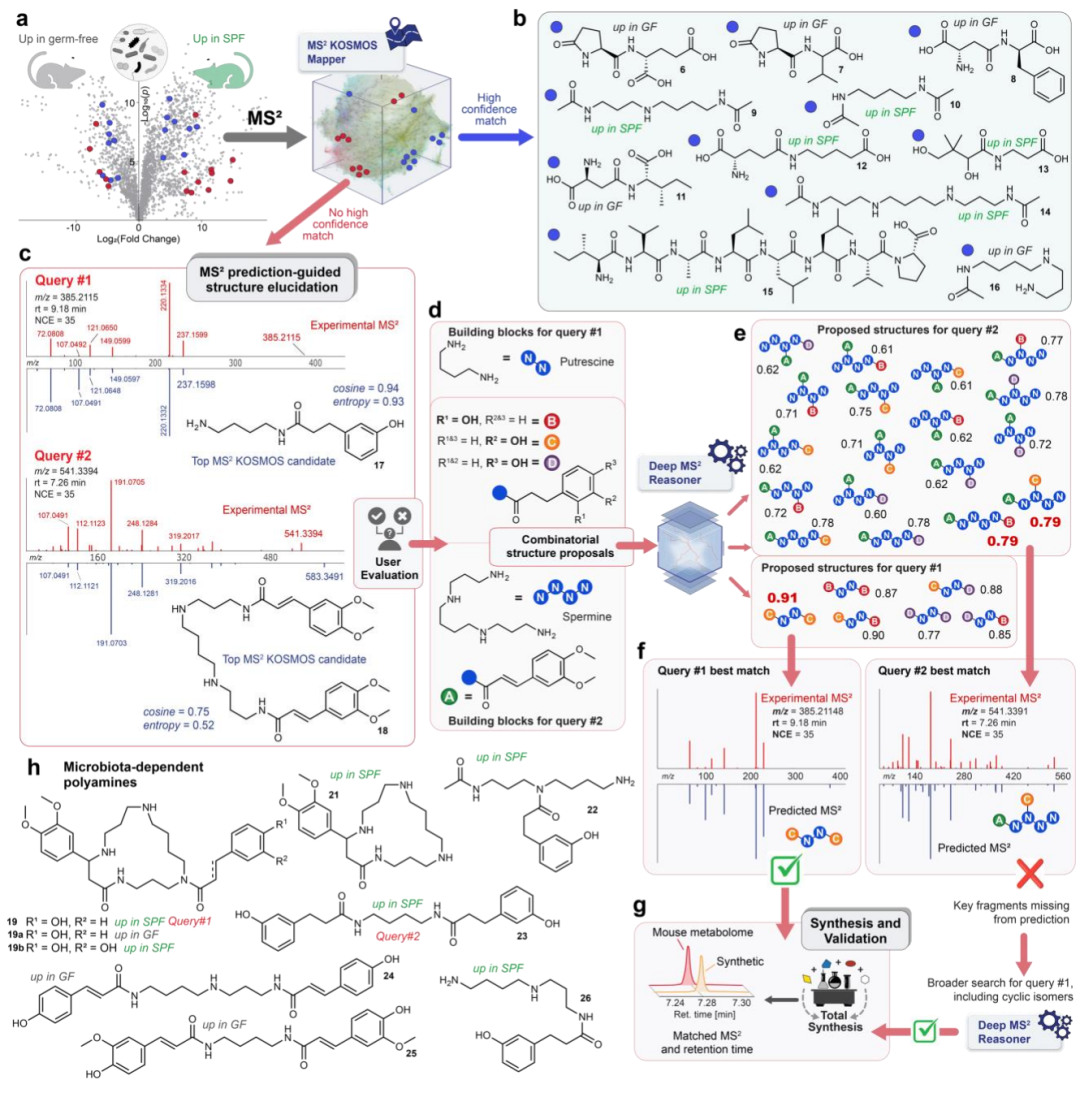
AIMe 辅助解析小鼠肠道微生物相关未知代谢物
最后,研究将 AIMe 扩展到 GNPS 数据库的 714 万余张共识质谱。以余弦相似度 0.7 为阈值,约 269 万张质谱获得候选注释,占查询总量约三分之一;将阈值提高到 0.8 后,仍新增约 127 万个高相似度注释,对应 GNPS 中超过 2600 万张此前没有注释的原始质谱。由此,AIMe 的应用范围从单个分子的质谱预测进一步扩展到了数据库规模的未知物注释。
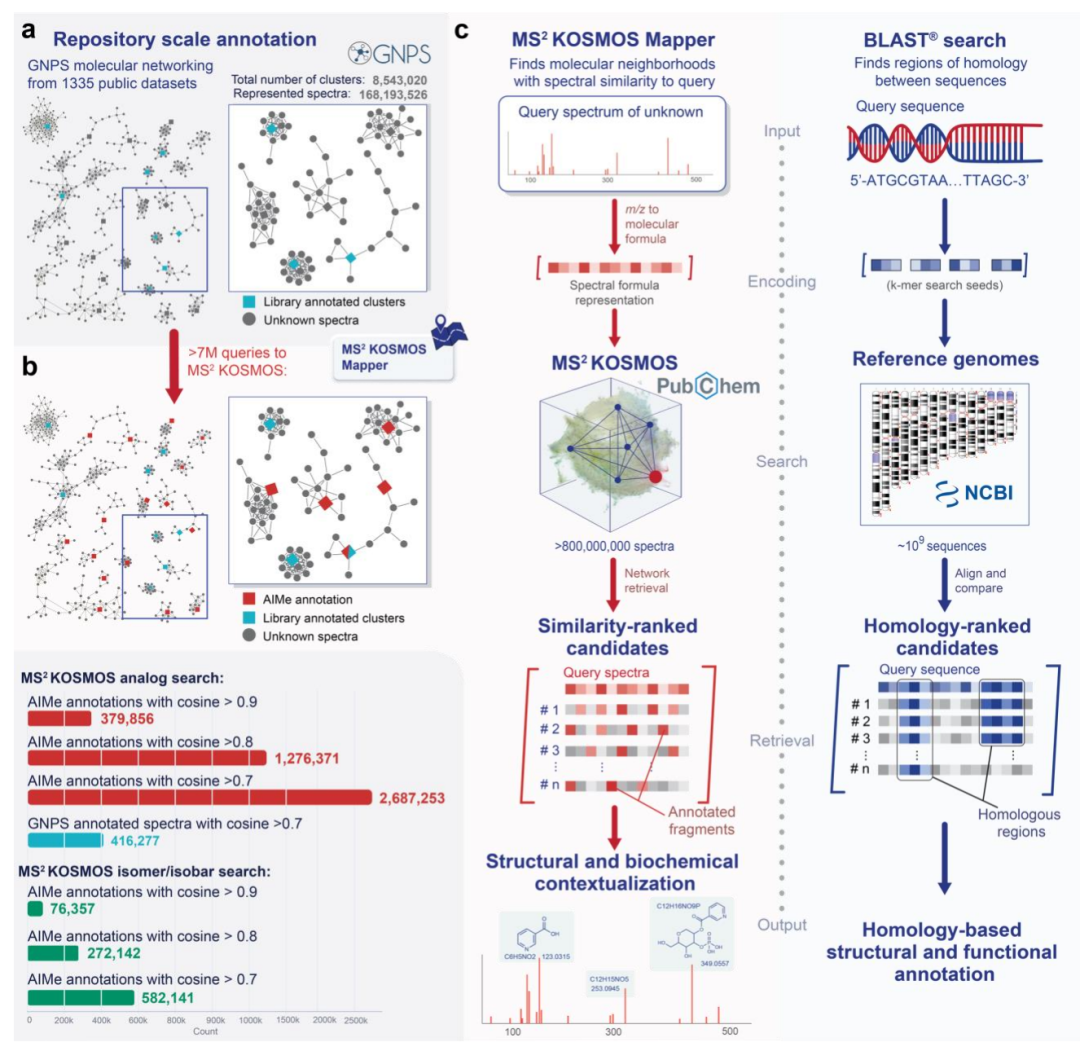
AIMe 在 GNPS 数据库上的大规模注释结果
这些结果并不意味着小分子结构鉴定已经被完全自动化。随着分子量增加,可能的碎裂路径明显增多,而训练数据中大分子的覆盖又相对不足,DeepMS²Reasoner 的预测性能仍会下降。更重要的是,MS² 本身通常不足以完成最终结构确认。按照代谢组学标准,在缺少保留时间、NMR 或标准品等独立证据时,AIMe 给出的结果主要属于 Level 3 注释,其作用更接近于缩小候选范围、提出结构假设并解释碎裂依据,最终确认仍需要实验验证。
写在最后
AIMe 的意义并不只是把质谱预测准确率进一步提高,而是尝试改变未知小分子的解析方式。过去,研究人员面对一张未知质谱,往往只能在规模有限的实验谱库中寻找直接匹配;AIMe 则先利用模型把已知小分子空间转化为一个可以搜索的预测质谱空间,再借助碎片结构和碎裂路径逐步缩小候选范围。它目前还不能取代标准品、NMR 等实验验证,却让大量原本因为「没有参考谱」而难以继续分析的信号获得了进一步追踪的可能。
对于代谢组学而言,这或许比单纯增加一批谱库条目更重要:未知质谱不再只有「匹配上」或「匹配不上」两种结果,而开始能够成为提出和检验结构假设的起点。


 扫一扫


 1408

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


