极简笔记 DeepLabv3+

DeeplabV3+DeeplabV3+网络结构详解 文章目录1 常规卷积与空洞卷积的对比1.1 空洞卷积介1.2 空洞卷积的优点2 DeeplabV3+模型3 DeeplabV3+网络代码4 mobilenetv2网络代码5 感谢链接 聊DeeplabV3+网络前,先看空洞卷积。 1 常规卷积与空洞卷积的对比 1.1 空洞卷积介 空洞卷积(Dilated convolution)如下图所示,其中 r 表示两列之间的距离(r=1就是常规卷积了)。 池化可以扩大感受野,降低数据维度,减少计算量,但是会损失信息,对于语义分割来说,这造成了发展瓶颈。 空洞 阅读详情

【极简笔记】Encoder-Decoder with Atrous Separable Convolution for Semantic Image Segmentation

文章核心:1. 提出DeepLabv3+,采用encoder-decoder结构(其实就是语义分割常用的下采样再上采样);2. 该网络通过带孔卷积可以任意控制encoder feature的resolution,有较好的尺度适应性;3. 采用modified Xception主干网络,并在ASPP(带孔卷积模块)和decoder模块采用depthwise separable convolution;

总之一句话,之前各种文章创新点的堆叠,加上大量的结构调参。
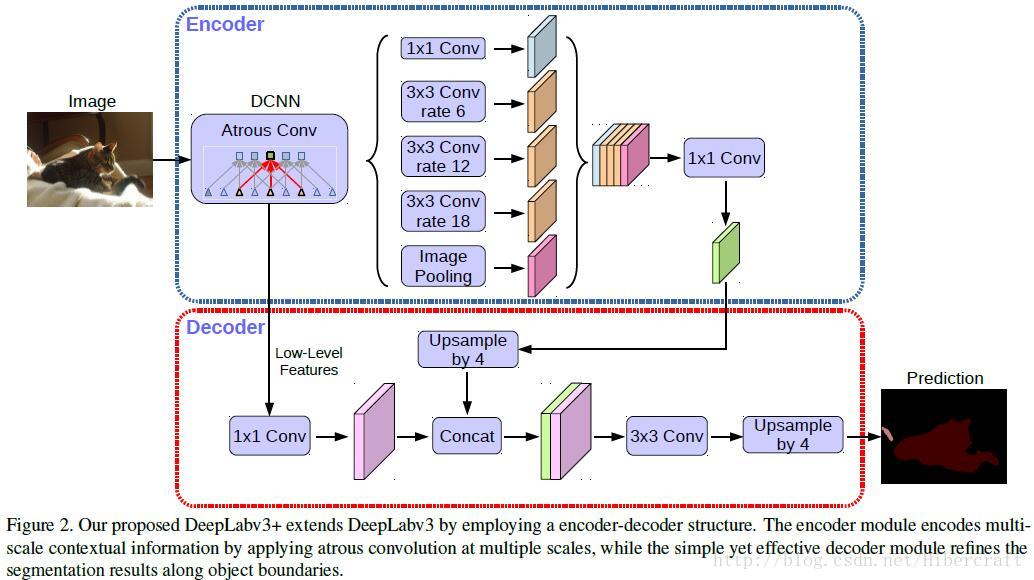
这里写图片描述

encoder-decoder和带孔卷积就不讲了,重点在它怎么合并 。如图在decoder部分,它是双线性上采样x4之后,和浅层通过1x1conv,拥有相同spatial resolution的feature map concatenate,之后再过一个3x3 conv,算是一次stage,这样多来几次回到原图大小。

在Xception的修改上,1. 更多的层;2. max pooling部分用stride=2的depthwise卷积替换;3. 每次depthwise 3x3卷积之后都加上了BN和ReLU。

Deeplabv3+概述(语义分割,小白必看) 关于图像分割的语义分割 阅读详情

相关推荐

DeepLabv3+

一.摘要 本文在进行语义分割任务时将空间金字塔池化模块或encoder-decoder结构引入到深度神经网络中。以前的网络通过对输入的feature map使用多种尺度的卷积核或者池化操作以及多种感受野能够编码出多尺度的环境信息。而之后的一些工作中提出的网络通过逐渐恢复空间信息能够捕获更加精细的物体边界。在本文中,将以上两种优势(多尺度特征+恢复空间信息)进行结合。特别地,本文提出的deeplabv3+deeplabv3的基础上加入了单却有效的decoder模块去细化分割结果,特别是物体的边界。 二

yy2050645的博客 2万+

DeepLabV3网络

接着上篇DeepLab V2,本博文单介绍下DeepLab V3(建议先去看下之前讲的DeepLab V1和DeepLab V2)。这是一篇2017年发表在CVPR上的文章。个人单阅读完论文后感觉相比DeepLab V2有三点变化:1)引入了Multi-grid,2)改进了ASPP结构,3)把CRFs后处理给移除掉了。再吐槽一下,这篇论文看着感觉乱糟糟的。本篇博文就不按照论文的顺序去写了,直接按照我个人的想法去写。

霹雳吧啦Wz 3万+

笔记 DeepLab系列比较

笔记 DeepLab系列比较 之前有写deeplabv3+的论文笔记,因为最近要写调研报告,就大致浏览了deeplab系列的论文,了解发展过程。本篇包含了很多其他笔记的摘要,会在最后列出。 DeepLabv1: https://arxiv.org/pdf/1412.7062v4.pdf 首次提出atrous conv和网络最后加CRF的操作。 - 主要是对原有VGG网络进行了一些变换...

Hibercraft的博客 1711

解析DeepLabv3+的网络结构及代码【Pytorch版】

主要结合DeepLabv3+的网络结构和开源代码进行了对照解析。通过对网络结构中的每一块的作用及其代码实现中的细节进行了解,就能够对该网络模型有一个宏观和微观上的把握。

AI数据工厂 7万+

深度学习之图像分割—— deeplabv3基本思想和网络结构以及论文补充

真正采用的膨胀系数应该是图中的rate乘上Multi-Grid参数,比如Block4中rate=2,Multi-Grid=(1, 2, 4)那么真正采用的膨胀系数是2 x (1, 2, 4)=(2, 4, 8)。首先回顾下上篇博文中讲的DeepLab V2中的ASPP结构,DeepLab V2中的ASPP结构其实就是通过四个并行的膨胀卷积层,每个分支上的膨胀卷积层所采用的膨胀系数不同(注意,这里的膨胀卷积层后没有跟BatchNorm并且使用了偏执Bias)。接着通过add相加的方式融合四个分支上的输出。

qq_44832832的博客 2092

【霹雳吧啦】手把手带你入门语义分割の番外7:DeepLabv3 源码讲解(PyTorch)

这篇文章是作者根据 B 站 霹雳吧啦Wz 的 《 DeepLabV3 源码解析 (Pytorch) 》系列所作的学习笔记,主要对train.py、deeplabv3_model.py 文件进行具体讲解。作者小白,请多包涵!

作者正在煮茶中... 2234

1.deeplabv3+网络结构及原理

这里的网络结构及原理可以看这篇博客,该博客翻译原论文解释得很清楚。

weixin_71719718的博客 6341

语义分割模型 DeepLabv3DeepLabv3+ 总结

DeepLab 模型首次亮相于 ICLR '14,是一系列旨在解决语义分割问题的深度学习架构。经过多年的迭代改进,同一组 Google 研究者于 2017 年底发布了广受欢迎的 “DeepLabv3”。当时,DeepLabv3 在 Pascal VOC 2012 测试集上取得了最佳 (SOTA) 性能,在著名的 Cityscapes 数据集上以及使用 Google 内部 JFT 数据集进行训练时也取得了相当不错的结果。

小拉拉的博客 5001

图像分割经典论文调研:DeepLabV3DeepLabV3+、DenseASPP

本文选取了三篇图像分割初期的经典论文:DeepLabV3DeepLabV3+、DenseASPP,重点关注每篇论文要解决什么问题、针对性提出什么方法、为什么这个方法能解决这个问题

yzfzzz的博客 3289

图像分割:DeepLabV3DeepLabV3+介绍

DeepLabV3DeepLabV3+网络的单介绍

weixin_39357271的博客 2万+

FCN、Unet、deeplabv1、deeplabv2、deeplabv3deeplabv3+的网络

FCN 通常情况下,FCN可以分为3种:FCN-32、FCN-16、FCN-8(分别表示32倍上采样、16倍上采样、8倍上采样)。 16上采样过程:先把32倍下采样的feature map上采样2倍,变成16倍下采样feature map,再和原来16倍下采样的feature map进行connect操作。最后,16倍双线性插值到原图像大小。 8上采样过程:先把32倍下采样的featu...

c_daofeng的博客 9501

DeepLabV3+: 在DeepLabV3基础上引入了Decoder

DeepLabv3作为Encoder提取特征,上采样后与backbone中间的低级特征以concat的方式融合,然后利用3*3卷积获得细化的特征,最后再进行上采样恢复到原始分辨率;在backbone部分,使用可分离卷积改进了Xception。

AI数据工厂 9684

DeepLabV3+神经网络解析

DeepLabV3+神经网络解析论文:Encoder-Decoder with Atrous Separable Convolution for Semantic Image Segmentation什么是DeeplabV3+网络deeplabV3+主要结构主干网络(DCNN)空洞卷积(膨胀卷积)空洞空间卷积池化金字塔(atrous spatial pyramid pooling (ASPP))利用特征获得预测结果损失函数结果对比 论文:Encoder-Decoder with Atrous Separab

Jkway 9659

搭建自己的语义分割平台deeplabV3+

搭建deeplabV3+网络 数据准备 源码修改 训练 测试

Lightismore的博客 4585

Deeplabv3+ 阅读笔记

Notes: 谷歌deeplabv3+的代码现在已经开源,详见deeplab(Github),还有一个使用的demo样例。 0. spatial pyramid pooling probing the incoming features with filters or pooling operations at multiple rates and multiple effecti...

feitianlzk的博客 6984

DeepLabv3+分析

DeepLabv3+ Encoder-Decoder with Atrous Separable Convolution for Semantic Image Segmentation 原文地址:DeepLabv3+ 注意本文的一作Liang−ChiehChen参与了DeepLab系列,MaskLab和MobileNet系列的工...

分享顶会顶刊论文即插即用模块 7232

DeepLabv3+ 模型详解

DeepLabv3+ 模型详解 文章目录DeepLabv3+ 模型详解1 介2 Encoder2.1 ResNet-101 as Network Backbone2.1.1 问:在“基础”的卷积神经网络中持续叠加更深的层数会发生什么?2.1.2 问:为什么ResNet中的残差模块会有用呢?2.1.3 ResNet的残差模块2.1.4 ResNet的网络结构2.1.5 ResNet的Pytorch实现2.2 ASPP结构2.2.1 SPP结构2.2.2 Atrous Convolution2.2.3 ASP

胡克林的博客 1万+

Deeplabv3学习:一种语义分割模型

DeepLabV3 是由 Google 研究团队研发并专门用于图像语义分割的一种深度学习模型。

qq_63318216的博客 2263
上一篇: 【极简笔记】CycleGAN
下一篇: 极简笔记 Path Aggregation Network for Instance Segmentation
Hibercraft
博客等级 码龄9年 78粉丝 38原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

红包个数最小为10个

红包金额最低5元

当前余额3.43前往充值 >
需支付:10.00
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值