


前言:
一:命名空间(namespace)
1.为什么要用命名空间
命名空间(namespace)是 C++ 用namespace 关键字把标识符(变量、函数、类型)的名字"关"进一个独立的作用域里,从而避免命名冲突和名字污染的机制。
可以看一个c语言中的例子:
#include <stdio.h>
#include <stdlib.h>

int rand = 10;        // 想定义一个叫 rand 的变量

int main()
{
    // 编译报错:“rand”: 重定义;以前的定义是“函数”
    printf("%d\n", rand);
    return 0;
}
结果报错: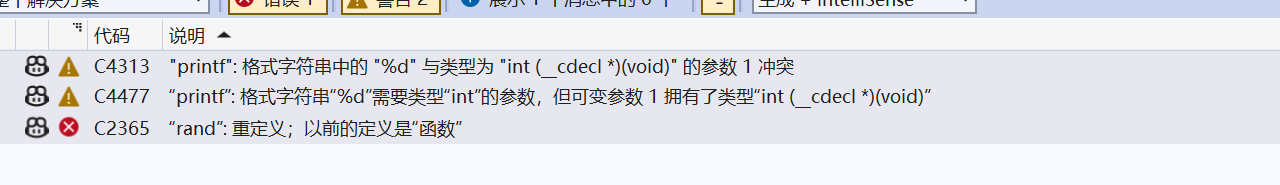
因为<stdlib.h> 里已经有一个 rand() 函数,又定义了一个全局变量 rand——全局作用域只有一个,名字撞车就直接编译报错。这在 C 项目里是普遍存在的问题。
C++ 引入 namespace 就是为了更好地解决这类问题。
2.命名空间的使用
namespace 名字        // 名字一般用项目名可用自己名字缩写
{
    // 里面可以定义变量 / 函数 / 类型
}
以上面rand变量举例,将rand放入namespace里,就不会报错
#include <stdio.h>
#include <stdlib.h>

// 1. 正常的命名空间定义
namespace hu
{
    int rand = 10;                       // 变量
}

int main()
{
    // 默认访问的是全局的 rand 函数指针
    printf("%p\n", rand);

    // 指定 hu 命名空间中的 rand
    printf("%d\n", hu::rand);//:: 叫作用域解析运算符

    return 0;
}
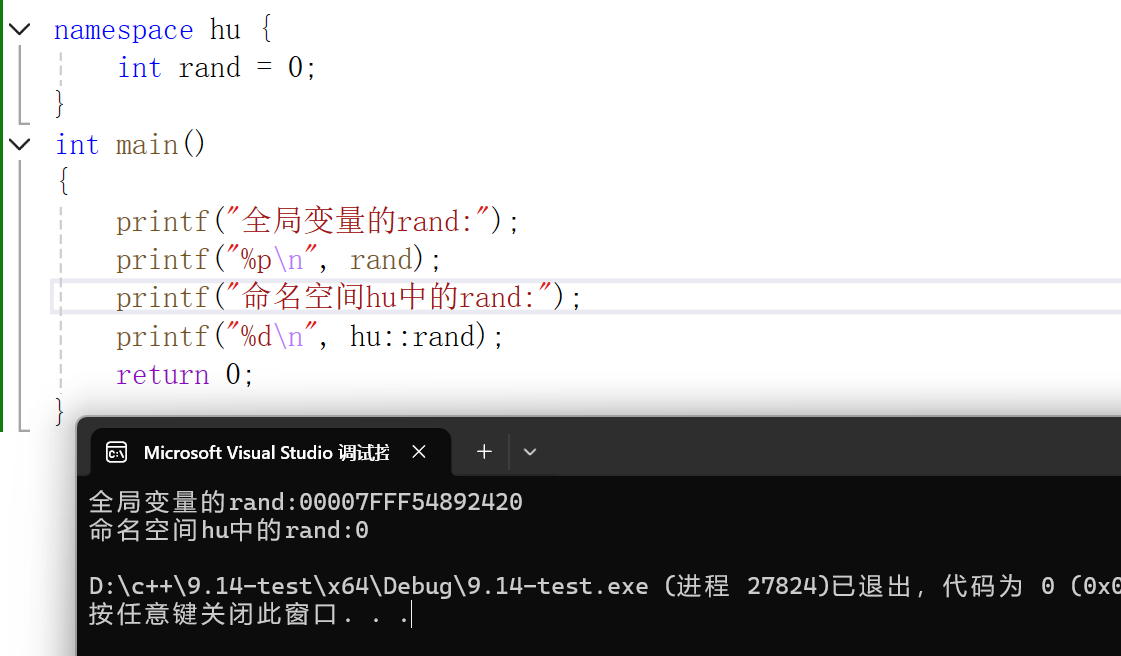
namespace 的本质是"定义出一个域"
这个域跟全局域各自独立,所以不同的域可以定义同名变量。上面的 rand 就不再冲突了——全局有自己的 rand,hu 域里有自己的 rand。
3.c++中的4种域
| 域 | 影响编译查找 | 影响变量生命周期 |
|---|---|---|
| 函数局部域 | ✅ | ✅ |
| 全局域 | ✅ | ✅ |
| 命名空间域 | ✅ | ❌ 不影响 |
| 类域 | ✅ | ❌ 不影响 |
域影响的是编译时语法查找一个变量/函数/类型出处(声明或定义)的逻辑,所有有了域隔离,名字冲突就解决了。局部域和全局域除了影响编译查找逻辑,还会影响变量的生命周期;命名空间域和类域不影响变量生命周期。
这一点很关键:命名空间里的变量仍然是全局变量(存在静态区、生命周期同程序),它只是换了名字查找的路径,不是变成了局部变量。
4.namespace 只能定义在全局,且可以嵌套
namespace byte
{
	namespace hu {
		int rand = 10;
	}
	namespace yu {
		int rand = 20;
	}
}

int main()
{
	printf("%d\n", byte::hu::rand);
	printf("%d\n", byte::yu::rand);
	return 0;
}
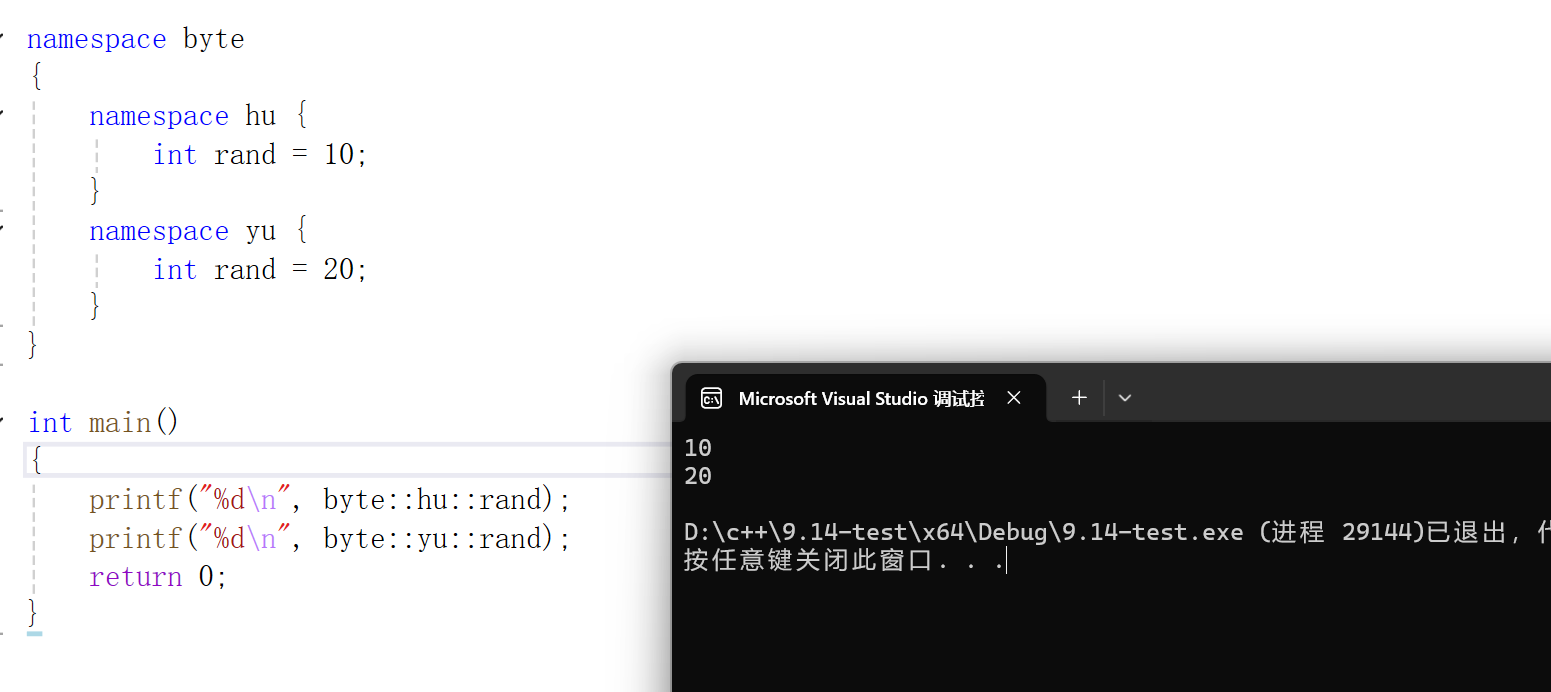
5. 多文件中定义的同名 namespace 会合并成一个
// Stack.h
#pragma once
#include<stdio.h>
#include<stdlib.h>
#include<stdbool.h>
#include<assert.h>
namespace byte
{
    typedef int STDataType;
    typedef struct Stack
    {
        STDataType* a;
        int top;
        int capacity;
    }ST;

    void STInit(ST* ps, int n);
    void STDestroy(ST* ps);
    void STPush(ST* ps, STDataType x);
    void STPop(ST* ps);
    STDataType STTop(ST* ps);
    int STSize(ST* ps);
    bool STEmpty(ST* ps);
}
// Stack.cpp
#include"Stack.h"
namespace byte                      // 同名 → 自动合并到同一个 bit 中
{
    void STInit(ST* ps, int n)
    {
        assert(ps);
        ps->a = (STDataType*)malloc(n * sizeof(STDataType));
        ps->top = 0;
        ps->capacity = n;
    }
    void STPush(ST* ps, STDataType x) { /* ... */ }
    // ...
}
6.名字查找默认不到命名空间里找
编译查找一个变量的声明/定义时,默认只会在局部或者全局查找,不会到命名空间里面去查找。
#include<stdio.h>
namespace byte
{
    int a = 0;
    int b = 1;
}
int main()
{
    // 编译报错: “a”: 未声明的标识符
    printf("%d\n", a);
    return 0;
}
只有指定命名空间中的值才可以查询到
#include<stdio.h>
namespace byte
{
    int a = 0;
    int b = 1;
}
int main()
{
    // 编译报错: “a”: 未声明的标识符
    printf("%d\n",byte:: a);
    return 0;
}
7.namespace的4种常见使用方法
| 方式 | 写法 | 建议 |
|---|---|---|
| ① 指定命名空间访问 | N::a | 项目中推荐这种方式 |
| ② using 将命名空间中某个成员展开 | using N::b; | 项目中经常访问的不存在冲突的成员推荐 |
| ③ 展开命名空间中全部成员 | using namespace N; | 项目不推荐,冲突风险很大;日常小练习程序为了方便推荐使用 |
① 指定命名空间访问
//  指定命名空间访问
int main()
{
    printf("%d\n", N::a);
    return 0;
}
② using 将命名空间中某个成员展开
//  using 展开某个成员
using N::b;
int main()
{
    printf("%d\n", N::a);
    printf("%d\n", b);      // 可以直接用 b 了
    return 0;
}
③ 展开命名空间中全部成员
//  展开全部成员
using namespace N;
int main()
{
    printf("%d\n", a);
    printf("%d\n", b);
    return 0;
}
为什么项目里不推荐 using namespace std;?
因为它把整个标准库几千个名字都倒进了全局域,一旦你自己的函数/变量名跟标准库撞了(比如自己写了个 count、data、swap),就会出现歧义或意外调用到标准库版本,而且报错信息极难定位。
二:C++输⼊和输出
2.1 <iostream> 与三个标准对象
<iostream> 是 Input Output Stream(输入输出流) 的缩写,是 C++ 标准的输入、输出流库,其中定义了标准的输入、输出对象。
| 名字 | 类型 | 含义 |
|---|---|---|
std::cin | istream 类的对象 | 主要面向窄字符(narrow characters, of type char)的标准输入流 |
std::cout | ostream 类的对象 | 主要面向窄字符的标准输出流 |
std::endl | 一个函数(函数模板) | 流插入输出时,相当于插入一个换行字符 + 刷新缓冲区 |
在c语言中实现的hello world如下:
int main()

{
	printf("hello world\n");
	return 0;
}
而在c++中则是这样:
#include<iostream>
int main()

{
	std::cout <<" hello world\n";
	return 0;
}
2.2 << 和 >>:被"复用"的运算符
<< 是流插入运算符,>> 是流提取运算符。(C 语言还用这两个运算符做位运算左移/右移)
#include<iostream>
int main()

{
	std::cout <<" hello world\n";//输出,在屏幕上打印hello world
	return 0;
}
#include<iostream>
int main()

{
	int a = 0;
	//std::cout <<" hello world\n";
	std::cin >> a;//输入a的值
	std::cout << a;//在屏幕上打印所输入的值
	return 0;
}
2.3 最大的优势:自动识别类型
使用 C++ 输入输出更方便,不需要像 printf/scanf 输入输出时那样,需要手动指定格式,C++ 的输入输出可以自动识别变量类型。
#define _CRT_SECURE_NO_WARNINGS 1
#include <iostream>
using namespace std;

int main()
{
    int a = 0;
    double b = 0.1;
    char c = 'x';

    cout << a << " " << b << "  " << c << endl;
    std::cout << a << " " << b << "  " << c << std::endl;

    scanf("%d%lf", &a, &b);       // C 风格:必须写 %d %lf
    printf("%d %lf\n", a, b);

    cin >> a;                     // C++ 风格:自动识别类型
    cin >> b >> c;
    cout << a << endl;
    cout << b << "  " << c << endl;
    return 0;
}
这里我们没有包含 <stdio.h>,也可以使用 printf 和 scanf,在包含 <iostream> 间接包含了。VS 系列编译器是这样的,其他编译器可能会报错。
2.4 endl vs '\n':换行 + 刷新
std::endl 是一个函数,流插入输出时,相当于插入一个换行字符加刷新缓冲区。
cout << "hello" << endl;    // 换行 + 刷新缓冲区
cout << "hello" << '\n';    // 只换行,不刷新
- 大量输出(循环里、竞赛题)用
'\n',别用endl;否则每次刷新都会拖慢程序; - 需要立即看到输出的场景用
endl(如交互式提示、崩溃前想看到日志)。
2.5 命名空间与 using namespace std
cout/cin/endl 等都属于 C++ 标准库,C++ 标准库都放在一个叫 std(standard)的命名空间中,所以要通过命名空间的使用方式去用他们。 一般日常练习中我们可以 using namespace std,实际项目开发中不建议 using namespace std,前面提到过原因。
#include <iostream>

int main()
{
    std::cout << "必须写 std::" << std::endl;      // 方式1:指定命名空间访问(项目推荐)
    return 0;
}
#include <iostream>
using std::cout;        // 方式2:只展开需要的(项目里最常用)
using std::endl;

int main()
{
    cout << "只展开用到的名字" << endl;
    return 0;
}
#include <iostream>
using namespace std;    // 方式3:全部展开(小练习方便,项目不推荐)

int main()
{
    cout << "方便但有冲突风险" << endl;
    return 0;
}
三:缺省参数
3.1 定义
缺省参数是声明或定义函数时为函数的参数指定一个缺省值。在调用该函数时,如果没有指定实参则采用该形参的缺省值,否则使用指定的实参,缺省参数分为全缺省和半缺省参数。
void Func(int a = 0)      // 声明时给 a 指定缺省值 0
{
    cout << a << endl;
}

int main()
{
    Func();      // 没有传参 → 使用缺省值 0,输出 0
    Func(10);    // 传参     → 使用指定实参 10,输出 10
    return 0;
}
3.2 全缺省 vs 半缺省
全缺省就是全部形参给缺省值,半缺省就是部分形参给缺省值。
#include <iostream>
using namespace std;

// 全缺省:所有形参都有缺省值
void Func1(int a = 10, int b = 20, int c = 30)
{
    cout << "a = " << a << endl;
    cout << "b = " << b << endl;
    cout << "c = " << c << endl << endl;
}

// 半缺省:只有后面的部分形参有缺省值
void Func2(int a, int b = 10, int c = 20)
{
    cout << "a = " << a << endl;
    cout << "b = " << b << endl;
    cout << "c = " << c << endl << endl;
}

int main()
{
    Func1();              // 10 20 30
    Func1(1);             //  1 20 30
    Func1(1, 2);          //  1  2 30
    Func1(1, 2, 3);       //  1  2  3

    // Func2();           // 编译报错:a 没有实参也没有缺省值
    Func2(100);           // 100 10 20
    Func2(100, 200);      // 100 200 20
    Func2(100, 200, 300); // 100 200 300
    return 0;
}
3.2.1 C++ 规定半缺省参数必须从右往左依次连续缺省,不能间隔跳跃给缺省值。
// 正确:从右往左连续
void f(int a, int b = 2, int c = 3);      // 缺省的是 b、c(右边连续两个)

// 错误:中间跳过了
//void f(int a = 1, int b, int c = 3);    // b 在中间没缺省值
//void f(int a = 1, int b = 2, int c);    // 最右边反而没缺省值
3.2.2 带缺省参数的函数调用,C++ 规定必须从左到右依次给实参,不能跳跃给实参。
void f(int a, int b = 2, int c = 3);

f(1);         // a=1, b=2, c=3
f(1, 5);      // a=1, b=5, c=3
f(1, 5, 8);   // a=1, b=5, c=8

// f(1, , 8);   //  语法都不合法,不能"跳过 b 只给 c"
3.2.3 函数声明和定义分离时,缺省参数不能在函数声明和定义中同时出现,规定必须函数声明给缺省值。
// Stack.h
#include <iostream>
#include <assert.h>
using namespace std;
typedef int STDataType;
typedef struct Stack
{
    STDataType* a;
    int top;
    int capacity;
}ST;

void STInit(ST* ps, int n = 4);      //  缺省值给在【声明】处
// Stack.cpp
#include"Stack.h"

// 缺省参数不能声明和定义同时给
void STInit(ST* ps, int n)           //  定义处【不写】缺省值
{
    assert(ps && n > 0);
    ps->a = (STDataType*)malloc(n * sizeof(STDataType));
    ps->top = 0;
    ps->capacity = n;
}
// test.cpp
#include"Stack.h"
int main()
{
    ST s1;
    STInit(&s1);                     // 使用缺省值 4

    // 确定知道要插入 1000 个数据,初始化时一把开好,避免扩容
    ST s2;
    STInit(&s2, 1000);               // 使用指定实参
    return 0;
}
为什么要这样规定?
因为缺省参数是在编译期、在"调用点"被替换成实参的——它属于"编译期语法糖",编译器看到 STInit(&s1) 时,需要当场把它变成 STInit(&s1, 4)。而:
test.cpp只#include "Stack.h",它看不到Stack.cpp里的定义;- 如果缺省值写在定义(
.cpp)里,test.cpp编译时根本不知道有缺省值,就会报"参数太少"的错。
四:函数重载
4.1 定义
C++ 支持在同一作用域中出现同名函数,但是要求这些同名函数的形参不同,可以是参数个数不同或者类型不同。这样 C++ 函数调用就表现出了多态行为,使用更灵活。C 语言是不支持同一作用域中出现同名函数的。
4.2 构成重载的三种情况
#include<iostream>
using namespace std;

// 1、参数类型不同
int Add(int left, int right)
{
    cout << "int Add(int left, int right)" << endl;
    return left + right;
}
double Add(double left, double right)
{
    cout << "double Add(double left, double right)" << endl;
    return left + right;
}

// 2、参数个数不同
void f()
{
    cout << "f()" << endl;
}
void f(int a)
{
    cout << "f(int a)" << endl;
}

// 3、参数类型顺序不同
void f(int a, char b)
{
    cout << "f(int a,char b)" << endl;
}
void f(char b, int a)
{
    cout << "f(char b, int a)" << endl;
}

int main()
{
    Add(10, 20);         // → int Add(int left, int right)
    Add(10.1, 20.2);     // → double Add(double left, double right)
    f();                 // → f()
    f(10);               // → f(int a)
    f(10, 'a');          // → f(int a,char b)
    f('a', 10);          // → f(char b, int a)
    return 0;
}
4.3 四种"看起来像重载但不是"的情况
4.3.1 返回值不同 —— 不能作为重载条件
// 返回值不同不能作为重载条件,因为调用时也无法区分
//void fxx()
//{}
//
//int fxx()
//{
//        return 0;
//}
4.3.2 仅顶层 const 修饰值参数 —— 不能重载
void g(int a);
//void g(const int a);    // 报"重定义":与上面是同一个函数
4.3.3 但 const 修饰"引用/指针所指对象" —— 可以重载(引用后面会讲)
void h(int& x);              // 左值引用版本
void h(const int& x);        // const 左值引用版本(还能接右值)构成重载

int a = 1;
h(a);                        // → h(int&)
h(10);                       // → h(const int&)  字面量只能绑 const 引用
const int b = 2;
h(b);                        // → h(const int&)
4.3.4 仅靠缺省参数 —— 不构成重载,反而制造歧义
void f(int a);
void f(int a = 1);        // 不构成重载(形参列表相同)→ 报重定义
五:引用
5.1 概念和语法
引用不是新定义一个变量,而是给已存在变量取了一个别名,编译器不会为引用变量开辟内存空间,它和它引用的变量共用同一块内存空间。 比如:水浒传中李逵,宋江叫"铁牛",江湖上人称"黑旋风";林冲,外号豹子头。
类型& 引用别名 = 引用对象;
1.& 紧跟在类型后面(int& b),而不是变量名后面。int & b 和 int& b 等价
2.定义时必须初始化,int& ra; 直接编译报错;
3.引用不是对象,它没有独立地址,&b 得到的是 a 的地址。
5.2 三大特性
1.引用在定义时必须初始化
2.一个变量可以有多个引用
3.引用一旦引用一个实体,再不能引用其他实体
int main()
{
    int a = 10;

    // 编译报错:“ra”: 必须初始化引用
    //int& ra;

    int& b = a;
    int c = 20;

    // 这里并非让 b 引用 c,因为 C++ 引用不能改变指向,
    // 这里是一个赋值
    b = c;

    cout << &a << endl;   // 与 &b 相同
    cout << &b << endl;
    cout << &c << endl;   // 与前两个不同
    return 0;
}
5.3 使用场景
引用在实践中主要是于引用传参和引用做返回值中减少拷贝提高效率和改变引用对象时同时改变被引用对象。 引用传参跟指针传参功能是类似的,引用传参相对更方便一些。
5.3.1 引用传参
修改实参
void Swap(int& rx, int& ry)
{
    int tmp = rx;
    rx = ry;
    ry = tmp;
}
int main()
{
    int x = 0, y = 1;
    cout << x << " " << y << endl;   // 0 1
    Swap(x, y);                     // 直接传变量名,不需要 &x, &y
    cout << x << " " << y << endl;   // 1 0
    return 0;
}
5.3.2 引用做返回值
引用返回让函数调用成为"左值"
int& STTop(ST& rs)
{
 return rs.a[rs.top];
}                                              // 返回数组元素的引用
STTop(st1) += 10;                              // 相当于 rs.a[rs.top] += 10
5.4 不要返回局部对象的引用(野引用)
传值返回会产生一个临时对象调用拷贝构造,传引用返回,返回的是返回对象的别名(引用),没有产生拷贝。但是如果返回对象是一个当前函数局部域的局部对象,函数结束就销毁了,那么使用引用返回是有问题的,这时的引用相当于一个野引用,类似一个野指针一样。传引用返回可以减少拷贝,但是一定要确保返回对象,在当前函数结束后还在,才能用引用返回。
// Date Func2()
Date& Func2()
{
    Date tmp(2024, 7, 5);
    tmp.Print();
    return tmp;        // tmp 是局部对象,函数结束就销毁
}

int main()
{
    Date ret = Func2();   // 读的是已销毁对象的"幽灵内存" —— 未定义行为
    ret.Print();
}
5.5 const 引用
5.5.1 核心规则:权限只能缩小,不能放大
可以引用一个 const 对象,但是必须用 const 引用。const 引用也可以引用普通对象,因为对象的访问权限在引用过程中可以缩小,但是不能放大。
int main()
{
    const int a = 10;

    // 编译报错:“初始化”: 无法从“const int”转换为“int &”
    // 这里的引用是对 a 访问权限的放大
    //int& ra = a;

    // 这样才可以
    const int& ra = a;

    // 编译报错:“ra”: 不能给常量赋值
    //ra++;

    // 这里的引用是对 b 访问权限的缩小
    int b = 20;
    const int& rb = b;

    // 编译报错:“rb”: 不能给常量赋值
    //rb++;

    return 0;
}
5.5.2 临时对象必须用 const 引用
不需要注意的是类似
int& rb = a*3; double d = 12.34; int& rd = d;这样一些场景下a*3的和结果保存在一个临时对象中,int& rd = d也是类似,在类型转换中会产生临时对象存储中间值,也就是时,rb和rd引用的都是临时对象,而 C++ 规定临时对象具有常性,所以这里就触发了权限放大,必须要用常引用才可以。
所谓临时对象就是编译器需要一个空间暂存表达式的求值结果时临时创建的一个未命名的对象,C++ 中把这个未命名对象叫做临时对象。
int main()
{
    int a = 10;

    const int& ra = 30;        //字面量 → 临时对象

    // 编译报错: “初始化”: 无法从“int”转换为“int &”
    // int& rb = a * 3;
    const int& rb = a * 3;     //表达式结果 → 临时对象

    double d = 12.34;
    // 编译报错:“初始化”: 无法从“double”转换为“int &”
    // int& rd = d;
    const int& rd = d;         //类型转换 → 临时对象

    return 0;
}
5.6 引用和指针的关系
| 对比项 | 引用 | 指针 |
|---|---|---|
| 语法概念 | 变量的取别名,不开空间 | 存储一个变量地址,要开空间 |
| 初始化 | 定义时必须初始化 | 建议初始化,但语法上不是必须 |
| 能否改指向 | 引用一个对象后不能再引用其他对象 | 可以不断地改变指向对象 |
| 访问方式 | 直接访问指向对象 | 需要解引用才是访问指向对象 |
sizeof 含义 | 结果为引用类型的大小 | 始终是地址空间所占字节数(32 位 4 字节,64 位 8 字节) |
| 安全性 | 指针很容易出现空指针和野指针问题,引用很少出现,引用使用起来相对更安全一些 | — |
六:内联函数(inline)
6.1 定义
用 inline 修饰的函数叫做内联函数,编译时 C++ 编译器会在调用的地方展开内联函数,这样调用内联函数就不需要建立栈帧了,就可以提高效率。
inline int Add(int x, int y)
{
    int ret = x + y;
    ret += 1;
    return ret;
}

int main()
{
    int ret = Add(1, 2);        // 展开后大致相当于:
                                // int x = 1, y = 2;
                                // int ret_tmp = x + y;
                                // ret_tmp += 1;
                                // int ret = ret_tmp;
    cout << Add(1, 2) * 5 << endl;
    return 0;
}
优势:
- 省掉函数调用开销(压栈、跳转、建栈帧、返回);
- 让编译器能做跨函数的优化(常量传播、公共子表达式消除、寄存器分配等)——这是现代编译器里 inline 的更大价值。
- 优化后的结果常常是纯常量计算:
6.2 五个核心特点
6.2.1 它只是一个"建议",不是命令
inline 对于编译器而言只是一个建议,也就是说,你加了 inline 编译器也可以选择在调用的地方不展开,不同编译器关于 inline 什么情况展开各不相同,因为 C++ 标准没有规定这个
6.2.2 只适合"频繁调用的短小函数"
inline适用于频繁调用的短小函数,对于递归函数,代码相对多一些的函数,加上inline也会被编译器忽略。
因为内联是用代码体积换速度:
inline void Big(int x)      // 500 行代码
{
    // ... 大量逻辑
}
// 在 100 个地方调用 → 代码体积暴增 100 倍
6.2.3 VS 的 Debug 版本默认不展开
vs 编译器 debug 版本下面默认是不展开 inline 的,这样方便调试,debug 版本想展开需要设置一下以下两个地方。VS 里打开内联的设置: 项目属性 → C/C++ → 优化
6.2.4 存在的目的是"替代 C 的宏函数"
C 语言实现宏函数也会在预处理时替换展开,但是宏函数实现很复杂很容易出错的,且不方便调试
// 实现一个 ADD 宏函数的常见问题
//#define ADD(int a, int b) return a + b;    // 宏参数不能带类型!宏是文本替换,不是函数
//#define ADD(a, b) a + b;                   // 没有括号,优先级全乱
//#define ADD(a, b) (a + b)                  // 缺每个参数各自的括号

// 正确的宏实现
#define ADD(a, b) ((a) + (b))


int main()
{
    int ret = ADD(1, 2);
    cout << ADD(1, 2) << endl;
    cout << ADD(1, 2)*5 << endl;   //缺外层括号 → 1 + 2*5 = 11(错!)
    int x = 1, y = 2;
    ADD(x & y, x | y);             // -> (x&y+x|y)  缺内层括号 → 优先级错乱
    return 0;
}
6.2.5 不建议声明和定义分离(否则链接错误)
inline 不建议声明和定义分离到两个文件,分离会导致链接错误。因为 inline 被展开,就没有函数地址,链接时会出现报错。
// F.h
#include <iostream>
using namespace std;
inline void f(int i);
// F.cpp
#include "F.h"
void f(int i)
{
     cout << i << endl;
}
// main.cpp
#include "F.h"
int main()
{
     // 链接错误:无法解析的外部符号
     f(10);
     return 0;
}


 扫一扫


 1892

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


