过拟合

限时加码!20+主流AI编程工具免费用 购周边加赠Coding Plan Lite,Claude Code、Cursor等即刻畅享,学习进阶更高效! 阅读详情

过拟合

在进行逻辑回归和线性回归时可能出现欠拟合和过拟合现象,欠拟合和过拟合均无法有效的应用到未测试数据中,过拟合对输入的实验数据的拟合效果异常完美,但是对未加入的数据拟合结果很差。下面三个图分别代指欠拟合,拟合良好和过拟合。(图片来自大牛吴恩达的课程)
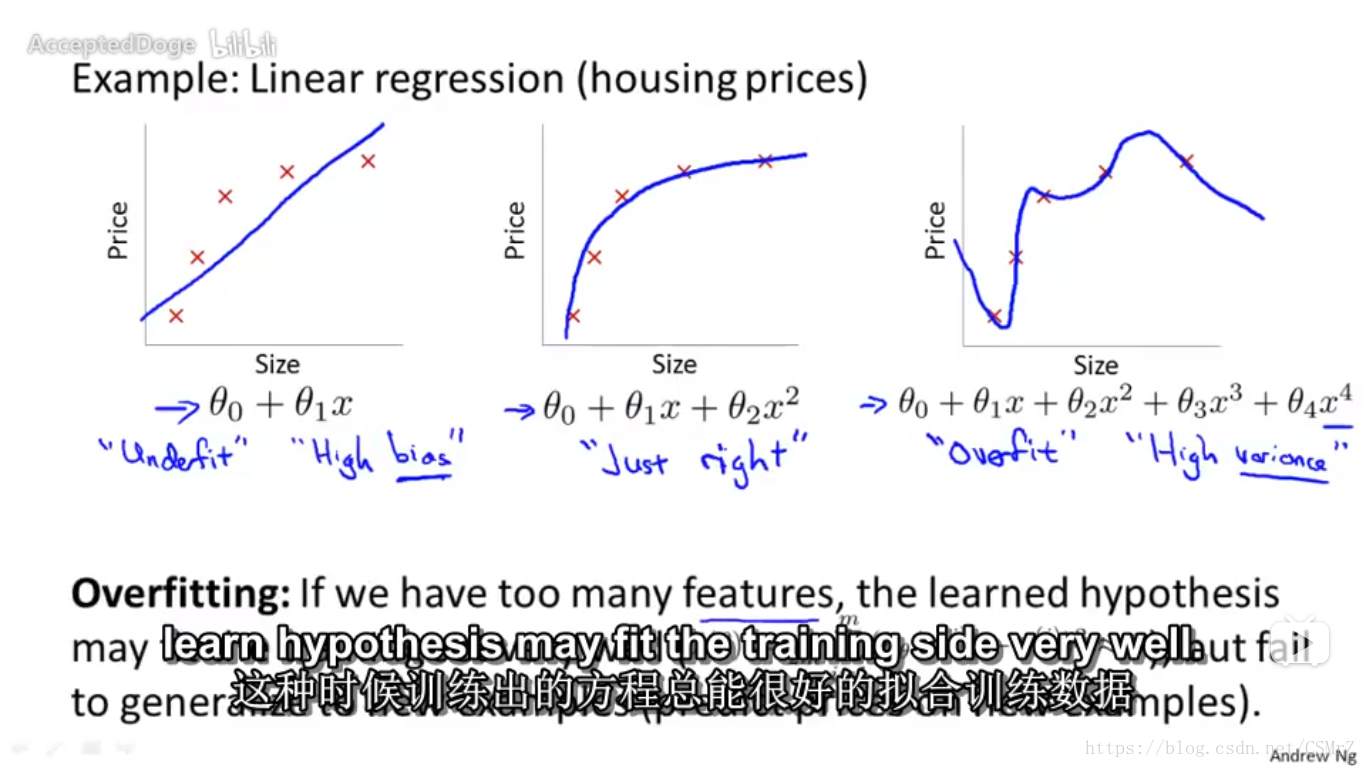
这里写图片描述

产生过拟合的原因

特征量太多,而测试数据太少。

解决方法

1.人为的舍弃特征量(略)

2.正则化

正则化的基本思想是在代价函数中加入惩罚因子,将特征量的影响力减小。例如假设函数h(θx)=θ0+θ1x1+θ2x22+θ3x1x2h(θx)=θ0+θ1x1+θ2x22+θ3x1x2,我们在原代价函数的基础上加上1000θ22+1000θ231000θ22+1000θ32,这样我们在最小化代价函数时,θ3θ3θ2θ2的值趋近于0,即弱化了后两项的影响力。当我们不知道弱化具体哪些项时,可以将所有项均弱化,这就叫做正则化,默认不弱化θ0θ0项。

线性回归中的正则化
1.梯度下降

代价函数变成如下形式:

J(θ)=12m[i=1m(hθ(xi)yi)2+λi=1nθ2i]J(θ)=12m[∑i=1m(hθ(xi)−yi)2+λ∑i=1nθi2]

更新θjθj(除θ0θ0):
θj=θj(1αλm)αmi=1m(hθ(xi)yi)xiθj=θj(1−αλm)−αm∑i=1m(hθ(xi)−yi)xi
2.正规方程

正规方程变为如下形式,在原来的基础上添加了一个除第一行对角线为0,其余对角线上均为1的矩阵。(不清楚为什么,但是解决了XTXXTX的不可逆问题)

θ=(XTX+0....1.........1)1XTYθ=(XTX+{0....1.........1})−1XTY
逻辑回归中的正则化

代价函数变为如下形式:

J(θ)=1mi=1m(yiloghθ(xi)+(1yi)log(1hθ(xi))+λmj=1nθ2jJ(θ)=−1m∑i=1m(yiloghθ(xi)+(1−yi)log(1−hθ(xi))+λm∑j=1nθj2

更新θjθj(除了θ0)θ0):
θj=θj(1αλm)i=1m(hθ(xi)yi)xijθj=θj(1−αλm)−∑i=1m(hθ(xi)−yi)xji
【模型过拟合解析】 在机器学习中,过拟合(Overfitting)是指模型在训练数据上表现非常好(例如,训练误差低或准确率高),但在新数据或未见过的测试数据上表现显著下降的现象。本质上,模型“过度记忆”了训练数据中的噪声和特定模式,而非学习数据的真实规律(即泛化能力差)。这导致模型无法有效适应新场景。例如,在回归问题中,过拟合模型可能完美拟合训练点,但在新数据上预测波动大。数学上,过拟合通常表现为偏差-方差权衡中的高方差问题。定义一个损失函数其中 θ为模型参数。 阅读详情

相关推荐

过拟合(定义、出现的原因4种、解决方案7种)

定义定义:给定一个假设空间H,一个假设h属于H,如果存在其他的假设h’属于H,使得在训练样例上h的错误率比h’小,但在整个实例分布上h’比h的错误率小,那么就说假设h过度拟合训练数据。 ———《Machine Learning》Tom M.Mitchell出现过拟合的原因1.  训练集的数量级和模型的复杂度不匹配。训练集的数量级要小于模型的复杂度;2.  训练集和测试集特征分布不一致;3.  样本...

NIGHT_SILENT的博客 6万+

神经网络--从0开始搭建过拟合和防过拟合模型

今天来学习一下如何从0开始搭建过拟合和防过拟合模型,本文是从零开始的,如有需要可自行跳至所需内容

拥有百余位万粉技术博主、200余位可合作代发博主,私域技术社群规模达千人,商务合作私信 1万+

过拟合的原因和解决方法

过拟合的原因 1、数据量太小 这个是很容易产生过拟合的一个原因。设想,我们有一组数据很好的吻合3次函数的规律,现在我们局部的拿出了很小一部分数据,用机器学习或者深度学习拟合出来的模型很大的可能性就是一个线性函数,在把这个线性函数用在测试集上,效果可想而知肯定很差了。 2、训练集和验证集分布不一致 训练集训练出一个适合训练集那样分布的数据集,当你把模型运用到一个不一样分布的数据集上,效果肯定大打折扣。这个是显而易见的。 3、模型复杂度太大 在选择模型算法的时候,首先就选定了一个复杂度很高的模型,然后

左手coding,右手cooking 1万+

过拟合(笔记整理)

关于过拟合、欠拟合,虽然知道这两个概念的意思,但是要准确的表达这个含义还是有点小困难,并且好记性不如烂笔头,所以写个博客,让大家温故而知新。

散修炼丹师手记 6852

神经网络学习9--过拟合 (Overfitting)的解决办法

方法一:增加数据 增加数据量, 大部分过拟合产生的原因是因为数据量太少了. 如果我们有成千上万的数据, 红线也会慢慢被拉直, 变得没那么扭曲 . 方法二:运用正规化 运用正规化. L1, l2 regularization等等, 这些方法适用于大多数的机器学习, 包括神经网络. 他们的做法大同小异, 我们简化机器学习的关键公式为 y=Wx . W为机器需要学习到的各种参数. 在过拟合中, W...

二毛的博客 6310

【深度学习】——过拟合的处理方法

目录 一、什么是过拟合?(overfitting) 二、过拟合的表现(判定方法) 训练集、测试集、验证集区别 测试集与验证集的区别 三、产生过拟合的原因 1、样本方面 2、模型方面 四、避免过拟合的方法 1、样本方面 1)增加样本量 2)样本筛选(特征降维、特征选择) 2、模型方法 1)正则化 ①概念 ②L0正则化 ③L1正则化 ④L2正则化 ⑤为什么可以避免过拟合? 2)归一化(Normalization) ①最小最大值归一化(min-max normaliz...

python_AI_fans的博客 2万+

过拟合现象,原因,以及降低过拟合的方法

一、什么是过拟合,为什么要避免过拟合 图1.1 Overfit&Normal 上图是一张使用线性回归拟合二维样本数据的matlab输出图片,其中Normal曲线是使用使用了带参数空间限制的最小二乘法进行求解的模型,Overfit曲线是使用最小二乘法直接求解得到的。 可以看到虚线输出的模型可能并不是我们现实生活中所想要的模型,当我们得到Overfit所学的模型后,用于实际回归任务中,可...

DevilXiao 3万+

随机森林过拟合问题

任何机器学习算法都会有一个很常见的问题,就是过拟合问题(overfitting),经常都能看到很多人在问随机森林会不会出现过拟合问题,在外国的网站看到了这篇文章,觉得写的很好,所以翻译转载在这里。 提出问题:随机森林是否会过拟合? 当我第一次看到这个问题时,我有点惊讶,第一个想法是,当然!任何复杂的机器学习算法都会过拟合。我已经训练了数百个随机森林(RF)模型,并且多次观察到它们过拟合。第二个...

蚁人的博客 4万+

什么是过拟合

但是,也有可能,模型的平均误差率在85%左右,在95%的置信度下,模型预测准确率的置信区间恰为 [80%,90%],那么此时模型并没有过拟合。当然,后一种情况出现的概率相对较小,我只是想表达一下,这种直观的判断方法是不一定准确的,不过方便的是,我们不用画学习曲线图啊,多省事。但是,有些模型除了参数还有超参数,例如KNN和KMeans的k值,支持向量机的C值,这些超参数是需要人为设定,没有办法让模型自己学习得到,我们只能通过经验或者多次训练比较,主观设定一个我们认为相对最优的值。在此过程中可以看出,

hellozhxy的博客 3834

过拟合是什么 怎么解决?

转载来源:https://blog.csdn.net/u010899985/article/details/79471909 一.过拟合 在训练数据不够多时,或者over-training时,经常会导致over-fitting(过拟合)。其直观的表现如下图所所示。 随着训练过程的进行,模型复杂度,在training data上的error渐渐减小。可是在验证集上的error却反而渐渐增大——...

小明的博客 4万+

面试题目:欠拟合、过拟合及如何防止过拟合

对于深度学习或机器学习模型而言,我们不仅要求它对训练数据集有很好的拟合(训练误差),同时也希望它可以对未知数据集(测试集)有很好的拟合结果(泛化能力),所产生的测试误差被称为泛化误差。度量泛化能力的好坏,最直观的表现就是模型的过拟合(overfitting)和欠拟合(underfitting)。过拟合和欠拟合是用于描述模型在训练过程中的两种状态。一般来说,训练过程会是如下所示的一个曲线图 一、什么是欠拟合? 欠拟合是指模型不能在训练集上获得足够低的误差。换句换说,就是模型复杂度低,模型在训练集上就表现很差.

Golden-sun的博客 3602

过拟合以及如何防止过拟合

什么是过拟合 过拟合即模型在训练过程中对模型参数进行拟合的过程中,由于训练数据集存在抽样误差(噪声),复杂的模型在训练的过程中会将抽样误差也一同进行拟合。这就导致训练好的模型在训练集上的表现很好,在测试集上的表现很差的原因。 导致过拟合的主要原因有两个:数据量太少和模型过于复杂 因为机器学习算法在拟合出正确的规则后,具有进一步拟合噪声的能力,因此,模型在训练的过程中极有可能会发生过拟合过拟合会大...

wdd18326179577的博客 3267

决策树过拟合现象_过拟合

img本文从模型训练的过拟合概念入手,通过两个实际的模型训练(LSTM和LightGBM)展示了在训练过程中出现的过拟合现象,之后通过修正参数来展示模型中参数对于过拟合结果的影响。全文分成如下几个部分:模型训练中的过拟合和欠拟合过拟合训练例子1:用Keras包创建LSTM模型拟合线性数据过拟合训练例子2:用lightgbm拟合随机生成的数据控制模型参数对过拟合的影响总结一 模型训练中的过...

weixin_29248611的博客 3407

理解过拟合

其它机器学习、深度学习算法的全面系统讲解可以阅读《机器学习-原理、算法与应用》,清华大学出版社,雷明著,由SIGAI公众号作者倾力打造。 书的购买链接 书的勘误,优化,源代码资源 原创声明:本文为 SIGAI 原创文章,仅供个人学习使用,未经允许,不能用于商业目的。 导言在进行有监督的机器学习建模时,一般假设数据独立同分布(i.i.d,independently and ide...

SIGAI_CSDN的博客 5433

什么是过拟合?怎么判断是不是过拟合过拟合产生的原因,过拟合的解决办法。

什么是过拟合过拟合也就是泛化能力差。 怎么判断是不是过拟合? 训练时准确率高,验证时准确率低。 过拟合产生的原因: 1.神经网络的学习能力过强,复杂度过高。 2.训练时间太久。 3.激活函数不合适。 4.数据量太少。 解决办法: 1.降低模型复杂度,dropout。 2.即时停止。 3.正则化。 4.数据增强。 ...

Deep learning小舟 6万+

模型过拟合怎么办

当模型出现过拟合(Overfitting)时,意味着它在训练集上表现很好,但在验证集或测试集上的表现较差,通常是因为模型过度“记住”了训练数据中的细节,而未能学到有效的泛化能力。

qq_45743959的博客 1248

防止过拟合的基本方法

过拟合是训练神经网络中常见的问题,本文讨论了产生过拟合的原因,如何发现过拟合,以及简单的解决方法。 发现过拟合问题 在训练神经网络时,我们常常有训练集、测试集和验证集三种数据集。 有时候我们会发现,训练出来的神经网络在训练集上表现很好(准确率很高),但在测试集上的准确率比较差。这种现象一般被认为是过拟合,也就是过度学习了训练集上的特征,导致泛化能力较差。 hold out 方法...

crazy_scott的博客 2万+

SVM中如何防止过拟合

在前面的博客中,我们已经详细讲述过了,什么是过拟合问题。 过拟合(overfitting)表现为模型在训练集上预测效果好,在测试集上预测效果差。 数据中的异常点会导致过拟合,这些异常点,严重偏离正常位置。 在SVM中,最优分类超平面恰恰是那些占少数的支持向量,如果支持向量中碰巧存在异常点,那么我们傻傻地让SVM去拟合这样的数据,最后的超平面就不是最优的了。 具体例子:(参考:https://www...

学无止境、积少成多、厚积薄发 1万+
上一篇: Classification----logisitic regression
CSMrZ
博客等级 码龄9年 0粉丝 20原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

红包个数最小为10个

红包金额最低5元

当前余额3.43前往充值 >
需支付:10.00
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
